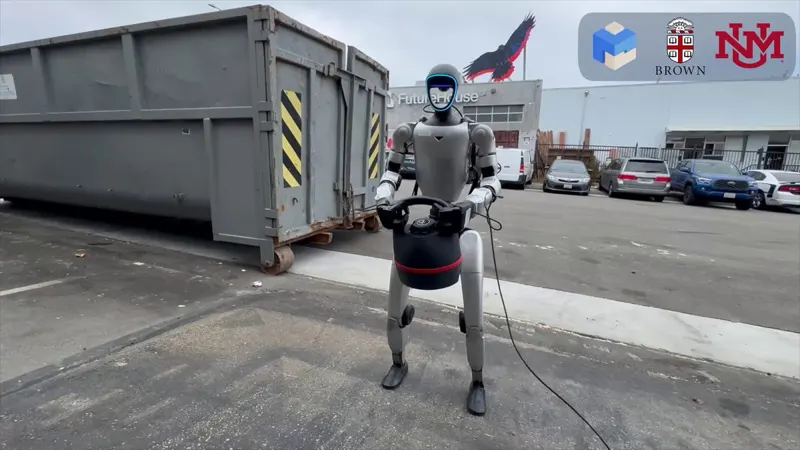
BRACE 把地形与手部力指令折进参考轨迹,双教师蒸馏成只靠本体感觉的流匹配策略;G1 真机负重爬坡,20N 负载跟踪误差 283mm 对基线 470mm。
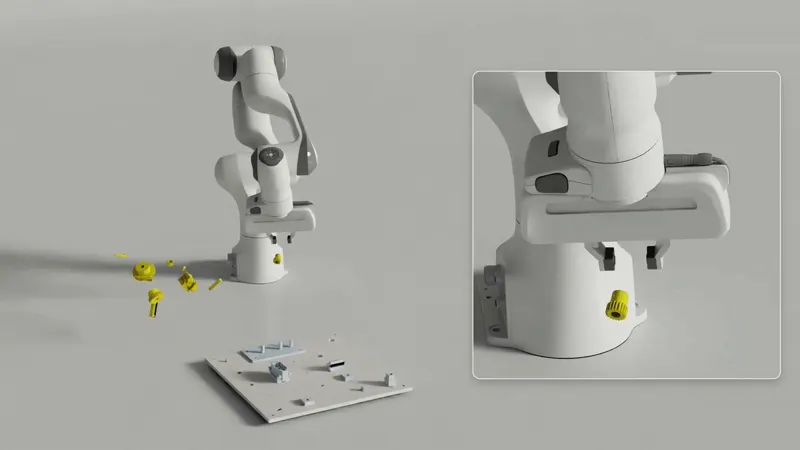
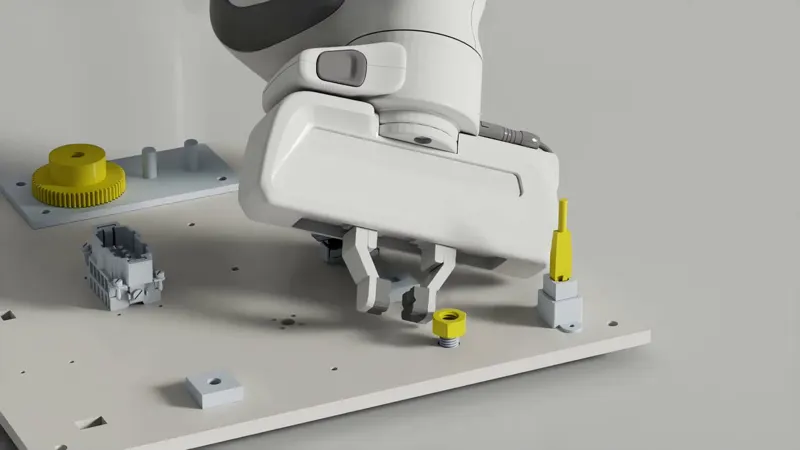
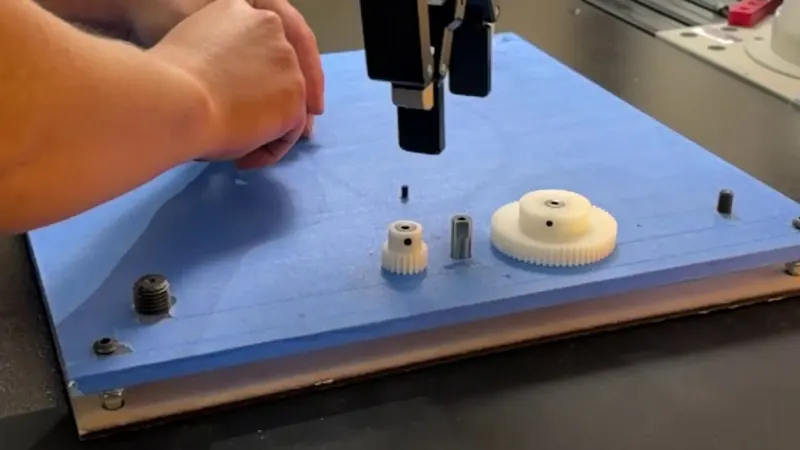
AlphaNIST 用单一强化学习策略完成 NIST 二十项精密装配,在全部任务上取得 98.2% 成功率,并仅凭末端二值奖励连续完成 10 个装配任务。
Robo Use 为智能体提供通往物理世界的 API:32 种 embodiment、100+ 场景、11 个智能体、2500+ 次试验,pip 一行接入。
AlphaNIST 线程首帖:只用二进制奖励加控制成本,在 20 项 NIST 装配任务上达到 98.2% 仿真成功率,无需密集奖励工程。
AlphaNIST 用单一二进制奖励从零训出一个策略,连续完成 10 项 NIST 装配任务;OmniReset 重置加 SGS 任务采样支撑多任务训练。
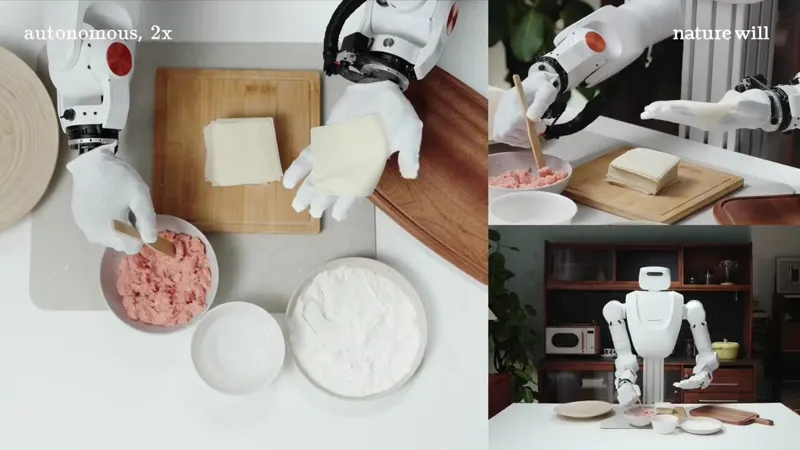
Nature Will 发布 500 亿参数物理通用基础模型 Natura-1,面向灵巧操作与即时机器人智能;视频展示其人形机器人双手揉捏塑形食材的精细操作,并引发行业是否还需自训模型的讨论。
Aether AI 的 CRIS-0 把因果推理带进物理世界:它持续跟踪任务条件,预测每个动作会如何改变这些条件,并在实际结果偏离计划时重新规划。视频演示包括取出盘中金属罐以免进微波炉、整理房间时区分空罐与未喝完的饮料,以及依据记忆规划搜索顺序。
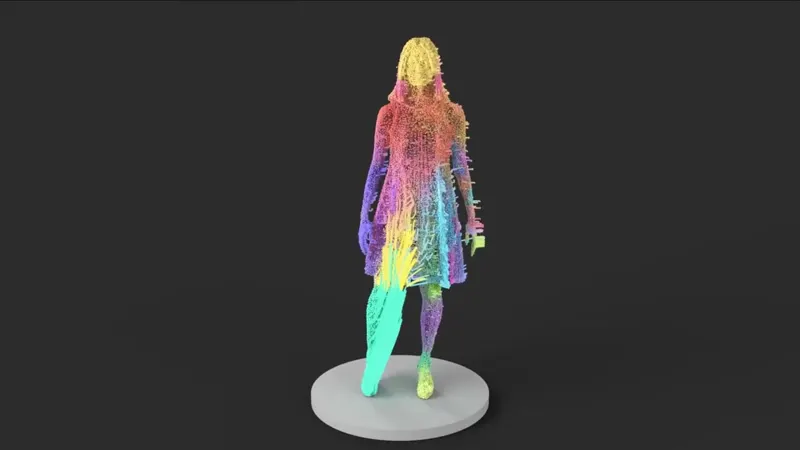
把一段 4D 捕捉压成一个带骨骼的 3D 资产,同时保住次级动力学(布料、头发这类跟随运动),既不靠物理仿真也不用学出来的可形变模型。SIGGRAPH Asia 2026。
MIT 的 Draft 把任意参数化串联链编译成可仿真 MJCF,不用重画 CAD:调肢体长度、机身尺寸、电机功率就能看控制器表现;自由参数由 114 个执行器与 49 份公开机器人描述拟合而来,锚定真实硬件,并用强化学习评估设计可行性。
SGS 按策略能力边界自适应采样训练配置,不在已掌握或还做不到的任务上浪费样本;配合最多百万级并行仿真学会多地形四足行走与接触式装配,再蒸馏成 RGB 策略零样本迁移真机。
现有视频驱动的人形机器人模仿学习通常要在运行时持续生成参考轨迹,策略因此依赖动捕室中的全局位置,物体一旦偏离演示位置,成功率便快速下降。本文提出三阶段教师—助手—学生训练框架 MOVER:先用 GENMO 从 100 段视频恢复人体运动,再由 GMR 重定向到 29 自由度天工人形机器人,并通过物体几何、尺度与位姿增强得到 4000 条参考轨迹;随后依次训练严格跟踪的教师、弱化自身体位置跟踪的助手,以及去除本体位置观测的 DAgger-PPO 学生。部署阶段由头戴 RGB-D 相机和物体标记估计相对位姿,QuatNet 则从物体相对位姿、关节状态与目标位置回归参考朝向。方法在仿真中比较多种物体摆放和形状配置,并在无动捕环境中完成真机搬运,但训练数据规模、视觉遮挡和目标定位误差仍限制泛化。
Ziluo Ding
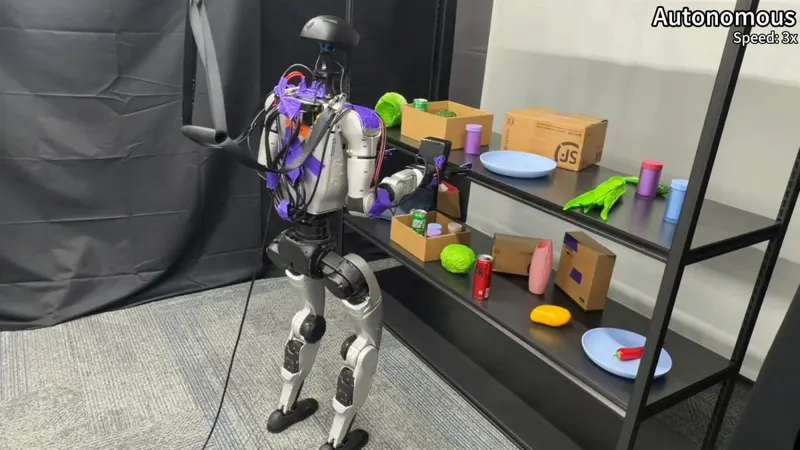
仅用UMI无机器人演示+动捕运动先验,扩散策略生成末端条件全身运动,G1真机关抽屉90%、货架取放80%,无需任务专属全身演示。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。