PAPER DEEP DIVE
RynnUnify:迈向统一具身大脑
RynnUnify以16B双分支统一具身大脑,交错语言推理与视频世界建模,并扩展至机器人动作控制。
论文:RynnUnify: Towards Unified Embodied Brain(arXiv:2610.32965v1,2026 年 10 月 23 日)
作者:Minghao Zhu、Bohan Hou、Kun Xiang、Zixuan Wang、Yinzhou Tang、Yifei Yang、Zhikai Wang、Tianyi Zhang、Kehan Li、Haoyu Zhao、Siteng Huang、Leigang Qu、Sicong Leng、Dongchi Huang、Mingxiu Chen、Shijian Lu、Yue Wang、Xiaodan Liang、Zhenyu Zeng、Deli Zhao、Chengju Liu、Jianfei Yang、Xin Li
机构:阿里巴巴达摩院、阿里巴巴集团、湖畔实验室
资源:GitHub 代码、项目主页、Hugging Face 模型集合
代码状态:公开仓库在提交 5653a9c756f4e87533d2c2031c680d010f8eada7 中提供视觉规划、分支条件策略优化、评测流程与模型入口。项目作者编写的代码采用 Apache-2.0,视觉规划目录保留 OpenMDW-1.1,模型权重、数据集和论文图片另有权利声明。
一句话总结
RynnUnify 把 8B 自回归推理器与 8B 整流流视频生成器放进一个 16B 混合 Transformer,用场景记忆和跨片段前缀维持长程视觉规划,再分别通过 BCPO 学习“何时生成未来视频”以及世界动作模型把预测表征接到机器人动作上。
研究背景与动机
具身模型需要同时回答三类问题:眼前有什么、操作之后会发生什么、下一步应该怎样做。传统视觉语言模型擅长描述当前观察和回答空间关系,却通常把“下一状态”压缩成一句文字;视频生成模型能够产生连续画面,却未必能把画面变化解释为可执行子任务。RynnUnify 的出发点不是把两个模型简单串起来,而是让语言推理产生的子任务和视觉提示直接控制视频预测,再让预测视频成为下一步推理的观察。
长程任务会把单步误差放大。机器人完成一个子任务后,新生成画面既是下一轮输入,也是前面所有判断的证据。如果模型只依赖初始图像,物体被机械臂遮挡或离开视野后就会丢失场景布局;如果每一段视频独立生成,布料褶皱、抽屉位置和物体身份会在片段边界跳变。论文因此同时处理两个时间尺度:四帧离散场景记忆保存较慢变化的场景锚点,上一段视频尾部的前缀保存较快的运动与交互状态。
现有统一多模态模型虽然共享生成与理解骨干,但生成视频并不自动改善推理。错误几何、物理幻觉或与问题无关的画面,都可能成为误导证据。RynnUnify 的第二层设计把“是否调用生成器”变成策略动作:直接回答分支保留低成本和稳定性,生成辅助分支只在预期收益更高时启用。这个选择由强化学习后的 8B 智能体完成,而不是在测试时对所有问题统一展开视频。
机器人控制还要求模型把视觉预测变成高频动作。论文没有把视频交给外部控制器再解析,而是构造世界动作模型:推理器输出连续子任务潜变量,生成器据此预测未来视频,动作头读取生成器内部特征并产生动作块。于是同一套“理解、预测、行动”表征可以在仿真与真实机械臂上接受检验。
为了分别衡量这些能力,作者建立两个新基准。Rynn-VP 检查长程视觉规划是否真正推进任务并保持场景连续性;Rynn-GEU 检查模型能否推断观察之外的未来状态,以及显式视频证据是否改善答案。两个基准把“画面看起来像”和“动作计划真的有效”拆开评价,避免只用生成质量代替具身能力。
架构:两个分支与三类视觉条件
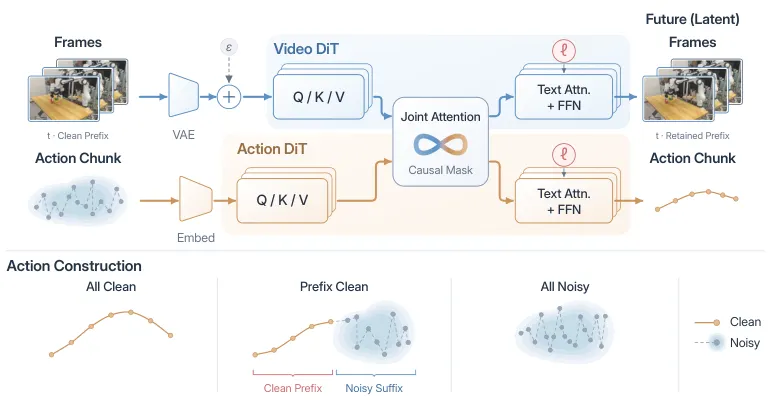
RynnUnify 建立在 Cosmos3 的 Mixture-of-Transformers 上。推理器与生成器各自拥有约 8B 参数,推理器使用自回归建模处理图像、视频和语言,生成器使用整流流预测连续视觉潜变量。两个分支通过联合注意力交换表示:生成器能够读取推理器给出的子任务、场景变化描述与时长条件,推理器不必把视频压缩成单一文本控制信号。
视觉输入先用因果视频变分自编码器处理,空间压缩倍率为 16,时间压缩倍率为 4。场景记忆的每一帧独立编码,因此在生成器序列中形成四组有明确边界的视觉项;主视频潜变量则作为另一组时间项。论文给出的条件序列可以写为
$$ S_t=\left[S_{\mathrm{AR}};Z_{\mathrm{mem}}^{(0)};\ldots;Z_{\mathrm{mem}}^{(3)};z_t\right], $$其中 $S_{\mathrm{AR}}$ 是推理器处理后的文本条件,$Z_{\mathrm{mem}}^{(i)}$ 是第 $i$ 个记忆帧的视觉 token,$z_t$ 是去噪时刻 $t$ 的主视频 token。记忆帧不是被插入主视频时间轴,而是作为独立视觉项排在主视频前面。这种布局让生成器能在不新增记忆编码器或额外交叉注意力模块的情况下读取持久场景信息。
四帧记忆包含固定初始观察、从更早历史中选择的两帧关键画面,以及最近一步的参考画面。历史不足时,模型从已有片段补充候选;第一步会重复初始观察填满槽位。执行过程中,初始观察保持不变,历史参考随新生成片段更新。这个固定锚点与滚动参考的组合,试图同时抵抗场景遗忘和过早锁定错误状态。
连续前缀承担另一种记忆。上一段视频尾部被编码成主视频时间轴开头的固定潜变量,边界帧只出现一次。离散记忆回答“场景应该长什么样”,连续前缀回答“物体刚刚怎样运动”。二者组合后,下一段生成既能看到较早的桌面布局,也能接上刚刚发生的抓取或旋转。
生成接口支持三种固定条件。图生视频固定第一帧;首尾帧生视频同时固定第一帧与最后一帧,用来生成两点之间的过渡;跨片段续写固定上一段尾部的若干潜帧,再预测新动作片段。训练时只有待预测位置参与生成损失,固定条件与独立记忆项都被排除,避免模型把已知像素复制当成主要学习目标。
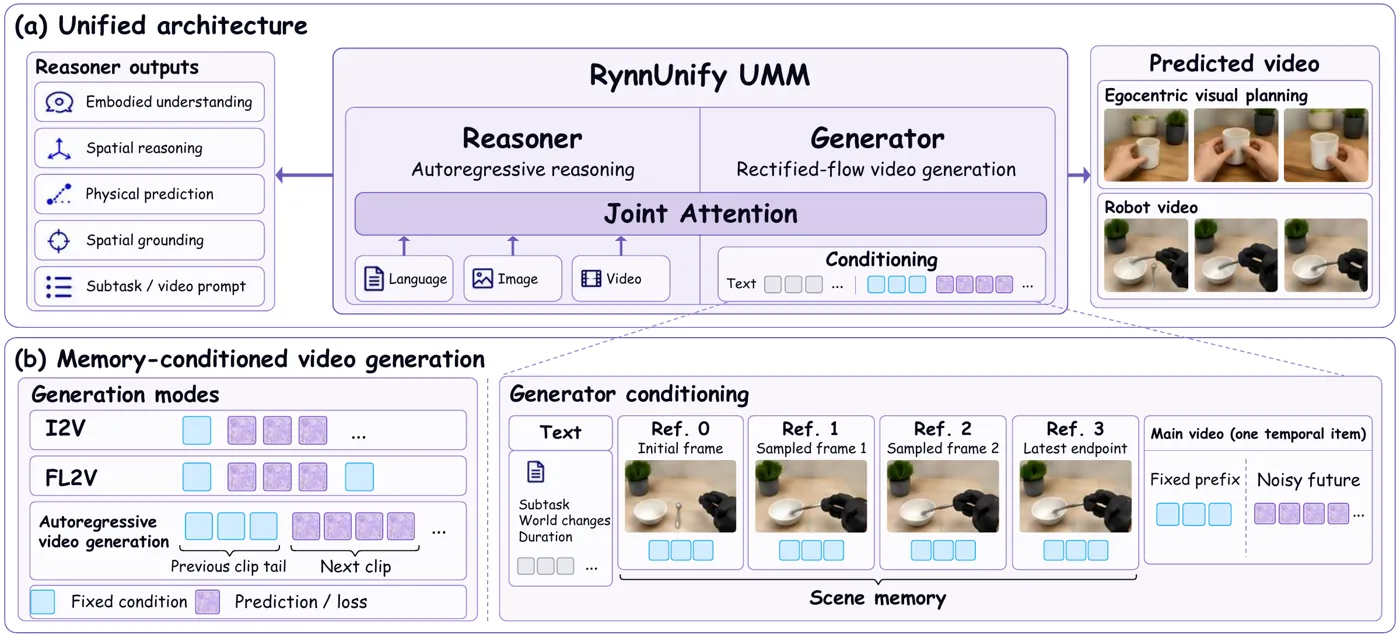
图 1:左侧是 8B 推理器、8B 生成器及联合注意力;下方展示四帧场景记忆、跨片段时间前缀以及三类生成条件。图片来源:论文 Figure 1。
方法详解:从两阶段预训练到动作块
1. 第一阶段只训练具身推理器
第一阶段优化推理器,使它掌握四类能力:时空理解、物理世界定位、下一子任务规划和视频提示生成。输入包括任务目标、初始观察、当前观察以及前三步子任务历史;输出包含下一可执行子任务、预期视觉变化和预计持续时间。监督 token 只包括助手回复,用户上下文和视觉输入不计损失。形式化目标是
\[ \mathcal{L}_R=-\sum_{i\in I_R}\log p_{\theta_R}\left(s_i\mid s_{生成增强理解数据采用交错对话格式。面对一个关于未来状态的问题,推理器先写世界建模指令和时长,系统随后插入对应的真实后续视频,再由推理器读取视频给出思考与答案。这样训练出的推理器既知道应该请求什么样的视觉证据,也知道怎样把视频内容转化为空间坐标、物理量或动作判断。
2. 第二阶段冻结推理器并训练生成器
第二阶段固定推理器,只优化生成器。训练任务包含图生视频、首尾帧生视频和跨片段续写。每个规划样本都配有子任务、详细视觉提示和操作时长。生成器损失沿用 Cosmos3 的流匹配目标,但只计算主视频中待预测位置:
$$ \mathcal{L}_G= \mathbb{E}\left[ \frac{1}{|\Omega|} \sum_{j\in\Omega} \left\| v_{\theta_G}(z_t,t,c)_j-v^{\star}_{t,j} \right\|_2^2 \right], $$其中 $v_{\theta_G}$ 是生成器预测的速度场,$z_t$ 是整流流时刻 $t$ 的主视频潜变量,$c$ 是文本与视觉条件,$v^\star_{t,j}$ 是由真实视频潜变量与采样噪声确定的目标速度。集合 $\Omega$ 只包含需要预测的位置,固定前缀和场景记忆不参与归一化,防止大量已知 token 稀释真正的监督。
长程推理还会遇到训练与测试分布错位:训练时起始帧来自真实数据,测试时起始帧来自模型上一段预测。Self-forcing 通过三类条件替换缩小差距。第一类在像素空间给起始帧加高斯噪声,并以一定概率做降采样再上采样模糊;第二类用固定检查点离线生成前一段视频,以生成片段末帧替换真实起始帧;第三类进一步把历史视频也换成离线生成片段,让场景记忆与起始帧来自同一条自洽的预测链。监督目标仍是当前片段的真实后续视频。
跨片段前缀的长度不是任意值。代码按因果变分自编码器的时间压缩倍率 4 计算,$k$ 个干净潜帧对应 $4k-3$ 个像素帧。训练采样 $k\in\{2,4,8\}$,分别对应 5、13、29 帧;推理使用上一段最后 13 帧。组合时间轴最多 241 帧,前缀最多占潜帧总数的一半,保证仍有足够多位置被预测。若上一段过短而无法提供足够帧,系统退回从末帧开始的图生视频,而不是拼接更早片段伪造连续前缀。
flowchart LR
    A[任务指令与视觉历史] --> B[8B自回归推理器]
    B --> C[下一子任务 视觉提示 时长]
    C --> D[4帧场景记忆]
    C --> E[13帧连续前缀]
    D --> F[8B整流流视频生成器]
    E --> F
    F --> G[预测片段末帧]
    G --> A
    B --> H[直接回答]
    B --> I[生成后回答]
    I --> F
    H --> J[分支奖励]
    I --> J
3. BCPO 让模型学习何时生成视觉证据
作者把智能体行为定义成两条分支。直接分支 $D$ 只读取原问题与观察;生成分支 $G$ 先写世界建模指令和时长,调用冻结的 RynnUnify 生成视频,再解释视频并回答。可路由问题每条采样四个直接轨迹和四个生成轨迹,原生多图问题则采样八个直接轨迹。生成器在强化学习阶段完全冻结,更新只发生在智能体推理器上。
同一分支内部用组归一化比较不同推理轨迹,得到
$$ \hat A_{z,i}=\frac{r_{z,i}-\mu_z}{\sigma_z+\epsilon}, $$其中 $r_{z,i}$ 是第 $z$ 条分支第 $i$ 条轨迹的奖励,$\mu_z$ 与 $\sigma_z$ 只在该分支的八条轨迹内计算。序列级重要性比 $\rho_{z,i}$ 使用整条轨迹平均 token 对数概率差,而不是逐 token 独立裁剪,适配不同推理长度:
$$ \mathcal{L}_{\mathrm{GSPO}}= -\mathbb{E}_{x,z,i} \left[ \min\left( \rho_{z,i}\hat A_{z,i}, \operatorname{clip}(\rho_{z,i},1-\epsilon_{\mathrm{low}},1+\epsilon_{\mathrm{high}})\hat A_{z,i} \right) \right]. $$分支之间则用平均奖励差学习生成概率软目标。若生成分支奖励更高,目标概率上升;若两条路径差异很小,目标保持接近平衡:
$$ q_G(x)=\operatorname{sg}\left( \operatorname{sigmoid}\left( \frac{\mu_G-\mu_D}{T_{\mathrm{route}}} \right) \right), $$其中 $\operatorname{sg}$ 停止梯度。$q_G(x)$ 只由原始输入、问题与观察决定,不能在看到生成视频后才决定是否值得生成。训练用带掩码的二元交叉熵拟合该目标,并把推理轨迹优化、路由学习和正则项合成完整目标:
$$ \mathcal{L}_{\mathrm{RL}} =\mathcal{L}_{\mathrm{GSPO}} +\lambda_{\mathrm{route}}\mathcal{L}_{\mathrm{route}} +\beta\mathcal{L}_{\mathrm{KL}} -\eta H. $$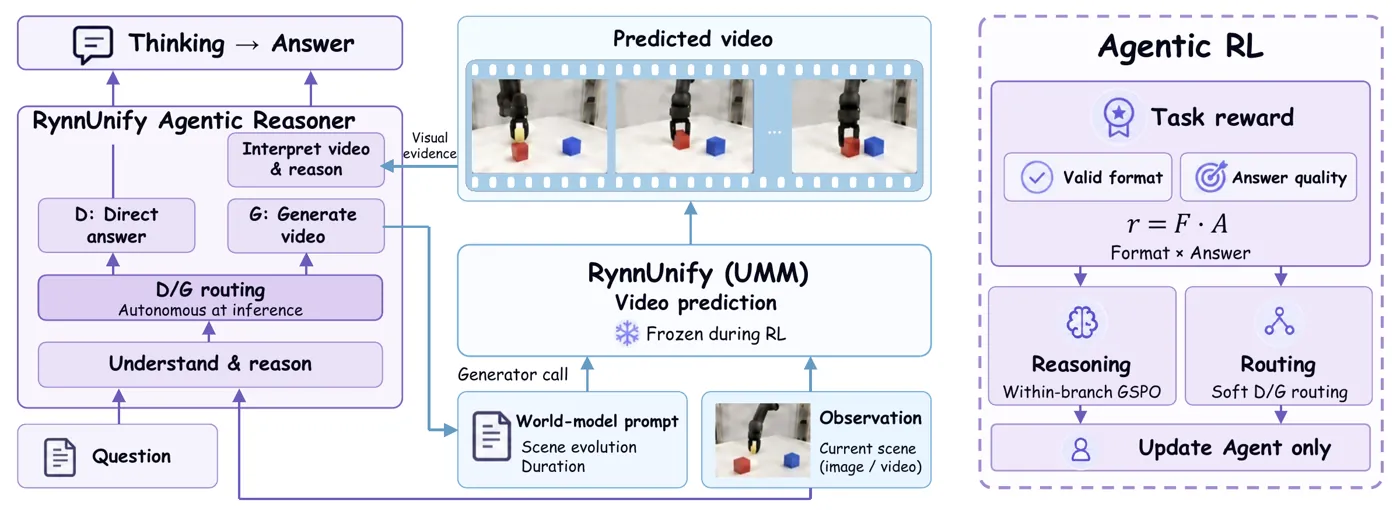
图 2:BCPO 每条可路由问题生成四条直接轨迹和四条生成辅助轨迹;分支内使用 GSPO,分支间学习软路由,生成器保持冻结。图片来源:论文 Figure 2。
4. 奖励把格式合法性与答案质量分开
轨迹奖励首先检查是否遵守请求、观察、回答的交互协议,再乘以任务答案质量:
$$ r(\tau)=F(\tau)A_k(\hat y,y^\star), \qquad F(\tau)\in\{0,1\}. $$数值与几何任务使用归一化误差 $e_k$ 映射到连续分数:
$$ A_k=\max\left(0,1-\frac{e_k}{0.30}\right)^3. $$物理与空间数值题按相对误差计算,区域与可供性按对称最近点距离计算,轨迹按参考弧长归一化后的离散弗雷歇距离计算。文本答案则使用选项匹配、归一化匹配或任务专用语义判断。格式错误得到零奖励,但生成服务故障不会被当成错误答案;开源实现明确让基础设施异常向上抛出,避免模型学习“生成失败就应该直接回答”的伪规律。
5. 世界动作模型把未来视频特征接到动作
世界动作模型延续推理器与生成器,但输入变成指令、当前左腕右三路相机以及视觉历史。推理器产生连续子任务潜变量,生成器通过逐层注意力使用该潜变量并预测未来视频。动作头包含 18 个模块,每个模块通过交叉注意力读取相邻两层生成器的视频隐状态,再用流匹配预测形状为 $48\times12$ 的动作块。机器人一次只执行前 16 个动作。
训练分为三阶段。第一阶段冻结视觉编码器与生成器,只训练推理器的语言层,从指令和多视图历史中识别当前子任务。第二阶段冻结推理器,联合训练生成器的视频 token 与原生动作 token,两类流匹配损失等权。第三阶段冻结推理器与原有动作输出层,联合训练新动作头和生成器,并加入相机位姿监督。总目标是
$$ \mathcal{L}_{\mathrm{III}} =\mathcal{L}_{\mathrm{act}} +0.01\mathcal{L}_{\mathrm{pose}} +0.005\mathcal{L}_{\mathrm{rel}}. $$动作头对加噪动作块预测噪声与干净动作之差,形成标准流匹配损失;位姿头预测未来相机相对当前相机的平移和旋转。相机位姿只在训练时使用,推理时不额外要求真值。这样的设计把“未来视频是否合理”与“动作是否成功”放在同一训练链路中,而不是把视频模型当作离线可视化工具。
数据与实验设计
论文使用约 200 万条通用理解样本,其中来自 RynnBrain 预训练语料的比例为 10%。视觉规划理解数据包含 55 万条人类与通用操作样本、60 万条机器人样本和 86,800 条 RoboCasa365 样本;具身感知与推理数据合计 196,600 条。生成训练共包含 1,083,458 个视频片段、约 1,370.1 小时,覆盖人类演示、真实机器人、仿真和具身推理视频。
| 数据用途 | 主要来源 | 样本或片段 | 规模 |
|---|---|---|---|
| 通用理解 | RynnBrain 预训练语料的 10% | 约 200 万 | 图像、视频、问答、空间和指令数据 |
| 视觉规划理解 | 人类、机器人、仿真与 RoboCasa365 | 1,236,800 | 子任务、操作序列与场景变化 |
| 具身感知与推理 | 空间、物理、动作、杂乱场景、区域、轨迹 | 196,600 | 问答、坐标与未来状态 |
| 视频生成 | 规划片段与具身推理片段 | 1,083,458 | 约 1,370.1 小时 |
Rynn-VP 包含 200 个手工收集的第一视角任务场景。给定初始图和总目标,模型要么生成连续视频,要么生成有序步骤图。评分拆成规划智能、视觉实现和视觉质量:规划智能检查目标推进、步骤有效性、依赖关系与完整性;视觉实现检查动作证据、对象一致性、状态连续性、片段一致性与物理可行性;视觉质量衡量画质和任务相关信息清晰度。总分不是简单平均,而是
$$ \mathrm{Score}_{\mathrm{RynnVP}} =0.5\,\mathrm{PI} +0.4\,\mathrm{VR} +0.1\,\mathrm{VQ}. $$Rynn-GEU 包含十个子集,覆盖位置、方向、距离、尺寸、物理量、杂乱场景连锁反应、动作语义、可供性、区域和轨迹。数据构造时尽量隔离训练与评测场景,并用未来视频增益筛选问题:优先保留“有真实未来画面时更容易答对”的样本,同时保留少量可直接推断的样本,避免基准只考察显式视频依赖。
实验结果
1. 基础具身理解达到所比较统一模型的最高平均分
在不调用生成器和强化学习智能体的条件下,RynnUnify 的十项平均分为 57.9,Cosmos 3 Nano 为 53.2。它在 VSI-Bench 上从 54.9 提升到 67.1,在 RoboSpatial 上从 62.1 提升到 72.8,在 ShareRobot 可供性上从 28.0 提升到 41.8。EmbSpatial 83.0、RefSpatial 60.3 和 ShareRobot 轨迹误差 0.27 也是所有比较模型中的最好结果。需要注意,平均分只统计表中十个指标,不等同于通用多模态能力总分。
| 模型 | VSI | MMSI | MindCube | ERQA | RoboSpatial | EmbSpatial | RefSpatial | 可供性 | 轨迹误差↓ | Where2Place | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Qwen3-VL-8B | 60.3 | 29.8 | 36.8 | 44.8 | 58.2 | 78.5 | 53.4 | 37.9 | 0.37 | 64.7 | 52.7 |
| RynnBrain-8B | 71.0 | 39.6 | 56.6 | 46.8 | 73.1 | 80.4 | 59.2 | 44.7 | 0.35 | 75.5 | 61.2 |
| Cosmos 3 Nano | 54.9 | 36.2 | 40.5 | 46.0 | 62.1 | 81.4 | 53.1 | 28.0 | 0.34 | 64.0 | 53.2 |
| RynnUnify | 67.1 | 35.9 | 44.2 | 43.8 | 72.8 | 83.0 | 60.3 | 41.8 | 0.27 | 56.9 | 57.9 |
表中同时暴露了一个重要边界。单任务代理 RynnBrain-8B 的平均分 61.2 高于 RynnUnify 的 57.9,因此“统一模型打败所有理解模型”并不成立。论文准确的主张是:RynnUnify 在所比较的统一多模态模型中平均分最高。它用同一个 16B 系统覆盖理解和生成,牺牲部分单项优势换来了跨任务共享。
2. 按需生成提高预判推理,但不是所有几何题都变好
直接回答时,RynnUnify 在 Rynn-GEU 的平均分为 44.0;加入 BCPO 智能体后升到 50.0。公共推理基准平均从 41.3 升到 44.6,其中 MindCube 从 44.2 升到 52.6。Rynn-GEU 的收益更不均衡:区域定位从 35.9 升到 66.2,杂乱场景连锁变化从 8.5 升到 29.1,说明生成视频提供的未来空间证据对这两类任务尤其有效。
| 设置 | 公共平均 | MindCube | ERQA | Rynn-GEU 平均 | 区域 | 杂乱场景 |
|---|---|---|---|---|---|---|
| RynnUnify 直接回答 | 41.3 | 44.2 | 43.8 | 44.0 | 35.9 | 8.5 |
| RynnUnify + Agentic Thinking | 44.6 | 52.6 | 44.8 | 50.0 | 66.2 | 29.1 |
| BAGEL + Interleaved Thinking | 38.4 | 39.6 | 44.8 | 10.8 | 18.5 | 1.9 |
| Cosmos 3 Nano + Interleaved Thinking | 36.0 | 36.4 | 41.4 | 33.5 | 28.4 | 4.5 |
作者也报告了反向证据:空间位置、距离和尺寸分数在智能体展开后略有下降。生成画面若扭曲细小几何,后续文本推理会把错误当成事实。BCPO 学到的路由因此不是万能开关;它只说明在奖励覆盖的任务集合上,按需生成的总体收益更高。对精确装配、孔位对齐或毫米级间隙,直接回答或额外几何校验仍更可靠。
3. 长程视觉规划优于所比较的统一模型
在 Rynn-VP 上,RynnUnify 取得规划智能 45.66、视觉实现 60.54、视觉质量 77.53,总分 54.80。相比 Cosmos 3 Nano 的 45.05,总分提高 9.75;提升主要来自规划智能增加 15.16 和视觉实现增加 5.96,而视觉质量反而低 2.16。这个结构说明改善并非只靠更漂亮的帧,而是来自子任务推进和跨片段一致性。
| 方法 | 输出形式 | 规划智能 | 视觉实现 | 视觉质量 | 总分 |
|---|---|---|---|---|---|
| BAGEL | 步骤图 | 9.46 | 24.36 | 58.50 | 20.32 |
| RxBrain | 步骤图 | 1.28 | 11.35 | 28.15 | 8.00 |
| Cosmos 3 Nano | 视频 | 30.50 | 54.58 | 79.69 | 45.05 |
| RynnUnify | 视频 | 45.66 | 60.54 | 77.53 | 54.80 |
| GPT-5.6 Terra + MiniMax-H3 | 组合视频系统 | 59.82 | 69.56 | 79.73 | 65.71 |
组合式系统 GPT-5.6 Terra 加 MiniMax-H3 的 65.71 仍高于 RynnUnify。因而“最佳统一多模态模型”和“所有系统最佳”必须严格区分。论文自己把后者列为组合生成系统,RynnUnify 的优势是把规划、生成和记忆放在一个模型中,而绝对上限仍可由更强的外部规划器加生成器获得。
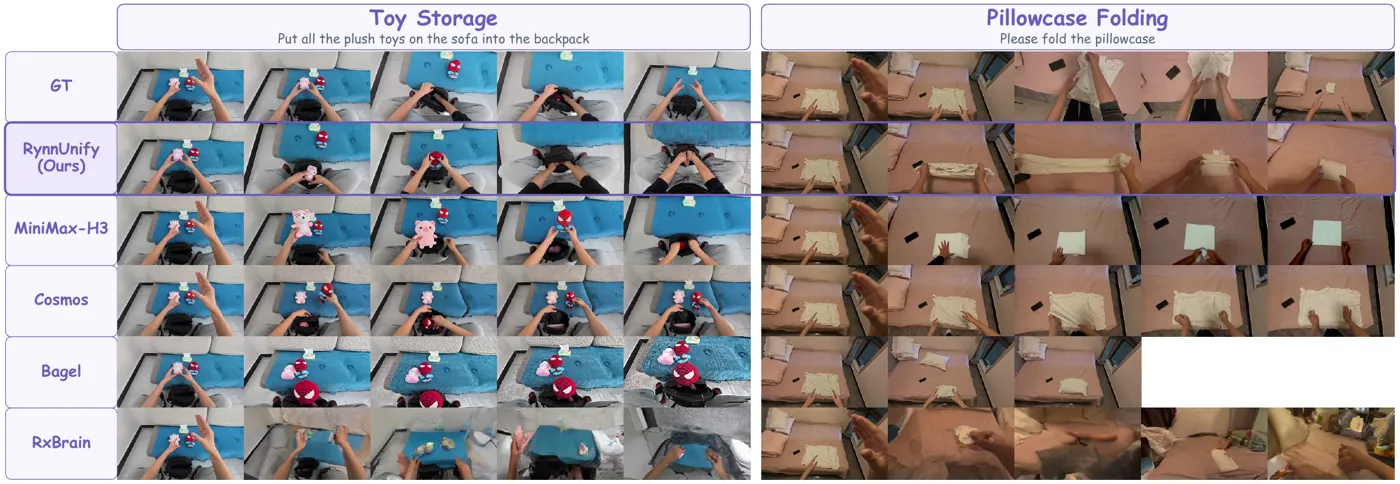
图 3:玩具收纳要求连续转移多个毛绒玩具,枕套折叠要求保持布料形变与背景布局。RynnUnify 在中间状态连续性上明显优于基线。图片来源:论文 Figure 8。
4. 世界动作模型在仿真与真实机械臂上都能执行多步操作
RoboCasa365 的完整测试中,RynnUnify 在 Composite-Seen 上达到 52.0%,在 Composite-Unseen 上达到 50.0%。未见组合的最高值是 RynnUnify;已见组合最高值是 Xiaomi-Robotics-1 的 57.1%。在作者挑选的 20 个组合移动操作任务上,每项运行 10 个回合,RynnUnify 总成功率为 51.5%,高于 CMA 的 47.0%、Xiaomi-Robotics-1 的 46.0% 和 Cosmos 3 的 45.0%。
| 方法 | 已见组合 | 未见组合 | 选定 20 项 |
|---|---|---|---|
| Cosmos 3 | 49.6% | 39.0% | 45.0% |
| Xiaomi-Robotics-1 | 57.1% | 32.1% | 46.0% |
| CMA | 50.6% | 44.0% | 47.0% |
| RynnUnify | 52.0% | 50.0% | 51.5% |
真实机器人实验在 Astribot S1 双臂移动平台上进行,每项 20 次。转向抓取要求机体转身后抓取并转移两个积木,平均成功率为 55.0%;积木交换要求把桌上与抽屉中的红蓝方块互换,成功率 35.0%;三次碗搬运后再抓勺子要求跨过视觉相似的重复状态,成功率为 50.0%。三项平均 46.7%,GR00T N1.7 为 26.7%,π0.5 为 25.0%。
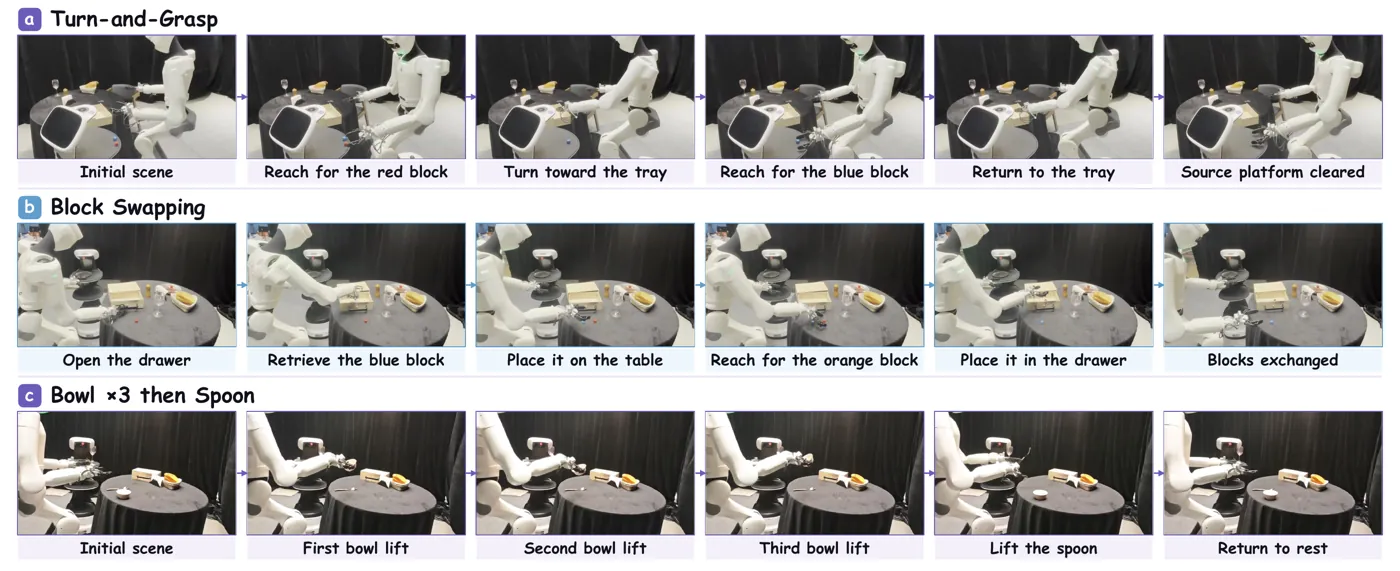
图 4:三类真实机器人任务展示机体转向、抽屉内物体交换和按次数记忆执行。图片来源:论文 Figure 10。
这些结果不等于机器人已经可靠。积木交换只有 35.0% 完成率,说明小物体定位、抓取和放置仍是瓶颈;每项 20 次也带来较宽的统计不确定性。三次碗任务的 50.0% 比最强基线高 10 个百分点,更值得关注的是行为结构:模型必须识别“已经完成几次”,而不是只依据当前画面里的碗是否存在。
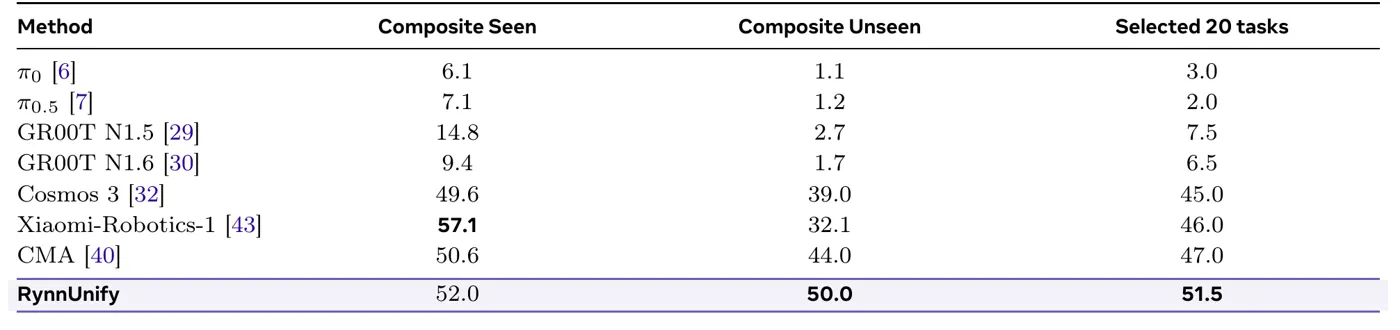
图 5:RoboCasa365 三项成功率对比。未见组合与选定 20 项的提升支持跨场景和复合任务泛化,但已见组合并非所有方法最佳。图片来源:论文 Table 5。
公开代码如何对应论文
视觉规划入口 VisualPlan/interleave_vp/plan_generator.py 的 generate_visual_plan 直接接收当前帧、可选场景记忆、可选前缀帧和目标帧,再选择图生视频、首尾帧生视频或跨片段续写。函数注释要求前缀像素帧数量等于 $4k-3$,与论文的因果变分自编码器时间压缩完全一致。跨片段实现还将历史时长和当前动作时长分开,避免把旧片段计入新动作条件。
VisualPlan/interleave_vp/cross_chunk_v2v.py 的 combined_timeline 明确限制了可运行配置。代码只允许前缀潜帧数为 2、4、8,检查源片段是否有足够尾部帧,并要求前缀不超过整个模型潜帧时间轴的一半。若条件不满足,返回跳过原因,不会用重复帧或更早片段补造连续前缀。这个实现细节比论文正文更能说明“跨片段连续性”是硬约束,而不是可视化技巧。
BCPO/rynn_rl/selective_rollout.py 的 Collector.one 将可路由问题展开成直接轨迹或完整请求、观察、回答轨迹;collect 为每个问题安排四个 $D$ 和四个 $G$。代码还验证视频提示是否引用合法帧号,协议错误会得到无奖励轨迹,而生成服务异常会向上抛出,避免把基础设施失败写进策略奖励。
BCPO/rynn_rl/selective_objective.py 的 build_targets 强制输入形状为问题数乘八,检查可路由问题恰好四条生成轨迹、原生问题恰好八条直接轨迹,并在各分支内部计算总体标准差。它由分支均值差构造软路由目标,与公式 6 对应。selective_loss.py 的序列级 GSPO 先对每条轨迹的 token 比取平均,再裁剪整条序列的重要性比,避免长轨迹被逐 token 累乘后产生极端权重。
这些代码对应关系有两个工程含义。第一,论文中的“视觉证据”不是任意视频,而是必须满足固定条件布局、帧数算术和协议引用的可审计输入。第二,强化学习只更新智能体,生成器、参考策略和奖励服务保持冻结,因此 BCPO 不能通过改变视频模型来刷高奖励,而必须学习请求、解释和路由。
局限性
作者明确承认,生成视频会扭曲细粒度几何,部分空间任务的智能体版本得分下降。模型可能正确完成“把物体移到目标区域”的语义计划,却在目标边界、相机旋转或尺寸关系上产生偏差。把生成视频当成真值会让后续推理过度自信,因此实际部署需要几何置信度、原图回路或外部测量来约束。
其次,Rynn-VP 是不依赖仿真器的视觉评测,主要判断任务步骤、场景连续性和物理合理性,不能替代真实执行。论文的真实机器人实验提供了重要补充,但只有三个任务、每项 20 次,尚不足以覆盖更多材质、光照、相机标定误差、网络延迟和人类干扰。视觉规划分数与机器人成功率的统计关系仍需更大规模研究。
第三,交错生成对闭环控制仍昂贵。生成 480p、24 帧每秒、默认每步 4 秒的视频,再进行解释和下一步规划,会形成秒级决策链。世界动作模型通过一次视频去噪和 16 步动作采样降低推理成本,但视频生成器仍参与控制器前置计算。论文把降低成本列为未来工作,说明当前演示更适合慢速操作和分层规划,而不是所有高频反射动作。
最后,实验结果需要按比较集合阅读。RynnUnify 是所比较统一多模态模型中的最高平均分,但 RynnBrain-8B 在表 2 的平均分更高,组合式 GPT-5.6 Terra 加 MiniMax-H3 在 Rynn-VP 上更高,Xiaomi-Robotics-1 在 RoboCasa365 已见组合上更高。它的核心贡献是统一架构与可组合能力,而不是每个单项都绝对领先。
结论与展望
RynnUnify 最值得借鉴的地方,是把“世界模型”从单独的视频生成器变成推理协议中的可调用工具。推理器先判断需要什么未来证据,生成器在场景记忆和时间前缀约束下产生片段,推理器再解释片段并决定下一步。这个闭环比固定长度视频预测更接近机器人真实的子任务节奏,也比纯文本规划保留了更多物体状态和视角变化。
世界动作模型进一步说明,视频预测特征可以同时服务动作头。未来视频不是给人看的旁路输出,而是动作策略的内部世界状态。若后续研究能提高细粒度几何可靠性、学习何时拒绝不可信生成证据,并把视频生成压缩到闭环可接受延迟,这条路线可能成为统一具身基础模型的重要结构。
金句
真正统一的具身大脑,不是让语言模型“顺便生成一段视频”,而是让语言推理知道何时需要未来画面,并让未来画面改变下一步推理与动作。