PAPER DEEP DIVE
UniAction:面向世界模型的统一动作条件化
UniAction 将力、相机指令、手部姿态与机器人姿态统一表示为稀疏动作元素,通过原生时空位置编码与基数校准注意力共享一个视频世界模型。
论文:UniAction: Unified Action Conditioning for World Models
作者:Bowen Xue、Zizhang Li、Hong-Xing Yu、Jiajun Wu
机构:Stanford University
论文链接:https://arxiv.org/abs/2610.32977
项目页:https://uniaction.github.io/
代码状态:官方仓库已公开,本文核对提交 b0d09151335f0682af4d6f5858ae188ed1c64981。
一句话总结
UniAction 把力、相机指令、手部姿态和机器人姿态都改写为“语义身份加时空坐标”的稀疏动作元素,让一个视频世界模型通过原生注意力统一接收四类控制。
研究背景:动作数据被表示方式切碎了
视频世界模型要回答的核心问题是:给定当前画面、文字任务和某个动作,世界接下来会怎样变化。大规模视频生成模型已经从互联网视频中学到物体外观、场景结构和运动规律,因此自然可以作为世界模型的基础。问题出在动作侧:不同环境把“动作”定义成完全不同的数据,模型很难像处理文字 token 那样直接接收一个统一输入。
力通常是一个瞬时向量,包含作用点和方向;相机控制是 W、A、S、D、I、J、K、L 这样的离散按键;手部姿态是逐帧关节坐标;机器人动作则可能来自不同机械结构的关节轨迹或末端执行器运动。它们有的是低维瞬时事件,有的是持续多帧的密集序列,有的具有明确图像位置,有的只表示全局视角变化。
现有系统往往为一种动作单独设计编码器和条件注入层,再用这种动作的数据单独训练模型。工程上这很直接,但会造成两类浪费。第一,动作标注数据本来就比普通视频少,按动作类型拆开以后,每份数据只能服务一个模型。第二,不同动作数据其实共享大量世界知识,例如物体材质、遮挡关系、重力效果和场景布局,单独训练无法把这些知识汇合起来。
另一种思路是把动作渲染成控制视频,再沿用视觉条件模型。只要动作本身能画出来,这种方法就有清晰的像素对应关系。但力没有天然外观,相机按键也不等同于真实画面;为它们手工设计可视化和渲染器,仍然需要一种又一种专用接口。
还有一类方法是给每种动作训练独立编码器,再把编码结果变成 token,通过交叉注意力注入视频模型。它比渲染方法更灵活,但动作发生在哪一帧、作用于画面哪个位置,只能隐含在编码器输出的特征中。对于手部和机器人姿态这类要求精确空间对应的任务,这种间接关系容易成为瓶颈。
论文的出发点可以概括为一个简单观察:无论原始动作长什么样,世界模型真正需要知道的是两件事,这是什么动作,以及它在何时、何处生效。只要把这两部分分别表示出来,四类看似不同的输入就可以进入同一条条件化通路。
方法总览:把动作变成共享时空中的稀疏点集
UniAction 的条件生成目标仍然是一个标准的视频扩散目标:模型根据初始帧、文本提示和动作生成未来视频。
$$p_\theta(V\mid I_0,T,A)$$
关键变化在动作 $A$ 的表示。论文把任意动作写成 $N$ 个动作元素,每个元素由一个离散语义身份 $s_i$ 和一个连续时空坐标 $\mathbf p_i$ 构成。
$$A=\{(s_i,\mathbf p_i)\}_{i=1}^{N},\qquad \mathbf p_i=(t_i,y_i,x_i)$$
这里的 $t_i$ 表示动作生效的时间,$y_i$ 与 $x_i$ 表示它在画面中的空间位置。一个动作可以使用很少的元素,也可以使用很多元素;语义身份可以来自不同动作族,但最终都遵循这套统一结构。
flowchart LR
  F[Force: 2 endpoint tokens] --> S[Sparse action set]
  C[Camera: 8 command identities] --> S
  H[Hand: visible joints] --> S
  R[Robot: visible link joints] --> S
  S --> E[Shared semantic codebook]
  S --> P[Time and image coordinate]
  E --> J[Append to video token sequence]
  P --> J
  J --> ROPE[Native 3D RoPE grounding]
  ROPE --> A[Cardinality-calibrated self-attention]
  A --> W[Shared video world model]
图 1:左侧是四类彼此异质的动作和传统的一类一模型方案,右侧是 UniAction 用一个联合模型完成四类控制后得到的动作跟随成绩。图中红柱说明统一模型在所有动作族上都超过对应专家模型。
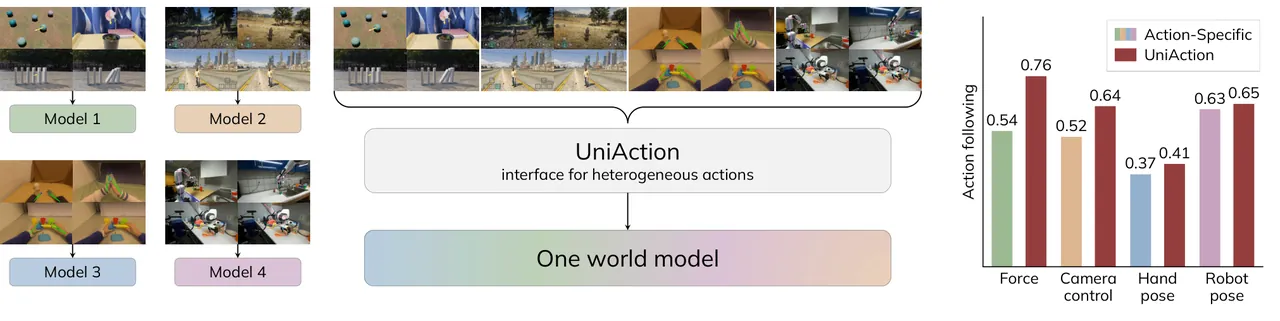
图 1:一个世界模型接收多类动作,并在四类任务上超过各自独立训练的专家模型。
语义身份:共享词表而不是四套编码器
每个动作元素先映射到共享语义词表中的离散身份 $s_i$。词表用一个可学习矩阵 $E$ 保存每个身份对应的 $d$ 维 token,其中 $d$ 与视频 token 的隐藏维度一致。
$$E\in\mathbb R^{|\mathcal S|\times d},\qquad \mathbf a_i=E[s_i]\in\mathbb R^d$$
这种表示把“动作含义”和“动作位置”分开。比如两个不同的手部关节可以共享同一套 token 维度,但在词表中拥有不同索引;同一种动作在不同画面位置也能复用同一个语义 token。模型不必为每个位置重新学习一套完全独立的动作含义。
词表并不要求所有动作共享原始数值空间。力的头尾角色、八个相机命令、手部关节编号和机器人关节编号都可以成为词表中的身份。新增动作族时,原则上只需增加身份并继续联合训练,而不必重写整个视频主干。
时空坐标:直接复用视频主干的 3D RoPE
动作发生的位置不能只靠一个独立编码器表示。UniAction 把动作坐标送进视频模型的空间压缩和 token 化流程,再将它们映射到主干已经使用的三维旋转位置编码。设 $\Phi_{\mathcal B}$ 为视频主干的位置编码机制,则动作 token 和视频 token 分别得到:
$$\widetilde{\mathbf a}_i=\Phi_{\mathcal B}(\mathbf a_i,\mathbf p_i),\qquad \widetilde{\mathbf v}_j=\Phi_{\mathcal B}(\mathbf v_j,\mathbf p_j^v)$$
这一步是方法与普通条件 token 的关键差异。交叉注意力方法也可以编码动作的时间与位置,但这些信息存在于另一个学习空间中;UniAction 则让动作与视频 token 进入同一套时空几何。动作坐标先经过主干的 VAE 压缩和 token 网格换算:
$$\mathbf p_i^{\mathrm{lat}}=g_{\mathcal B}(\mathbf p_i)$$
然后,动作 token 被直接追加到视频 token 序列之后,并通过主干原生自注意力共同计算:
$$[\mathbf v_1,\ldots,\mathbf v_M,\mathbf a_1,\ldots,\mathbf a_N]$$
因此,相同语义身份在不同位置出现时可以使用同一个 $E[s_i]$,位置差异完全由原生位置几何承担。相比从头学习动作与视频的对应关系,这种做法直接借用了视频预训练中已经形成的时空先验。
图 2:四类动作先在语义身份和时空坐标上统一,再与视频 token 拼接,经原生 3D RoPE 和基数校准注意力进入 Wan2.2 主干。
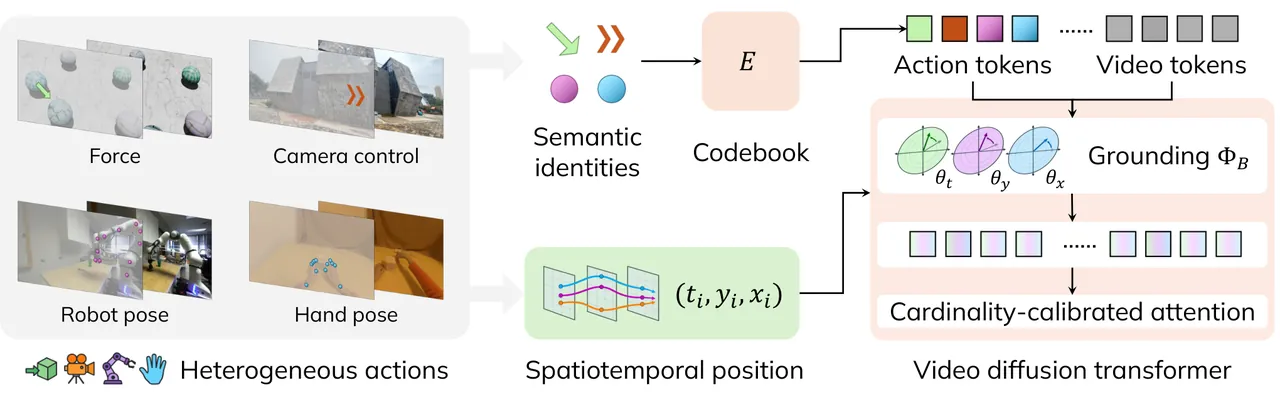
图 2:UniAction 的语义词表、时空定位与联合注意力流程。
四类动作如何实例化
手部姿态是逐帧逐关节的密集序列。论文将关节编号作为语义身份,每个可见关节在每一帧生成一个动作元素,其坐标就是该关节在图像中的位置。机器人姿态同理,只是身份来自具体机器人的关节结构。两类数据因此不需要把骨骼或机器人型号强行投影成同一种原始向量。
相机控制包含四个平移命令和四个旋转命令,本身没有天然图像坐标。论文给每个方向指定画面边缘的固定规范位置;同一方向上的平移与旋转共享位置,但使用不同语义身份加以区分。每当某个键处于激活状态,就在该帧生成一个动作元素。
力是一个瞬时向量,单个点无法同时表达作用起点、方向和大小。UniAction 用两个动作元素表示一次力:一个位于力向量尾部,一个位于头部,两者语义身份分别标记起始和终点,位置差就编码了力向量。官方代码甚至把这个约束写成输入检查,每次力必须恰好有两个 token。
基数校准:稀疏动作不应被密集姿态淹没
当动作 token 和视频 token 放入同一个注意力序列后,又出现新的偏差。一个机器人姿态可能包含大量关节和时间点,而一次力只有两个 token。如果不做处理,注意力分配给一整类动作的总质量会随 token 数量增长,模型可能把“表示更密”误当成“动作更重要”。
论文先分析一个视频查询对所有动作 token 的总未归一化注意力质量:
$$Z_a=\sum_{i=1}^{N}\exp(\ell_i^a)=N\cdot\operatorname{mean}_i[\exp(\ell_i^a)]$$
可以看到,总质量中乘了一个仅由 token 数量决定的因子 $N$。为了消除表示粒度的影响,方法给所有动作 logit 加同一个偏移:
$$\hat\ell_i^a=\ell_i^a+\log\frac{N_{\mathrm{ref}}}{N}$$
其中 $N_{\mathrm{ref}}$ 是固定参考基数,主实验取 784。由于所有动作 token 加上同样的量,动作 token 之间的相对排序不变;改变的是动作族与视频 token 之间的总注意力尺度。校准后的视频输出可以写为:
$$[A_v\mid A_a]=\operatorname{softmax}([L_v\mid L_a+b]),\qquad b=\log\frac{N_{\mathrm{ref}}}{N_a}$$
$$O_v=A_vV_v+A_aV_a$$
这部分设计看似只是一个 logit 偏移,却解决了统一 token 序列中的一个结构性问题:模型可以同时接受不同粒度的动作,而不会默认让 token 更多的表示获得更强控制。
实验设置:四个数据集、同一主干、同一预算
主实验从 GoalForce、SolarWM、EgoDex 和 DROID 中各取 1 万段动作标注视频,总计 4 万段。每段采样为 81 帧,并调整到 832×480。GoalForce 内部包括 5 千段球体、2.5 千段多米诺和 2.5 千段花朵场景。
生成主干采用 Wan2.2-I2V-A14B 的高噪声专家,通过 LoRA 适配。动作适配阶段只更新动作分支,视频分支保持冻结;LoRA rank 与 alpha 都是 128,动作 token 通过主干自注意力与视频 token 交互。主要模型约有 4.04 亿可训练参数。
动作跟随评测不是简单看视频是否“像训练数据”,而是在 107 个源样本上固定初始帧和文本提示,只改变动作条件,构造 410 个反事实生成。例如旋转或反转力、改变相机方向、翻转或固定姿态轨迹。然后用 DIS 光流、CoTracker3 和 ViPE 分别测量物体、关键点和相机响应,归一化到零到一。
力的方向评分直接比较估计方向与目标方向:
$$s_{\mathrm F}=C\left(\frac{\hat{\mathbf f}^{\top}\mathbf f}{\|\hat{\mathbf f}\|\,\|\mathbf f\|}\right)$$
其中 $C(x)$ 将结果截断到零到一。若生成视频根本没有有效运动响应,该样本得零分。除自动指标外,作者还组织了 60 个案例、100 名参与者的人评,每个视频按动作跟随和视觉质量做 1 到 5 分评分。
主结果:统一接口同时提升跟随与视觉质量
与视觉条件方法 VACE 和交叉注意力方法 Cross-Attn 相比,UniAction 在四类动作上的动作跟随分数都最高,LPIPS 都最低。提升最明显的是力、手部姿态和机器人姿态;相机控制上的优势也很稳定。
| 动作 | 方法 | 动作跟随↑ | LPIPS↓ | 人评动作跟随↑ | 人评视觉质量↑ |
|---|---|---|---|---|---|
| 力 | VACE | 0.6046 | 0.1178 | 2.47 | 3.40 |
| 力 | Cross-Attn | 0.1618 | 0.1341 | 1.96 | 3.13 |
| 力 | UniAction | 0.7630 | 0.1163 | 4.37 | 4.00 |
| 相机 | VACE | 0.4997 | 0.5100 | 3.30 | 3.55 |
| 相机 | Cross-Attn | 0.5306 | 0.5124 | 3.13 | 3.35 |
| 相机 | UniAction | 0.6371 | 0.4863 | 4.02 | 3.68 |
| 手部 | VACE | 0.2938 | 0.1122 | 3.30 | 3.43 |
| 手部 | Cross-Attn | 0.0678 | 0.1695 | 2.34 | 3.12 |
| 手部 | UniAction | 0.4119 | 0.0910 | 3.36 | 3.42 |
| 机器人 | VACE | 0.5245 | 0.1389 | 3.60 | 3.73 |
| 机器人 | Cross-Attn | 0.0859 | 0.1859 | 2.07 | 3.44 |
| 机器人 | UniAction | 0.6521 | 0.1164 | 4.32 | 3.99 |
交叉注意力在机器人和手部任务上的自动分数很低,这与它的机制一致:动作编码器虽然能接收原始信号,却需要从有限数据里重新学习动作 token 与画面位置的对应。VACE 在有可渲染控制图时更有竞争力,但在力和相机控制上没有天然视觉表示,UniAction 的优势因此更大。
图 3:四类动作的条件视频对比。叠加箭头、按键和骨架表示输入动作,UniAction 的动作落点、方向和姿态变化更接近指定条件。
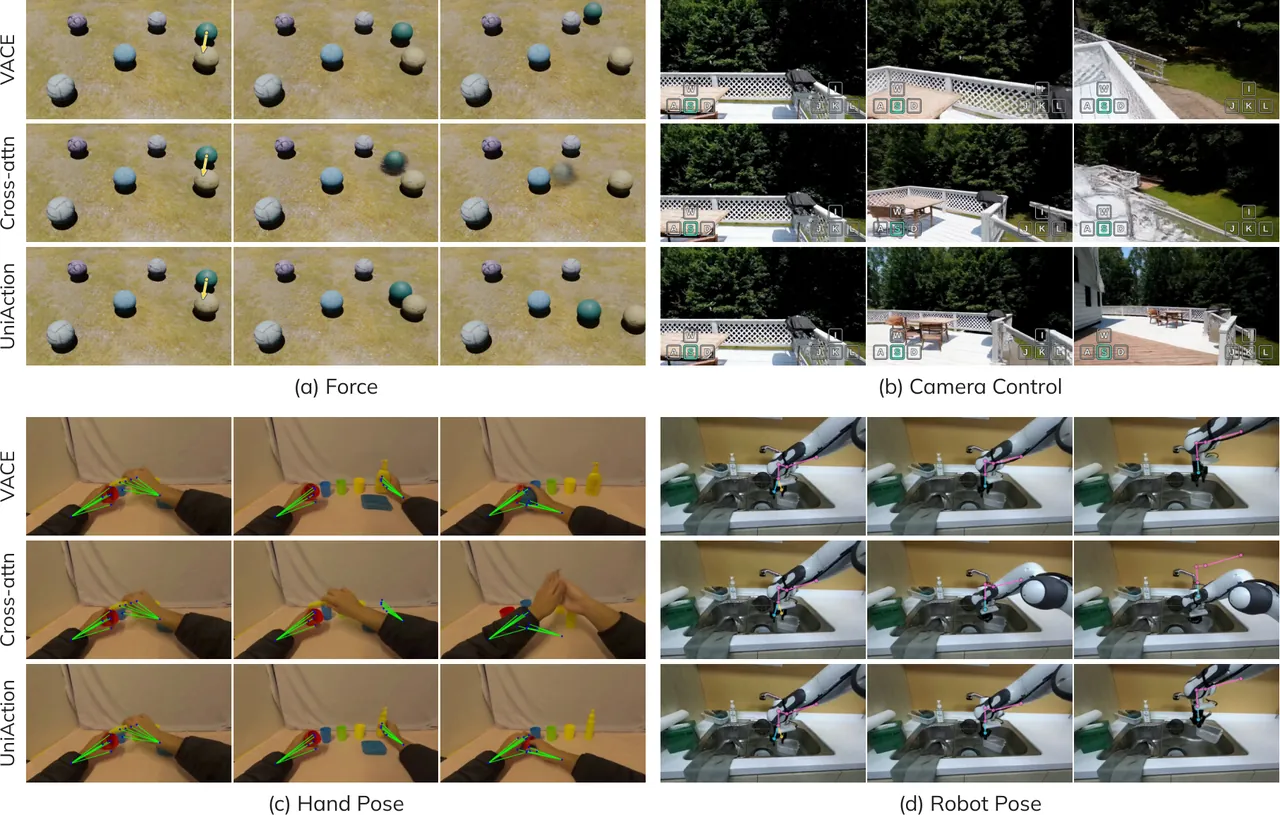
图 3:VACE、Cross-Attn 与 UniAction 在四类动作上的定性对比。
联合训练比四个专家模型更强
统一表示的第二个价值是让不同动作的数据互相补充。作者为每类动作训练同构专家模型,并确保每个专家和联合模型看到相同样本、相同次数。四个专家合起来相当于一个四倍参数、按动作类型硬路由的模型,消耗的总计算量也与联合训练相当。
| 动作 | 专家动作跟随↑ | 联合 UniAction↑ | 专家 LPIPS↓ | 联合 UniAction↓ |
|---|---|---|---|---|
| 力 | 0.5436 | 0.7630 | 0.1295 | 0.1163 |
| 相机 | 0.5182 | 0.6371 | 0.4780 | 0.4863 |
| 手部 | 0.3701 | 0.4119 | 0.0934 | 0.0910 |
| 机器人 | 0.6310 | 0.6521 | 0.1286 | 0.1164 |
联合模型在四类动作的动作跟随分数上全部超过专家,在 LPIPS 上三项更好、相机项仅略高 0.0083。这个结果比单纯超过 VACE 或交叉注意力更有说服力,因为它比较的是同一架构、同一数据预算和同一训练量下“共享参数”与“按任务拆模型”的差别。
作者将收益归因于共享世界知识。只训练力的专家无法从机器人操作视频里学习机械结构和遮挡,只训练机器人的专家也无法从力的视频里学到材料响应;联合训练则让一门动作的数据补足另一门动作对场景动力学的理解。
图 4:联合训练的 UniAction 位于每组的第二行。与第一行的动作专家相比,它更准确地执行力、相机、手部和机器人条件,并减少不合理形变。
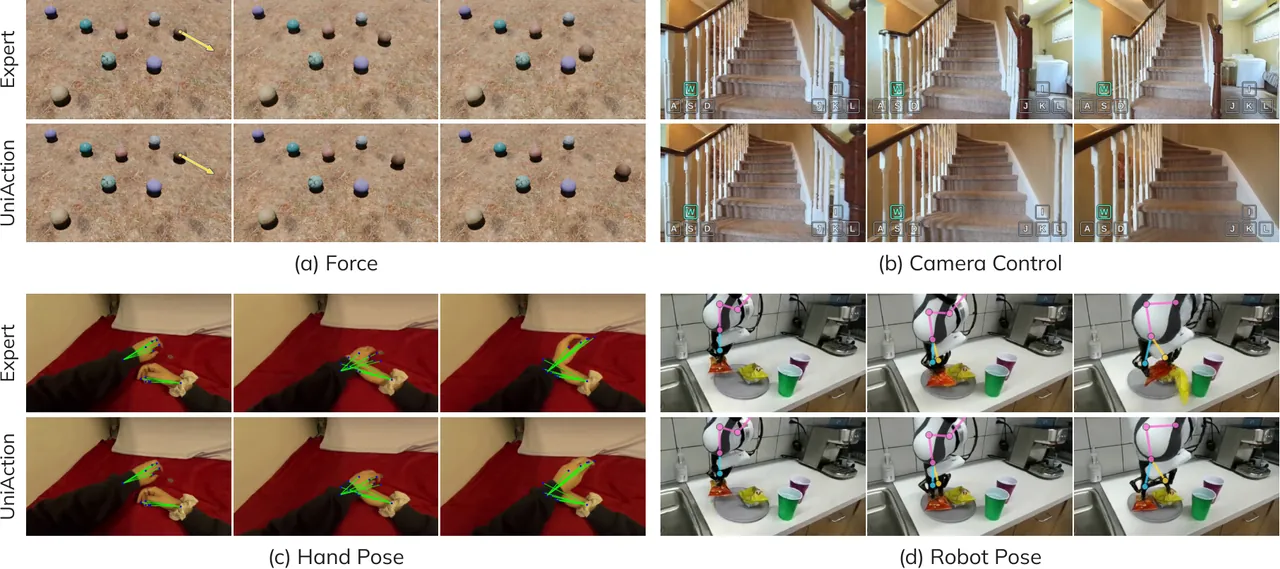
图 4:联合训练模型与四类动作专家模型的定性比较。
消融:原生位置几何比“有坐标”更重要
作者用 Wan2.2-TI2V-5B 做消融,比较把动作坐标保留但改走交叉注意力、把 3D RoPE 换成固定正弦 APE 或可学习 APE、以及去掉基数校准的结果。三种位置几何替代方案在需要精确空间控制的手部和机器人任务上几乎失效。
| 变体 | 力 | 相机 | 手部 | 机器人 |
|---|---|---|---|---|
| 自注意力改为交叉注意力 | 0.2975 | 0.5050 | 0.0533 | 0.0733 |
| RoPE 改为正弦 APE | 0.2084 | 0.5278 | 0.0603 | 0.0755 |
| RoPE 改为可学习 APE | 0.1485 | 0.5206 | 0.0656 | 0.0693 |
| 去掉基数校准 | 0.5186 | 0.4966 | 0.4303 | 0.6995 |
| UniAction | 0.7190 | 0.5842 | 0.4266 | 0.7004 |
这里有一个细节值得注意:去掉基数校准后,手部和机器人的分数甚至略高于完整模型,而力和相机明显下降。这恰好验证了论文的偏差分析。姿态 token 多,未校准时会获得更强注意力;稀疏动作 token 少,则被压制。完整模型通过牺牲一点密集姿态的绝对分数,换来两类稀疏动作的大幅提升,使共享模型在四类控制间更均衡。
时间泛化实验进一步说明复用预训练位置几何的价值。训练时力只出现在第 0 帧,测试时把力推迟到第 8 帧和第 24 帧。UniAction 的物体运动会在指定时间开始,而可学习绝对位置编码因为没见过来自这些时间槽的监督,几乎不会随动作时刻移动。
图 5:两组模型都只在第 0 帧见过力。UniAction 在测试时把力推迟到第 8 帧或第 24 帧后,仍能延迟触发相应运动;可学习 APE 对未见时间槽几乎没有响应。
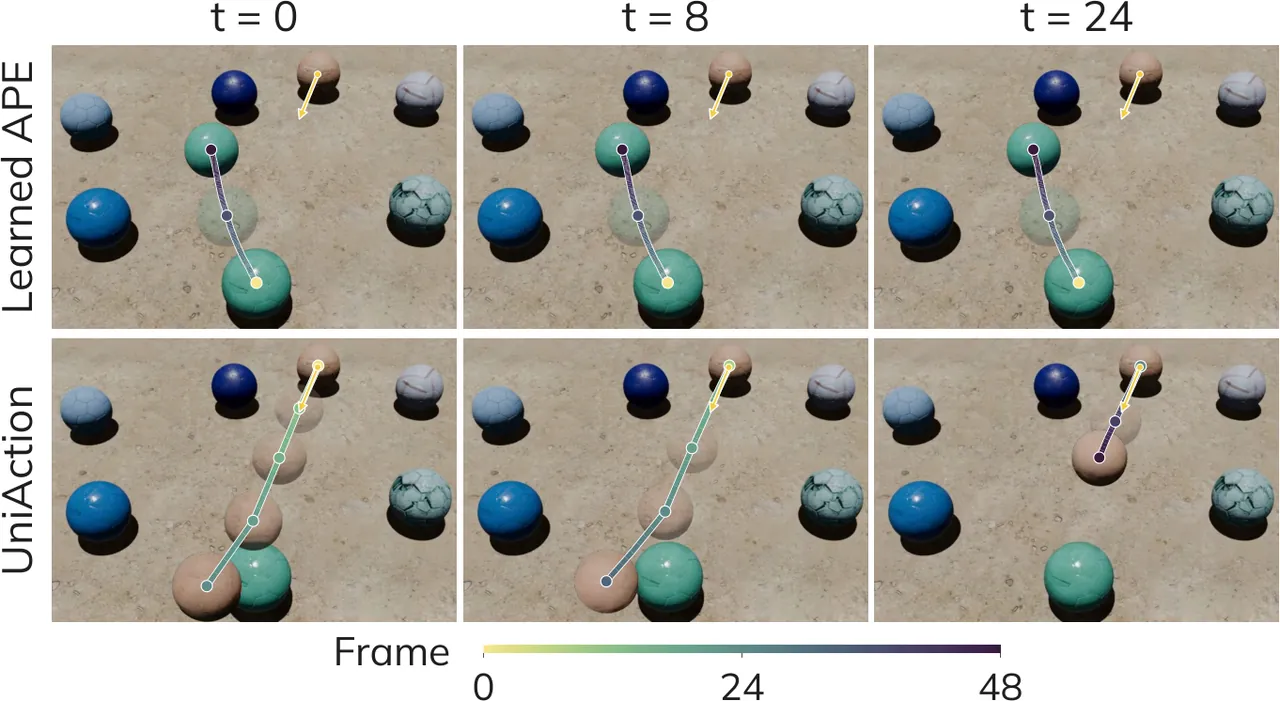
图 5:力作用时间从训练时的第 0 帧迁移到第 8 与第 24 帧。
效率并非全部占优
统一接口的参数成本明显低于 VACE 和交叉注意力:UniAction 约 4.04 亿可训练参数,VACE 约 31 亿,交叉注意力约 6.4 亿。单次去噪前向中,UniAction 的额外延迟在四类动作上均低于另外两种方法,但手部动作的额外计算量达到 72.9 TFLOPs,说明把大量关节 token 放入自注意力仍会带来 token 长度成本。
| 方法 | 可训练参数 | 额外 TFLOPs | 额外延迟 |
|---|---|---|---|
| VACE | 3.1B | 351.2,四类相同 | 约 21% |
| Cross-Attn | 640M | 33.5 到 36.0 | 8.6% 到 9.0% |
| UniAction 力 | 404M | 0.1 | 3.6% |
| UniAction 相机 | 404M | 5.9 | 3.0% |
| UniAction 手部 | 404M | 72.9 | 6.6% |
| UniAction 机器人 | 404M | 37.2 | 4.9% |
图 6:补充的力定性比较。UniAction 对多米诺的初始受力和后续连锁倒向保持更准确的对应。
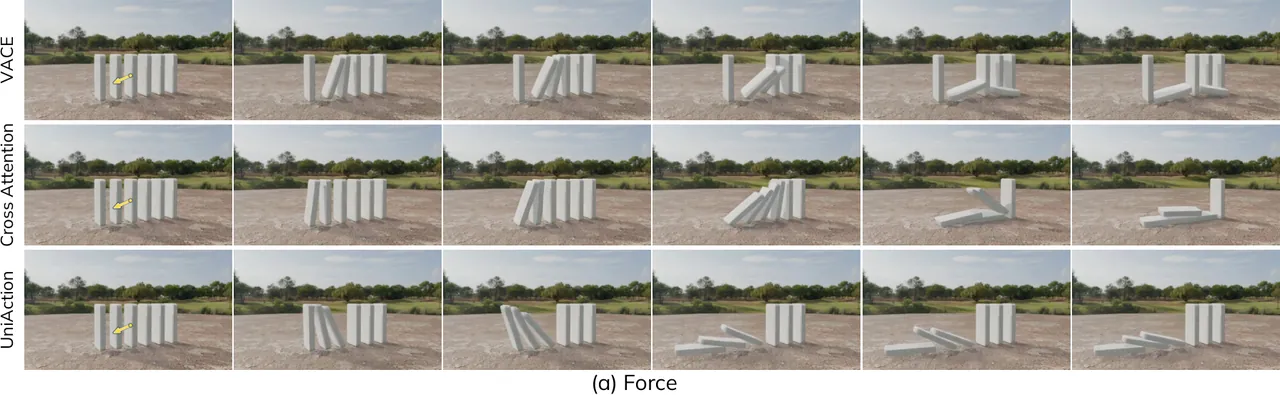
图 6:补充力作用案例,三行分别为 VACE、Cross-Attn 和 UniAction。
代码对应:论文中的三个关键约束都能在实现里找到
官方代码把主要输入规格和参考基数直接写成不可变配置。81 帧、480×832、手部 16 个身份、相机 16 个身份、机器人 12 个身份与 $N_{\mathrm{ref}}=784$ 都不是只出现在论文附录里的文字,而是运行时的结构参数。
# src/uniaction/model/action.py:22-37
@dataclass(frozen=True)
class UnifiedActionConfig:
    l_max: int = 32
    num_frames: int = 81
    dit_dim: int = 5120
    video_height: int = 480
    video_width: int = 832
    hand_vocab_size: int = 16
    camera_vocab_size: int = 16
    robot_vocab_size: int = 12
    force_start_token_id: int = 0
    force_endpoint_token_id: int = 3
    action_reference_count: float = 784.0
力的“两点表示”也被实现强化为一组严格检查。代码要求每条力恰好包含一个起点 token 和一个终点 token,并且两者的时间坐标都为 0。这说明论文不是仅用箭头示意力,而是把作用点、方向与大小落实成两个位于同一时刻的动作元素。
# src/uniaction/model/action.py:191-209
if count != 2:
    raise ValueError(f"force requires exactly two tokens, got {count}")
start = ids == self.force_start_token_id
endpoint = ids == self.force_endpoint_token_id
if not bool(((start.sum(dim=1) == 1) & (endpoint.sum(dim=1) == 1)).all()):
    raise ValueError("force requires one start token and one endpoint token")
if not bool((time_ids.float() == 0).all()):
    raise ValueError("force start and endpoint RoPE must both use time zero")
tokens = torch.where(
    start.unsqueeze(-1),
    start_token.expand(batch, count, -1),
    endpoint_token.expand(batch, count, -1),
)
return self.force_token_norm(tokens)
位置对齐由 `wan_rope_at_positions()` 和 `_action_freqs()` 完成。实现先从视频序列长度推断三维修正网格,再把归一化图像坐标换算成高度、宽度网格位置,把动作时间换算成潜空间帧位置,最后按时间、高、宽三个轴生成 RoPE 频率。这正是论文中 $g_{\mathcal B}$ 与 $\Phi_{\mathcal B}$ 的代码落点。
# src/uniaction/model/action.py:452-476
t_pos = time_ids * (float(f - 1) / float(adapter.num_frames - 1))
v_norm = uv[:, 1].clamp(0.0, 1.0)
u_norm = uv[:, 0].clamp(0.0, 1.0)
h_pos = (v_norm * float(h) - 0.5)
w_pos = (u_norm * float(w) - 0.5)
state.freqs = torch.cat(
    [
        wan_rope_at_positions(t_pos, dim_t),
        wan_rope_at_positions(h_pos, dim_h),
        wan_rope_at_positions(w_pos, dim_w),
    ],
    dim=-1,
)
基数校准也有直接对应实现。动作 logit 的偏移由一个不可训练的对数参考量减去实际 token 数的对数得到,因此每一类动作都获得与自身稀疏程度相关的统一平移。
# src/uniaction/model/action.py:510-520
def action_key_log_weight(
    *,
    video_token_count: int,
    action_token_count: int,
    action_log_reference: torch.Tensor,
) -> torch.Tensor:
    if video_token_count <= 0 or action_token_count <= 0:
        raise ValueError("video and action token counts must be positive")
    if action_log_reference.numel() != 1:
        raise ValueError("action_log_reference must be scalar")
    return action_log_reference.reshape(()) - math.log(float(action_token_count))
局限与风险
第一,作者在动机中明确指出动作标注数据稀缺,并且集中在有限的场景和交互模式里。这解释了统一训练的必要性,但也意味着四类数据并不能自动覆盖开放世界。联合模型学到的共享知识,很可能仍受 GoalForce、SolarWM、EgoDex 与 DROID 的采集分布约束。
第二,论文只验证了四种手工定义的动作形式,以及数量有限的语义身份。真实机器人平台的关节数量、传感模态和控制频率变化更大;开放动作词表、更多机器人本体、跨本体映射和长时闭环控制都还没有得到证明。某些动作也需要专门的预处理,例如姿态关键点可见性和力的头尾点标注。
第三,核心评测是生成视频是否跟随动作,而不是机器人在物理环境中的任务成功率。自动指标依赖 DIS、CoTracker3 和 ViPE 等现成估计器,它们的失败模式会进入最终分数。动作跟随分数高,只能说明视频层面的响应正确,不能直接等同于可执行的机器人控制策略。
第四,方法依赖 Wan2.2 这类大型视频主干。主实验使用 A14B 高噪声专家,消融使用 5B 模型;参数量、显存和推理成本仍然很高。虽然相对 VACE 的条件开销更小,但手部动作把大量关节 token 送入自注意力时仍有明显计算增长。
结论
UniAction 的贡献不只是把四种输入塞进一个模型,而是找到了一种能跨原始形式成立的共同语言:离散语义回答“做什么”,连续坐标回答“何时何处做”。原生 3D RoPE 让这种语言与视频主干共享时空结构,基数校准又避免密集表示压过稀疏表示。
实验上最重要的证据不是某一个最高分,而是联合训练的模型在四类动作上同时超过各自的同构专家。它说明动作数据之间的差异没有大到必须永远拆开,统一表示使共享的场景和动力学知识真正发生了迁移。对机器人世界模型而言,这是从“一个任务一套控制接口”走向“一个模型持续吸收多种干预经验”的可行起点。
金句:统一动作不是抹平输入,而是保留每种动作的语义与坐标,再把它们放进世界模型已经理解的那套时空。