PAPER DEEP DIVE
Fast-VLA:机器人操作只需一次思考
冻结的 4B 视觉语言模型仅在每次任务开始时构建多层 KV 记忆,在线轻量动作器持续读取实时视觉、机械臂状态和历史视角生成动作。Fast-VLA 在 RoboTwin 达到 92.43%,并将摊销推理加速 10.9–17.1 倍。
论文元信息
论文:Fast-VLA: You Only Think Once for Robot Manipulation
作者:Kehong Gong、Guanli Hou、Xiaoxu Zheng、Qi Wang、Mingxi Xu、Anbang Zhai、Xiaoyu He、Mingyuan Zhang、Michael Bi Mi。
机构:Huawei Central Research Institute。
时间与入口:arXiv v1 发布于 2026 年 10 月 15 日;论文 abs;项目页;官方代码;模型权重。
核验范围:本文依据论文全文、官方仓库提交 ad69ea0f32595801a015dfbd70fb77876d694752、公开项目页与静态实验图表撰写。速度结论均指论文在相同硬件、统一计时口径下报告的摊销策略推理时间,不等同于完整机器人系统的端到端控制周期。
一句话总结
Fast-VLA 把“理解任务”和“跟踪世界状态”拆到两个时间尺度:冻结的 4B 视觉语言模型只在回合开始时读取一次指令与初始多视角图像,并把结果保存成 34 层 KV 任务记忆;此后轻量动作器直接读取实时图像、机械臂状态和历史视角,持续输出动作块,而不再重新运行大模型。
研究背景:任务理解很慢,机器人状态变化很快
现有视觉语言动作模型通常把多十亿参数的主干网络放进控制闭环。每当策略需要预测新动作块,模型都要重新编码当前画面和语言指令。视觉语言主干擅长提供物体语义、空间关系与任务目标,但这种调用频率与控制频率并不匹配。机器人每几十毫秒就要修正姿态,任务描述却通常在一个回合内保持不变。
这种错配造成两个后果。第一,大模型参数、视觉 token 与注意力计算反复进入在线路径,使单步延迟难以压低。第二,部署时既要容纳视觉语言模型,又要保留动作生成模块,在线常驻内存和峰值显存都很高。已有方法会缩短动作 token、并行解码或减少动作去噪步数,但如果每次都重新让大模型理解同一条指令,主干调用仍是结构性开销。
另一条路线缓存历史表示。例如只复用相邻帧中视觉变化较小的 token,或把最近若干帧的键值保存在注意力和记忆中。它们承认场景具有时间连续性,却仍把大量任务语义计算留在重复路径。论文追溯这种设计把大模型当作一个随每个动作块刷新的“世界解释器”。
作者提出的观察更简单:任务理解与动作控制可以分层。人拿起杯子之前会先确定目标、识别物体并形成大致计划,真正伸手时主要依据当前视觉与本体感觉修正运动,不必每挪动一厘米就重新解释整条指令。Fast-VLA 因而把一次回合级推理变成固定记忆,把闭环性交给轻量在线动作器。
难点并没有消失。固定记忆无法表示正在移动的手臂、刚被打开的抽屉或已经被抓住的物体。系统必须让当前观测有能力“查询”旧任务上下文,使同一份固定任务记忆在不同时刻产生不同读取结果。Fast-VLA 的技术重点正是这套查询、融合与动作解码机制。
论文在 RoboTwin 2.0、LIBERO 与 LIBERO-Plus 上验证方法。RoboTwin 2.0 的 Clean 与 Randomized 成功率分别为 92.46% 和 92.40%,均值 92.43%。在标准 LIBERO 与 LIBERO-Plus 上分别为 95.95% 和 79.11%。与三个持续调用大模型的基线相比,RoboTwin 摊销推理时间降低 10.9 至 17.1 倍。
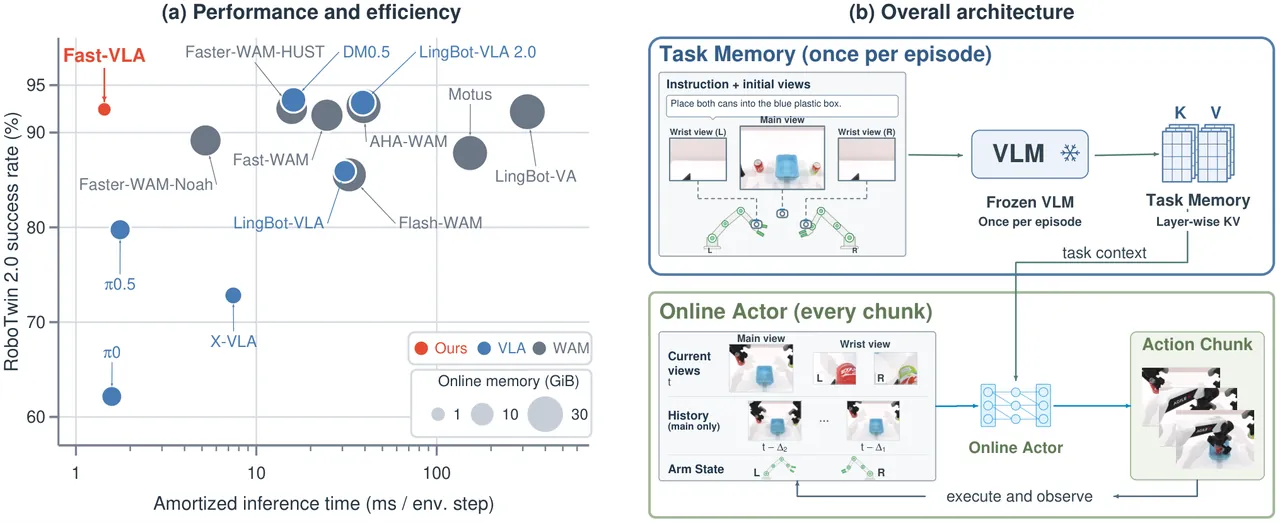
图 1:左侧比较 RoboTwin 2.0 上的成功率与摊销延迟,气泡面积对应在线常驻内存;右侧展示冻结视觉语言模型只构建一次多层 KV 任务记忆,在线动作器持续查询该记忆并预测 50 步双臂动作。
方法总览:先建立任务记忆,再持续进行状态查询
给定语言指令 $L$ 和回合初始的多相机图像 $I_0$,冻结视觉语言模型生成任务记忆:
$$M_0 = G_{\mathrm{VLM}}(L,I_0)$$
$M_0$ 不是一段自然语言摘要,也不是单个全局向量,而是视觉语言模型各层前缀 token 的键和值。RoboTwin 使用三张初始图像,每张图像包含 256 个软 token;这些图像 token 与指令 token 共同组成前缀。模型缓存其中的 34 层键值,因此任务记忆保留了从浅层视觉关联到深层语义组织的多层信息。
在每个动作块边界,在线动作器接收当前图像 $I_t$、可选历史 $H_t$ 与机械臂本体状态 $q_t$,先编码在线观测:
$$Z_t = G_{\mathrm{online}}(I_t,H_t,q_t)$$
随后,动作器把当前状态转化为动作查询,读取固定记忆并一次预测未来 $K$ 步:
$$\hat{A}_{t:t+K-1}=F_{\mathrm{pred}}(Z_t;M_0)$$
这个分解没有取消闭环。变化的观测和状态不断重写在线特征与动作查询,固定不变的只是任务级 KV。动作器每个动作块执行一次,策略每执行部分动作后重新观察环境、更新输入并生成下一块。因此“只思考一次”准确指视觉语言模型只做一次任务情境化,不指机器人仅预测一次就结束回合。
flowchart LR
  I["初始多视角图像
与语言指令"] --> V["冻结 DM0.5
一次前缀计算"]
  V --> M["34 层 KV
任务记忆"]
  O["当前多视角图像
历史视角与机械臂状态"] --> D["DINOv2 视觉编码
与查询融合"]
  M --> X["跨记忆注意力
读取任务上下文"]
  D --> X
  X --> H["动作头
一次前向"]
  H --> A["RoboTwin 50 x 14
LIBERO 10 x 7"]
方法详解:固定记忆如何被实时观测反复读取
1. 回合级记忆由 34 层键值集合构成
论文将任务记忆明确写为不同深度缓存层的集合:
$$M_0=\{(K_0^\ell,V_0^\ell)\}_{\ell=1}^{34}$$
$K_0^\ell$ 与 $V_0^\ell$ 是冻结视觉语言模型第 $\ell$ 层在“指令加初始图像”前缀上的键和值。浅层 token 更接近局部外观与位置,深层 token 更偏向物体关系与任务语义。只保留最后一层会丢失这种多尺度结构,论文的消融也显示完整 34 层在标准 LIBERO 与 LIBERO-Plus 上都优于单层版本。
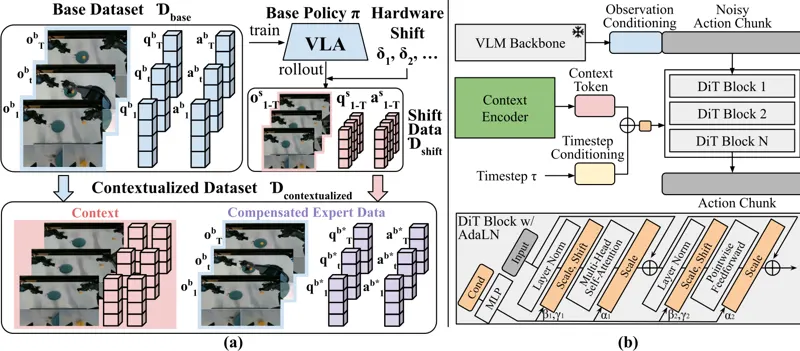
训练时没有必要为每个动作样本重复运行视觉语言模型。由于该模型完全冻结,仓库脚本预先计算并保存每个训练回路的 KV bank,动作器训练直接读取这些缓存。RoboTwin bank 使用 22 个 FP8 分片,约 1.6 TiB;LIBERO bank 使用 2 个 BF16 分片,约 150 GiB。体量说明“一次推理”并不等于记忆免费:它把在线重复计算换成了离线缓存与每回合一次的高成本预填充。
2. 在线视觉编码器负责观察变化
RoboTwin 配置以 DINOv2 ViT-B/14 分别编码头部与两个腕部相机。相同相机的当前帧和历史帧共享编码器权重,再用相机槽位与时间槽位嵌入区分来源。论文采用的时间偏移为 -17、-8 和 0,即保留两帧头部历史与当前三路视图。历史视角不是任务记忆的一部分,它们只描述近期运动与遮挡变化。
每个腕部图像的 CLS token 会与对应手臂的七维状态共同形成局部条件。机械臂状态包含关节或末端执行器控制相关维度,最后一位对应夹爪。某只手臂的动作查询只接收该手臂的腕部 CLS 与状态,这减少了左右臂条件串线的风险。共享的跨视觉注意力仍能让所有动作查询读取三路相机的视觉 token。
3. 时间与手臂索引给动作查询一个稳定骨架
动作器为未来第 $\tau$ 步和第 $a$ 只手臂初始化一个查询向量:
$$z_{\tau,a}^{(0)}=e_{\mathrm{time}}(\tau)+e_{\mathrm{arm}}(a),\quad \tau\in\{0,\ldots,49\}$$
RoboTwin 的 $K=50$,两只手臂各有七维动作,因此一次输出 50 乘 14 的绝对关节命令。LIBERO 使用单臂、$K=10$ 与七维动作,输出 10 乘 7。时间嵌入让不同未来步不必共享完全相同的查询,手臂嵌入让左右臂在自注意力中拥有明确角色。
当前腕部 CLS 与状态经过线性投影和角色嵌入拼接,再由 MLP 形成局部反馈。门控残差把这份反馈加入每个未来时间步的对应手臂查询。此后四个动作解码层都会重新注入局部条件,避免随着层数加深而淡忘当前手臂位置与夹爪状态。
4. 解码层先看机器人周围,再读任务记忆
每个解码层依次执行自注意力、跨视觉注意力和跨记忆注意力。自注意力对齐同一动作块中的未来步与双臂;跨视觉注意力读取当前三路视图与历史头部帧,解决“物体现在在哪里”“手臂是否已经接近”等问题;跨记忆注意力再补上“这条指令要求做什么”“初始场景里目标与哪些物体有关”等回合级信息。
这个顺序有直观含义。动作首先需要落到眼前的视觉状态,然后才用任务记忆消除局部歧义。如果动作查询只关注固定记忆,它会知道目标却无法跟上物体移动;如果只关注当前帧,它又可能抓住外观相似的错误物体。两条注意路径共同提供状态与任务两种条件。
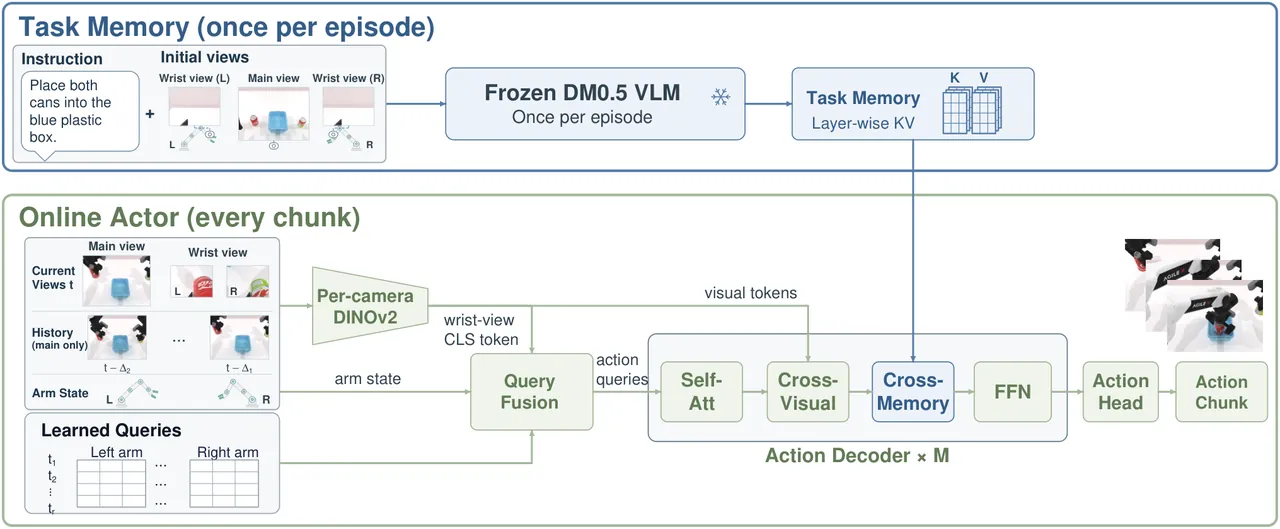
图 2:上方冻结模型只处理指令和初始视图,形成多层键值任务记忆;下方在线动作器融合当前与历史视觉、本体状态和时间/手臂查询,在四个解码层中交替读取视觉 token 与任务记忆,最后一次输出动作块。
5. KV 适配器不是简单拼接 34 层
不同视觉语言模型层使用各自位置的旋转位置编码,直接求平均会把不同相位空间的关键字混在一起。Fast-VLA 先从每个缓存键中撤销源层 RoPE,得到公共坐标中的键,再按可学习权重融合:
$$\alpha_{m,\ell}=\operatorname{softmax}_{\ell}(s_{m,\ell})$$
$$(\bar K_m,\bar V_m)=\sum_{\ell=1}^{34}\alpha_{m,\ell}(\mathcal{R}_{c\leftarrow\ell}(K_0^\ell),V_0^\ell)$$
这里 $m$ 表示动作解码层,$\mathcal{R}_{c\leftarrow\ell}$ 表示从源层到公共 RoPE 坐标的变换。融合后的键先做 RMSNorm,再经线性映射并使用目标解码层的位置编码;值经过另一条线性映射。这样每个解码层虽然读取同一份任务缓存,却可以选择不同深度的信息组合。
仓库实现进一步显示,路由权重不仅含静态层偏置,还由当前动作查询的均值决定:
$$w_m=\operatorname{softmax}(\alpha_m+\operatorname{Router}_m(\bar z_m))$$
也就是说,同一回合里不同动作块的视觉与状态输入可以改变“该读哪几层任务记忆”。权重网络最后一层初始化为零,训练起点仍以深度对齐层为主,不会在训练早期随机打散多层信息。
6. 动作生成是一次前向回归,而非迭代去噪
四个解码层完成后,线性动作头直接回归整块动作。在线动作器,包括 DINOv2 视觉编码器,使用归一化动作上的 L1 损失训练:
$$\mathcal{L}_{\mathrm{act}}=\frac{1}{KD}\sum_{k=0}^{K-1}\sum_{d=1}^{D}\left|\hat a_{t+k,d}-a_{t+k,d}\right|$$
这里 $D$ 是动作维度。与需要多步去噪的生成式动作专家相比,一次回归没有采样迭代,也不保留粒子或噪声状态。它牺牲了显式多模态分布建模,换来稳定的单次前向成本。论文没有把速度提升归因于某个单独技巧,而是来自大模型移出控制循环、四层动作解码器与一次前向动作头三者叠加。
7. 摊销延迟把一次性预填充也算进成本
设回合执行步数为 $H$、动作块长度为 $K$,预填充时间为 $T_{\mathrm{prefill}}$,动作器单块时间为 $T_{\mathrm{actor}}$,论文报告的每环境步摊销延迟为:
$$\frac{T_{\mathrm{prefill}}+\lceil H/K\rceil T_{\mathrm{actor}}}{H}$$
这个定义很关键。若只报告动作器毫秒数,会隐藏每回合第一次视觉语言模型预填充。Fast-VLA 的 RoboTwin 预填充为 108.87 毫秒,首个动作块总耗时 153.74 毫秒,后续块为 44.87 毫秒;按观测回合长度摊销后为每步 1.437 毫秒。LIBERO 预填充为 88.38 毫秒,动作块为 34.25 毫秒,摊销后为每步 3.975 毫秒。
8. 代码层面明确区分“回合缓存”与“在线调用”
官方 fastvla/policy.py 的 reset() 只把缓存设为空;第一次 act() 调用 build_cache(),后续调用沿用同一缓存并直接执行模型。若请求没有提供某个历史偏移,代码会回退到当前帧,而不是拒绝运行。这个行为保证了接口连续可用,但也意味着部署侧必须正确提供历史图片,否则策略会在不报错的情况下损失真实时间信息。
fastvla/model/cache_attn.py 中的 prepare_canonical_kv() 在 FP32 下撤销 34 层 RoPE,正是为了降低跨层融合时的相位误差;KVFusion 再学习权重、做键归一化和目标层重投影。fastvla/model/fastvla.py 的 QueryGrid 与 LocalCondition 分别实现时间/手臂查询网格和腕部 CLS、状态、角色嵌入融合。论文描述的模块与公开源码存在可核对的落点。
9. 训练数据与规模揭示了适用边界
RoboTwin 训练覆盖 50 个任务的 Clean 加 Randomized 数据,共 27,500 个回路,训练 200,000 步,有效批量为 256,约消耗 150 个加速器小时。LIBERO 使用四个套件、40 个任务的示范,共 2,000 个回路,训练 30,000 步,批量为 32,约 5 个加速器小时。视觉编码器从 DINOv2 初始化并微调,动作解码器与动作头从头训练。
这些数字说明论文主要验证在中大规模仿真示范内,动作器能否学会读取现成视觉语言表征。它没有证明同一动作器可以零样本迁移到真实机械臂,也没有证明离线 KV bank 在传感器分布变化时仍然有效。预填充峰值仍需约 12 GiB,更适合固定工作站或带独立推理节点的机器人系统,而不是直接塞入低功耗本体控制器。
实验分析:速度收益、任务成功率与记忆依赖
评测规模并不小。RoboTwin 每个任务在 Clean 与 Randomized 各跑 100 个回合,共 10,000 个回合;标准 LIBERO 的四个套件各 10 个任务,每个任务 50 个初始状态,共 2,000 个回合;LIBERO-Plus 则覆盖全部 10,030 个扰动实例。成功率之外,论文在相同硬件上单独测量每动作块时间、每环境步摊销时间与常驻内存。
RoboTwin 的结果表明,记忆复用没有以明显成功率下降换取速度。Fast-VLA 的 92.43% 均值低于 DM0.5 的 93.45%,也比 Faster-WAM HUST 的 92.52% 低 0.09 个百分点,但主要速度收益来自每次控制只运行动作器。DM0.5 每步 16.069 毫秒,Fast-VLA 每步 1.437 毫秒,前者是后者的 11.2 倍;相对 Faster-WAM HUST 与 Fast-WAM 分别为 10.9 倍与 17.1 倍。
| RoboTwin 2.0 方法 | Clean 成功率 | Randomized 成功率 | 平均成功率 | 摊销毫秒/步 | 相对 Fast-VLA |
|---|---|---|---|---|---|
| DM0.5 | 93.60% | 93.30% | 93.45% | 16.069 | 慢 11.2 倍 |
| Faster-WAM HUST | 92.60% | 92.44% | 92.52% | 15.704 | 慢 10.9 倍 |
| Fast-WAM | 91.90% | 91.76% | 91.83% | 24.624 | 慢 17.1 倍 |
| Fast-VLA | 92.46% | 92.40% | 92.43% | 1.437 | 基准 |
LIBERO 上的结论更混合。Fast-VLA 的 95.95% 是很有竞争力的标准基准成绩,但 LIBERO-Plus 的 79.11% 仍比 π0.5 低 6.59 个百分点,比 DM0.5 低 6.79 个百分点。作者指出这两个动作预训练基线拥有在外部动作数据上训练过的动作生成权重,而 Fast-VLA 的解码器与动作头在 LIBERO 示范上从头训练。这个差异不能完全归因于记忆机制,却也不能被忽略,因为真实部署往往同样重视扰动鲁棒性。
| LIBERO 方法 | 标准 LIBERO | LIBERO-Plus | 毫秒/块 | 摊销毫秒/步 | 在线常驻内存 |
|---|---|---|---|---|---|
| Faster-WAM Noah | 98.50% | 75.00% | 118.85 | 12.160 | 21.35 GiB |
| Faster-WAM HUST | 99.00% | 73.57% | 824.43 | 84.350 | 22.27 GiB |
| Fast-VLA | 95.95% | 79.11% | 34.25 | 3.975 | 0.86 GiB |
速度对比必须与动作执行策略一起读。RoboTwin 的 50 步块确实比许多基线更长,摊薄了每个动作块的固定开销;但论文报告的摊销每步同时计入首个动作块的预填充时间,并且使用公开的平均回合长度。真正需要继续核验的是系统级控制:视觉采集、坐标变换、安全限幅和通信是否会把毫秒级优势重新抬高。论文测量的是策略推理,而非机械臂执行闭环。
视觉注意力分析提供了记忆之外的另一条证据。在一个成功的 300 步叠积木回合中,头部相机注意力会随子目标从红块转向绿块,左右腕部相机分别关注本侧正在操作的物体。右腕甚至在第二阶段开始前就转向绿块。这不能证明策略拥有显式规划器,但说明在线视觉查询会随任务阶段改变,而不是一直复制初始帧。
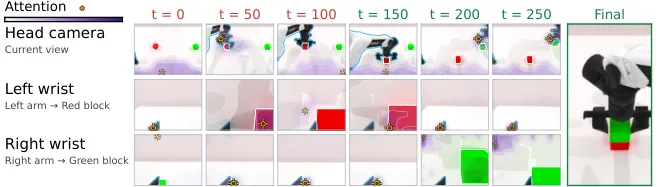
图 4:在一个 300 步双臂叠积木任务中,头部注意力随左右手分工从红块转向绿块,两个腕部相机则分别跟踪本侧目标。注意力变化表明固定任务记忆仍由不断更新的在线视觉输入来查询。
记忆消融:多层、图文联合比“有缓存”更重要
作者不只比较有无记忆,还改变缓存内容与深度。完全移除任务记忆时,LIBERO 与 LIBERO-Plus 降到 69.90% 和 53.69%;只保留文本 token 的 KV 可把标准 LIBERO 提升到 93.20%,但 LIBERO-Plus 只有 73.84%;只保留第 34 层则得到 94.70% 与 73.70%。完整 34 层同时使用指令和初始视图达到 95.95% 与 79.11%。
| 任务记忆构造 | 标准 LIBERO | LIBERO-Plus | 主要观察 |
|---|---|---|---|
| 无任务记忆 | 69.90% | 53.69% | 在线动作器缺少回合级目标 |
| 仅文本 token KV | 93.20% | 73.84% | 语言目标有效,但场景锚点不足 |
| 仅最后一层图文 KV | 94.70% | 73.70% | 单层语义强,扰动泛化有限 |
| 完整 34 层图文 KV | 95.95% | 79.11% | 多层结构与初始视觉共同生效 |
记忆交换实验揭示固定记忆的敏感面。把语言换成另一项任务时成绩降至 35.18% 与 29.66%;保持同一任务但换成另一回路的初始记忆只剩 6.26% 与 8.36%;仅替换初始视图为 2.64% 与 2.62%;换成完全不同任务的记忆几乎崩溃到 0.62% 与 0.52%。这说明动作器确实读取了与当前回路匹配的具体场景,而不是只从缓存中学到一个笼统的任务类别。
这组结果同时暴露风险。初始视角如果被遮挡、曝光错误或包含错误物体,错误会进入固定记忆并在整个回合被反复读取。动作器能通过腕部图像修正局部控制,却没有机制重新运行视觉语言模型确认“我一开始是否看错了”。因此一次思考的成本优势与单次观察错误的代价是一体两面。
在线输入与刷新频率
去掉腕部视觉时,LIBERO 与 LIBERO-Plus 降到 65.60% 和 33.49%,下降幅度最大;去掉本体状态为 94.30% 与 72.41%;只用腕部、不看头部视图为 87.10% 与 68.72%。腕部近景对抓取阶段尤其关键,头部视图仍为全局定位提供不可替代的信息。固定任务记忆不能弥补在线传感器缺失。
记忆刷新越频繁,扰动基准上的成功率越高,但成本也迅速上升。每动作块刷新一次得到 96.50% 与 72.47%,视觉语言模型调用次数为每回合一次的 17.37 倍,摊销到每步 12.391 毫秒;每两块和每四块刷新分别达到 95.95% 与 70.63%、95.95% 与 68.24%。这与“任务信息变化慢、场景状态变化快”的假设一致:更频繁刷新能补回部分静态记忆损失,却重新把大模型带回控制路径。
不同记忆生产者也影响结果。在 LIBERO 与 LIBERO-Plus 上,PaliGemma 为 95.35% 和 73.15%,π0.5 为 94.90% 和 71.48%,Qwen2.5-VL-7B 为 95.35% 和 75.55%,DM0.5 为 95.95% 和 79.11%。缓存体积分别约 9.8、9.8、31.8 与 79.7 MB。更强或更大的编码器不是单调更好,DM0.5 在本实验中的优势同时体现在扰动成功率,而不只是参数规模。
长时任务没有立即失效。RoboTwin 短、中、长步预算分组成功率为 94.00%、90.27% 与 90.25%;最长的 “put_bottles_dustbin” 需要 1700 步,成功率仍有 87.00%。不过论文没有报告真实小时级连续运行、光照强烈漂移或回合中途目标改变。长步数不等于开放式非平稳环境。
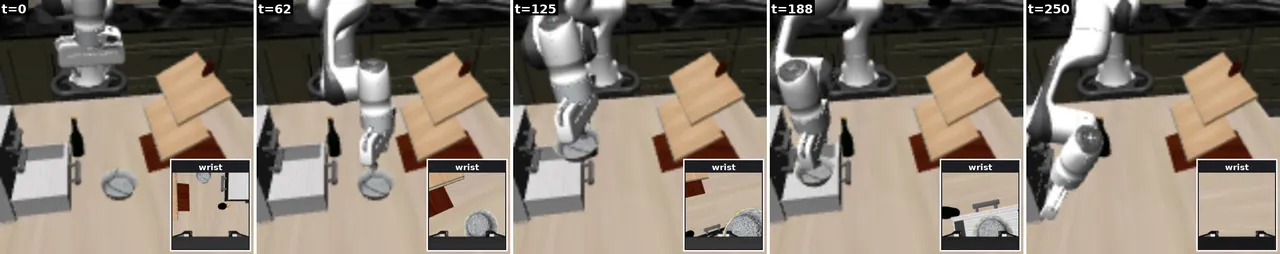
图 6:LIBERO-Plus 扰动回合中的连续执行。即使初始第三视角受到传感器噪声影响,未被扰动的腕部近景仍为在线动作器提供局部控制依据;任务记忆保留从受扰动初始观察中获得的目标上下文。
局限与独立判断
作者明确承认,任务记忆在回合初始化后保持不变。在线动作器虽然能响应当前观测,但当任务目标中途改变、用户插入新指令或高层子目标需要重新规划时,Fast-VLA 没有经过验证的处理机制。作者把事件触发记忆更新与高层重规划列为未来方向。这个限制比“物体移动”更根本,因为它涉及任务记忆的语义失效,而非动作器能否跟踪位置。
实验全部位于仿真基准。论文没有展示真实机械臂在不同相机标定、反光材质、通信延迟和接触动力学下的大规模测试。LIBERO-Plus 的扰动覆盖视觉与场景变化,却不能替代真实世界传感器噪声。固定记忆对初始观察的交换实验还表明,真实部署一旦在回合开头看错,后续闭环未必能纠正任务上下文。
显存成本仍高。在线常驻内存为 RoboTwin 1.22 GiB、LIBERO 0.86 GiB,但预填充峰值分别为 12.11 GiB 与 11.74 GiB。把大模型移出每次动作调用,不代表可以把大模型移出机器人计算栈。系统仍需一台能在回合开始时承载 4B 模型预填充的计算设备,或者通过外部服务接收任务记忆与初始缓存。
LIBERO-Plus 的泛化差距不能简单归因于记忆构造。Fast-VLA 的动作模块从 LIBERO 示范从头训练,而 π0.5 与 DM0.5 使用动作预训练。作者已经说明这一差异,因此更合理的判断是:该方法在效率与普通仿真成功率上很强,但扰动泛化仍需要与动作预训练结合验证。不能只拿 95.95% 的标准 LIBERO 成绩掩盖 79.11% 的扰动成绩。
从工程角度看,最值得复现的不是某个数字,而是缓存生命周期设计。代码把每回合第一次调用视为缓存构建点,部署层必须明确何时调用 reset()、历史偏移如何采集、异常恢复后是否复用旧缓存。若回合边界识别错误,动作器可能读取上一个任务的记忆;若历史图片缺失,代码会静默回退当前帧,外部接口却看不出输入质量已经下降。
总结与展望
Fast-VLA 的贡献是把视觉语言模型的“任务情境化”变成可复用的多层 KV 状态,再用专门的动作器反复查询。它没有声称固定记忆包含当前世界状态,而是明确让视觉、本体感觉和历史帧负责变化部分。方法因此形成两个层次:回合级上下文保持稳定,动作级观测持续更新。
实验结果支持这套分解在论文设置内可行:RoboTwin 达到 92.43% 平均成功率,标准 LIBERO 达到 95.95%,同时把摊销延迟压到每步 1.437 与 3.975 毫秒。更强的证据来自记忆交换和输入消融:任务记忆并非摆设,在线视觉也不能被它替代。效率提升来自任务信息与状态信息的不同更新频率。
下一步最有价值的工作有三项。第一,设计事件触发刷新,不在每个动作块调用大模型,而是在视觉突变、子目标完成或置信度下降时更新记忆。第二,引入高层重规划,使指令或任务目标变化可以直接替换缓存。第三,在真实机器人上验证缓存构建、失效和恢复策略,尤其是初始视角质量、相机标定与动作预训练的交互。
金句
Fast-VLA 真正省掉的不是“思考”,而是把同一份任务思考在每个动作块里重复一遍;它把稳定的任务语义留成记忆,把快速变化的世界交给持续查询。