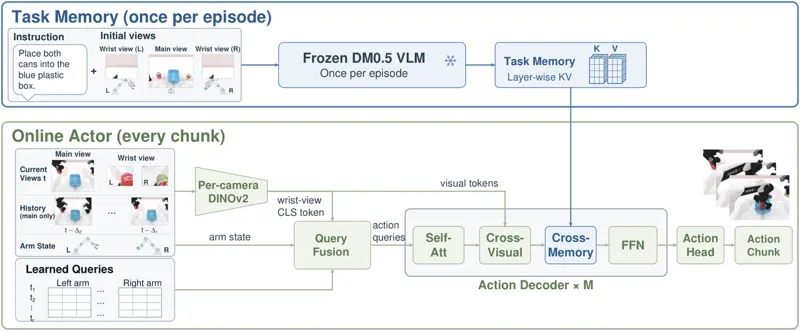
Fast-VLA:机器人操作只需一次思考冻结的 4B 视觉语言模型仅在每次任务开始时构建多层 KV 记忆,在线轻量动作器持续读取实时视觉、机械臂状态和历史视角生成动作。Fast-VLA 在 RoboTwin 达到 92.43%,并将摊销推理加速 10.9–17.1 倍。Kehong Gong, Guanli Hou, Xiaoxu Zheng · 25次阅读 · 2026年10月15日视觉语言动作模型机器人操控2026年10月15日