PAPER DEEP DIVE
让 π0.5 学会呼叫 Astra
冻结 π0.5,仅训练轻量 CALL 检测器预测何时需要外部推理;Astra 只在关键恢复事件接管,将 LIBERO 成功率从 95.5% 提升至 97.5%,同时显著减少外部调用。
论文:Make π0.5 Learn to Call Astra for Reliable Robot Manipulation(arXiv:2610.14117v1)
作者:Jianli Sun、Chengxiang Li、Yonglin Tian
机构:中国科学院自动化研究所;三亚学院信息与智能工程学院
代码:KykGeek/Pi05_CALL_Astra,采用 MIT 许可证。仓库提供控制、交接、恢复以及 Astra 执行适配代码,但不包含 π0.5 权重、OpenPI 运行环境、已训练的 CALL 头、模型凭据或复现实验产物。
一句话总结
这项工作冻结 π0.5,只训练一个约 48 万参数的本地点火器,用策略自身的语义特征、动作特征以及机器人与动作块统计量预测“现在是否需要外部推理”,再把少数高风险状态交给 GPT-6 Astra 进行闭环纠错,从而在 200 个 LIBERO 回合中把成功率从 95.5% 提升到 97.5%。
研究背景与动机
大型推理模型进入机器人操作后,最直接的使用方式是把视觉观察、任务指令和机器人状态持续送入外部模型,让它逐步给出动作或审核策略提案。这种方式能够利用丰富的世界知识和长程推理,但也把一个原本可以在本地高频运行的控制回路,变成了依赖网络、上下文构建和模型生成速度的昂贵回路。
π0.5 一类视觉语言动作模型(Vision-Language-Action,VLA)解决的是另一侧的问题:它可以直接从感知与语言产生动作块,通常能够快速完成常规操作。不过,通用策略仍会在对象关系复杂、接触状态变化或执行轨迹偏离时失败。论文引用的既有实验表明,让 Astra 持续审核 π0.5 的动作提案可以提高混合系统成功率,但每一次提案都查询外部模型,会让正确提案也承担相同开销。
本文的问题因此不是“外部推理是否有效”,而是“怎样把外部推理限制在真正需要的时刻”。作者将系统拆成三个角色:π0.5 是默认执行者;CALL 是轻量级能力不足检测器;Astra 是被呼叫的恢复专家。正常状态下,CALL 与 π0.5 共用一次前向传播,不产生额外模型调用;只有触发器点火后,环境控制权才发生转移。这个设计把“策略速度”和“推理能力”从互斥的二选一,变成一条有明确交接边界的分工链。
这种分工还带来一个容易被忽略的评价问题。只看最终成功率,无法判断系统是不是频繁呼叫外部模型;只看 token 数,又会掩盖恢复动作是否真的推进了环境。论文同时记录五类指标:任务成功率、发生咨询的回合数、实际执行 Astra 动作的回合数、Astra 执行的环境步占比,以及端到端动作吞吐。这样的指标体系能区分“检测器发出请求”和“外部模型真正接管”,对选择性干预研究尤其重要。
论文的核心假设是,π0.5 在失败前并非完全没有信号。策略的视觉语言前缀表示、动作 token 表示、机器人本体状态以及即将执行的动作块统计量,可能共同编码了当前提案是否稳定。如果这些内部量和任务结果之间存在可学习关系,就不必调用另一个大模型来判断是否需要大模型。CALL 正是这一假设的实现:它不替代 π0.5,也不生成动作,只判断当前策略是否值得被继续信任。
预备知识:动作块、漂移与能力标签
论文使用 OpenPI 的 pi05_libero 检查点作为冻结基础策略。一次查询会产生形状为 $10\times 7$ 的动作块,系统默认消费其中五个动作,然后再次查询策略。一个动作块是一个短期计划,而不是十个彼此独立的分类结果;因此,检测当前状态是否危险时,只观察机器人状态还不够,还要观察“策略准备怎样行动”。这解释了为什么 CALL 的辅助输入包含整个动作块的均值、标准差、范数、首尾动作及首尾差值。
“帮助标签”并非人工标注的失败类别。给定一个仿真器保存状态,作者让 π0.5 在不呼叫 Astra 的情况下继续执行剩余的 $M$ 次独立试验,并记录成功次数 $K$。若从该状态继续完成任务的能力记为 $q_\pi$,则能力估计与帮助目标分别是
$$ q_\pi=\frac{K}{M}, $$ $$ y_{\mathrm{help}}=1-q_\pi. $$这两式把“是否需要帮助”转成连续概率:若十次试验全部成功,帮助目标为零;若十次全部失败,帮助目标为一;只成功部分次数时,标签保留中间值。训练数据来自 LIBERO-Recovery 的失败状态、失败前轨迹和保存的仿真器状态,也加入 π0.5 正常推进时的状态,以避免检测器只认识危险样本而不知道常态是什么。
离线数据按任务划分训练、早停、校准和测试集合,共包含 37 个留出任务折与 5,055 个能力状态样本。这个“按任务留出”的切分比随机拆分状态更严格,因为它减少了同一任务轨迹同时出现在训练和测试中的泄漏风险。运行时部署 37 个任务专用 CALL 头,并保留两个套件级后备头;已知任务优先使用专用头,未知任务退回套件头。
方法详解:从冻结表示到选择性交接
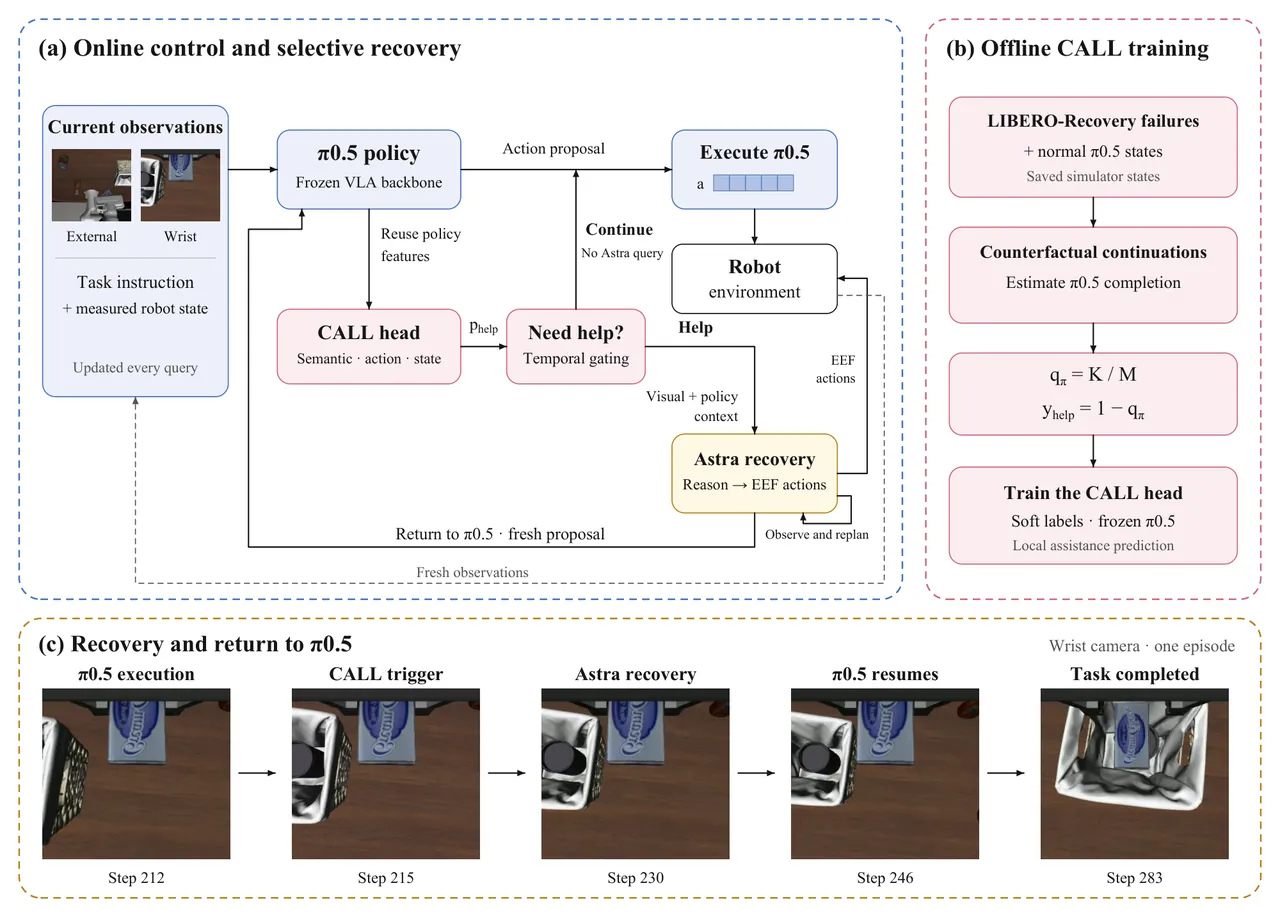
图 1:论文的方法总览。(a) CALL 复用冻结 π0.5 的特征决定是否交接;(b) 用反事实继续试验构造能力标签;(c) 腕部相机展示一次执行、触发、Astra 恢复、返回策略并最终完成任务的真实过程。
1. 三路特征构成 3116 维输入
CALL 不重新编码图像和语言,而是通过特征钩子复用 π0.5 的中间表示。输入向量定义为
$$ \begin{aligned} x &= [h_{\mathrm{sem}};h_{\mathrm{act}};u],\\ \dim(x) &= 2048+1024+44=3116. \end{aligned} $$其中,$h_{\mathrm{sem}}$ 是最终视觉语言前缀表示的掩码均值,维度为 2048;$h_{\mathrm{act}}$ 对最终动作 token 表示做池化,维度为 1024;$u$ 是 44 维辅助量,包含八个机器人状态值与 36 个动作块统计值。这里的拼接并非简单地“把所有张量都喂给分类器”,而是明确地把任务与场景语义、策略计划以及当前本体状态分成三路,后续再通过独立投影控制每一路的尺度。
动作统计量的构造与代码严格对齐。对一个 $10\times 7$ 动作块,代码分别计算每个动作维度的均值和标准差,共产生 $7+7=14$ 个数;再计算整个 70 维动作块的 L2 范数,加入第一个动作、最后一个动作和首尾差值,每项各七维。于是辅助动作统计共有
$$ 14+1+7+7+7=36 $$个数值,再加上八个机器人状态值,就得到 44 维的 $u$。首尾差值让检测器能看到短期计划是否在快速转向,范数提供整体动作幅度,均值和标准差描述每个自由度的集中程度。相比只输入当前关节位置,这种表示更接近“策略是否正在做出异常计划”的诊断信号。
2. 轻量三支路评分头
三个输入分支分别映射为 128、128 和 64 维,拼接后得到 320 维表示。该表示依次通过 LayerNorm、256 单元线性层、GELU、LayerNorm 和单标量输出。CALL 头只有 479,937 个可训练参数,相对于底层 VLA 和外部 Astra 都很小。它没有复制 π0.5 的视觉编码器,因此不需要在模拟器每一步重新处理原始图像;它读取的是基础策略已经算出的表示。
| 分支 | 输入维度 | 投影维度 | 作用 |
|---|---|---|---|
| 语义表示 $h_{\mathrm{sem}}$ | 2048 | 128 | 编码任务、场景与视觉语言上下文 |
| 动作表示 $h_{\mathrm{act}}$ | 1024 | 128 | 编码当前动作计划的内部状态 |
| 状态与动作统计 $u$ | 44 | 64 | 编码本体状态、动作幅度与首尾变化 |
| 拼接投影 | 320 | 256 | 融合三路信号并输出标量 |
原始标量 $z_\theta(x)$ 经过温度校准后变成帮助概率:
$$ p_{\mathrm{help}}=\sigma\!\left(\frac{z_\theta(x)}{T}\right). $$温度 $T$ 不应被理解为模型难度参数,而是一个在评估前校准的概率尺度。不同任务头和不同套件的数据分布并不相同,若直接使用未校准 logit,固定阈值可能在不同任务上产生截然不同的触发频率。论文分别校准普通阈值、硬阈值和温度,目的是让“概率超过阈值”在任务之间具有更稳定的操作含义。
3. 硬阈值与 4/5 时间确认
单次高分可能是瞬时噪声。若每一个略微升高的分数都触发 Astra,系统会重新落入频繁咨询的老问题。CALL 因而使用两种并行触发条件:极高分数可越过冷却与确认,立即交接;普通高分必须在最近五次查询中至少出现四次,才判定为持续需要帮助。形式化地,
$$ \begin{aligned} \mathrm{CALL}_{t} ={}& \left[p_{t}\geq\tau_{\mathrm{hard}}\right]\\ &\lor \left[\sum_{j=0}^{4}\mathbf{1}(p_{t-j}\geq\tau)\geq 4\right]. \end{aligned} $$左侧的硬阈值用于处理迅速恶化、等不到四次确认的紧急状态;右侧的四分之五规则用于吸收单帧波动。每次触发后,系统进入六个查询的冷却期,防止连续交接造成控制权抖动。正常执行时,每次策略查询后消费五个动作,因此触发器的时间粒度不是仿真器单步,而是策略重规划周期。这个实现细节决定了检测延迟和计算节省之间的折中。
flowchart LR
    O[External and wrist observations] --> P[Frozen pi0.5 policy]
    P --> A[10x7 action chunk]
    P --> S[Semantic feature h_sem]
    P --> H[Action feature h_act]
    A --> U[State plus 36 action statistics]
    S --> C[3116-D CALL head]
    H --> C
    U --> C
    C --> Q{Calibrated help score}
    Q -->|CONTINUE| E[Execute five pi0.5 actions]
    Q -->|Hard threshold or 4 of 5| X[Clear remaining action queue]
    X --> R[Astra observes and reasons]
    R -->|30 to 50 EEF corrections| V[Execute recovery chunk]
    V --> F[Refresh observation and proposal]
    F --> R
    R -->|Return control| G[Fresh pi0.5 proposal]
    G --> P
    E --> P
4. 交接不是一次函数调用,而是控制权协议
论文强调,在切换给 Astra 前,宿主必须清空 π0.5 动作队列里尚未执行的动作。若旧动作继续泄漏到外部模型接管阶段,恢复轨迹会混合两种控制器,后续状态与日志也无法归因。Astra 接收外部相机与腕部相机图像、任务指令、测量到的机器人状态、原始 π0.5 提案以及执行历史;它可以给出末端执行器(EEF)修正,也可以直接判断当前状态已可返回策略。
一次实际接管中,Astra 可以输出 30 至 50 个连续的单步 EEF 修正。宿主按顺序执行整个动作块,每个修正消耗一个 LIBERO 环境步;块执行完成后,宿主刷新观察和新的 π0.5 提案,再由 Astra 决定继续恢复还是交还控制权。这个“有界块加刷新”的协议限制了外部模型单次决策的作用范围,避免它在陈旧观察上无限生成长动作序列。
返回策略也不是无条件跳转。恢复执行器只有同时具备完成状态、可恢复标记、连续一致的环境步编号、双侧视觉观察以及有限机器人状态时,重入闸门才允许 π0.5 接管。任务成功时不再重入;恢复未完成或恢复结果声称“可返回”但缺少同步检查点时,系统保持交接状态。这样的保守策略意味着偶发额外停机,换来的是不会把陈旧动作当作已恢复状态继续执行。
5. 公开代码与论文组件的对应关系
公开仓库把 CALL 头的维度与三支路结构直接写在 models/call_astra_v1_head.py。下面的代码片段对应第 2.1 节:2048、1024、44 分别进入 128、128、64 的线性投影,拼接后再进入 256 维主体。
SEMANTIC_DIM = 2048
ACTION_DIM = 1024
STATE_STATS_DIM = 44
_BRANCH_OUTPUT_DIMS = {"semantic": 128, "action": 128, "state": 64}

self.body = nn.Sequential(
    nn.LayerNorm(body_input_dim),
    nn.Linear(body_input_dim, hidden_size),
    nn.GELU(),
    nn.LayerNorm(hidden_size),
)
self.help_head = nn.Linear(hidden_size, 1)
models/action_statistics.py 则把论文中的 36 个动作统计量实现为强形状约束:输入必须是有限的 $10\times 7$ 动作块,输出必须恰好是 36 维。这个检查比“平均池化后交给 MLP”更严格,因为一旦动作块长度或维度变化,训练时学到的位置语义就会错位。论文文字中的首动作、尾动作、差值、均值、标准差和范数,都能在该函数中找到逐一对应。
控制器一侧,models/call_controller.py 在每次策略查询时产生动作块、计算帮助分数并执行决策。若继续,则执行回到动作块;若呼叫,则构造交接请求,其中包含任务指令、回合编号、策略查询序号、环境步、观察快照、机器人状态、仿真器状态、原动作块、冻结特征、帮助分数、阈值与最近分数窗口。这样交接对象本身就是可审计的现场记录,而不是只传一个布尔值。
6. 为什么这种结构节省计算
CALL 的主要开销已经隐含在 π0.5 前向传播中。语义表示和动作 token 表示原本就会被计算,三支路 MLP 只增加很小的矩阵乘法;动作统计也可以在动作块产生后线性完成。正常回合没有 Astra 请求,因此上下文组装、网络传输、外部模型推理、工具调用和输出 token 都被完整跳过。论文报告的无交接路径保持接近基线的吞吐,正是这种结构设计的直接结果。
不过,“本地检测”不等于“零延迟”。策略仍然需要计算 3116 维特征、运行评分头并维护时间窗口。四分之五规则还必须跨多次查询积累证据,因此可能把本来很快失败的状态拖到下一至数个重规划周期才触发。论文用成功率、触发率和连续试验共同评价检测器,而不是只报告一个离线分类准确率,这一点比单纯证明“帮助概率可预测”更有工程意义。
实验设置与主要结果
实验覆盖 LIBERO-10、Object、Goal 和 Spatial 四个套件,每个套件十项任务,每项任务五个回合。纯 π0.5 和混合系统各完成 200 个回合。任务成功、交接、Astra 动作、token 和吞吐均在相同评估框架中记录;所有回合使用仿真器,机器人与环境均为 LIBERO 标准接口。
总成功率从 191/200(95.5%)提升到 195/200(97.5%),绝对增加两个百分点。这个总提升全部来自 LIBERO-10 的 43/50 到 47/50。其余三个套件中,纯 π0.5 原本已分别达到 50/50、49/50 和 49/50,混合系统没有改变成功数。因此,本文的主要收益不是“所有任务全面上涨”,而是在最难套件中补回了四个失败回合。
| 套件 | 纯 π0.5 | Astra + π0.5 | 差值 | 解释 |
|---|---|---|---|---|
| LIBERO-10 | 43/50(86%) | 47/50(94%) | +8 个百分点 | 主要增益来源 |
| Object | 50/50(100%) | 50/50(100%) | 0 | 基线已饱和 |
| Goal | 49/50(98%) | 49/50(98%) | 0 | 维持原水平 |
| Spatial | 49/50(98%) | 49/50(98%) | 0 | 维持原水平 |
| 总计 | 191/200(95.5%) | 195/200(97.5%) | +2 个百分点 | 净增四个成功回合 |
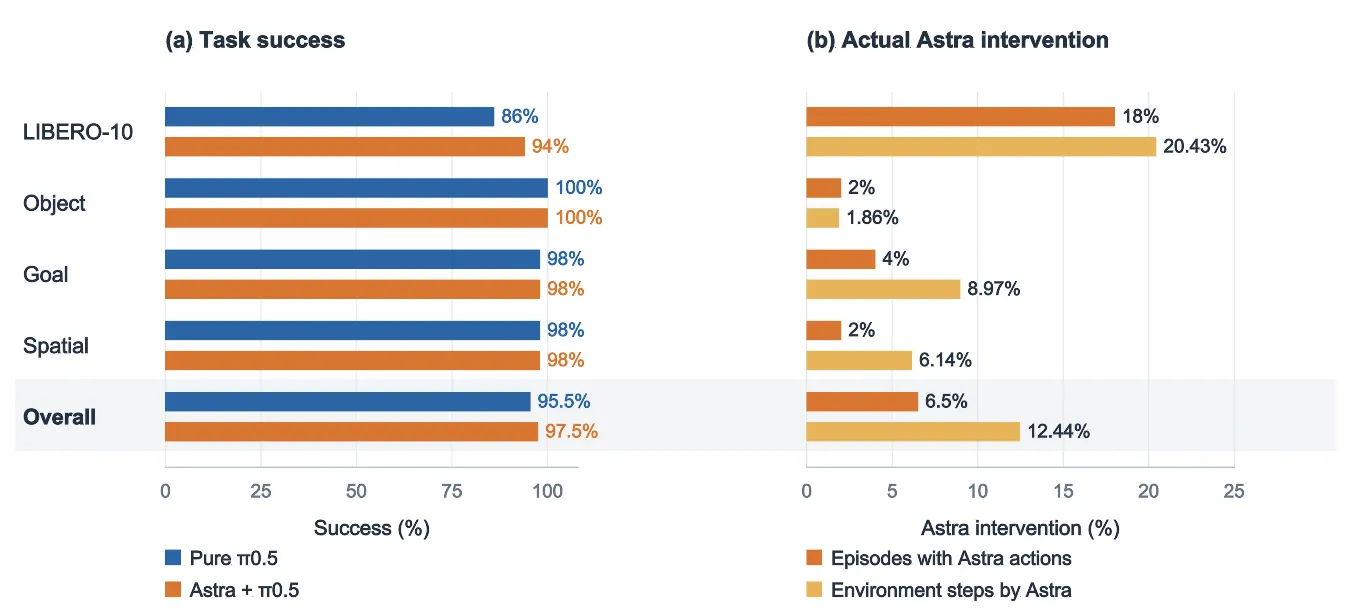
图 2:论文的任务成功与实际 Astra 干预统计。左栏比较成功率,右栏区分发生 Astra 动作的回合比例与 Astra 执行的环境步比例。
成功率表需要与干预表一起读。系统在 61/200 个回合中咨询 Astra,但只有 13/200 个回合真正执行了 Astra 动作。换言之,48 个回合虽然发生交接,Astra 查看现场后直接交还 π0.5,没有接管任何环境步。所有回合合计执行 4,561/36,654 个 Astra 环境步,占 12.44%;其余 87.56% 仍由 π0.5 动作完成。
| 套件 | 咨询回合 | Astra 动作回合 | Astra 步数 | 环境步占比 |
|---|---|---|---|---|
| LIBERO-10 | 31/50 | 9/50 | 3,485 | 20.43% |
| Object | 19/50 | 1/50 | 132 | 1.86% |
| Goal | 8/50 | 2/50 | 560 | 8.97% |
| Spatial | 3/50 | 1/50 | 384 | 6.14% |
| 总计 | 61/200 | 13/200 | 4,561 | 12.44% |
三个较容易套件合计只在 4/150 个回合中执行 Astra 动作,Astra 只承担 1,076/19,592 个环境步,步占比 5.49%。这说明选择性干预在 Object、Goal 和 Spatial 上确实接近“正常执行不打扰外部模型”的目标。LIBERO-10 的咨询和动作占比明显更高,也符合该套件任务更长、基础策略更易失败的事实。
作者进一步保存了 CALL 第一次请求帮助的 59 个状态,以及 Astra 真正执行第一个恢复动作前的 13 个状态,并用纯 π0.5 从每个状态继续五次。两组共享六个状态,共 66 个不同状态和 330 次试验。第一次 CALL 状态的无帮助成功率为 229/295(77.63%),实际动作前状态进一步降到 33/65(50.77%)。这说明触发点确实集中了更多困难状态,但检测器仍会在部分可完成任务上发出请求。
| 对照对象 | 样本 | 纯 π0.5 继续成功率 |
|---|---|---|
| 没有发生 Astra 咨询的回合 | 139 个回合 | 139/139(100%) |
| 没有执行 Astra 动作的回合 | 187 个回合 | 187/187(100%) |
| 第一次 CALL 状态 | 59 个状态 | 229/295(77.63%) |
| Astra 首个动作前状态 | 13 个状态 | 33/65(50.77%) |
这种“分层对照”比只看平均成功率更有信息量。它表明系统没有在明显成功的常规状态中频繁呼叫 Astra,同时也暴露了 LIBERO-10 内部的差异:该套件第一次 CALL 状态的纯策略继续成功率只有 103/150(68.67%),实际动作前为 25/45(55.56%);而在 Object 的第一次 CALL 状态中,纯策略仍能完成 91/95(95.79%)次继续试验。两类状态的语义风险显然不同。
Object 是论文最重要的反面案例。它有 19/50 个回合发生咨询,占 38%,但纯 π0.5 在第一次 CALL 状态的继续成功率高达 95.79%,最终只有一个回合真正执行 Astra 动作。作者把这归因于 Object 任务较简单、场景相对同质,以及训练数据中失败状态可能过度代表。这个现象说明 CALL 学到了“像失败数据的状态”,而没有完全学到“外部恢复会带来净收益的状态”。
Token 成本与动作吞吐
论文统计 Astra 的输入、输出和总 token。总使用量为 2,985,877 个输入 token 与 190,360 个输出 token,合计 3,176,237 个 token。按每个套件 50 个测试回合归一化,LIBERO-10 平均每回合 48,443.82 个 token,Object 为 1,985.70,Goal 为 8,004.70,Spatial 为 5,090.52,总体为 15,881.19。LIBERO-10 的高成本与其 31 次咨询和 3,485 个 Astra 环境步直接相关。
若只看 Object、Goal 和 Spatial,三个套件合计约 5,027 token/回合。它们仍保持 100%、98% 和 98% 的成功率,说明在较容易任务上,系统能够在大幅降低外部推理使用的同时保持结果。输入中有 2,346,403 个 token 通过提示缓存复用,输出中包含 35,648 个推理 token;缓存降低了计费和延迟压力,但没有改变每次咨询仍要发送当前视觉与执行上下文的本质。
吞吐指标揭示了 token 统计无法表达的时间成本。纯 π0.5 总体达到 8.25 环境步/秒,CALL 开启且没有 Astra 交接的 139 个回合为 7.83 步/秒,所有混合回合平均只有 2.58 步/秒。各套件无交接路径也基本接近纯策略,例如 Goal 为 8.25 对 8.17,Spatial 为 6.94 对 6.79。交接回合则因为外部推理、上下文刷新和恢复执行而显著变慢。
| 套件 | Astra token/回合 | 纯 π0.5 吞吐 | 无交接混合吞吐 | 全部混合回合吞吐 |
|---|---|---|---|---|
| LIBERO-10 | 48,443.82 | 8.84 | 8.11 | 1.93 |
| Object | 1,985.70 | 8.54 | 8.35 | 4.06 |
| Goal | 8,004.70 | 8.17 | 8.25 | 2.97 |
| Spatial | 5,090.52 | 6.79 | 6.94 | 4.07 |
| 总体 | 15,881.19 | 8.25 | 7.83 | 2.58 |
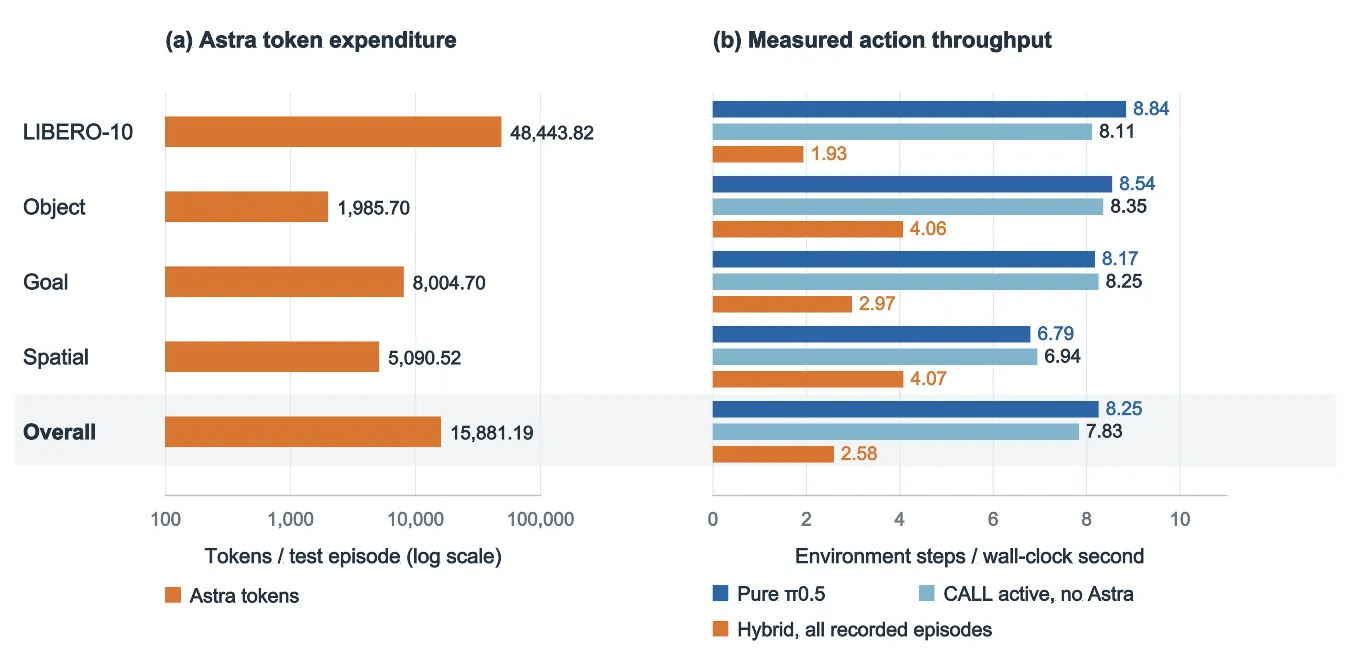
图 3:左图为每测试回合的 Astra token 对数分布;右图比较纯 π0.5、无交接混合路径和全部混合回合的动作吞吐。
因此,这项工作的“快”需要加上限定条件:普通路径快,接管路径慢。系统通过减少接管比例,把高延迟限制在少数回合中;但一旦 Astra 开始生成长恢复动作,整个回合的墙钟时间仍会成倍增加。对真实机器人而言,这种延迟可能影响动态环境、人工监督体验和安全回退,因此吞吐结果应被看作选择性干预的代价,而不是被总体成功率掩盖的细节。
从部署角度看,最应该优化的是 Object 一类“咨询很多、动作很少、继续执行又往往能成功”的区域。若能让 CALL 更好地区分“状态看起来接近失败”与“Astra 的行动能够改变结局”,就能减少只进行上下文检查而不行动的咨询。论文的 48/61 个零动作交接说明,外部模型在不少现场只充当复核器;这类咨询仍有诊断价值,但也会消耗显著的 token 和等待时间。
方法价值与边界条件
这项工作最值得借鉴的地方,是把“何时调用外部智能”当成独立学习问题,而不是在提示词中写一条笼统规则。CALL 使用策略内部表示和动作统计,输入成本低;交接协议清空队列,防止残留动作污染;恢复路径使用有界 EEF 块;返回策略要求完整同步状态。每个环节都针对一种具体失控风险,而不是仅靠模型自我声明“我已经恢复好了”。
同时,CALL 的训练目标衡量的是 π0.5 在保存状态上的继续成功率,而不是 Astra 介入后的净收益。它能学出状态困难度,却不一定能学出恢复收益。Object 的高触发率正说明这个差别:一个状态的继续成功率可能已经很高,但训练集里相似视觉构型经常出现在失败数据中,导致帮助概率偏高。若未来把标签改为“Astra 接管相对继续策略的因果增益”,检测器会更直接地优化资源分配。
论文的交接设计也有可迁移性。真实机器人系统中,控制器切换常见的问题是旧指令、旧观察和旧规划混在一起;这里通过动作队列清理、快照传递、恢复块边界和重入校验,建立了明确的所有权转移。即使外部专家不是 Astra,这些协议同样适用于人类遥操作、云端规划器或另一个专用恢复策略。
但当前证据仍属于仿真闭环。LIBERO 的动作接口、相机位置、成功判定和任务长度都有统一规范,真实机器人会额外面对传感器遮挡、标定误差、通信中断、执行器延迟与不可逆碰撞。论文没有在实体平台上测量安全恢复率,也没有报告网络抖动或外部服务失败时的退化行为。代码虽然包含受控执行和返回门禁,但这些机制在真实硬件上的时序边界仍需独立验证。
局限性
第一,作者明确承认 Object 套件存在明显过度触发:38% 的回合请求咨询,但第一次 CALL 状态的纯策略继续成功率仍有 95.79%,最终只有一回合执行 Astra 动作。训练数据中失败状态的占比与场景同质性可能让检测器把“似曾失败”误当成“需要恢复”。这是选择性干预最关键的产品级缺陷,因为不产生动作的咨询同样消耗 token 和墙钟时间。
第二,论文只在 LIBERO 仿真中评估,且每项任务只有五个回合。200 个总回合足以展示总体趋势,却不足以稳定估计罕见但代价高的失败。尤其是安全关键场景真正关心的尾部风险,可能在平均成功率中被稀释。论文也指出,高代价的稀有失败在训练目标中没有被赋予更高权重。
第三,CALL 使用 37 个任务专用头和两个套件后备头,依赖任务级能力监督。换到新机器人、新夹具、新相机布置或开放世界任务时,任务折与动作统计的分布会变化。论文没有展示跨实施例迁移、在线适应或对未知任务头的系统评估,因此当前结果不能直接证明方法具备开放环境泛化能力。
第四,外部模型一旦行动,成本非常高:LIBERO-10 平均每个测试回合消耗 48,443.82 个 Astra token,全部混合回合吞吐降到 2.58 步/秒。论文的重点是把这类开销限制在少数状态,而不是让接管本身变便宜。对于要求实时闭环或离线运行的机器人,仍需研究更短上下文、更小恢复模型、并行预取或分层缓存策略。
第五,公开仓库定位于集成运行时,不包含 π0.5 检查点、已训练 CALL 权重、OpenPI 依赖和实验产物,也要求外部 Astra 凭据。这有利于避免泄露密钥和分发大模型,但意味着第三方无法仅凭仓库完整复现论文表格。代码对应关系清楚,实验可复现性仍依赖作者未公开的模型与运行环境。
从独立判断看,最需要补充的消融不是“有无 CALL”,而是三类信号各自贡献多少、4/5 规则与硬阈值分别拦截了哪些错误、冷启动时温度校准对触发率有多敏感。论文给出了总体成功率与咨询指标,但没有逐项呈现这些设计选择的反事实结果,因此读者能确认系统有效,却难以判断每个模块的边际价值。
结论与展望
本文把冻结 VLA 与外部具身推理模型组合成一个分层控制系统。π0.5 负责快速日常执行,CALL 从策略已有表示与动作块统计中预测能力不足,Astra 只在触发后接管并输出有界 EEF 恢复动作,宿主随后依据完整同步检查点决定是否把控制权交还 π0.5。方法没有重新训练基础策略,也没有让外部模型参与每个正常步骤。
在 LIBERO 的 200 个回合中,混合系统达到 97.5% 成功率,相对纯 π0.5 提高两个百分点;增益集中在 LIBERO-10,三个较容易套件的 Astra 环境步占比为 5.49%。无交接路径的吞吐接近基线,但所有混合回合的平均吞吐只有 2.58 步/秒,显示选择性交接确实减少了高频外部调用,却无法消除单次恢复的高延迟。
下一步最有价值的方向,是让 CALL 从“预测当前状态是否会失败”走向“预测外部恢复是否值得”。如果训练信号加入 Astra 动作的预期收益、恢复成本与安全风险,检测器就有可能同时减少 Object 中的无效咨询、提高真正可救状态的召回率,并把延迟预算分配给最可能改变结局的回合。选择性干预的目标不只是少调用,而是在有限外部推理预算下最大化任务可靠性。