PAPER DEEP DIVE
通过动作自蒸馏训练通用导航策略
ASD 用同一视觉语言模型构建教师与学生,借未来轨迹这一特权信息自推断语言目标,再从机载观测学习推理与轨迹预测,无需人工语言或推理标注。
论文:Training Generalist Navigation Policies via Action Self-Distillation
作者:Bowen Feng、Keqin Wang、Yulong Yang、Amogh Joshi、Christine Allen-Blanchette、Dhruv Shah、Felix Heide
机构:普林斯顿大学
会议:CoRL 2026
论文页:arXiv:2610.17593 · 项目页:asd-nav.github.io
公开代码状态:截至本次核查,项目页的 Code 按钮仍指向空锚点,arXiv 源码包中只有 LaTeX 与论文图,没有论文附录 B.4 所称的 data.py、prompt.py 与 train.py。因此本文能够核实方法描述,但暂时不能完成论文与公开源码之间的逐行对应。
一句话总结:动作自蒸馏把机器人已经采集到的未来轨迹当作训练时的特权反馈,让同一个视觉语言模型先反推语言目标,再只凭机载图像学习目标、推理和未来路径,从而绕过人工语言标注。
1. 研究背景:导航数据很多,语言监督却很少
机器人导航已经有大量“图像加轨迹”数据。机器人在校园、人行道和办公楼里移动时,前视相机持续记录画面,底层控制器持续记录位移,形成大量可以直接用于行为克隆的样本。可是要训练一个真正听懂“从门口出去右转,再沿着走廊走”的视觉语言动作模型,传统流程还需要另一层标注:这段轨迹对应什么语言目标,当前场景为什么支持这个动作,遇到行人时模型应该怎样预测对方运动。论文要解决的正是这个断层。
视觉目标导航模型已经证明,大规模异质机器人数据可以训练出较强的通用性,但它们通常以目标图像或未来目标点作为条件,不能直接接受自然语言。另一方面,视觉语言导航和语言条件 VLA 可以接受指令,却常见两类代价:要么由人逐段写明场景与动作理由,要么借助多个外部模型生成目标描述和推理链,再把这些输出当作伪标签做监督。
作者的出发点不是再增加一个更大的标注器,而是重新利用轨迹本身。轨迹是已有数据的一部分,但它通常只在推理时被省略。训练时把真实未来轨迹画在当前前视图像上,相当于告诉视觉语言模型:“人已经选择了这条路,请解释这条路通向什么目标。”这条经过轨迹标注的图像就是教师看到的特权输入 $o_0^*=f(o_0,y)$,其中 $y$ 是示范轨迹,$f$ 把轨迹投影到图像上。
这个设定与普通伪标签有本质区别。普通做法先用冻结教师批量标注整个数据集,再训练学生;ASD 则在同一个训练循环里,让随学生参数缓慢变化的 EMA 教师根据当前轨迹生成目标与推理。教师不需要人工答案,学生也不需要看到轨迹叠加图。论文因此把“有轨迹、无语言”的机器人数据转换成“有语言目标、有推理、有动作”的自监督训练样本。
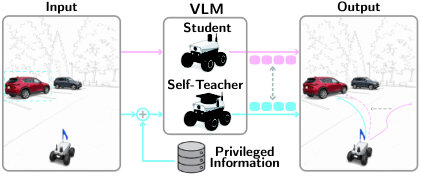
2. 问题定义:从历史状态预测语言条件下的未来轨迹
机器人每一步获得一张前视图像 $o_t$,状态可以写成鸟瞰平面坐标 $s_t=[x,y]\in\mathbb{R}^{2}$。过去 $T$ 个状态组成历史轨迹 $\tau_{-T:0}=\{s_{-T},\ldots,s_0\}$,未来 $H$ 个状态组成待预测轨迹 $\tau_{0:H}=\{s_0,\ldots,s_H\}$。模型本体是一个自回归视觉语言模型,轨迹被序列化成类似 JSON 的文本,再由语言模型逐个预测 token。
理想策略同时输出结构化推理 $R$ 与未来轨迹。给定语言目标 $g$,推理时希望得到:
$$ \hat{\tau}_{0:H},R\sim\pi(\cdot\mid o_{-T:0},\tau_{-T:0},g). $$
公式 (1) 的关键不只是“看图像做动作”,而是让同一个生成过程显式产出推理。推理不是额外的分类标签,而是与轨迹 token 一起由模型生成。这里的难点在于训练数据没有 $g$,也没有 $R$。ASD 的全部监督只能来自图像、历史轨迹和未来轨迹。
在实际训练中,历史长度为 8 个路点,采样率 5 Hz;未来预测 16 个路点,采样率 2.5 Hz,对应 6.4 秒预测时域。机器人在每个规划周期输出一段未来路径,再由底层 API 转换成线速度与角速度。
3. 方法总览:同一模型扮演教师与学生
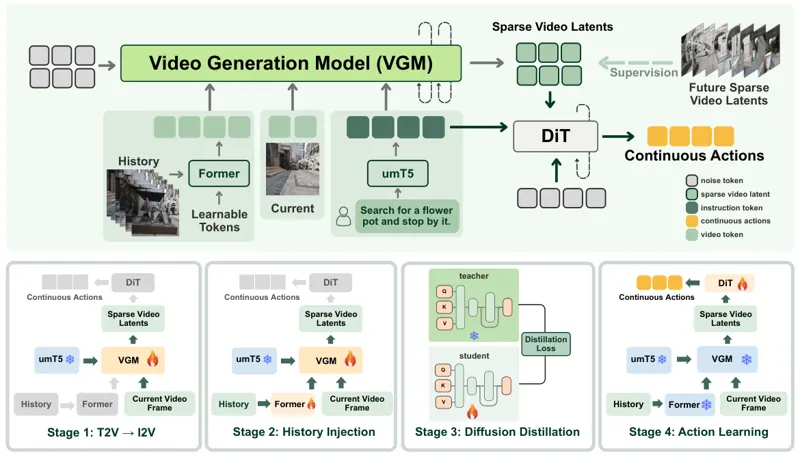
ASD 使用同一个开源视觉语言模型的两份参数。学生参数为 $\theta$,自教师参数为 $\phi$。训练开始时两者都从 Qwen2.5-VL-3B-Instruct 初始化,随后教师不是独立训练的第二个大模型,而是学生参数的指数滑动平均。这样,教师既能保留预训练模型的广泛语义知识,又会缓慢吸收学生在新导航数据上的适配。
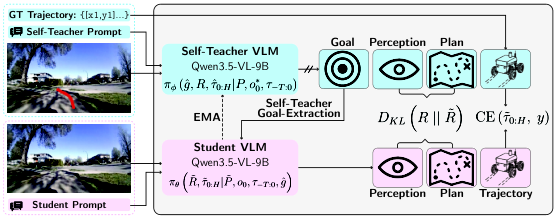
一次训练迭代包含两遍前向。第一遍是教师看到特权轨迹,生成推断目标 $\hat{g}$、推理 $R$ 与教师轨迹;第二遍学生只看到原始图像、历史轨迹和教师给出的目标 $\hat{g}$,生成自己的推理 $\tilde{R}$ 与轨迹 $\tilde{\tau}_{0:H}$。监督信号一部分来自教师推理分布,另一部分来自真实未来轨迹。
教师前向写成:
$$ \hat{g},R,\hat{\tau}_{0:H}\sim\operatorname{sg}\left(\pi_{\phi}(\cdot\mid P,o_0^*,\tau_{-T:0})\right). $$
其中 $\operatorname{sg}$ 表示停止梯度。教师只生成监督目标,推理损失不会反传去直接更新教师。学生前向为:
$$ \tilde{R},\tilde{\tau}_{0:H}\sim\pi_{\theta}(\cdot\mid\tilde{P},o_0,\tau_{-T:0},\hat{g}). $$
对照公式 (2) 与 (3) 可以看到信息差被刻意限制在训练阶段:教师多了绘制真实轨迹的 $o_0^*$,学生使用原始 $o_0$;教师自己推断目标,学生的目标由教师提供。部署时教师、轨迹叠加和真实未来轨迹全部消失,操作者直接给出语言指令。
flowchart TD
    D["Trajectory-only dataset
image + past + future"] --> T["Self-teacher
Qwen VLM EMA"]
    D --> S["Student
same Qwen VLM"]
    Y["Ground-truth future
trajectory y"] --> V["Project y on front image
privileged view"]
    V --> T
    T --> G["Inferred goal"]
    T --> R["Structured reasoning R"]
    G --> S
    D --> S
    S --> RS["Student reasoning"]
    S --> TS["Predicted trajectory"]
    R --> KL["Forward KL on reasoning tokens"]
    RS --> KL
    Y --> CE["Cross entropy on trajectory tokens"]
    TS --> CE
    KL --> L["Joint training loss"]
    CE --> L
    L --> U["Update student"]
    U --> E["EMA update teacher"]
    E --> T
图 2 展示了论文实现中的两遍结构:左侧输入同时进入教师和学生,教师从真实轨迹获得反馈,目标被提取后再交给学生。真正部署时只保留右下角的学生路径。
4. 结构化推理:让生成内容回到可见场景
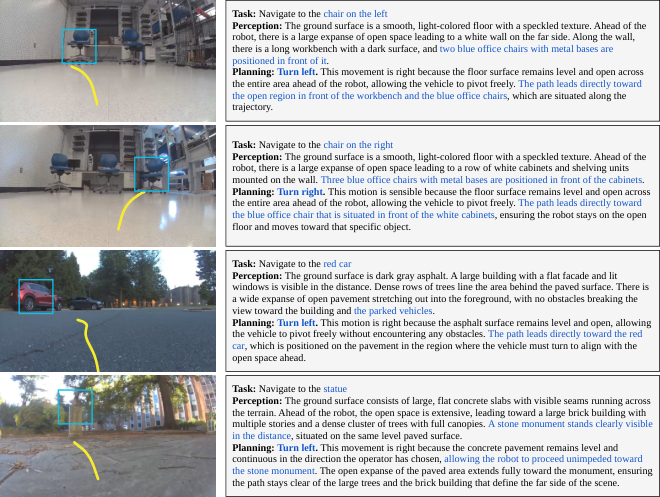
论文没有让教师自由写一段任意长的思维链,而是规定固定字段。Task 用一句话给出导航目标;Perception 描述可见地面、边界、建筑与开阔区域;Agents 列出画面中真实存在的移动实体,没有就写 none;Prediction 预测这些实体可能怎样移动;Planning 从固定动作词表中选一个离散动作,并用刚刚命名的场景特征解释;最后输出 Trajectory。
这个格式有两个直接作用。第一,它把语言监督绑定到可观察内容,减少教师凭空编造不存在的行人或障碍物。第二,它把“语言推理”和“轨迹 token”切成可分别计算损失的区间。模型不是拿整段文本做黑箱相似度,而是只在推理字段上匹配教师的 token 分布,在轨迹字段上对真实未来路点计算交叉熵。
论文还专门排除了教师独有的 Task 区间。学生把教师提取的 Task 当作提示上下文,不负责重新生成它;推理监督只覆盖 Task 之后的 Perception、Agents、Prediction 和 Planning。这个细节避免把“目标提取”与“目标条件下的场景推理”混成一个损失项,也使消融中的“仅目标监督”有明确定义。
字段化推理还有一个工程意义:部署后的文本不是不可检查的隐藏状态。图 6 的示例中,模型对右侧椅子的决策会先描述目标方位和通道,再选择转向;对室外红车的决策会把左侧空地与车辆位置联系起来。论文并未声称文本就是模型内部因果机制的完整解释,但它至少提供了可读、可对照轨迹的中间产物。
5. 损失函数:为什么匹配分布比复制一句话更重要
推理 token 使用前向 KL 散度监督。若教师分布为 $R$,学生分布为 $\tilde{R}$,则基本目标是:
$$ \mathcal{L}_{\mathrm{reason}}=D_{\mathrm{KL}}\left(R\Vert\tilde{R}\right). $$
公式 (4) 在实现上比较的是教师与学生每个 token 位置的 logits 分布,而不是把两句自然语言做字符串距离。更完整的表达为:
$$ \mathcal{L}_{\mathrm{reason}} =D_{\mathrm{KL}}\left( \operatorname{sg}\left[\pi_{\phi}(\cdot\mid P,o_0^*,\tau_{-T:0})\right] \Vert \pi_{\theta}(\cdot\mid\tilde{P},o_0,\tau_{-T:0},\hat{g}) \right). $$
轨迹 token 则直接对齐真实未来:
$$ \mathcal{L}_{\mathrm{traj}} =\operatorname{CE}\left(\tilde{\tau}_{0:H},y\right). $$
两项相加得到训练目标:
$$ \mathcal{L} =\mathcal{L}_{\mathrm{traj}}+\mathcal{L}_{\mathrm{reason}}. $$
论文附录解释了分布监督的优势。把 KL 展开并把教师项视为停止梯度后,优化等价于教师加权交叉熵:
$$ \mathcal{L}_{\mathrm{reason}} \equiv -\mathbb{E}_{R\sim\pi_{\phi}} \left[\log\pi_{\theta}(R\mid\tilde{P},o_0,\tau_{-T:0},\hat{g})\right] +\mathrm{const}. $$
与标准监督微调相比,差别在于目标分布。普通 SFT 每个输入通常只有一条人工推理,经验分布会退化成对唯一答案的硬标签;教师分布则可以在同一观察下同时保留若干正确的描述方式。例如红车位于灰车左侧,也可以等价地说灰车位于红车右侧。ASD 让学生给多种合理解释分配概率,而不是被其中一句措辞锁死。这是论文认为推理蒸馏比“离线生成一条伪标签再 SFT”更能保留预训练能力的重要机制。
6. EMA 教师:不是冻结标注器
教师参数按学生参数的指数滑动平均更新:
$$ \phi\leftarrow\alpha\phi+(1-\alpha)\theta. $$
训练配置取 $\alpha=0.999$,每 10 个学生更新步同步一次教师。附录给出的比例说明,在这种设置下,教师的大部分权重仍来自原始预训练检查点,只有较小部分来自新数据上的学生更新。它既不同于完全冻结的离线教师,也不是学生当前参数的即时副本。
完全冻结教师可以批量预生成推理标签,训练接口更简单,但存在容量与分布错配:教师的知识不一定适合学生当前看到的数据分布,且学生无法通过自身改进反馈给教师。ASD 的 EMA 教师保留预训练 VLM 的语义知识,同时逐步吸收导航数据,使教师在训练循环内生成分布更接近当前任务的目标和推理。论文用教师压力测试进一步检查模型崩塌:在更激进的 0.99 更新下,教师与学生检查点的逐 token KL 仍平滑上升,推理熵没有变成完全重复的 0 或近似均匀分布的极端值。
7. 训练流程与部署流程是两条不同的路径
训练样本只包含当前图像、过去 8 个路点和真实未来 16 个路点。先把未来轨迹叠加到当前图像,教师生成 Task、Perception、Agents、Prediction、Planning 与 Trajectory。再提取 Task 句子,把目标注入学生提示。学生看不到轨迹叠加图,也不生成 Task,只生成后续推理和未来轨迹。最后分别计算 KL 与交叉熵,反向更新学生,再做 EMA 更新。
部署时不再输入真实轨迹,也没有教师前向。无目标条件模式直接输出推理与路径:
$$ \tilde{R},\tilde{\tau}_{0:H} \sim\pi_{\theta}^{\star} (\cdot\mid\tilde{P},o_0,\tau_{-T:0}). $$
语言条件模式由操作者提供目标 $g^{\circledast}$:
$$ \tilde{R},\tilde{\tau}_{0:H} \sim\pi_{\theta}^{\star} (\cdot\mid\tilde{P},o_0,\tau_{-T:0},g^{\circledast}). $$
机器人执行预测路径中的前 8 个动作,保留后半段作为滚动时域的先验,然后获取新图像与新历史状态重新规划。因此暂停并非模型主动学习出的停止行为;真机上观察到的一次规划停顿,主要来自观测、推理和再次规划的计算延迟。
8. 实验设置:小数据、真实环境、强基线
训练数据来自 RECON 与 FrodoBots-2K。RECON 由 Clearpath Jackal 在校园非结构化环境采集,含鱼眼前视相机、不同天气与光照;FrodoBots-2K 来自 Earth Rover Zero,覆盖十余座城市的人行道与行人共享空间。由于完整数据规模过大,论文随机选择在线划分中 25% 的场景,按 90% 训练、10% 验证使用,合计约 100 小时示范数据。
主模型是 Qwen2.5-VL-3B-Instruct,教师与学生同源。训练使用 8 张 A6000 Pro、256 GB 内存、AMD Threadripper 7980X;每卡批大小为 1,梯度累积 2,AdamW fused,学习率 $1\times10^{-5}$,余弦调度,热身 5 步,训练 2 个 epoch。图像保持数据集原生分辨率,最大输出 512 token。
| 配置 | 取值 | 含义 |
|---|---|---|
| 学生与教师骨干 | Qwen2.5-VL-3B-Instruct | 同一预训练检查点初始化 |
| 过去路点 | 8 个,5 Hz | 构成历史运动上下文 |
| 未来路点 | 16 个,2.5 Hz | 预测 6.4 秒路径 |
| 训练数据 | RECON + FrodoBots-2K | 随机 25% 场景,约 100 小时 |
| 训练轮数与学习率 | 2 epochs,1e-5 | AdamW fused,余弦调度 |
| EMA 教师 | α=0.999,每 10 步更新 | 保留预训练知识并缓慢吸收学生 |
真机平台是一台 FrodoBot EarthRover Mini,只使用单个前视相机。评测覆盖 3 个室内方向任务、4 个室内物体任务、2 个室内多阶段任务和 4 个室外任务,总计 13 个语言条件导航任务。每个任务有固定指令与 10 次试验,初始位置和朝向会变化。人工评测者不知道方法身份,最多允许三次重新规划;碰撞或目标离开视野视为失败。
9. 室内结果:OOD 场景中的目标选择能力
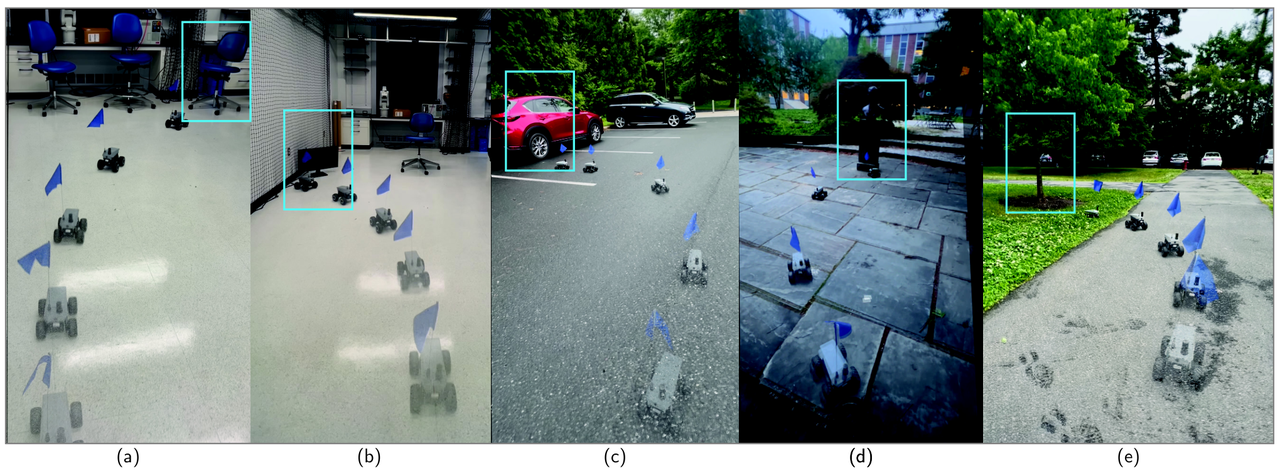
室内实验在办公室式实验室进行。训练数据主要来自室外,而测试对象包括椅子、垃圾桶、显示器、门和走廊,因此不仅语言组合是新的,大量物体类别与空间布局也属于分布外。表 1 中 Qwen2.5-VL-ASD 平均成功率为 84%,OmniVLA 为 54%,NaVILA 为 27%;换成 Qwen3.5-VL 骨干后平均成功率达到 94%。
| 方法 | 方向类 3 项平均 | 物体类 4 项平均 | 多阶段 2 项平均 | 9 项总平均 |
|---|---|---|---|---|
| OmniVLA | 0.633 | 0.575 | 0.350 | 0.54 |
| NaVILA | 0.200 | 0.250 | 0.400 | 0.27 |
| Qwen2.5-VL-ASD | 0.900 | 0.875 | 0.700 | 0.84 |
| Qwen3.5-VL-ASD | 0.967 | 0.975 | 0.850 | 0.94 |
数字最能说明问题的地方不是平均差,而是困难任务。面对三把相同椅子时,ASD 必须理解“右边的椅子”这一相对位置,而不能只识别椅子类别;在显示器任务中,场景同时存在垃圾桶、椅子和显示器;在走廊任务中,模型要把穿门、右转和沿走廊前进组合起来。Qwen2.5-VL-ASD 在这三项上的成功率分别是 80%、70% 和 60%,对应 OmniVLA 的 20%、20% 和 0%。
论文还报告了一个单任务时延对照:左椅子任务中 OmniVLA 成功率 90%、平均 25.3 秒,NaVILA 为 20%、28.9 秒;原生 Qwen2.5-VL 生成物理上不可执行的动作,成功率 0%;Claude Opus 4.7 能正确识别目标并达到 70%,但平均 846.1 秒;ASD 达到 100%,平均 15.3 秒。这组结果说明,前沿大模型的语义能力并不自动等于可部署的机器人策略,ASD 的价值在于把这种语义能力通过轨迹反馈转成低延迟控制。
10. 室外结果与语言可操控性
室外测试位于校园环境,含沿人行道前进、到雕像、到树和到指定颜色汽车四个任务。Qwen2.5-VL-ASD 平均成功率 95%,Qwen3.5-VL-ASD 达到 98%。雕塑是训练集中没有的物体类别,属于更明显的 OOD 目标,Qwen2.5-VL-ASD 仍达到 80%,比 OmniVLA 高 20 个百分点,比 NaVILA 高 70 个百分点。
| 方法 | 人行道 | 雕像 | 树 | 汽车 | 平均 |
|---|---|---|---|---|---|
| OmniVLA | 1.00 | 0.60 | 1.00 | 1.00 | 0.90 |
| NaVILA | 0.90 | 0.10 | 0.00 | 0.30 | 0.33 |
| Qwen2.5-VL-ASD | 1.00 | 0.80 | 1.00 | 1.00 | 0.95 |
| Qwen3.5-VL-ASD | 1.00 | 0.90 | 1.00 | 1.00 | 0.98 |
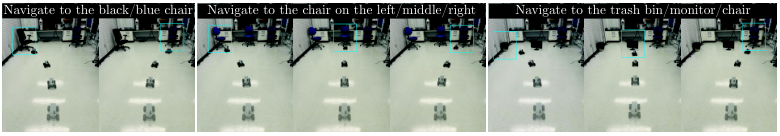
语言可操控性实验比“每条命令换一个新场景”更严格。图 3 在同一物理环境中分别给出颜色、方向和物体目标,要求模型产生不同轨迹。训练集中每个场景通常只有一条示范轨迹,并没有为同一画面合成多条反事实路径;因此模型能在同一场景下区分红车与灰车、左侧与右侧目标,说明它没有简单记住“这张图应该往哪里开”。
11. 多阶段任务:训练单段指令,执行多步目标
Doorway 要求机器人走到门并穿过;Hallway 进一步要求穿门后右转,再沿走廊前进。论文报告 Qwen2.5-VL-ASD 在这两项上的成功率为 80% 和 60%。OmniVLA 分别为 70% 和 0%,NaVILA 分别为 30% 和 50%。这意味着基线各擅长其中一种模式:OmniVLA 能处理短的两段目标,却在四段走廊任务上失效;NaVILA 在长走廊任务尚可,但在穿门任务上表现较差。
ASD 的优势可能来自两个耦合因素。第一,语言目标由教师根据整条未来轨迹提取,轨迹跨门并转向时,目标句子可能保留高阶意图,而不只是当前帧的转向动作。第二,结构化推理把可见门框、右侧通道与后续直行空间分开描述,使轨迹 token 的生成有条件依赖这些场景关系。论文没有做逐 token 的因果消融来证明哪一句话直接控制哪一段运动,因此这里应视为机制解释,而不是已完全验证的内部因果链。
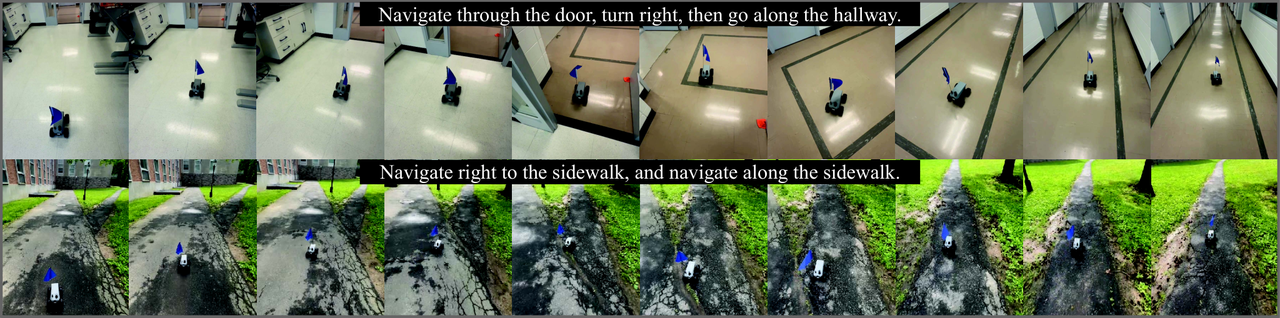
多阶段任务的实验规模仍有限。Hallway 只有每方法 10 次试验,60% 与 50% 的差距只有一次成功;论文也没有给出置信区间。因此更稳妥的结论是:ASD 展示了多阶段指令的可执行性,并明显优于部分基线,但还不能据此断言它在更复杂楼层导航中已经稳定领先。
12. 推理质量与消融:提升不是只来自更强骨干
表 4 用五个代表性任务拆开监督来源。完整 Qwen2.5-VL-ASD 平均成功率 80%;只监督教师推断目标、不监督推理时降到 26%;训练有推理但部署时关闭推理,降到 14%。如果换成离线教师标签再 SFT,Claude Opus 5 标注为 36%,Qwen2.5-VL 标注为 22%;用同一数据集直接 SFT NaVILA 只有 16%。
| 方法 | 右椅 | 椅子 | 显示器 | 走廊 | 汽车 | 平均 |
|---|---|---|---|---|---|---|
| ASD,仅目标监督 | 0.40 | 0.20 | 0.20 | 0.10 | 0.40 | 0.26 |
| ASD,部署时关闭推理 | 0.10 | 0.20 | 0.20 | 0.00 | 0.20 | 0.14 |
| Claude Opus 5 标签 + SFT | 0.30 | 0.50 | 0.30 | 0.30 | 0.40 | 0.36 |
| Qwen2.5-VL 标签 + SFT | 0.40 | 0.30 | 0.30 | 0.00 | 0.10 | 0.22 |
| NaVILA 同数据 SFT | 0.00 | 0.10 | 0.20 | 0.30 | 0.20 | 0.16 |
| Qwen2.5-VL-ASD | 0.80 | 0.90 | 0.70 | 0.60 | 1.00 | 0.80 |
| Qwen3.5-VL-ASD | 0.90 | 1.00 | 0.90 | 0.80 | 1.00 | 0.92 |
这组消融区分了三个假设。“只要给目标就够了”被 26% 的结果反驳;“推理只是训练时的辅助,测试时可以删除”被 14% 的结果反驳;“提升只是因为 Qwen3.5 更强”也不能解释为什么同一 Qwen2.5 骨干下,完整 ASD 显著高于同骨干 SFT。最强冻结教师 Claude Opus 5 的离线标签也只有 36%,进一步说明教师模型容量高并不自动带来好的学生策略,在线、随轨迹反馈生成的分布监督更关键。
不过,消融仍不能证明提升全部来自语言推理的语义正确性。KL 可能同时传递教师的场景先验、输出格式、动作偏好和语气 token。论文通过“仅目标”和“关闭推理”两组实验缩小了解释范围,但要区分“语义推理”与“额外正则化”还需要更细的表示层干预。
13. 开放环轨迹预测:补充证据而非替代真机结论
论文在 RECON 与 FrodoBots-2K 验证集上做了 2 秒开放环预测。ASD 在 RECON 上的平均位移误差为 0.174,低于 Diffusion Policy 的 0.180 和 Qwen2.5-VL+SFT 的 0.192;在 FrodoBots-2K 上平均位移误差为 0.031,低于大多数对照。论文统计 ASD 在 8 个指标中取得 7 个最低值,而不是全部 8 个:例如 FrodoBots-2K 的 MSE 为 0.004,仍高于高斯策略与高斯混合模型的 0.002。
开放环结果的解释边界必须明确。它说明在不执行动作时,ASD 的短时路径预测更接近真实轨迹,也说明增益不只是 VLA 对专用行为克隆模型的替换,因为与同骨干、同数据的 Qwen2.5-VL+SFT 相比仍有差距。但开放环不能衡量误差累积、碰撞和重规划恢复能力,因此论文的主证据仍应是 13 个真实任务。
14. 方法意义:把轨迹当作语言监督的接口
ASD 最有价值的设计因果链是:示范轨迹能让教师推断“为什么要这样走”,目标句子把这种意图压缩成可部署条件,推理分布再把场景到动作的中间关系传给学生。它与传统逆强化学习或目标推断的区别在于,推理不是恢复一个奖励函数,而是直接产生语言目标和可执行轨迹 token;它与普通 VLM 伪标注的区别在于,目标与推理在训练循环内由带轨迹反馈的 EMA 教师生成。
这也解释了为什么论文强调“self-distillation as a grounding mechanism”。前沿 VLM 在左椅子任务中识别正确目标,Claude Opus 4.7 也能达到 70% 成功率,但二十分钟级的平均完成时间不适合控制。原版 Qwen2.5-VL 的语义知识没有自动变成可行动作,成功率是 0%。ASD 没有换更大的模型,而是用 100 小时轨迹数据把已有模型的语义输出和机器人运动分布接上。
从数据效率看,OmniVLA 使用了约 9500 小时、10 个平台的数据,ASD 使用约 100 小时示范,却在室内 OOD 任务取得更高成功率。这个比较不能直接推出“ASD 比所有多模态预训练方法都高效”,因为训练数据来源、评测环境和模型先验并不相同;但它至少说明,在语言监督缺失的机器人数据上,轨迹反馈式自蒸馏提供了可扩展的监督路径。
15. 局限性与风险
作者自述的第一项局限是仍然依赖示范轨迹作为特权反馈。ASD 去掉了人工语言和推理标注,但没有去掉高质量的连续轨迹。若目标只能通过交互式纠正、口头澄清或任务级奖励表达,而示范轨迹本身含糊,教师未必能推断出操作者真正想要的目标。
作者自述的第二项局限是教师质量受预训练 VLM 约束。在场景语义模糊、目标很小或指令需要细粒度空间关系时,自生成目标和推理可能退化。由于学生把教师目标当作条件,教师一次系统性误判会进入训练监督,不会像人工标注那样被独立审核。
我的独立判断是评测证据仍偏窄。全部真机结果来自一台 FrodoBot EarthRover Mini,室内外各一个主要物理环境,每个任务 10 次试验,没有置信区间或多种机器人形态。Hallway 的 60% 与 NaVILA 的 50% 只差一次成功,不宜被当作稳定优势。作者还明确说明 ASD 没有学习停止判据,完成依赖人工判断,这限制了完全自主部署。
执行层面的独立风险是路径预测与低层控制之间存在缝隙。附录报告 ASD 一次执行 16 步中的前 8 步,在不平整地形上可能偏离计划;雕像任务的主要失败正是“计划合理但执行偏移”。此外,训练只使用 25% 场景子集,长期运行、动态人群密度变化、不同相机标定和轮式底盘差异都还没有覆盖。最后,自生成语言目标可能吸收数据偏差,形成看似合理却不可审计的指令,部署时需要保留人工监督和失败回退。
16. 结论与展望
ASD 证明了一条清晰的技术路线:如果机器人数据已经有示范轨迹,那么轨迹本身可以成为语言目标和推理的监督入口。教师通过绘制真实未来路径获得特权信息,学生在没有轨迹叠加图的条件下学习相同推理并预测动作,EMA 让监督在训练循环内持续更新。13 个真实导航任务、语言可操控性实验、多阶段任务和开放环轨迹预测共同支持了这条路线。
下一步最值得验证的不是继续堆任务数量,而是回答三个机制问题:教师生成的哪类语言信息真正影响动作;如何把轨迹反馈扩展到交互纠正与失败恢复;如何让模型在分布外场景中知道自己何时不可靠。如果这些边界能够被实验拆清,ASD 可能成为把未标注机器人轨迹转成可部署推理策略的一种通用训练范式。
金句:ASD 没有给机器人补一份人工答案,而是让已经走过的路,反过来解释它为什么要这样走。