PAPER DEEP DIVE
RIWANav:世界模型与导航策略的递归自我改进
城市长距离导航里一步走偏会顺着后续观测一路放大,而模仿学习只监督专家的成功动作、真机试错又太贵;用冻结世界模型做想象反馈则会随策略演化逐渐失准。RIWANav 把「动作条件世界模型 + 策略」的耦合适配写成任务级递归自我改进:Cosmos 世界模型为同一状态下采样的 4 个候选路点块想象未来 17 帧,打分后经 GRPO 的组内相对优势更新策略,并配 KL 与专家锚点两项防漂移;改进后的策略再提出动作,只保留与记录专家运动局部一致(ADE/MADE/AOE/MAOE 加权一致性 Q≥0.35)的动作-视频对进入策略诱导回放池,按相对初始策略的行为新颖度与当前预测误差排优先级去微调世界模型,K=19 轮闭环。UrbanNav test-seen 成功率 89.92%、SPL 86.87%,test-unseen 88.25%/82.59%,比冻结世界模型的 GRPO-WM 高 7.94/6.50 个百分点,导航误差从 3.3314 降到 2.0429;世界模型在策略动作上 L1/LPIPS 各降 3.2%/7.1%。已在自建移动机器人上完成城市实机验证。
RIWANav: Recursive World–Action Models with Self-Improvement for Urban Navigation
Jing Xie、Shouwei Ruan、Yubin Wang、Yuxiang Zhang、Haitao Yang、Songchang Jin、Dianxi Shi(上海交通大学人工智能研究院 MoE 重点实验室 / 北京航空航天大学 / 香港科技大学 / 清华大学 / 得克萨斯大学奥斯汀分校 / IGDL 北京)
arXiv:2610.08640v1 [cs.RO],2026-10-06 · arXiv:2610.08640
代码状态:本文未提供公开代码。arXiv 全文没有给出仓库链接,按标题与作者检索 GitHub 也没有对应实现。它依赖的三个上游项目是公开的:UrbanNav 数据集(CASIA-IVA-Lab/UrbanNav,AAAI 2026)、Navigation World Models(facebookresearch/nwm)与 NVIDIA Cosmos 视频世界模型。
一句话总结
冻结的世界模型在策略不断进步后会变成瓶颈:它给的评价越来越不符合策略真实会走到的状态分布。RIWANav 的做法是把「世界模型 + 策略」当成一个任务专用的递归自我改进(RSI)系统,每一轮交替两次更新——世界模型想象四个候选动作的视觉后果、用 GRPO 的组内相对优势改进策略;改进后的策略再用「专家一致性过滤 + 行为新颖度/预测误差优先级」挑出动作-视频对,反过来更新世界模型。在 UrbanNav 的 test-unseen 上,成功率从冻结世界模型基线的 80.31% 提到 88.25%,SPL 从 76.09% 提到 82.59%,导航误差从 3.3314 降到 2.0429。
一、研究背景:城市导航里的误差是会复利的
长时程城市导航的任务形态很具体:智能体只能看到街景级别的当前观测与最近一段运动历史,要把一个语言指定的目的地翻译成一步一步的局部决策,还得自己判断什么时候该停。论文把现有主流做法的问题拆成三层。
第一层,模仿学习学不到失败。CityWalker、UrbanNav 这类工作用专家轨迹做监督,初始化很强,但监督信号只覆盖「专家做对的那些动作」。策略上线后自己走出来的错误状态,数据集里根本没有对应标注。这在城市导航里格外要命,因为一次不准的局部运动会改变下一帧观测,错误沿着后续决策一路复利——你偏离人行道半步,接下来的视野、可行走走廊、避让对象全都变了。
第二层,真机试错太贵。强化学习确实能从失败里学,但长时程的试错交互要在真实城市里跑:一次失败可能是撞上路桩、走进车行道,或者在路口耗到超时。论文因此把需求写得很清楚——后训练需要「结果反馈」,但不能要求每个候选动作都被物理执行一遍。
第三层,也是本文真正的靶子:冻结的世界模型会过时。动作条件世界模型(NWM、Fast-WAM 等)能当学习到的模拟器,为候选动作预测视觉后果,让策略在执行前就比较局部决策。这条路线解决了「不物理执行也能拿到反馈」。但论文指出一个被普遍忽略的问题:用于策略优化的世界模型不应该保持冻结。策略在改进,它访问的状态分布和提出的动作分布都在漂移,而冻结的世界模型没有跟上这种漂移;它的预测误差会直接扭曲后续的策略更新,成为基于模型的后训练的瓶颈。
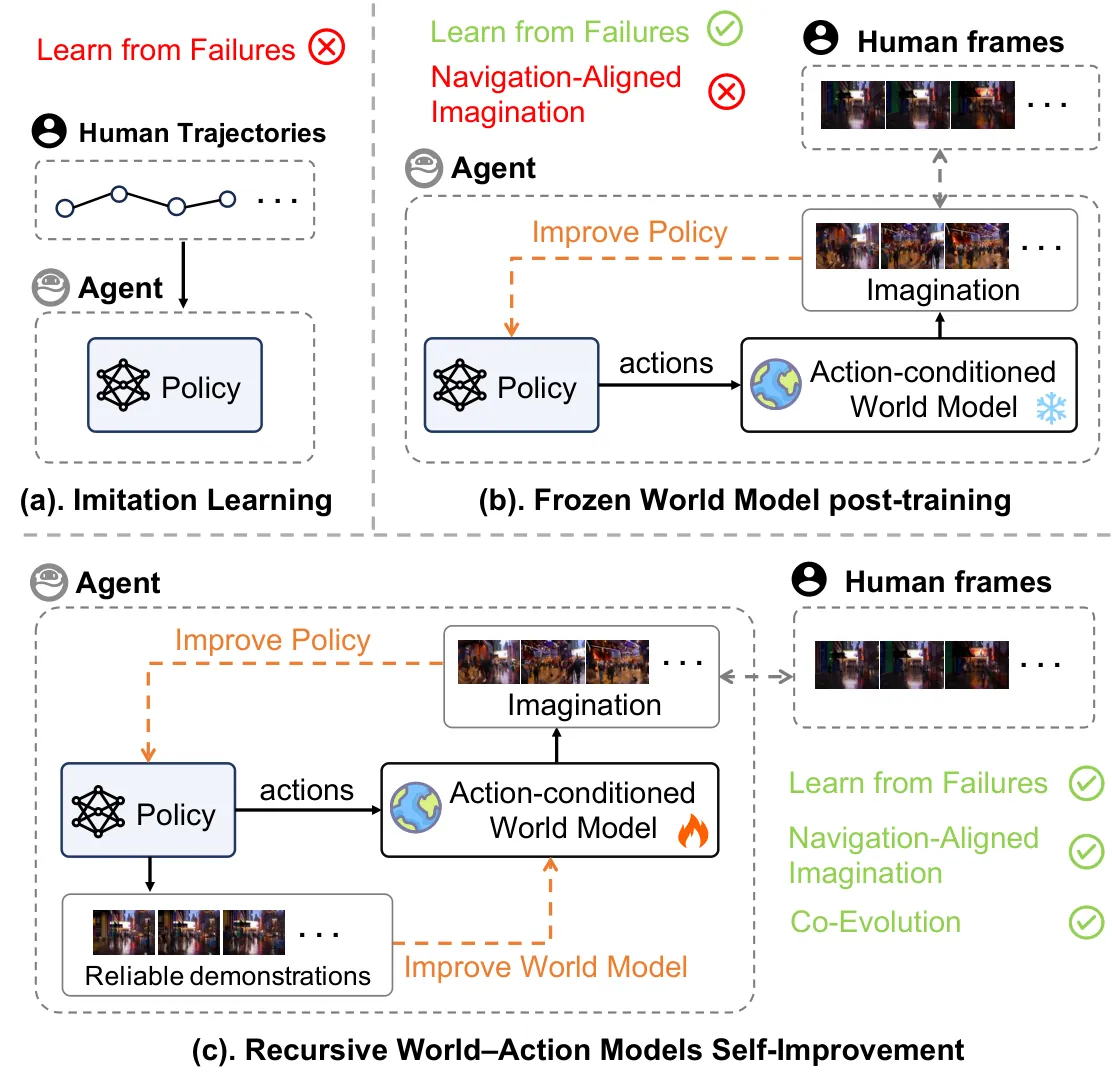
图1:从模仿学习到递归世界-动作模型自我改进的三个台阶。(a) 模仿学习只用专家轨迹训练,对策略自己造成的失败几乎没有监督;(b) 冻结世界模型让策略能从想象后果中学习,但它的预测与不断演化的策略逐渐错位;(c) RIWANav 把训练闭环合上——想象后果改进策略,而有据可依的策略诱导样本反过来精炼世界模型,供下一轮策略学习使用。
论文把解法接到递归自我改进(Recursive Self-Improvement, RSI)这个概念上:RSI 研究的是「每一个改进阶段都改变下一阶段的条件」的系统,POET 让环境-智能体对共同进化就是典型。RIWANav 把这个原则搬到导航后训练,具体形式是策略优化与世界模型适配的耦合——改进后的策略决定世界模型下一步该学哪些示范,精炼后的世界模型为后续策略学习提供更新过的反馈。自我改进不是来自某个更强的组件,而是来自这两个组件之间的递归回路。
二、相关工作与本文的位置
真实世界导航。这一支靠数据、监督形式与策略设计推进:CityWalker 用大规模步行与行车视频扩展城市导航学习,UrbanNav 把城市尺度的人类轨迹与地标锚定的语言对齐,OmniVLA 学一个跨图像/语言/混合目标模态的共享策略,NoMaD 用目标掩码的扩散策略,VENTURA 生成指令条件的视觉路径供下游控制。论文对这条线的定位很明确:它们改进的是训练本身,本文改的是后训练。
用于策略学习的世界模型。PlaNet 与 Dreamer 确立了「在潜空间里想象」的范式,后续工作扩到更广的域与高维视觉观测,最近延伸到导航与具身控制。NWM 用可控视频预测给导航轨迹排序,Fast-WAM 联合建模视频与动作、在不显式生成未来的情况下改进策略学习。与这些工作把世界模型当作固定的想象反馈来源不同,本文研究的是世界模型与策略如何在策略行为演化时持续互相适配。
递归自我改进。在学到的动力学层面,这个问题已经被碰过几次:不确定性感知预测与短 rollout 减少对模型误差的利用,保守目标惩罚不确定的转移,PDML 让模型学习朝当前策略分布倾斜,另有一批工作用学习进度、新颖度或好奇心来优先化经验。RIWANav 的贡献是把这几条线连成一个闭环:世界模型用想象反馈改进策略,演化中的策略指导下一次世界模型更新,两者递归地互相提升。
三、预备知识:问题形式化与世界模型接口
离线数据集是 UrbanNav,记作 $\mathcal{D}=\{(s_t, a_t^{\mathcal{D}}, o_{t+1:t+T}^{\mathcal{D}})\}_t$,其中 $a_t^{\mathcal{D}}$ 是录制的专家动作,$o_{t+1:t+T}^{\mathcal{D}}$ 是它之后的 $T$ 帧 RGB。状态包含最近 $C$ 帧观测、它们的位姿与语言目标:
$$s_t = (o_{t-C+1:t},\ q_{t-C+1:t},\ \ell)$$
策略 $\pi_\theta(a\mid s)$ 输出一个 $H$ 航点动作 $a=[p_1,\ldots,p_H]\in\mathbb{R}^{H\times 2}$,每个 $p_j\in\mathbb{R}^2$ 是当前相机坐标系下的平面航点,另有一个独立的头预测停止概率。实验中 $H=8$,对应 8 秒的 8 个航点。
动作条件的 Cosmos 世界模型预测一个候选动作的视觉后果:
$$\hat{o}_{t+1:t+T} = f_\phi\big(o_t,\ \mathcal{A}(a),\ \ell\big) \tag{1}$$
这里 $\mathcal{A}$ 把航点块转成 Cosmos 消费的相对位姿序列——论文实现里是由 16 个相对位姿动作驱动 Cosmos 预测 17 帧、2 fps。监督策略 $\pi_{\theta_0}$ 与预训练世界模型 $f_{\phi_0}$ 共同初始化整个递归;递归进行到第 $k$ 阶段时,$f_{\phi_k}$ 冻结、策略改进,然后策略供给样本把 $f_{\phi_k}$ 更新成 $f_{\phi_{k+1}}$。重复到第 $K$ 轮(实验里 $K=19$)得到最终世界模型 $f_{\phi_K}$。
有两个「固定参照」贯穿全文,值得单独点出来:录制的专家动作 $a_t^{\mathcal{D}}$ 锚定未来监督(世界模型更新时配对的未来帧只来自数据集),初始策略 $\pi_{\theta_0}$ 提供行为新颖度的固定基准(衡量候选动作偏离冷启动策略多远)。这两者都不随递归更新,是整套方法能「有据可依」而不发散的关键。
四、方法详解
4.1 一轮递归里的两拍
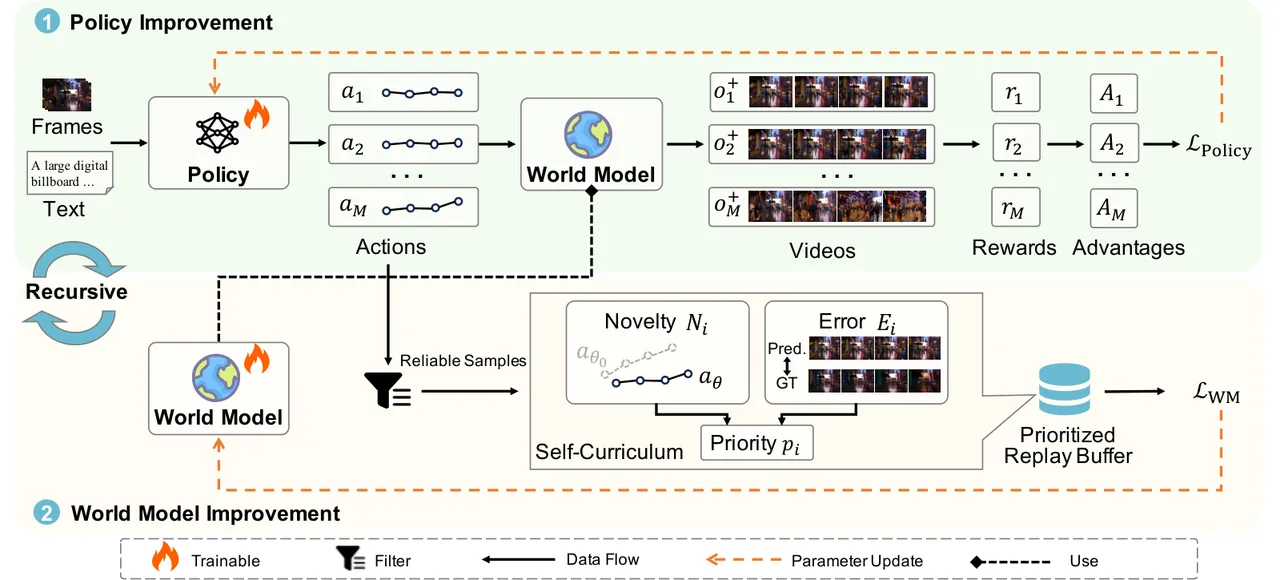
图2:RIWANav 的递归自我改进回路。(1) 当前世界模型想象动作后果,用于改进策略;(2) 改进后的策略构造有据可依的自课程,用于改进下一个世界模型。递归重复这两次更新,同时改变两个组件以及它们之间交换的反馈。论文原图用火焰标记每一阶段被优化的组件。
每个周期严格交替两次更新。第一拍(策略改进):当前世界模型预测若干候选动作的视觉后果,这些后果的相对质量构成比较动作、改进策略的依据。第二拍(世界模型改进):改进后的策略生成候选动作,其中与专家运动一致的那些与录制的未来帧配对,进入策略诱导回放池;有据可依的自课程按行为新颖度与当前预测误差给这些对排优先级,用于世界模型适配。精炼后的世界模型再为下一轮策略更新供给想象反馈。
这个设计的要点在于两拍各自冻结对方:策略更新阶段世界模型固定,世界模型更新阶段策略不动。这避免了「评价者和被评价者同时变化」导致的训练不稳定,也让每一步的归因变清楚——论文后面的消融正是按这个切分做的。
4.2 策略冷启动:行为克隆出一个强初始化
递归需要一个足够强的起点。论文用 UrbanNav 专家轨迹做监督微调(SFT),实现为行为克隆:冻结的 DINOv2 视觉特征、CLIP 文本特征与位姿嵌入一起送进一个 transformer 航点头。SFT 目标 $\mathcal{L}_{\mathrm{SFT}}$ 由三部分组成——航点 $L_1$ 误差、方向误差、停止预测的二元交叉熵。
得到的 $\pi_{\theta_0}$ 在后训练里承担两个角色:它是策略优化的初始化,也是全程固定的行为参照(KL 惩罚的参考策略、行为新颖度的基准)。论文明确指出它本身不会去比较策略提出的多个备选动作——这正是后训练要补上的能力。
4.3 从想象中学习:GRPO 与三重约束
在状态 $s$ 上,当前策略输出均值航点块 $\mu_\theta(s)$,然后采样 $M$ 个候选动作:
$$a_i \sim \mathcal{N}\big(\mu_\theta(s),\ \sigma^2 I\big),\qquad i\in\{1,\ldots,M\}$$
其中 $\sigma$ 控制采样尺度,$I$ 是单位矩阵(实现里 $M=4$)。世界模型在这一阶段保持固定,通过式 (1) 预测每个候选的视觉后果 $\hat{o}_i^{+}$。导航打分函数给每个候选一个分数:
$$r_i = R_{\mathrm{nav}}(s,\ a_i,\ \hat{o}_i^{+})$$
它衡量的是想象后果的质量。这里论文强调了一个方法论上的选择:比较来自同一状态的候选,能降低对奖励绝对尺度的敏感性,直接指出「哪个局部决策产生了更好的想象后果」。这也是选 GRPO 而不是 PPO 的理由——组内相对比较天然免疫奖励标定问题。
组内相对优势按下式计算:
$$A_i = \frac{r_i - \bar{r}}{\operatorname{std}(r_{1:M}) + \epsilon_A} \tag{2}$$
$\bar{r}$ 与 $\operatorname{std}(r_{1:M})$ 是这 $M$ 个奖励的均值与标准差,$\epsilon_A>0$ 保证数值稳定。令 $\pi_{\mathrm{old}}$ 为采样这组候选的策略,$\rho_i(\theta)=\pi_\theta(a_i\mid s)/\pi_{\mathrm{old}}(a_i\mid s)$ 是似然比。航点动作的更新目标是:
$$\mathcal{L}_{\mathrm{Policy}} = -\frac{1}{M}\sum_{i=1}^{M}\min\Big(\rho_i A_i,\ \operatorname{clip}(\rho_i, 1-\eta, 1+\eta)A_i\Big) + \beta D_{\mathrm{KL}}\Big(\pi_\theta(\cdot\mid s)\ \big\|\ \pi_{\theta_0}(\cdot\mid s)\Big) + \lambda_{\mathrm{exp}}\mathcal{L}_{\mathrm{exp}} \tag{3}$$
三项各有分工,值得逐条读清楚:裁剪项用范围 $\eta$ 限制单步更新幅度;KL 项把动作分布约束在冻结的初始策略 $\pi_{\theta_0}$ 附近;专家锚 $\mathcal{L}_{\mathrm{exp}}$ 保留了 SFT 目标里的航点与方向两个分量,把当前预测与录制的专家航点做比较。所以式 (3) 的结构是:组内相对项负责从想象的动作后果里学,而裁剪、KL 惩罚与专家锚三者一起防止策略从监督版本上不稳定地漂移。
4.4 策略诱导回放:先解决「监督是否有效」
第二拍的核心难题是:改进后的策略提出的动作,未必与录制的未来 $o_{t+1:t+T}^{\mathcal{D}}$ 构成可靠对应。大幅偏离专家动作 $a_t^{\mathcal{D}}$ 的候选,那段录制视频根本不是它的后果,拿它做监督就是在教世界模型一个错误的因果关系。论文的处理是只保留与录制专家运动局部一致的策略动作。
一致性度量沿用 UrbanNav 的四个指标:平均距离误差 ADE、最大平均距离误差 MADE、平均朝向误差 AOE、最大平均朝向误差 MAOE。用 $\mathcal{M}=\{\mathrm{ADE},\mathrm{MADE},\mathrm{AOE},\mathrm{MAOE}\}$ 索引,专家一致性分数定义为:
$$Q_i = \frac{\sum_{m\in\mathcal{M}} w_m \exp\!\left[-d_m(a_i, a_t^{\mathcal{D}})/\tau_m\right]}{\sum_{m\in\mathcal{M}} w_m} \tag{4}$$
$d_m(a_i, a_t^{\mathcal{D}})$ 是候选在指标 $m$ 下与录制专家动作的偏差,$w_m$ 是非负权重,$\tau_m>0$ 是各指标专属的尺度。指数核把无界的距离/朝向误差压成 $Q_i\in[0,1]$,四个指标的加权平均让「距离近但朝向反了」这类情况不会被单一指标掩盖。
准入条件是三条同时满足:rollout 有效、$Q_i \geq q_{\min}$、各项最大误差容限也满足($q_{\min}$ 是专家一致性阈值,实现里取 0.35)。通过的动作与其录制未来组成「专家一致的动作-视频对」,作为世界模型训练的可靠样本;每个被准入的三元组 $(s, a_i, o^{+\mathcal{D}})$ 进入策略诱导回放池 $\mathcal{R}_k$。
这里有一个容易被读漏的设计:没通过过滤的候选并没有被丢掉,它们仍然参与策略优化,只是不参与世界模型训练。也就是说,过滤器把「策略阶段可以大胆探索」和「世界模型阶段必须有可靠监督」这两件事解耦了——探索的宽度由 GRPO 那一拍承担,监督的严格性由这一拍承担。
4.5 有据可依的自课程:优先级怎么算
均匀回放把所有准入样本一视同仁,既不看行为新颖度也不看预测误差。论文的自课程给每个动作-视频对算三个量。
第一个是相对初始策略的行为偏离度:
$$D_i = \big\lVert a_i - \mu_{\theta_0}(s)\big\rVert_2 \big/ \sqrt{2H}$$
除以 $\sqrt{2H}$ 是把 $H\times 2$ 维航点向量的欧氏距离做尺度归一,让不同 $H$ 下的 $D_i$ 可比。第二个是当前预测误差 $e_i$:预测未来与录制未来在时间对齐帧上的平均像素 $L_1$ 误差。两者分别映射到有界的新颖度分数与误差分数:
$$N_i = 1-\exp(-D_i/\tau_N),\qquad E_i = 1-\exp(-\tau_E e_i) \tag{5}$$
$\tau_N>0$、$\tau_E>0$ 控制各自的尺度。回放优先级把一致性分数当乘性门控、把新颖度与误差当加性项:
$$p_i = Q_i\left(\epsilon_p + \lambda_N N_i + \lambda_E E_i\right) \tag{6}$$
$\lambda_N$、$\lambda_E$ 平衡新颖度与误差(实现里两者都取 0.50,等权),$\epsilon_p>0$ 保证优先级非零。$Q_i$ 出现在乘法位置是刻意的:一致性差的样本无论多新颖、误差多大,优先级都被整体压低;而 $\epsilon_p$ 让一致性高但既不新颖也不难预测的样本仍保留一个基础被采样概率。
每次世界模型更新时,新准入的与历史的样本在同一个回放池里竞争,按 $p_i^\alpha$ 成比例无放回采样,$\alpha\geq 0$ 控制优先化强度。三个因子合起来的效果是:把适配集中在既与专家一致、又偏离初始策略行为或仍被当前世界模型预测得不好的样本上。
4.6 世界模型更新:用 Cosmos 原生目标
采样出的批 $\mathcal{B}_p\subset\mathcal{R}_k$ 定义世界模型目标:
$$\mathcal{L}_{\mathrm{WM}}(\phi) = \mathbb{E}_{(s,a_i,o^{+\mathcal{D}})\sim\mathcal{B}_p}\Big[\mathcal{L}_{\mathrm{video}}\big(f_\phi(o_t, \mathcal{A}(a_i), \ell),\ o^{+\mathcal{D}}\big)\Big] \tag{7}$$
$o^{+\mathcal{D}}$ 是与 $a_i$ 配对的录制未来,$\mathcal{L}_{\mathrm{video}}$ 是 Cosmos 的原生条件视频模型目标。这一点在工程上很关键:论文没有为世界模型适配发明新的损失,改的只是「喂什么数据、按什么优先级喂」,视频重建目标本身沿用预训练模型的原生形式。适配后 $f_{\phi_{k+1}}$ 负责评价后续的策略候选动作,供给更新过的想象反馈,递归闭合。
4.7 实现参数与一轮的完整数据流
论文给的实现细节很完整:策略预测 8 秒内的 8 个航点,每个状态比较 4 个候选;Cosmos 由 16 个相对位姿动作预测 17 帧、2 fps。策略训练学习率 $10^{-5}$、裁剪范围 $\eta=0.20$;自课程阈值 $q_{\min}=0.35$、$\lambda_N=\lambda_E=0.50$;世界模型每 500 个策略步更新一次,每次最多用 500 个回放样本。训练跑在 4 张 NVIDIA H200 上。实机部署用一台自建移动机器人平台,前视相机提供 RGB 观测。
flowchart TD
    D[UrbanNav 离线数据集
状态 + 专家动作 + 录制未来帧] --> SFT[策略冷启动 SFT
DINOv2 + CLIP + 位姿嵌入
transformer 航点头]
    SFT --> P0[初始策略 θ0
同时是 KL 参照与新颖度基准]
    P0 --> SAMP[采样 M=4 个候选动作
高斯扰动均值航点块]
    WM[当前世界模型 φk 冻结] --> IMAG[想象每个候选的视觉后果
Cosmos 17 帧 2fps]
    SAMP --> IMAG
    IMAG --> SC[导航打分 R_nav
得到组内分数 r_i]
    SC --> GRPO[GRPO 组内相对优势
裁剪 + KL 到 θ0 + 专家锚]
    GRPO --> PK[改进后的策略 θk+1]
    PK --> FILT[专家一致性过滤
ADE MADE AOE MAOE 加权 Q_i
阈值 q_min = 0.35]
    FILT --> POOL[策略诱导回放池 R_k
动作-视频对]
    POOL --> CURR[有据可依的自课程
新颖度 N_i + 预测误差 E_i
优先级 p_i]
    CURR --> WMUP[世界模型更新
每 500 策略步 最多 500 样本
Cosmos 原生视频目标]
    WMUP --> WM2[新世界模型 φk+1]
    WM2 -. 下一轮想象反馈 .-> WM
    PK -. 未通过过滤的候选仍用于策略优化 .-> GRPO
把参数放回流程里能看出代价结构:一次世界模型更新对应 500 个策略步,而每个策略步要为 4 个候选各跑一次 Cosmos 视频预测。$K=19$ 轮递归意味着世界模型被更新了 19 次,每次最多 500 个样本——世界模型适配在总计算量里是小额支出,想象反馈(策略阶段的视频预测)才是大头。这也解释了作者把「适配大型视频世界模型增加内存与计算」列为局限时的实际含义。
五、实验结果
5.1 设置:一次严格的控制变量比较
评测在 UrbanNav 官方的 train / test-seen / test-unseen 三个划分上做。所有训练框架接收完全相同的近期帧、位姿历史与语言目标,都预测 8 个局部航点加一个停止概率,共用同一份数据划分、episode 列表、轨迹映射与 3 米成功半径。除特别说明外,结果是 3 个随机种子的均值与标准差。
指标共六个:成功率 SR(最终是否到达目标)、oracle 成功率 OSR(访问过的任一姿态是否进入目标区域)、导航误差 NE(最终与目标的距离)、SPL(按路径长度加权的成功率,衡量效率)、nDTW 与 SDTW(归一化动态时间规整及其成功加权版本,衡量轨迹保真度)。除 NE 外都是越高越好。
基线的构造方式是这篇论文实验设计里最值得学的部分:控制比较固定策略架构、初始化、数据、接口与评测协议,只改后训练框架。模仿学习是所有框架共享的策略;PPO 与 GRPO 是纯策略基线,优化同一个导航目标但没有动作条件的视觉反馈;PPO-WM 与 GRPO-WM 在对应优化器上加一个冻结的 Cosmos 提供想象后果;RIWANav 用 GRPO 做策略改进,并额外用本文的自课程适配 Cosmos。与已有方法的对比(表2)里,NoMaD 补了文本条件与停止头,OmniVLA 用 LoRA 微调其连续动作头,NWM 按视觉-语言目标对齐重排 4 个策略候选,UrbanNav 与 Fast-WAM 保留原检查点与原生动作接口。
5.2 主结果:递归回路带来的那一跳
| 训练框架(test-unseen) | SR (%) ↑ | SPL (%) ↑ | NE ↓ | nDTW (%) ↑ | SDTW (%) ↑ | OSR (%) ↑ |
|---|---|---|---|---|---|---|
| 模仿学习 | 67.88 | 66.03 | 4.4537 | 80.85 | 64.99 | 68.16 |
| PPO | 67.94 ± 0.09 | 65.65 ± 0.16 | 4.3768 ± 0.0434 | 80.76 ± 0.05 | 65.04 ± 0.08 | 68.38 ± 0.07 |
| GRPO | 70.63 ± 1.10 | 68.49 ± 1.06 | 4.5795 ± 0.0894 | 82.34 ± 0.54 | 67.82 ± 1.13 | 70.91 ± 1.07 |
| PPO-WM(冻结世界模型) | 75.05 ± 0.21 | 72.44 ± 0.19 | 3.5912 ± 0.0462 | 84.96 ± 0.15 | 72.27 ± 0.22 | 75.56 ± 0.21 |
| GRPO-WM(冻结世界模型) | 80.31 ± 0.94 | 76.09 ± 1.05 | 3.3314 ± 0.1014 | 87.77 ± 0.45 | 77.62 ± 0.92 | 81.01 ± 0.82 |
| RIWANav(本文) | 88.25 ± 0.43 | 82.59 ± 0.25 | 2.0429 ± 0.0815 | 91.95 ± 0.16 | 85.51 ± 0.39 | 89.37 ± 0.44 |
test-seen 上的阶梯形状一致:模仿学习 70.91/70.55(SR/SPL)、PPO 72.04/71.40、GRPO 75.11/74.45、PPO-WM 78.90/78.25、GRPO-WM 83.35/81.27、RIWANav 89.92/86.87,NE 从 3.8427 一路降到 1.7842。
这张表可以拆成三个结论。第一,纯策略后训练收益有限。test-unseen 上 PPO 相对模仿学习只改动 SR/SPL 各 +0.06%/-0.38%,GRPO 好一些,+2.75%/+2.46%。从共享的模仿初始化出发,只换优化器挖不出多少东西。第二,冻结世界模型的想象反馈是最大的一跳。PPO-WM 比 PPO 高 7.11%/6.79%,GRPO-WM 比 GRPO 高 9.68%/7.60%——在还没做任何世界模型适配之前,想象出的视觉后果本身就已经是有用的训练信号。第三,闭合递归回路再拿一段。相对 GRPO-WM,RIWANav 在 test-seen 上高 6.57%/5.60%,在 test-unseen 上高 7.94%/6.50%,两个划分的全部六个指标都是最好。NE 从 3.3314 降到 2.0429,nDTW/SDTW/OSR 从 87.77/77.62/81.01 升到 91.95/85.51/89.37。
第三点里有一个细节值得强调:成功、路径效率、路线保真度、oracle 成功率四类指标同向改善。论文据此论证,策略引导的世界模型适配改进的是完整 rollout,而不只是「什么时候停」这个决策——如果只是停止判断变准,SR 与 OSR 会涨而 nDTW/SDTW 不会跟着涨。
| 类别 | 方法 | test-seen SR / SPL (%) | test-unseen SR / SPL (%) | test-unseen NE ↓ | test-unseen SDTW / OSR (%) |
|---|---|---|---|---|---|
| 模仿学习 | UrbanNav | 60.36 / 59.75 | 60.99 / 59.45 | 5.3680 | 57.93 / 61.18 |
| 模仿学习 | NoMaD | 82.35 / 77.59 | 84.80 / 79.85 | 2.3520 | 80.37 / 85.09 |
| 模仿学习 | OmniVLA | 77.49 / 77.25 | 81.11 / 80.80 | 2.9283 | 77.05 / 81.17 |
| 世界模型 | Fast-WAM | 58.48 / 39.57 | 55.25 / 35.00 | 9.2896 | 47.16 / 59.75 |
| 世界模型 | NWM | 71.26 / 70.67 | 67.99 / 65.93 | 4.4130 | 65.06 / 68.46 |
| 递归自我改进 | RIWANav(本文) | 89.92 / 86.87 | 88.25 / 82.59 | 2.0429 | 85.51 / 89.37 |
与已有方法的对比里,RIWANav 在两个划分的全部六个指标上都是最好。相对 SR 最强的先前方法 NoMaD,test-unseen 的 SR/SPL 高 3.45%/2.74%,NE 少 0.3091,SDTW/OSR 高 5.14%/4.28%;相对 SPL 最强的 OmniVLA,SR/SPL 高 7.14%/1.79%、nDTW 高 1.13%。在预测式模型这一类里,它比 NWM 高 20.26%/16.66%,NE 从 4.4130 降到 2.0429。论文对这条对比的解读是:同时优于学习型策略与预测式重排模型,说明递归自我改进是一种训练效应,而不是某个基线设计带来的偶然结果。
不过这张表也留下了一个需要读者自己判断的问题:Fast-WAM 与 NWM 的表现明显弱于 NoMaD(test-unseen SR 分别只有 55.25% 与 67.99%),它们都是世界模型路线的代表作。论文没有解释这个差距有多少来自「方法本身不适合城市导航」、多少来自接口适配(NWM 被改造成对 4 个策略候选做视觉-语言目标对齐重排)。也就是说,「RIWANav 比世界模型基线高 20 个点」这句结论的强度,取决于那次重排改造是否公平。
5.3 消融:一个诚实的负结果
| 世界模型更新 | 策略诱导回放 | 有据自课程 | SR (%) ↑ | SPL (%) ↑ |
|---|---|---|---|---|
| ✗ | ✗ | ✗ | 80.31 ± 0.94 | 76.09 ± 1.05 |
| ✓ | ✗ | ✗ | 78.23 ± 1.91 | 74.72 ± 1.92 |
| ✓ | ✓ | ✗ | 84.83 ± 0.33 | 80.11 ± 0.32 |
| ✓ | ✓ | ✓ | 88.25 ± 0.43 | 82.59 ± 0.25 |
消融在 test-unseen 上做,四行对应四种配置。这里的第二行是全文最有信息量的一行:只开世界模型更新、但用录制的专家动作-视频对做静态回放(static expert replay),SR 与 SPL 反而比冻结世界模型基线低 2.08% 与 1.37%,标准差也从 ±0.94 涨到 ±1.91。
换句话说,「更新世界模型」本身不是收益来源,甚至有害。收益来自更新时用的是谁的动作:把静态专家回放换成策略诱导回放(均匀采样),SR/SPL 涨 6.60%/5.39%;再叠加有据可依的自课程(按新颖度与预测误差排优先级而不是均匀采样),又涨 3.42%/2.48%。两者合起来相对冻结世界模型基线是 7.94%/6.50%。
这个负结果把论文的论点从「世界模型要更新」精确化为「世界模型必须在策略自己产生的行为分布上更新」。用专家数据继续微调世界模型,只会让它更擅长预测专家会看到的画面,而策略优化需要的恰恰是对策略当前会走到的那些状态的准确预测——两者的分布差异就是那 2.08% 的损失。这也和图1(b) 的动机叙述严丝合缝。
5.4 递归证据:世界模型本身有没有变准
| 世界模型 | 评测动作 | $L_1$ ↓ | LPIPS ↓ |
|---|---|---|---|
| 初始 $\phi_0$ | 专家动作 | 0.1396 ± 0.0032 | 0.4532 ± 0.0065 |
| 策略诱导动作 | 0.1521 ± 0.0042 | 0.4539 ± 0.0059 | |
| 静态专家适配 | 专家动作 | 0.1352 ± 0.0034 | 0.4265 ± 0.0079 |
| 策略诱导动作 | 0.1505 ± 0.0044 | 0.4314 ± 0.0067 | |
| RIWANav $\phi_K$ | 专家动作 | 0.1329 ± 0.0034 | 0.4203 ± 0.0079 |
| 策略诱导动作 | 0.1472 ± 0.0043 | 0.4217 ± 0.0070 |
这一节回答论文的第三个问题:世界模型在改进后的策略行为上是否变得更准。评测集是两个固定的、各含 128 个状态-动作对的集合,全部排除在所有世界模型更新之外:一个是专家动作,一个是训练后期由改进策略生成的动作(策略诱导动作)。在同样的 8 秒时程上报告逐帧 $L_1$ 误差与 LPIPS 感知相似度,都是越低越好。
结果是:最终的 RIWANav 世界模型在两个分布上都最好,相对初始模型在专家动作上把 $L_1$/LPIPS 降低 4.8%/7.3%,在策略诱导动作上降低 3.2%/7.1%。静态专家适配也改善两个分布;策略引导的适配在其之上再降——专家动作上 1.7%/1.5%,策略诱导动作上 2.2%/2.2%。论文原图 Fig.3 还追踪了这两条指标在 19 轮递归中的走势(第 0 轮是初始世界模型,最后一轮 $K=19$ 是 RIWANav 的最终模型):尽管单次更新之间有小幅波动,两个动作分布上的误差整体下降,且大部分改进保留到了最后一轮。
把这组数字和 5.3 的消融放在一起读,能得到本文最干净的因果链:策略引导的适配同时改善了「对策略自己动作的预测」和「对专家动作的预测」,说明它不是在牺牲原分布质量去追新分布。但也要说清量级——$L_1$ 只降了 3.2%(0.1521→0.1472),而对应的 SR 涨了 7.94%。世界模型精度的小幅提升换来策略性能的大幅提升,这个杠杆比例论文没有解释机制。
5.5 定性结果:三个世界模型的对照
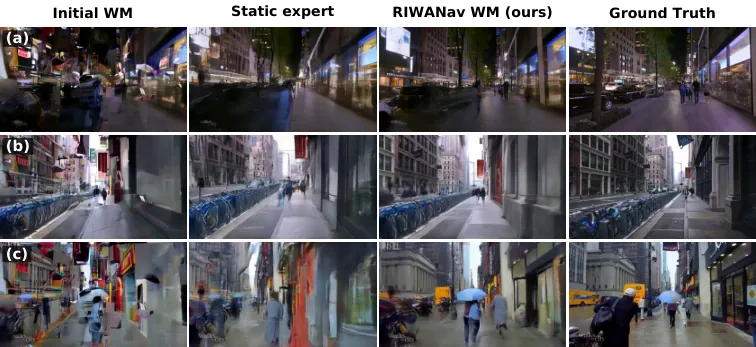
图3(论文 Fig.4):在改进策略生成的动作上做递归世界模型改进的定性证据。初始世界模型、静态专家适配、RIWANav 三者接收完全相同的观测、语言目标与动作,右侧给出时间对齐的录制未来作为参考。三行分别是夜间车流、两侧停满自行车的人行道、雨天人行道。在这些案例里,经过递归更新的 RIWANav 世界模型更好地保留了可通行走廊与场景布局,长时程伪影更少。
论文的描述是:初始世界模型在 8 秒 rollout 中经常丢失场景结构,静态专家适配并不能稳定地解决改进策略分布下的畸变,而最终的 RIWANav 世界模型给出更连贯的人行道边界、立面几何、以及车辆与行人的排布。这些案例与表4 的 $L_1$/LPIPS 改进一致:适配到策略诱导行为,能更可靠地为改进策略生成的动作保留场景结构。需要注意的是,这是三组手挑的案例,没有配套的定量统计(例如伪影发生率)。
5.6 实机部署
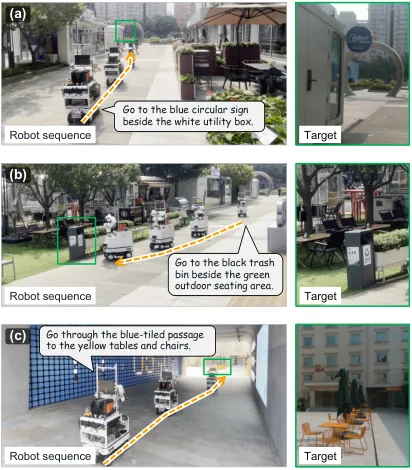
图4(论文 Fig.5):RIWANav 的真实世界城市导航。橙色虚线箭头示意路径,绿框标出目标。三组任务的语言目标分别是「白色配电箱旁的蓝色圆形标识牌」「绿色座椅旁的黑色垃圾桶」「通向黄色桌椅的蓝色瓷砖通道」,覆盖不同路线布局与光照条件。
部署形态是:给一句自然语言指令加机载视觉观测,策略预测航点引导机器人走向指定目标。论文展示了跨不同路线布局与光照条件的导航序列,结论是这些定性试验表明学到的策略能引导实体机器人走向语言指定的地标,支持 RIWANav 在离线评测之外的实用可行性。这一节没有成功率数字、没有试验次数、也没有与基线的实机对比——它是可行性演示,不是实机评测。
六、局限性
作者自述的四条。其一,当前实现是任务专用的,并且依赖一个固定的离线数据集。其二,也是最本质的一条:录制的未来只能监督接近专家运动的策略动作,这在没有新交互数据的情况下限制了反事实探索——式 (4) 的一致性过滤保证了监督有效性,代价就是把世界模型的适配范围钉死在专家轨迹的邻域里。其三,适配大型视频世界模型增加内存与计算。其四,虽然实机试验证明了可行性,但还需要跨城市、跨环境、跨机器人本体的更广评测。
我的判断,五条。
第一,导航打分函数 $R_{\mathrm{nav}}$ 在全文没有被定义。式 (1) 到式 (7) 都写得很细,但整个策略改进的信号源 $r_i = R_{\mathrm{nav}}(s, a_i, \hat{o}_i^{+})$ 只有一句「衡量想象后果的质量」。它到底读不读预测帧的像素、还是只用航点几何与语言目标的对齐、是否使用了停止头——这些决定了这套方法能不能被别人复现,也决定了「想象反馈」这个说法的字面成立程度。这是本文最大的可复现性缺口。
第二,世界模型精度提升与策略性能提升之间的量级不匹配。$L_1$ 在策略诱导动作上只降 3.2%、LPIPS 降 7.1%,SR 却涨 7.94%、NE 降 38.7%。要么是 GRPO 对打分函数的微小偏差极其敏感(那这套方法的稳定性就值得怀疑),是 $R_{\mathrm{nav}}$ 主要依赖预测中某个被 $L_1$/LPIPS 平均掉的局部特征(比如可通行走廊的边界)。论文没有做这层归因。
第三,静态专家回放的负结果把功劳判给了数据分布,但也削弱了「递归」这个叙事的必要性。既然关键是「用策略自己的动作去更新世界模型」,那么一个非递归的替代方案——直接用当前策略采样、过滤、更新世界模型,交替但不用优先级课程——已经能拿到 84.83/80.11,占最终 88.25/82.59 的大部分。自课程贡献的 3.42%/2.48% 是真实的,但「递归自我改进」这个框架名承载的期望值高于它实际解释的增益比例。
第四,关键超参没有消融。$q_{\min}=0.35$ 决定了回放池的准入门槛,直接控制「监督有效性」与「覆盖策略分布」的权衡;$\lambda_N$、$\lambda_E$ 只是取了等权 0.50;$\alpha$(优先化强度)、$\tau_N$、$\tau_E$、$\tau_m$、$w_m$ 全部没有给出数值也没有敏感性分析。$q_{\min}$ 尤其关键:调高它世界模型退回专家分布(对应消融第二行的负结果),调低它会引入错误因果配对,最优点在哪、有多宽,论文没有回答。
第五,新颖度的参照 $\mu_{\theta_0}$ 是固定的。$D_i$ 衡量的是「偏离冷启动策略多远」,这在训练早期等价于「新颖」,但到第 19 轮时策略已经走了很远,大量样本的 $D_i$ 都会饱和在高位,新颖度项逐渐退化成常数偏置,课程实际由 $E_i$(预测误差)主导。把它换成对当前策略 $\mu_{\theta_k}$ 的偏离、或者对回放池历史密度的度量,可能更贴合「课程」的原意。论文没有讨论这个随轮次退化的问题。
七、总结与展望
RIWANav 的贡献可以压成一句话:用于策略优化的世界模型不能冻结,但也不能用专家数据去更新——它必须在策略自己产生的、且仍能被录制未来合法监督的那部分行为上更新。具体而言,它把世界模型与导航策略的耦合适配形式化为任务专用的递归自我改进,每轮交替两次冻结对方的更新;策略侧用 GRPO 的组内相对优势配合裁剪、KL 与专家锚三重约束;世界模型侧用四指标指数核的一致性分数 $Q_i$ 做准入门控、用行为新颖度 $N_i$ 与预测误差 $E_i$ 做加性优先级,采样后沿用 Cosmos 原生视频目标。
实验设计是这篇论文扎实的地方:控制变量比较(同一策略架构、同一初始化、同一数据、同一接口、同一评测协议,只换后训练框架)、三种子的均值±标准差、六个指标同向改善、两个固定且排除在更新之外的世界模型评测集。消融里那个「静态专家回放反而变差」的负结果被如实报告并用来支撑论点,这在世界模型文献里并不常见。
往前看,作者自述的局限其实就是路线图:解开「固定离线数据集」这个约束。当前整套设计里最别扭的地方,是一边要靠策略探索出新行为,一边又只能用录制未来做监督,于是必须用一致性过滤把探索裁回专家邻域。一旦允许少量真实交互(哪怕只在世界模型最不确定的那些状态上),$Q_i$ 的门控就可以松开,反事实探索的空间立刻打开,「递归」的含金量也会随之上升。另一个方向是把这套耦合更新从任务专用的导航搬到多任务或跨本体的设置——目前它依赖 UrbanNav 提供的专家动作与录制未来这一对严格对齐的监督,换个数据集就要重新定义一致性度量。
对做机器人后训练的人,可以直接拿走的经验有三条:一,想象反馈即使来自冻结世界模型也是强信号(GRPO→GRPO-WM 的 +9.68% SR 是全文最大的一跳),不要因为没有在线适配就放弃世界模型;二,用专家数据继续微调世界模型可能有害,要先确认更新数据的行为分布是不是策略当前会访问的那一个;三,优先级课程里把「有效性」放在乘法位置、「价值」放在加法位置(式 6 的 $Q_i(\epsilon_p + \lambda_N N_i + \lambda_E E_i)$)是个可迁移的结构,它保证了再高的新颖度也不能把一个监督无效的样本推进训练集。
金句
世界模型不是策略的老师,是策略的镜子——策略走远了,镜子就得跟着重新磨;而用专家的旧照片磨镜子,只会让它照不清策略现在站的地方。