RIWANav:世界模型与导航策略的递归自我改进
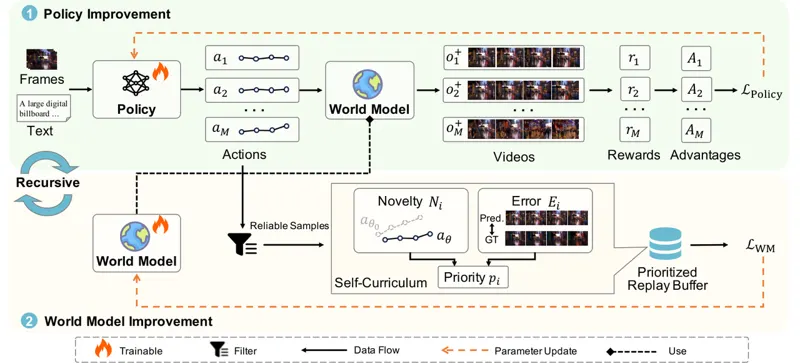
城市长距离导航里一步走偏会顺着后续观测一路放大,而模仿学习只监督专家的成功动作、真机试错又太贵;用冻结世界模型做想象反馈则会随策略演化逐渐失准。RIWANav 把「动作条件世界模型 + 策略」的耦合适配写成任务级递归自我改进:Cosmos 世界模型为同一状态下采样的 4 个候选路点块想象未来 17 帧,打分后经 GRPO 的组内相对优势更新策略,并配 KL 与专家锚点两项防漂移;改进后的策略再提出动作,只保留与记录专家运动局部一致(ADE/MADE/AOE/MAOE 加权一致性 Q≥0.35)的动作-视频对进入策略诱导回放池,按相对初始策略的行为新颖度与当前预测误差排优先级去微调世界模型,K=19 轮闭环。UrbanNav test-seen 成功率 89.92%、SPL 86.87%,test-unseen 88.25%/82.59%,比冻结世界模型的 GRPO-WM 高 7.94/6.50 个百分点,导航误差从 3.3314 降到 2.0429;世界模型在策略动作上 L1/LPIPS 各降 3.2%/7.1%。已在自建移动机器人上完成城市实机验证。
Jing Xie, Shouwei Ruan, Yubin Wang · 8次阅读 · 2026年10月6日
UrbanNavigationWorldModel
2026年10月6日