PAPER DEEP DIVE
UniWAM:混合流世界-动作建模与操作锚点位姿监督的统一移动操作
UniWAM 将导航与操作建模为共享视频和动作扩散主干上独立采样的两条控制流,并用大规模自动生成的操作锚点位姿监督机器人停靠,在 MAP-Bench 与 24 项真机任务上提升导航精度和移动操作成功率。
论文信息:Wei Xue、Keliang Liu、Mingzhang Cui、Jinhua Xie、Jinjie Wei、Jianan Hou、Jingcheng Lu、Lintao Wang、Kaixiang Qiu、Yizhou Liu、Xinghai Ye、Jinghang Han、Mingcheng Li、Jie Gu、Shunli Wang、Lihua Zhang、Dingkang Yang。技术报告提交于 2026 年 9 月 30 日。论文链接:arXiv:2609.39388;项目页:UniWAM Project;代码:Fysics-AI/UniWAM;数据:MAP-Data 与 MAP-Bench。代码以 Apache-2.0 许可证发布,本次核对的提交为 0a83bdab。
一句话总结
UniWAM 把移动操作拆成共享世界模型的导航流与操作流,并用可自动生成的“操作锚点位姿”明确告诉机器人走到哪里、朝哪个方向停下,从而同时改善远程停靠、移动操作和固定基座操作。
研究背景与动机
移动操作不是导航与机械臂操作的简单拼接。机器人先要用广角视野找到远处目标,穿过房间并停在适合伸手的位置;停稳以后,控制器又要切换到窄视野、腕部相机和多自由度机械臂动作。两个阶段的观测视角、动作空间、控制频率与有效数据分布都不同。若把它们压成一个动作向量,网络必须用同一组动作 token 同时解释米级底盘位移和厘米级末端执行器运动,这会让共享表示承担本不必要的冲突。
已有统一策略通常选择两条路线。第一类方法把所有自由度放进一个动作头,缺失数据通过补零或掩码处理;第二类方法在动作模块内部设置两个专家,但仍然让同一个训练样本同时监督导航与操作。两种路线都隐含了一个假设:一条完整移动操作轨迹中的每一帧都应该为两种行为提供同等有效的监督。论文指出这个假设与真实数据不符。机器人导航时机械臂多数时间静止,操作时底盘多数时间静止,联合监督会把大量“保持不动”的指令混入训练,也会把可独立采集的导航数据与操作数据绑在完整轨迹里。
第二个问题更靠近任务定义。“可操作位置”究竟是哪个点?传统方法可能学习地板可通行区域、候选基座位姿、可达性反演或从策略 rollout 中得到的偏好分布。这些表示要么依赖具体机械臂,要么依赖具体策略,要么只给出评分而不监督接近过程。结果是模型经常已经看见目标,却在目标旁边停下,或者朝向偏差使机械臂够不到物体。移动操作真正需要的是一个几何上明确、可批量生成、能监督整段接近轨迹的终点。
论文提出的两个核心对象正好对应上述问题。Architecture 侧的“混合流”把导航与操作放到共享视频 DiT 和动作 DiT 的不同 batch row 中,两个流只通过参数共享交换知识;数据侧的 Manipulation Anchor Pose 把基座停止位置与朝向写成显式目标,并由此生成超过 150 万条带图像平面标注的导航轨迹。这个组合既解决训练样本如何组织的问题,也解决“停在哪里”如何定义的问题。
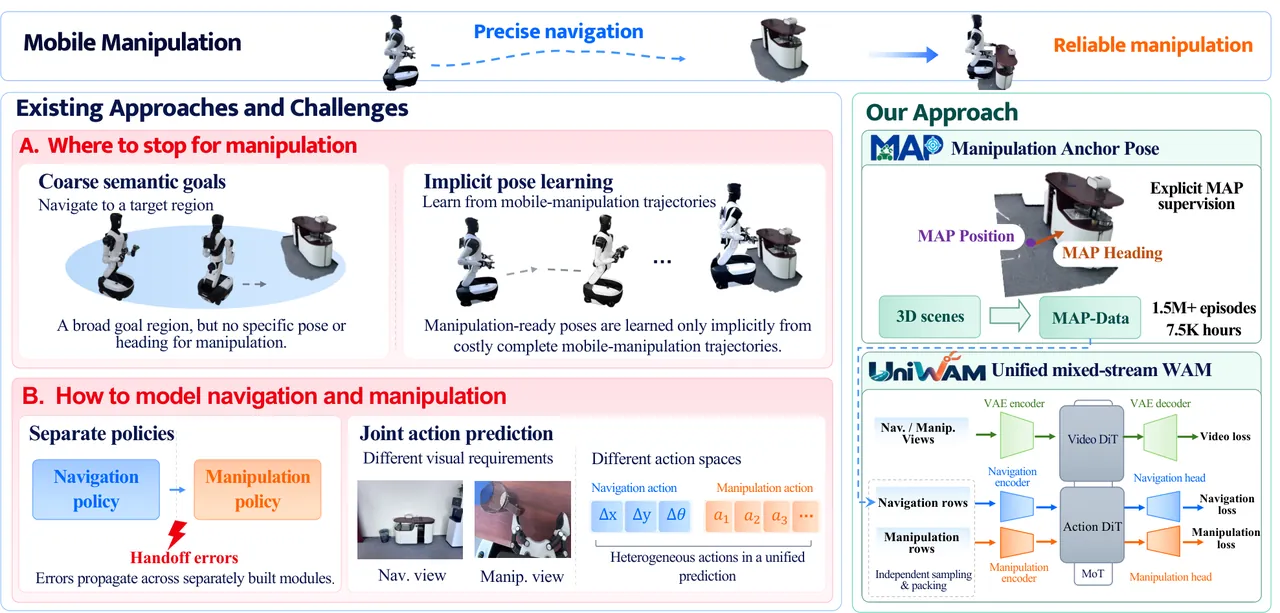
问题定义与评价对象
给定一个操作目标 $o_i$,其操作锚点位姿定义为一个二维位置与一个朝向:
$$\mathbf{m}_i=(\mathbf{p}_i^{\mathrm{MAP}},\theta_i^{\mathrm{MAP}}),\qquad \mathbf{p}_i^{\mathrm{MAP}}\in\mathbb{R}^2,\quad \theta_i^{\mathrm{MAP}}\in\mathbb{S}^1.$$这个定义刻意不依赖某一台机器人的臂长、某一套策略或某一次 rollout。它只描述场景中一个适合开始操作的目标基座位姿,因此可以在三维场景里自动计算。与只给候选基座打分不同,MAP 还允许生成从任意可行观察位姿到该终点的完整轨迹,并对轨迹中的每一帧给出“目标框在哪里、终点在图像中的哪里”的监督。
论文用位置误差和朝向误差评价停靠质量。对 $N$ 条评测轨迹,平均位置误差与平均绝对朝向误差分别是:
$$E_{\mathrm{pos}}=\frac{1}{N}\sum_{r=1}^{N}\left\|\widehat{\mathbf{p}}_r-\mathbf{p}_r^{\mathrm{MAP}}\right\|_2,\qquad E_{\mathrm{head}}=\frac{1}{N}\sum_{r=1}^{N}\left|\operatorname{wrap}\left(\widehat{\theta}_r-\theta_r^{\mathrm{MAP}}\right)\right|.$$位置误差以厘米报告,朝向误差以度报告,并按初始距离分成小于 1.5 米、1.5 至 3.5 米、至少 3.5 米三档。该分层很重要,因为小范围偏差可能被短程控制器吸收,而朝向误差会随着接近距离放大。论文还规定,若动作块中至少 80% 的相对位姿都接近零,并且最后一项也接近零,则视为停止信号;连续三个这样的动作块后结束 episode,避免不同基线的停止判断不一致。
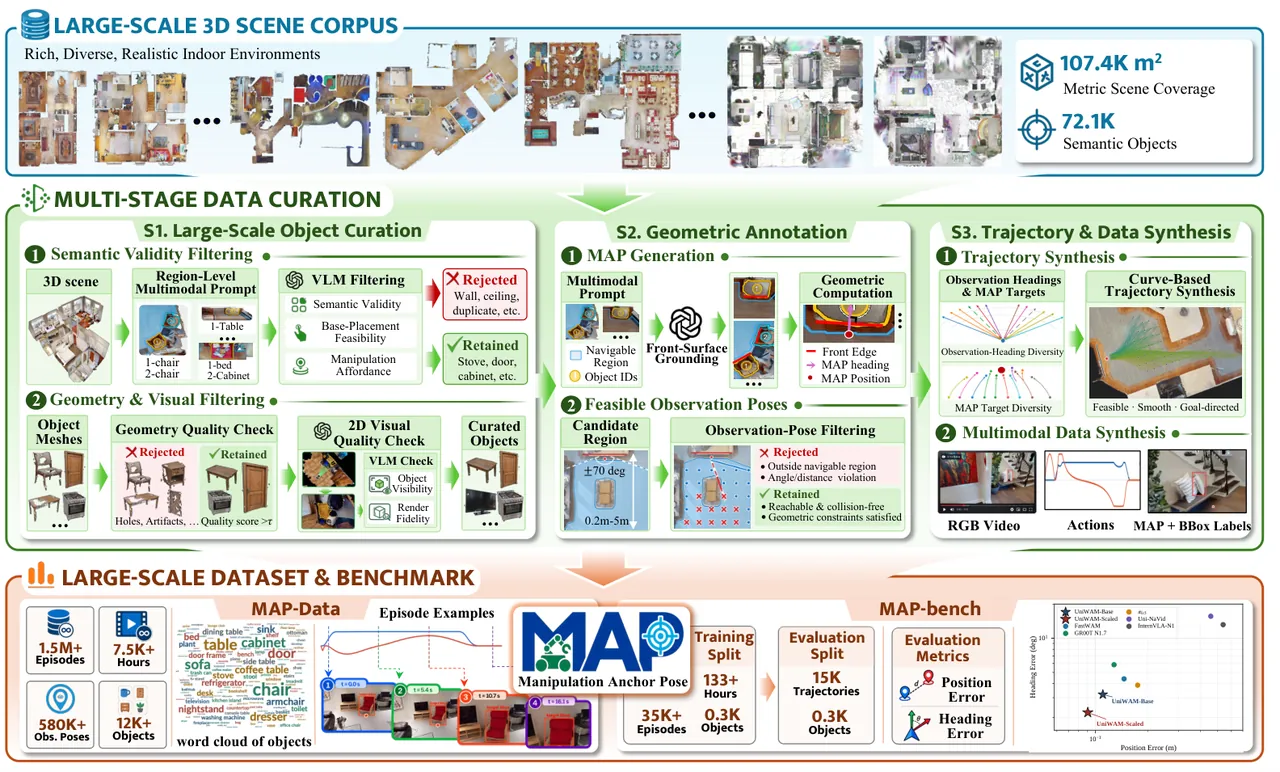
MAP-Data 的自动化构造
数据管线从 HM3D、HM3D-Semantics、InteriorGS 与大规模室内场景中收集环境。第一阶段把异构输入统一成目标实例、可导航区域和可渲染观察位姿。网格场景要经过几何与通行性检查,高斯场景要结合占据图和渲染结果验证。没有实例标注的数据会借助语义实例分割获得候选掩码,随后还要通过语义唯一性、几何完整性、目标前方存在无碰撞基座空间、以及多个可行视角下仍可稳定观察等筛选。
第二阶段由视觉语言模型识别目标面向操作的一侧。设该前缘在地面上的中点为 $\mathbf{p}_f$,指向可导航空间的单位法向量为 $\mathbf{n}_f$,则 MAP 位置是射线与可通行区域边界的交点,朝向让基座面向目标表面:
$$\mathbf{p}^{\mathrm{MAP}}=\operatorname{Ray}(\mathbf{p}_f,\mathbf{n}_f)\cap\partial\mathcal{F}_{\mathrm{nav}},\qquad \theta^{\mathrm{MAP}}=\operatorname{atan2}\left((\mathbf{p}_f-\mathbf{p}^{\mathrm{MAP}})_y,(\mathbf{p}_f-\mathbf{p}^{\mathrm{MAP}})_x\right).$$第三阶段用单段或多段三次贝塞尔曲线连接观察位姿与 MAP。每个分段由四个控制点决定:
$$\mathbf{q}(s)=(1-s)^3\mathbf{c}_0+3(1-s)^2s\,\mathbf{c}_1+3(1-s)s^2\mathbf{c}_2+s^3\mathbf{c}_3,\qquad s\in[0,1].$$当直线曲线被障碍物挡住时,A* 搜索提供无碰撞走廊,再由分段拟合生成平滑路径。轨迹只有在始终位于安全导航区域、从标注正确的侧面接近目标、目标操作边界持续落在水平视野内,并满足曲率与长度约束时才会保留。终点位置不准、朝向错误或出现明显折返的轨迹会被删除。这样得到的不是一张静态热力图,而是可渲染、可执行、逐帧可监督的轨迹集合。
对轨迹中的每一帧,系统保存自中心 RGB 图像、平面导航动作、目标框和投影后的 MAP 点。投影公式为:
$$\mathbf{u}_t^{\mathrm{MAP}}=\Pi\left(T_{c_t\leftarrow w}\begin{bmatrix}x_{\mathrm{MAP}}&y_{\mathrm{MAP}}&z_{\mathrm{MAP}}&1\end{bmatrix}^{\top}\right),$$其中 $T_{c_t\leftarrow w}$ 把世界坐标映射到相机坐标,$\Pi$ 应用相机内参和透视除法。由此,导航动作不仅有“下一步怎么走”的数值标签,还同时对应“目标在图像中的框”和“终点在图像中的点”。MAP-Data 最终包含超过 150 万条 episode 和 7500 小时导航轨迹;MAP-Bench 则保留 300 个目标、109 个场景、35,454 条训练轨迹和 15,000 条评测轨迹,并在 $SE(2)$ 空间中聚类初始位姿,确保训练与评测不共享近似重复的起点。
UniWAM 的混合流架构
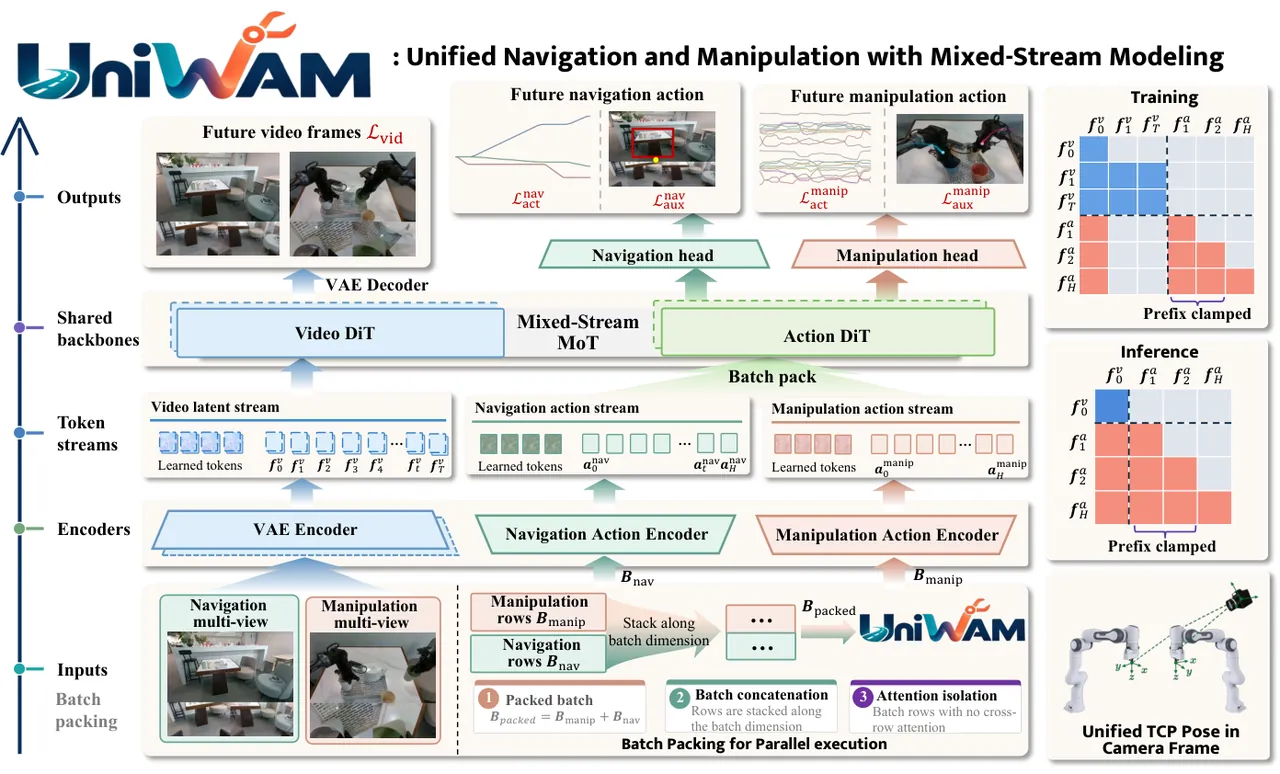
UniWAM 令 $s\in\{\mathrm{nav},\mathrm{manip}\}$ 表示导航或操作流。时刻 $t$ 的流输入包括各自的相机观测 $o_t^s$、语言指令 $\ell$ 与机器人本体状态 $q_t$,输出长度为 $H$ 的动作块:
$$A_t^s=(a_{t,1}^s,\ldots,a_{t,H}^s)=f_{\phi}^s(o_t^s,\ell,q_t).$$两个流的编码器、输出头和可学习 token 独立,但 $f_\phi^s$ 内部的视频 DiT 与动作 DiT 参数共享。导航流使用浅角度、广视野头部相机;操作流使用俯视头部相机和两个腕部相机。执行完整移动操作时,导航流还会读取腕部画面,以观察接近过程中机械臂的相对位置。两条流可以单独推理,也可以在同一次前向计算中批量并行。
导航动作不是底盘线速度与角速度,而是动作块起点坐标系下的平面位姿增量 $(\Delta x,\Delta y,\Delta\theta)$。论文给出的理由是标签分布:真实移动底座受保守速度限制,记录到的速度经常集中在零或速度上限,形成类似夹爪开合的二值分布。把一段速度累积成位姿增量后,目标成为连续路径,更容易由连续动作模型拟合。低层控制器仍可把增量转换成目标速度,因此接口改变没有增加执行难度。
操作流把每条机械臂表示为 10 维动作:三维末端位置、六维旋转与一维夹爪状态,双臂共 $(3+6+1)\times2=20$ 维。六维旋转取旋转矩阵前两列,再用 Gram-Schmidt 正交化恢复完整矩阵。位置与旋转都表达在当前主相机坐标系中,视觉上相近的运动在不同机器人之间也拥有相近的数值目标。单臂机器人缺失的一侧补零并在损失中屏蔽。
训练时,两个流编码后的张量沿 batch 维拼接,而不是沿序列维拼接:
$$X^{\mathrm{pack}}=\operatorname{Concat}_B\left(X^{\mathrm{manip}},X^{\mathrm{nav}}\right)\in\mathbb{R}^{(B_{\mathrm{manip}}+B_{\mathrm{nav}})\times L\times D}.$$因此一个导航样本永远不会在同一行里注意操作 token,一个操作样本也不会读取导航画面;两条流的知识交换只发生在共享权重更新。这个边界是论文与“序列拼接”最关键的差异。源码中的动态打包也明确记录分支顺序为操作、导航,并保存两边实际 batch 大小,便于共享层处理后按行拆回各自的输出头。
flowchart LR
  A["Instruction + stream-specific RGB"] --> B{"Active stream"}
  B -->|nav| C["Nav action encoder"]
  B -->|manip| D["Manip action encoder"]
  C --> E["Shared Video DiT"]
  D --> E
  C --> F["Shared Action DiT"]
  D --> F
  E --> G["Future latent prediction"]
  F --> H["Nav head"]
  F --> I["Manip head"]
  H --> J["SE(2) increments, target box, projected MAP"]
  I --> K["Camera-frame dual-arm EEF, 2D tracks"]
  J --> L["Independent sampling and packed batch"]
  K --> L
因果动作注意力与前缀条件推理
同一个流内部,动作 token 只读取当前视觉 token、本流的可学习 token 以及不晚于自己的动作。设视觉 token 集合为 $\mathcal{V}_t$,可学习 token 为 $\mathcal{T}^s$,第 $j$ 个动作 token 的可见邻域为:
$$\mathcal{N}\left(a_{t,j}^s\right)=\mathcal{V}_t\cup\mathcal{T}^s\cup\left\{a_{t,k}^s:k\leq j\right\}.$$这条因果约束与异步执行直接对应。推理时,一个动作块的前 $P$ 个动作已经由上一轮提交并正在执行,它们是干净前缀;后续动作应当以这个前缀为条件继续生成。如果注意力允许前面的 noisy token 读取后面的 noisy token,训练与部署的信息流就会错位。论文的消融显示,去掉因果掩码后,长距离位置误差从 21.0 厘米升到 29.0 厘米,说明该约束在需要连续多块接近的场景尤其重要。
独立流采样
论文先按规则把完整移动操作轨迹切成导航窗口与操作窗口,再判断每个窗口中的受控部分是否实际运动。活跃窗口与空闲窗口拥有不同权重,导航专属数据和操作专属数据只进入各自的流。最终从来源 $d$ 的第 $i$ 个窗口采样的概率为:
$$q(d,i)=\frac{\alpha_d}{\sum_{d'}\alpha_{d'}}\frac{w_{d,i}}{\sum_j w_{d,j}}.$$第一项控制不同数据来源的总采样质量,第二项在同一来源内部调整窗口比例。这样,大规模 MAP-Data 不会仅凭 episode 数量淹没真实机器人数据,导航中机械臂静止的长段也不会统治操作流。同一 batch 会拒绝重复或时间上过于接近的窗口,同一 episode 中两个窗口的起始帧还必须至少相隔 $\delta$ 帧。最后按流分别组 batch,两边的 batch 大小无需相同,样本也不必来自同一条轨迹。
图像平面辅助监督
仅用三维动作监督时,模型可能学到数值上正确、但无法在图像中稳定定位目标的映射。UniWAM 在每个动作向量后追加辅助目标,并与主动作一起去噪:
$$a_{t,i}^s=\left[a_{t,i}^{s,\mathrm{act}};a_{t,i}^{s,\mathrm{aux}}\right].$$导航辅助目标是目标框与投影 MAP 点,前者负责“物体在哪里”,后者负责“应该停在哪里”。操作辅助目标是两条末端执行器的二维轨迹与可见性标志,它们把当前相机坐标系下的三维动作与其在图像中的落点绑定。辅助点并非人工随意标注:标定先把每条臂的本体状态映射到公共参考系,再到主相机;随后用针孔模型投影法兰与夹爪上实际可见的点。几何有效只说明点位于相机前方和图像范围内,外观可见性还要用 DINOv2 patch 特征判断,并用滞回阈值、短缺口填补和短游程删除减少闪烁。
这一设计的意义可以从消融中观察。移除导航辅助后,真实机器人平均停靠误差从 15.1 厘米、4.91 度退化到 17.6 厘米、6.84 度,移动操作成功率从 63.1% 降到 56.9%。移除操作辅助后,导航变化较小,但固定基座操作成功率从 44.3% 降到 39.3%。可见两个辅助目标基本作用于各自流,同时通过共享主干产生有限的跨任务收益。
流匹配训练目标
视频 latent、动作和辅助目标都使用 flow matching。给定干净目标 $\mathbf{x}$、高斯噪声 $\epsilon$ 和噪声等级 $\sigma$,构造 noisy 输入与速度目标:
$$\mathbf{x}_\sigma=(1-\sigma)\mathbf{x}+\sigma\epsilon,\qquad \mathbf{v}^*=\epsilon-\mathbf{x}.$$视频与动作各自采样噪声等级,动作及其辅助维度共享同一个 $\sigma$。当前观测保持干净,只监督未来视频 latent;前缀位置被替换为已经提交的干净动作,并从损失中排除。设 $g$ 为一个监督组,$\mathcal{F}_{b,t}^g$ 是有效特征集合,$\mathcal{I}_b^g$ 是非前缀且至少含一个有效特征的位置集合,则单样本损失为:
$$\ell_b^g=\frac{\omega(\sigma_b)}{\left|\mathcal{I}_b^g\right|}\sum_{t\in\mathcal{I}_b^g}\frac{1}{\left|\mathcal{F}_{b,t}^g\right|}\sum_{j\in\mathcal{F}_{b,t}^g}\left(\widehat{v}_{b,t,j}-v^*_{b,t,j}\right)^2.$$总目标把未来视频、两个流的动作与两个流的辅助项加权相加:
$$\mathcal{L}=\lambda_{\mathrm{vid}}\mathcal{L}_{\mathrm{vid}}+\sum_{s\in\{\mathrm{nav},\mathrm{manip}\}}\left(\lambda_{\mathrm{act}}^s\mathcal{L}_{\mathrm{act}}^s+\lambda_{\mathrm{aux}}^s\mathcal{L}_{\mathrm{aux}}^s\right).$$由于每个均值只在有效位置和有效特征上计算,导航样本不会为操作损失贡献零,也不会因为补齐维度而稀释梯度。这个细节与混合流采样共同保证“一个样本只监督一种行为”不是接口层的表面拆分,而是进入了优化目标。
实现、速度与工程约束
视频主干采用 Wan2.2-TI2V-5B,动作 DiT 有 30 层、隐藏维度 1024,视频 DiT 隐藏维度为 3072。33 帧观察窗口每隔四帧取一张,共九张 RGB 图像,编码成三个时序 VAE latent。相机画面排成 384 乘 320 的画布,主视图与腕部视图分区输入。训练使用 AdamW、初始学习率 $10^{-5}$ 与余弦衰减,视频 VAE 和文本编码器冻结。推理使用十步确定性 Euler 采样,不使用 classifier-free guidance。
论文还报告了明显的系统工程优化。标准 PyTorch 执行时,短动作序列会产生大量独立的 Python 到 GPU kernel 调度,CPU 提交开销可能让 GPU 等待。训练路径把混合流 transformer layer 编译成完整图;推理路径分别编译 VAE 编码、视觉 cache prefill 和带 cache 的动作去噪。当前观测只编码一次,各层视频 key/value 在十个 Euler 步之间复用。固定输入形状配合 reduce-overhead 编译与 CUDA graph 后,单张 H200 上的双流推理延迟从约 220 毫秒降到 60 毫秒以下,16 张 H200 的训练吞吐超过每秒 600 个样本。
代码与论文方法的对应
动态打包代码直接体现了“操作与导航是不同 batch row”这一核心。文件 training/real_robot/training/src/uniwam/models/wan22/mixed_stream_action_dit.py 第 107 至 166 行先按固定顺序收集活跃分支,再沿第 0 维拼接 token、时间和上下文,最后在 metadata 中保存 branch_sizes 与 branch_order:
branch_inputs = (
    ("manip", manip_action, manip_timestep, manip_context, manip_context_mask),
    ("nav", nav_action, nav_timestep, nav_context, nav_context_mask),
)
for branch, action, timestep, context, context_mask in branch_inputs:
    chunk = self._branch_pre_dit(
        branch=branch,
        action=action,
        timestep=timestep,
        context=context,
        context_mask=context_mask,
    )
    chunks.append(chunk)
    branch_sizes[branch] = int(action.shape[0])

return {
    "tokens": torch.cat([chunk["tokens"] for chunk in chunks], dim=0),
    "meta": {
        "branch_sizes": branch_sizes,
        "branch_order": ("manip", "nav"),
    },
}
相机坐标系相对位姿也在部署代码中有明确对应。文件 training/real_robot/deployment/common/uniwam_piper_common/camera_frame.py 第 90 至 105 行使用目标位置减锚点位置得到平移,用目标旋转乘锚点旋转的转置得到相对旋转,再把矩阵转回六维表示:
def fixed_reference_relative_pose(
    anchor_xyz: np.ndarray,
    anchor_rot6d: np.ndarray,
    target_xyz: np.ndarray,
    target_rot6d: np.ndarray,
) -> tuple[np.ndarray, np.ndarray]:
    anchor_position = np.asarray(anchor_xyz, dtype=np.float32)
    target_position = np.asarray(target_xyz, dtype=np.float32)
    anchor_rotation = rotation_6d_to_matrix(anchor_rot6d)
    target_rotation = rotation_6d_to_matrix(target_rot6d)
    relative_xyz = target_position - anchor_position
    relative_rotation = np.matmul(
        target_rotation, np.swapaxes(anchor_rotation, -1, -2)
    )
    return relative_xyz.astype(np.float32), matrix_to_rotation_6d(relative_rotation)
MAP-Bench 结果
所有 MAP-Bench 基线都在同样 35,454 条训练轨迹上训练 40,000 步,使用相同的前视 RGB 和各自原生动作接口。UniWAM-Base 不增加外部数据,因此比较的是架构差异;UniWAM-Scaled 保持训练预算,只混入 MAP-Data,因此额外衡量显式停靠监督。UniWAM-Scaled 在三个距离档都取得最低位置误差,总体为 9.85 厘米和 2.30 度,相对最强外部基线的 14.1 厘米与 4.11 度分别降低 30.1% 和 44.0%。
| 方法 | 短程位置 / 朝向 | 中程位置 / 朝向 | 长程位置 / 朝向 | 总体位置 / 朝向 |
|---|---|---|---|---|
| GR00T N1.7 | 9.48 cm / 5.66° | 10.8 cm / 5.42° | 22.0 cm / 7.46° | 14.1 cm / 6.18° |
| π0.5 | 7.98 cm / 3.26° | 9.85 cm / 3.51° | 50.8 cm / 5.55° | 22.9 cm / 4.11° |
| FastWAM | 9.24 cm / 3.44° | 11.0 cm / 3.95° | 31.1 cm / 6.66° | 17.1 cm / 4.68° |
| UniWAM-Base | 7.71 cm / 2.37° | 8.85 cm / 3.06° | 21.0 cm / 4.29° | 12.5 cm / 3.24° |
| UniWAM-Scaled | 7.48 cm / 1.82° | 7.86 cm / 2.08° | 14.2 cm / 3.01° | 9.85 cm / 2.30° |
最值得注意的是距离退化曲线。π0.5 从短程 7.98 厘米退化到长程 50.8 厘米,长度放大约 6.4 倍;UniWAM-Scaled 从 7.48 厘米到 14.2 厘米,只放大约 1.9 倍。原因不只是平均精度更高,而是 MAP 明确监督了终点,位置与朝向的小误差不会在长时间接近中无限累积。加入 MAP-Data 后,UniWAM 的长程位置误差从 21.0 降到 14.2 厘米,而短程只从 7.71 降到 7.48 厘米,说明这份数据的价值主要集中在远距离和全局空间定位。
在固定 7:3 数据混合比例与固定 40,000 步预算下,使用 25%、50%、100% 的 MAP-Data 目标时,总体位置误差依次为 11.4、10.3、9.85 厘米。随着数据增加,错误单调下降,但最后翻倍只带来 4.4% 的总体改善,呈现递减收益。相同 MAP-Data 与训练预算喂给 π0.5 时,总体位置和朝向只改善 5.7% 与 1.0%,长程仍为 47.8 厘米。这说明 MAP-Data 不是自然兼容任意动作接口的通用增益;只有当导航被当作独立流并获得图像平面目标时,大规模停靠监督才发挥最大作用。
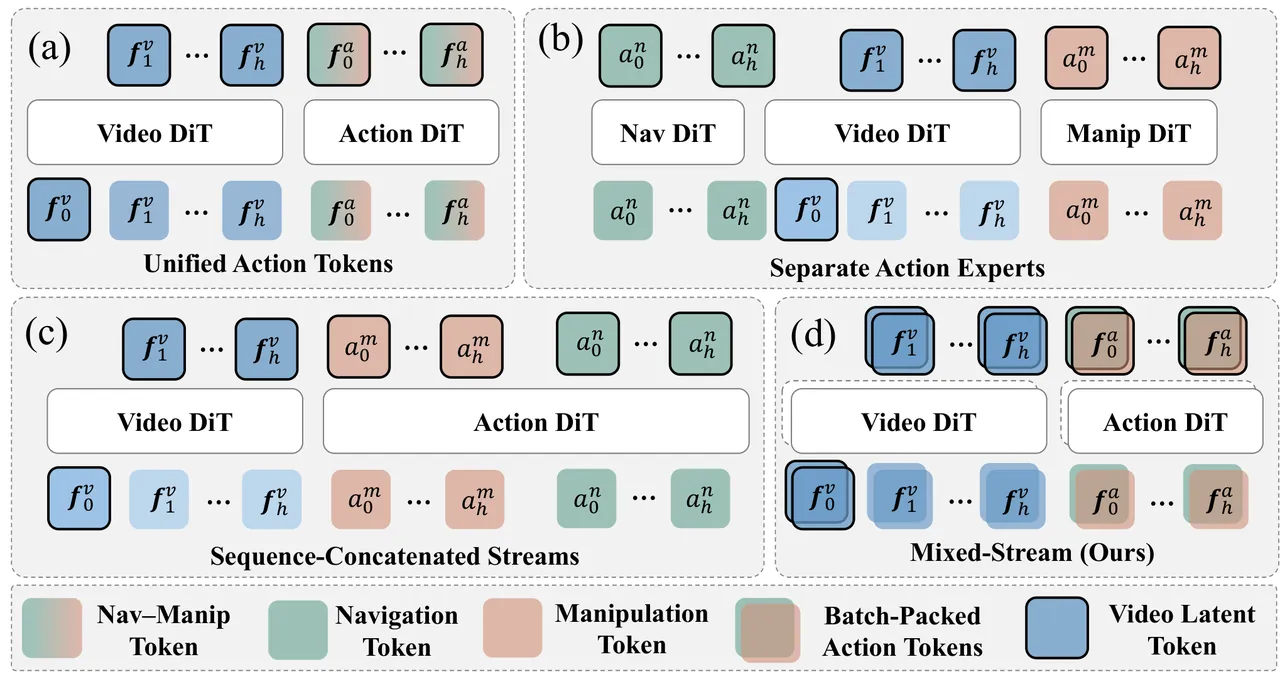
架构与采样消融
为了把架构收益与采样收益分开,论文在四个移动操作任务上比较五种组合。统一动作 token、分离动作专家和序列拼接都必须联合采样;混合流则同时测试联合采样与独立采样。所有变体使用同一视频初始化、数据、优化预算、评测协议和辅助目标。
| 方案 | 位置误差 | 朝向误差 | 移动操作成功率 |
|---|---|---|---|
| 统一动作 token | 22.0 cm | 7.49° | 46.9% |
| 分离动作专家 | 19.7 cm | 6.06° | 54.4% |
| 序列拼接 | 22.1 cm | 6.78° | 60.0% |
| 混合流,联合采样 | 18.6 cm | 5.87° | 60.0% |
| 混合流,独立采样 | 17.1 cm | 5.30° | 63.1% |
从统一 token 改为混合流联合采样,位置与朝向误差分别降低 15.5% 和 21.6%,成功率提高 13.1 个百分点。与参数更多的分离动作专家相比,共享一个动作 DiT 的混合流仍把位置误差降低 5.6%,成功率提高 5.6 个百分点。随后保持混合流架构不变,只在采样层启用独立流,位置误差进一步从 18.6 降到 17.1 厘米,成功率从 60.0% 提高到 63.1%。因此论文的最终收益来自两个可分离因素:把流放在不同 batch row,以及允许每条流按自身数据分布采样。
真实机器人结果
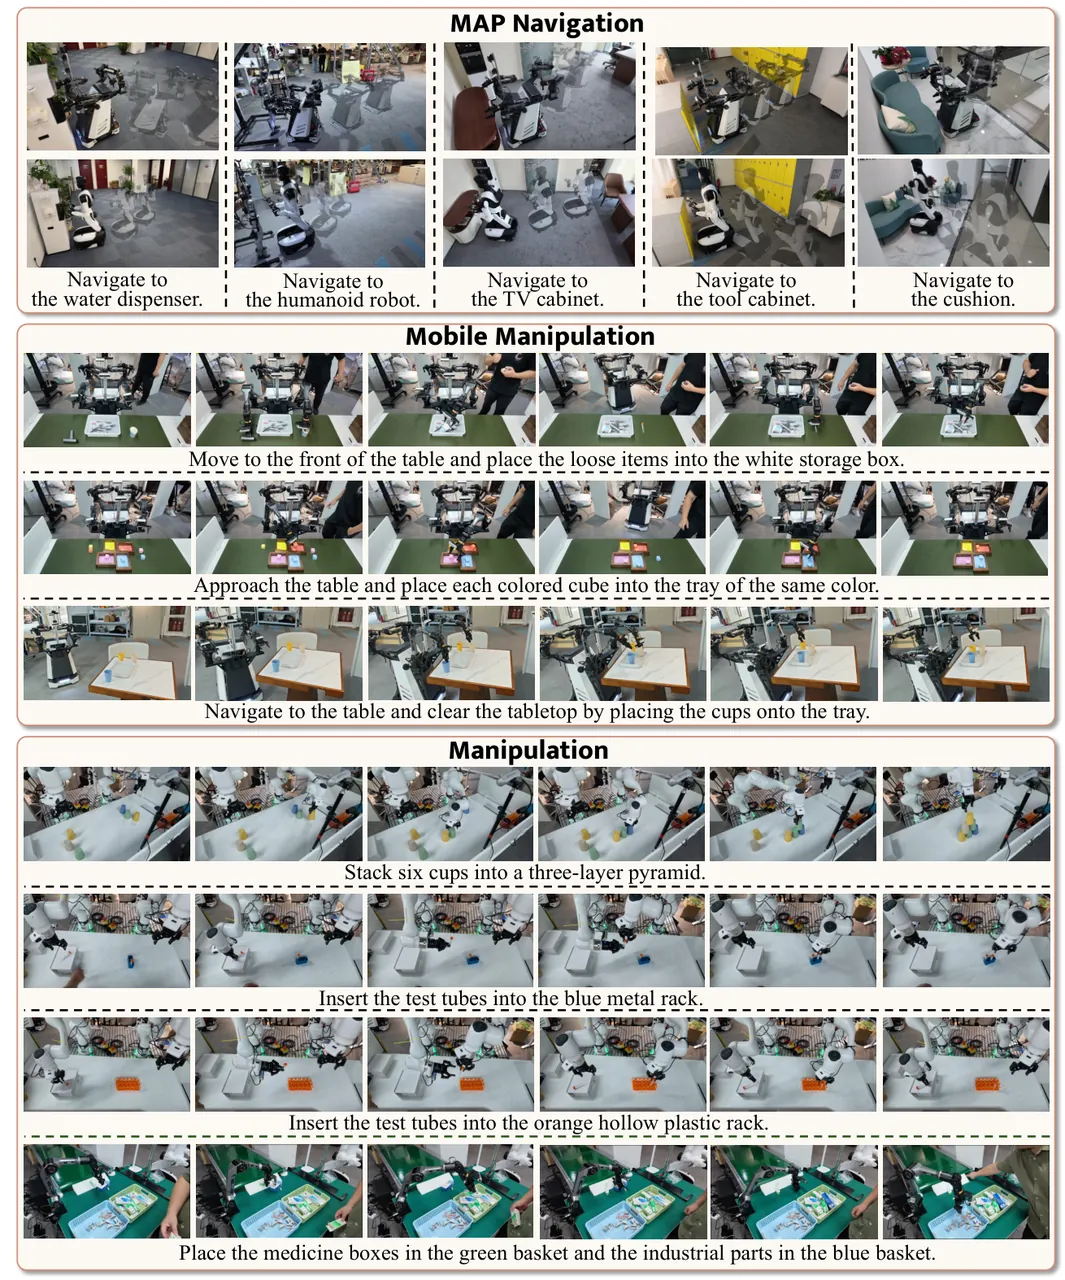
真实机器人实验覆盖四类平台、24 个任务,包括 13 个 MAP Navigation、4 个 Mobile Manipulation 和 7 个 Manipulation 任务。每个导航任务在两台移动底座上各收集 50 条示范,每个移动操作任务约 200 条,六杯堆叠等困难任务达到 400 条。启动测试时,机器人从距离参考 MAP 一至五米、朝向偏移正负 45 度的随机位置开始。所有方法使用相同相机、指令和成功判定。
| 方法 | 导航位置 / 朝向 | 移动操作位置 / 朝向 / 成功率 | 固定基座操作成功率 |
|---|---|---|---|
| π0.5 | 23.3 cm / 5.15° | 26.2 cm / 5.72° / 62.5% | 71.4% |
| GR00T N1.7 | 18.1 cm / 6.55° | 20.4 cm / 7.20° / 39.4% | 36.8% |
| UniWAM-Base | 15.1 cm / 4.91° | 17.1 cm / 5.30° / 63.1% | 44.3% |
| UniWAM-Scaled | 11.7 cm / 4.25° | 13.2 cm / 4.56° / 80.0% | 68.9% |
UniWAM-Scaled 的导航位置误差比最强基线低 35.4%,移动操作停靠位置误差低 35.3%,端到端成功率比 π0.5 高 17.5 个百分点。论文报告这两个成功率的 95% Wilson 区间不重叠,因此端到端优势比单纯的点估计更有说服力。更重要的对照是 UniWAM-Base:它只使用与基线相同的真实任务数据,却已经把导航误差降到 15.1 厘米与 4.91 度,说明架构本身不是靠额外数据才有效。
固定基座操作仍不是 UniWAM 最强势的场景。UniWAM-Scaled 平均成功率 68.9%,低于 π0.5 的 71.4%。它在三个分拣与放置任务上领先,但 π0.5 在六杯堆叠、两种试管插入和长时序咖啡制作上领先 2.5 至 12.5 个百分点。论文将差距归因于 π0.5 拥有大规模真实机器人预训练,而 UniWAM 从视频模型出发并依赖混合数据训练。这个结果不应被导航优势掩盖,它清楚表明“统一”不等于在所有技能上都超过专用预训练策略。
论文还测试了只使用 MAP-Data 训练的 UniWAM-Sim。它没有使用任何真实机器人、房间或目标实例,在真实平台平均停靠误差为 18.7 厘米与 6.34 度。这个位置误差优于使用真实示范训练的 π0.5,但朝向误差仍高于 π0.5 的 5.15 度。零样本结果说明合成导航监督具有可迁移性,同时也说明几何终点标签并不能完全替代真实控制中的动态误差与硬件差异。
局限性与风险
第一项局限由作者明确承认:相邻物体抓取存在多峰歧义。在颜色分拣任务中,粉色与蓝色方块紧挨着,示范中两种抓取都合理,确定性十步采样器可能落到两个模式之间,夹爪于是朝空隙闭合。作者认为在指令中显式指定目标物体可能缓解问题,但当前模型并没有可靠的目标消歧机制。对实际部署而言,这可能比平均成功率更危险,因为错误动作自信且难以从轨迹层面提前发现。
第二项作者自述问题是操作阶段仍有小幅非零底盘运动。导航流即便应该保持静止,也可能预测出接近零但不为零的动作块。论文对所有方法统一忽略位移小于 0.05 米且转角小于 0.05 弧度的底盘块,从而避免精密放置被轻微漂移破坏。这个处理解决了执行扰动,却没有证明模型真正学会了“操作期间绝对不动”;换一个阈值或平台后仍需重新验证。
第三项是评价范围的限制。MAP-Bench 主要测以基座停靠为中心的导航,24 个真实任务虽然跨四个平台,但仍由同一研究团队定义指令、初始配置与成功谓词。真实机器人成功率部分比较的置信区间有重叠,架构消融的结论也需要结合误差指标理解。MAP-Data 依赖三维场景质量、目标实例分割和视觉语言模型对操作面的判断,错误标注会在 150 万条轨迹规模上被放大,而不是被平均掉。
第四项是效率与数据门槛。低于 60 毫秒是经过专门编译、cache 与固定输入形状优化后的单张 H200 结果,不能直接等同于未优化实现、其他 GPU 或不同分辨率的通用延迟。UniWAM-Scaled 还额外使用 MAP-Data、402 个私有操作任务及更多训练算力,因此真实机器人端到端优势不能全部归因于 MAP 或混合流,论文通过 Base 版本和固定预算实验分别拆开了一部分因素,但完整系统的总成本仍高。
总结与展望
UniWAM 的主要贡献不是把两个任务名称写进一个模型,而是重新安排了共享与分离的边界。视频世界模型、动作 transformer 和参数更新共享,视觉输入、动作接口、输出头、采样分布与监督目标分离。导航不再被迫用零值补齐操作维度,操作也不必为底盘静止帧付出同样的训练预算。MAP 则把移动操作中的停靠终点从隐式偏好变成显式几何对象,并进一步生成目标框和图像上的终点坐标,使动作学习拥有可追溯的视觉锚点。
结果呈现出一个清晰分工:混合流架构在相同数据下改善停靠,MAP-Data 在固定预算下显著改善远程导航,两者的独立采样又在真实平台上提高端到端成功率。与此同时,固定基座灵巧操作仍落后于大规模真实预训练基线,相邻目标歧义与残余底盘运动也说明统一表示尚有边界。下一步最有价值的方向不是继续扩大平均指标,而是研究目标条件消歧、严格零运动约束、真实机器人规模预训练,以及跨团队、跨环境的独立复现。
金句:移动操作需要的统一,不是让导航和操作变成同一种动作,而是让它们在同一套世界知识上保留各自的观察、动作与采样边界。