PAPER DEEP DIVE
RoboFoundry:自我学习具身智能体的系统即策略演化
RoboFoundry 冻结基础模型,把上下文、技能与语义绑定组成可演化系统,在多个基准和真实机器人上持续修复失败并迁移经验。
一句话总结:RoboFoundry 不微调基础模型,而是把模型周围的上下文、技能和语义绑定组成一个可执行、可诊断、可验证、可累积修改的系统,并把这个系统本身当作持续演化的具身策略。
1. 研究背景:模型不是完整的具身智能体
具身智能体并不是把一段任务描述送进多模态模型、再让模型输出动作就能成立。真正运行在环境中的策略还包括观测组织、历史压缩、工具调用、技能复用、错误恢复、机器人接口和跨步骤状态维护。基础模型只是这个执行结构中的一个决策核心。论文的出发点正是这一区分:同一个模型在不同上下文组织、不同动作接口和不同记忆机制下,会表现出显著不同的任务完成率,因此可执行策略应当被视为“模型加外围系统”,而不是单独的模型函数。
较早的具身系统多把大模型当作高层规划器,由人工定义允许动作,再交给低层控制器执行。代码即策略进一步扩大了模型的作用,使模型可以组合感知、导航和操作原语。但当任务变长、机器人本体变化或环境出现分布偏移时,单次生成的程序很难覆盖所有情况。失败可能来自看不见目标、理解错空间关系、计划顺序错误、没有保存中间状态、检索了过期记忆,或把语义目标绑定到了错误的执行接口。把所有失败都归因于“模型不够强”,既无法定位问题,也无法形成稳定的修复。
已有工作通常分别优化记忆、上下文、技能库或动作接口。这样的局部优化能改善某一环节,却缺少一个统一视角来处理失败之间的耦合。例如,机械臂没有抓住物体,可能不是抓取技能参数错误,而是先前保存的对象位置已经失效;导航成功与否也可能取决于任务分解是否把“饮水机”当作语义目标,再把该目标绑定到具体机器人的移动动作。RoboFoundry 因此不是再增加一个模块,而是主张把整个支撑系统当作策略对象,将每次执行痕迹转化为有证据的系统修改。
论文还强调,交互本身不等于自我改进。一个智能体可以在多次试验中重复同一种错误,也可以在偶然成功后把错误原因写进记忆。要让经验成为能力,至少需要三个条件:失败能够归因到具体能力;修改能够被后续执行验证;反复有效的修改能够通过其他任务的检验并持久保留。RoboFoundry 的“执行—反思—修复—晋升”闭环就是围绕这三个条件设计的。
这套思路适合长期运行的机器人,而不是一次性的演示程序。现实部署中,系统会在不同房间、不同物体、不同机器人和不同任务阶段持续积累经验。若每次失败都依赖工程师改代码,系统无法自治;若模型直接改写自身权重,又会带来灾难性遗忘和难以审计的问题。RoboFoundry 选择介于两者之间的路线:基础模型保持冻结,修改范围限定在可读、可回滚的文件与技能系统中。
2. 核心问题形式化:冻结模型,演化系统
论文把基础模型记为 $M$,把围绕模型的系统记为 $H$。任务实例 $x$ 在当前一般系统 $H_g$ 和任务级系统 $H_t$ 下执行后,会产生一条包含工具调用、观测、机器人状态、动作、结果与反馈的轨迹:
$$\tau\sim\mathcal{T}(H_g,H_t,x)$$
这条公式的关键不在采样记号,而在依赖关系。轨迹由一般系统、任务系统和任务实例共同决定,因此同一条失败轨迹既可以指向任务级上下文错误,也可以暴露一般技能或绑定规则的问题。系统优化的对象不是 $M$,而是 $H_t$ 与 $H_g$。任务级系统先在当前任务上寻找更优版本:
$$H_t^*=\arg\max_{H_t\in S_t}\mathbb{E}_{\tau}\left[r_x(\Delta H_t,\tau)\right]$$
其中 $S_t$ 是任务级可编辑空间,$\Delta H_t$ 是一次候选修改,$r_x$ 表示修改后的轨迹在任务 $x$ 上的评分。这个目标只回答“当前任务有没有修好”。若修改只对单个任务有效,它可能只是绕过局部障碍,不足以成为一般能力。于是论文又定义了一般系统优化:
$$H_g^*=\arg\max_{H_g\in S_g}\mathbb{E}_{x\sim\mathcal{X}_{\mathcal{A}},\,\tau\sim\mathcal{T}(H_g,H_t^*(x),x)}\left[r_x(\Delta H_g,\tau)\right]$$
这里 $\mathcal{X}_{\mathcal{A}}$ 是与某类能力缺口相关的任务分布。一般修改必须在任务级最优系统已经就位的条件下,仍然对其他任务产生收益。这个两层目标把“修复一个案例”和“获得一种能力”分开,避免把所有成功都误当成可迁移知识。
3. 内外双循环:从轨迹到持久能力
内循环负责执行。模型看到任务、观测和选中的上下文,调用技能接口并产生动作;执行结果、状态变化和反馈被写入轨迹。外循环负责改进。它先检查失败落在哪个能力环节,再提出任务级修改,并让修改在后续试验中接受验证。验证成功的修改可以先保留在任务级系统中;只有反复出现、且能解释其他任务同类失败的规则,才被抽象为一般修改。
论文把失败诊断归到感知、推理、规划、保存、检索和利用六类能力。这个划分不是任意日志标签:感知错误需要改变观察解析;推理错误需要纠正关系判断;规划错误需要调整子任务顺序;保存错误意味着关键证据没有进入持久记忆;检索错误意味着记录存在但没有在正确时机被取回;利用错误则表示上下文已经出现,却没有被模型用于决策。诊断粒度决定了后续修改能否被检验。
flowchart TB
    A[Task x] --> B[Inner loop
execute H_g and H_t]
    B --> C[Trace
observations actions states outcomes]
    C --> D[Diagnose capability gap
perceive reason plan save retrieve utilize]
    D --> E[Candidate task edit]
    E --> F{Held-in repair
passes?}
    F -->|No| G[Discard candidate]
    F -->|Yes| H[Commit H_t edit]
    H --> I[Abstract reusable rule]
    I --> J{Held-out transfer
score >= 0?}
    J -->|No| K[Keep capability local]
    J -->|Yes| L[Promote to H_g]
    L --> B
    K --> B
该流程与“让模型自由反思”有本质差别。自由反思只生成一段解释,RoboFoundry 则要求修改落到文件、技能或绑定规则上,再通过新一轮执行判断修改是否真的改变了结果。失败候选可以明确丢弃,而不是不断堆积在提示词中。成功候选也不是立即全局化,而要经过留出轨迹检验。
图 2 展示完整结构。左侧内循环把一般系统和任务系统组合成当前策略,上下文表面负责活动记忆与文件系统,技能表面负责原子技能、组合与恢复,语义绑定和执行绑定把跨本体决策落到具体机器人。右侧外循环把能力失败转化为候选修改,并分别进行任务内修复和跨任务保留检查。
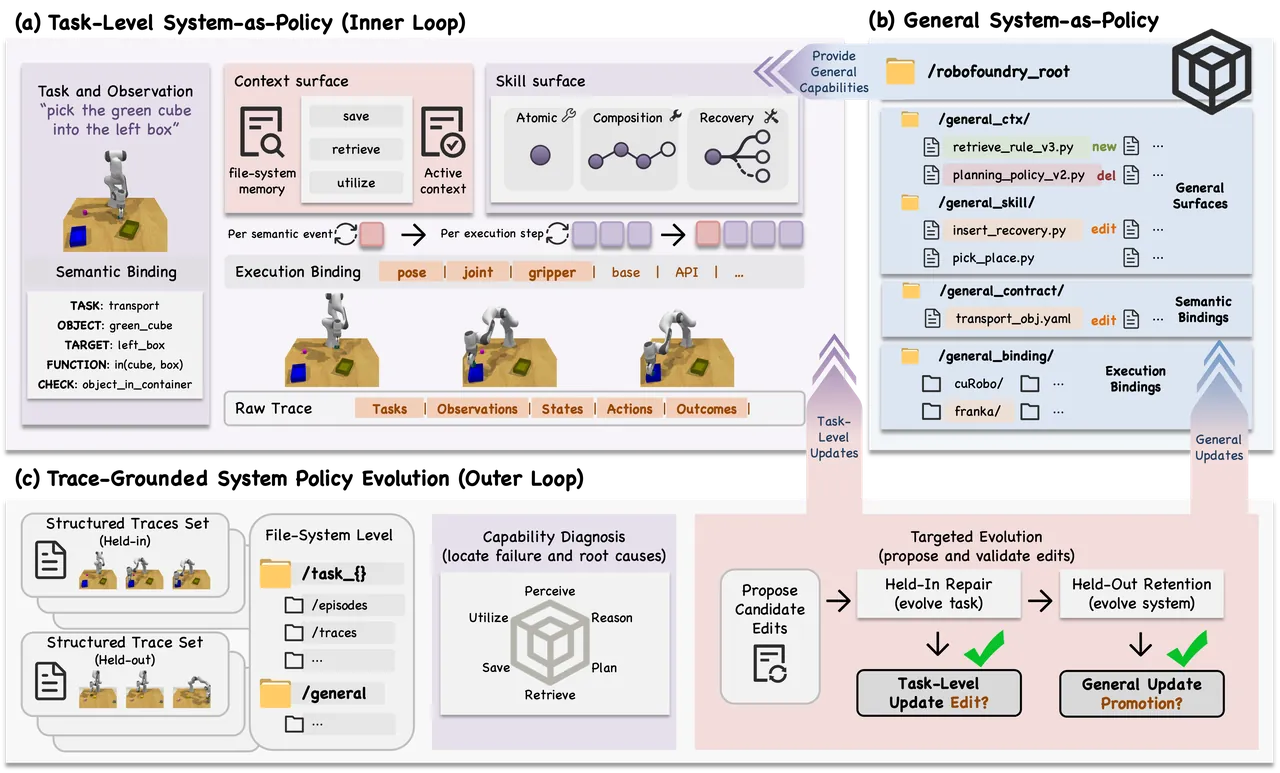
图2:RoboFoundry 的内循环执行、双层系统、上下文与技能表面,以及外循环诊断和晋升流程。
4. 上下文表面:保存不是目的,正确利用才是
上下文系统由活动上下文和持久文件记忆组成。论文没有在每个时间步无条件重写记忆,而是让系统在任务进展、状态变化或异常发生时决定是否保存。上下文操作空间被明确限定为保存、检索和利用:
$$S_t^{\mathrm{ctx}}=\{\mathrm{SAVE},\mathrm{RETRIEVE},\mathrm{UTILIZE}\}$$
保存操作选择对后续任务有意义的证据,例如已经完成的子任务、对象的空间关系、遮挡前后的状态或失败条件。检索操作在合适的阶段取回这些证据。利用操作把检索结果转成当前决策所需的活动上下文:
$$c_t=\mathrm{Utilize}(\mathrm{Retrieve}(x,z_t,\mathcal{M}_t),z_t)$$
其中 $z_t$ 是当前观测与机器人状态,$\mathcal{M}_t$ 是持久记忆,$c_t$ 是最终送入模型的活动上下文。模型据此产生语义决策:
$$p_t=M(x,z_t,c_t;H_g,H_t^s)$$
这条链把记忆问题拆成两个可诊断环节。若证据从未写入 $\mathcal{M}_t$,问题在保存策略;若证据存在但检索不到,问题在检索条件;若 $c_t$ 已经包含证据而决策仍然错误,问题在利用或推理。这样的分解使同一条“忘记任务进度”的失败不再只有模糊解释。
论文中的化学实验是这一点最清楚的例子。六个子任务依次包括放置漏斗、放置器皿、天平归零、加入粉末、归还勺子与倾倒。系统在执行时写入“漏斗已就绪”“天平已归零”等状态,最终倾倒阶段再检索早期状态。若只看最后一帧,机器人无法知道漏斗是否已经插入;文件记忆把跨长时间跨度的前置条件带到决策点。
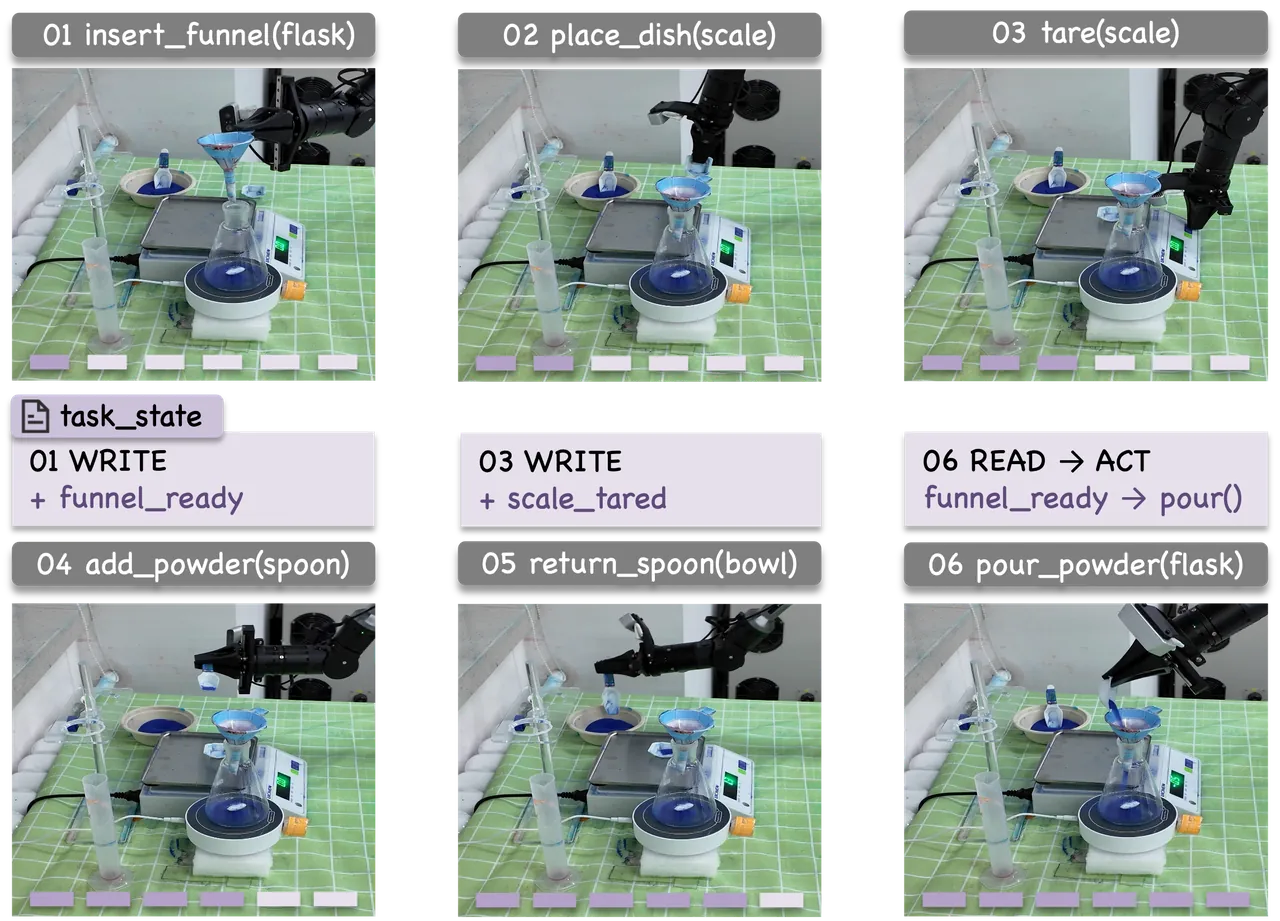
图6:六个相互依赖的化学操作子任务通过任务状态记录连接,最后倾倒阶段检索早期漏斗就绪状态。
5. 技能表面:从原子动作到带失败条件的恢复
技能系统不是简单扩大工具列表。论文把它组织成三层:原子技能、可复用组合和失败条件触发的恢复。原子技能提供抓取、移动、放置、打开等基本执行;组合技能把多个原子步骤封装成有语义边界的流程;恢复技能只在特定失败条件下介入,例如抓取没有产生预期位移、目标被遮挡或阶段状态未满足。
分层结构减少了每次决策的自由度。面对长时程任务,模型不必重新生成整段底层代码,而是调用经过验证的组合技能,并在失败时选择对应恢复。与此同时,组合技能仍保留语义接口,允许系统根据物体、目标和任务阶段重新绑定参数。这样既避免脚本完全写死,也避免每一步都从自然语言重新推导。
论文的 LIBERO-PRO 案例显示,系统会把重复出现的长动作序列抽象成复合函数,并修正任务生成模板、坐标语义和启动逻辑。奶油奶酪案例中,一次切向推动没有成功,系统检查平面位移后重新抓取,再执行放置。这个恢复过程是试验局部的,只有共享的复合技能进入持久系统。论文特意区分“解决当前失败”和“把恢复经验全局化”,这与双层优化目标一致。
技能演化也可能产生错误抽象。另一个碗相关案例说明,即使执行接口已经抽象,空间定位仍然可能失败;减少代码长度不能替代正确的物体与支撑面关系。因此,论文没有把技能库扩张等同于能力提升,而是依赖轨迹评分判断修改是否真正修复问题。
6. 共享语义接口与机器人执行绑定
跨机器人迁移的难点在于,任务语义和具体执行并不处在同一个抽象层。人类说“找到饮用水”,语义目标是识别饮水机并规划接近路径;轮式机器人、四足机器人或人形机器人需要不同的移动控制与感知约束。若让模型直接输出每个本体的底层动作,演化出的经验很难迁移。RoboFoundry 因此将同一任务系统投影成两个绑定结果:
$$H_t^s(M)=\mathrm{BIND}_s(H_t(M)),\qquad H_t^e(M)=\mathrm{BIND}_e(H_t(M))$$
语义绑定 $H_t^s$ 保留任务分解、对象关系和可迁移决策;执行绑定 $H_t^e$ 把语义动作映射到某台机器人的运动学、工具和动作 API。执行之后,机器人状态与反馈再被送回语义层:
$$(z_{t+1},f_t)=\mathrm{Execute}(H_t^e(p_t))$$
这种拆分有两个直接作用。第一,诊断时可以区分“任务理解错了”和“执行接口没做对”。第二,演化得到的技能规则可以保留语义部分,只替换执行绑定。论文在 AgileX 机械臂、毛巾折叠和 Unitree G1 导航中展示的迁移,依赖的正是这一共享语义接口,而不是把某台机器人的动作序列逐字复制到另一台机器人。
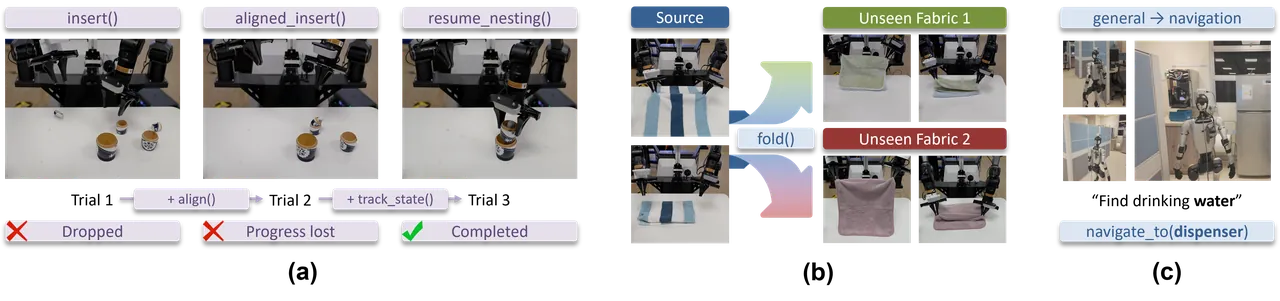
图5:真实环境中的演化与迁移,包括嵌套娃娃、未见颜色毛巾折叠和 Unitree G1 语义导航。
毛巾折叠的结果尤其能说明迁移边界。系统只在蓝色毛巾上演化,随后直接处理绿色和粉色毛巾。三者在颜色、几何和材料上不同,但共享“展开、对齐、折叠”的语义技能结构。RoboFoundry 在未继续适应的情况下达到八成以上成功率,而单独 $\pi_{0.5}$ 低于两成。这个对比支持语义技能与执行绑定分离的价值,但仍属于有限物体族内的迁移,不能等同于任意柔性物体泛化。
7. 任务级修复如何被接受
外循环对一条失败轨迹先提出候选修改 $\Delta H_t$,然后在任务内执行修复验证。候选只有在目标任务的后续试验中提高评分,才被提交为 $\Delta H_t^*$。论文将提交写为对当前系统的编辑操作:
$$H_t^*\leftarrow H_t\oplus\Delta H_t^*$$
这里的 $\oplus$ 表示把可执行修改应用到文件或技能系统,而不是把一段反思文本追加到提示词。修改内容可以是任务描述、上下文保存规则、检索条件、技能函数、恢复分支或执行参数。每次修改都保留证据和结果,后续可以追踪是哪个失败导致了哪次编辑。
被提交的任务级修改还会经过抽象:$\Delta H_g\leftarrow\mathrm{Abstract}(\Delta H_t^*,\tau_x;H_g)$。抽象不是简单删除任务名,而是从修复轨迹中提取与能力缺口相关的规则。例如“抓取后若物体没有进入开口,保持夹爪闭合直到就位”可以脱离红星插柱这一具体任务,成为抓取恢复规则;“当前帧是遮挡状态的权威来源,历史画面只用于提醒”可以成为视觉记忆冲突规则。
论文在 EB-Habitat 空间子集展示了一个完整演化轨迹。初始留入成功率为 21.4%,三次提交修改后升至 50.0%;两个候选被丢弃,不改变系统;最后一个候选达到 78.0%,通过留出检查后被标记为可晋升。这里的价值不只是终点更高,还在于失败候选没有污染持久系统。系统能够拒绝修改,是自治演化可靠性的组成部分。
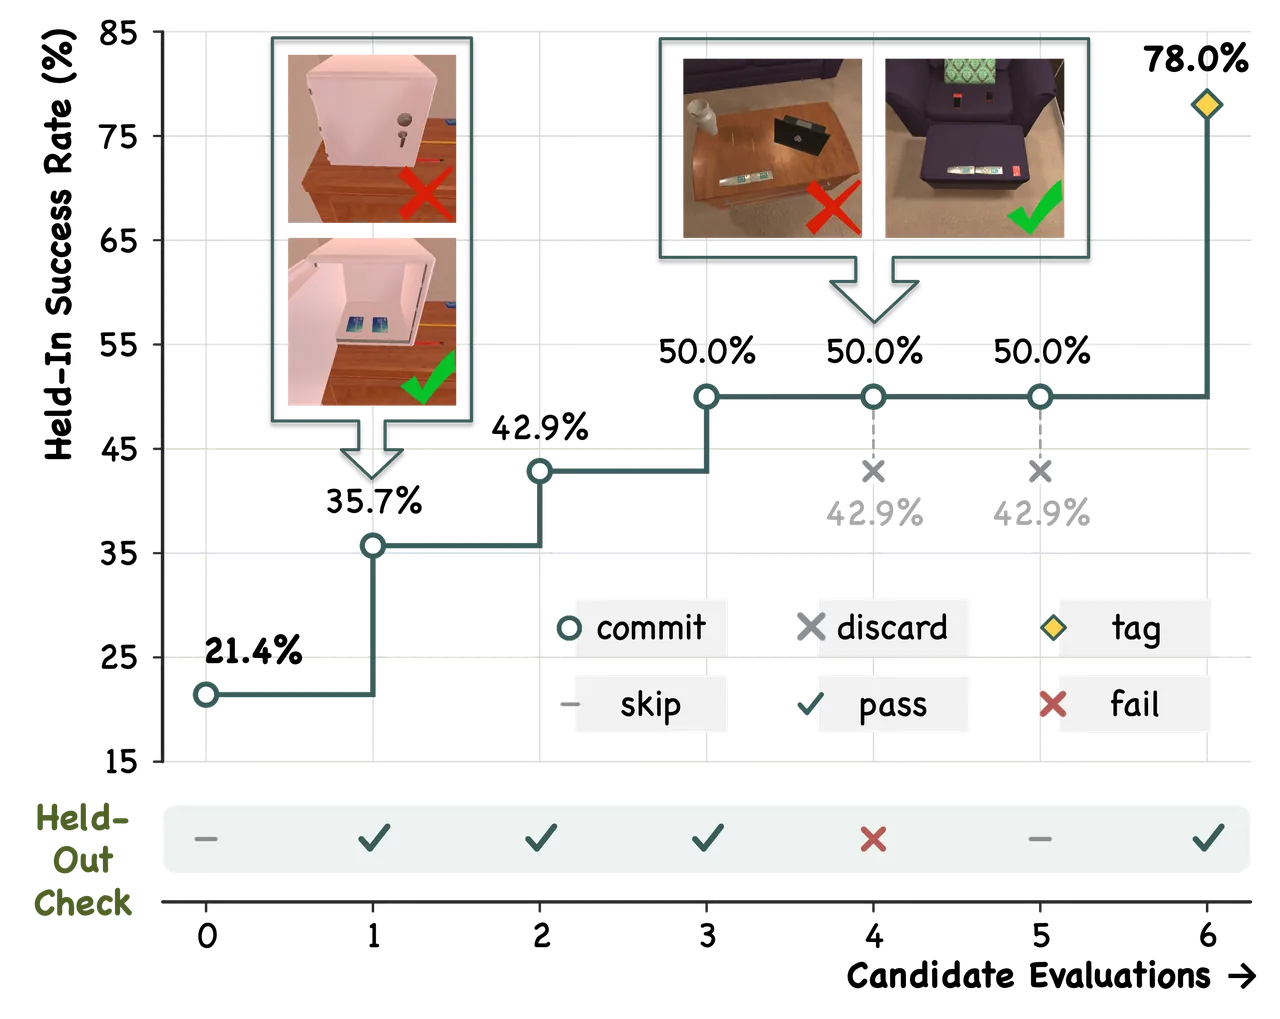
图3:EB-Habitat 空间子集上的演化轨迹,六次候选评估中三次提交、两次丢弃、一次晋升。
8. 一般系统晋升:验证的是同类能力,不是记忆相似度
从任务级修改抽象出一般规则后,系统需要判断它能否解决其他任务的同类能力缺口。论文从历史轨迹中选出同一能力类别、但任务实例不同的成功记录,构成留出轨迹集合:
$$\mathcal{T}_a^{\mathrm{out}}(x)=\{\tau_i\in\mathcal{T}:a_i=a,\ x_i\neq x\}$$
对每条留出轨迹,系统只保留修复前的任务、观测、状态和历史,再让候选一般规则提出任务级修改 $\Delta H_{t,i}^{\prime}$。它将候选修改与原本成功的修改 $\Delta H_{t,i}^{*}$ 比较,计算能力条件化的迁移增益:
$$\Delta_{\mathrm{cap}}(\Delta H_g)=\frac{1}{|\mathcal{T}_a^{\mathrm{out}}(x)|}\sum_{\tau_i\in\mathcal{T}_a^{\mathrm{out}}(x)}\left[r_x(\Delta H_{t,i}^{\prime},\tau_i)-r_x(\Delta H_{t,i}^{*},\tau_i)\right]$$
只有当 $\Delta_{\mathrm{cap}}(\Delta H_g^*)\geq 0$ 时,候选才被晋升:
$$H_g^*\leftarrow H_g\oplus\Delta H_g^*$$
这条门禁比“新规则看起来更通用”严格。它要求一般规则在别的任务轨迹上至少不降低修复质量。阈值取零也意味着晋升条件偏保守:能通过,说明规则没有破坏既有同类修复;但不保证它在所有分布外任务上都有正收益。论文后续的局限也与此有关,留出轨迹仍来自已有任务集合。
图 4 展示了留入数据规模与最终性能的关系。每个套件固定 50 个留出任务;仅用四分之一留入任务,EB-ALFRED 已达到 78.0%,EB-Habitat 达到 66.0%;使用四分之三留入数据后,EB-Habitat 达到 74.0%。这说明演化主要从少量高信息失败中提取规则,而不是依赖大规模重训练。
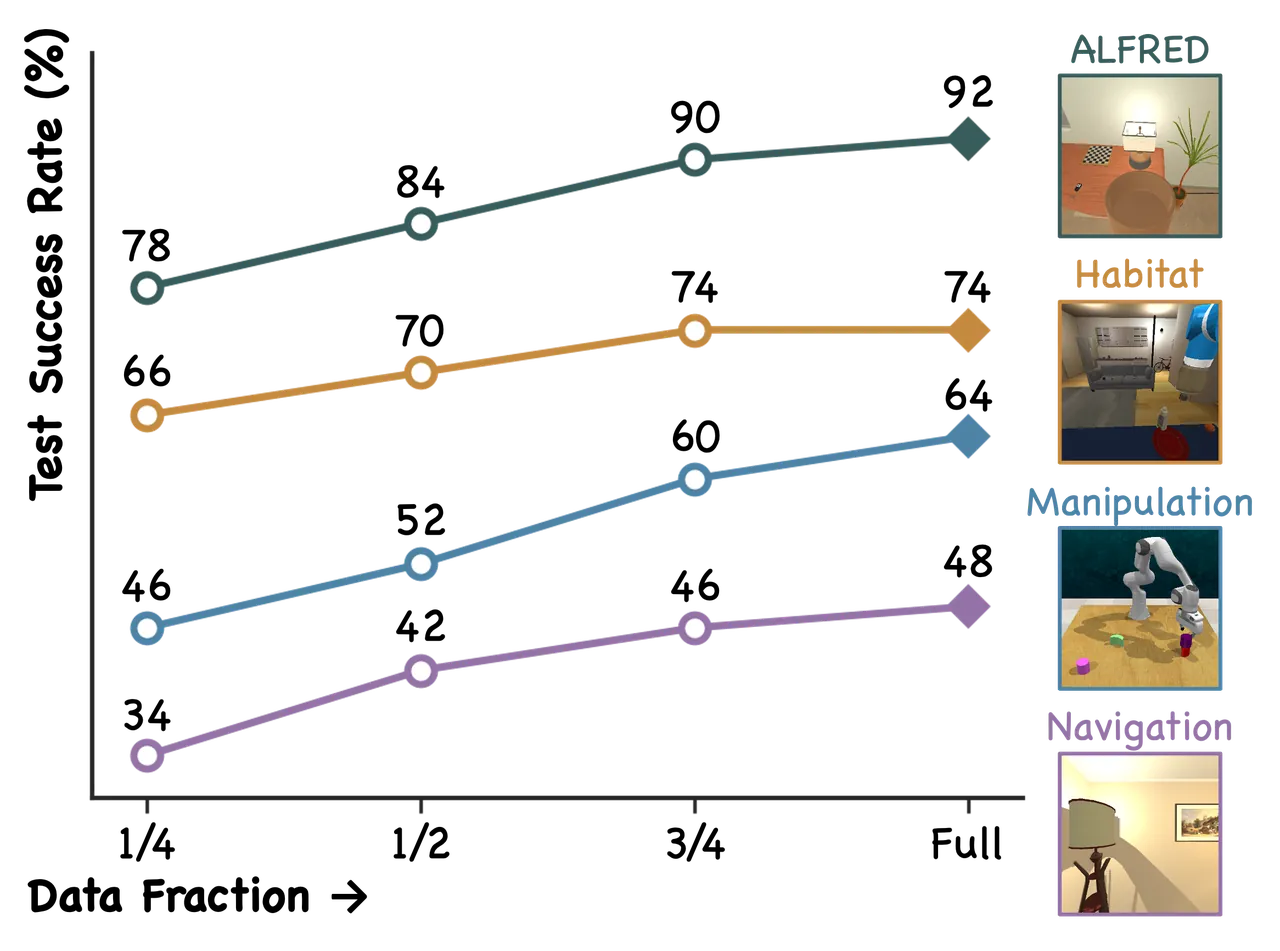
图4:EmbodiedBench 上留入数据规模与留出性能的关系,四分之一数据已覆盖大部分收益。
9. 文件系统:让演化结果可检查、可回滚
RoboFoundry 把系统状态放进文件系统,而不是隐藏在不可读的向量记忆或模型参数中。执行系统包含当前可调用技能、任务模板和绑定逻辑;证据目录保存轨迹、失败摘要和编辑记录;试验局部目录保存尚未晋升的恢复状态。模型可以读取、搜索、增加、修改和删除文件,因此修改本身可以被审计。
文件组织带来两个工程优势。第一,任务级修改和一般系统修改有明确边界,试验局部恢复不会自动污染全局能力。第二,系统可以把修改前后版本与对应轨迹一起保存,便于比较和回滚。论文的 LIBERO-PRO 案例中,任务生成模板、对象中心坐标语义、抓取与放置辅助函数和启动逻辑都曾作为持久修改对象;奶油奶酪的特定恢复过程则保留在局部执行上下文中。
这并不意味着文件越多越好。持久修改会增加系统复杂度,错误规则也可能长期存在。论文设计了丢弃、任务级提交和一般晋升三个层级,但如果验证任务与真实部署分布差异过大,文件仍可能积累过拟合规则。工程上还需要版本控制、依赖检查、冲突处理和定期回归,这些不属于当前论文实验的主要评估范围。
10. 实验设置与主要结果
论文在 EmbodiedBench、RoboMemArena、LIBERO-PRO 和真实机器人上评估。EmbodiedBench 覆盖 ALFRED、Habitat、Navigation 与 Manipulation,主要考察决策能力;RoboMemArena 考察转移、遮挡、计数和序列等长时程记忆;LIBERO-PRO 通过物体、目标和空间扰动考察执行鲁棒性;真实实验包括 AgileX、Unitree G1 和化学操作。
EmbodiedBench 的关键结论是,系统演化对不同基础模型都有效。GPT-5.5 的平均成功率从 56.9% 提升到 72.7%,增加 15.8 个百分点。论文摘要中的 27.8% 是相对提升,不能与 15.8 个百分点混写。GPT-6 Astra 从 71.9% 提升到 78.0%,Qwen3.7-Plus 从 60.0% 提升到 70.3%。后者已经接近 GPT-5.5 的 72.7%,说明外围系统可以缩小模型能力差距。
| 方法 | 平均成功率 | 相对基础模型的百分点增益 | 含义 |
|---|---|---|---|
| 基础 GPT-5.5 | 56.9% | — | 仅使用基础模型与普通代理结构 |
| RoboFoundry + GPT-5.5 | 72.7% | +15.8 pp | 完整双层演化 |
| RoboFoundry-Lite + GPT-5.5 | 65.5% | +8.6 pp | 简化系统仍能获得明显收益 |
| RoboFoundry + Qwen3.7-Plus | 70.3% | +10.4 pp | 接近 GPT-5.5 完整系统结果 |
| RoboFoundry + GPT-6 Astra | 78.0% | +6.1 pp | 更强基础模型仍有增益,但绝对空间收窄 |
RoboMemArena 的整体结果更能说明上下文系统的独立贡献。RoboFoundry 的完整任务成功率与条件成功率分别为 53.5% 和 72.8%,高于 PrediMem 的 38.5% 和 55.2%、MemER 的 27.3% 和 49.1%、HiF-VLA 的 16.9% 和 39.8%。完整任务成功要求所有阶段完成,因此它与只看阶段成功率的指标一起使用,可以区分“中途有改善”与“最终完成任务”。
| 方法 | TSR(完整任务成功率) | CSR(条件成功率) |
|---|---|---|
| RoboFoundry | 53.5% | 72.8% |
| PrediMem | 38.5% | 55.2% |
| MemER | 27.3% | 49.1% |
| HiF-VLA | 16.9% | 39.8% |
| $\pi_{0.5}$ | 21.5% | 38.7% |
| MemoryVLA | 15.0% | 35.3% |
上下文演化并非只对完整系统有效。单独 $\pi_{0.5}$ 在加入上下文演化后,从 26.8%/45.6% 提升到 56.2%/72.2%;PrediMem 从 42.0%/60.6% 提升到 57.7%/75.9%。由于这里改变的是上下文保存与利用方式,而不是基础动作模型,结果支持“系统修改可以独立于权重更新发挥作用”。
LIBERO-PRO 考察分布扰动。在没有特权物体位姿时,RoboFoundry 在 Object、Goal、Spatial 三类扰动上的平均完整任务成功率分别为 96.0%、88.0% 和 92.0%,条件成功率为 98.0%、86.0% 和 91.5%。CaP-Agent0 的对应结果明显更低,完整任务成功率仅为 21.8%、25.6% 和 11.8%。提供特权位姿后,RoboFoundry 进一步达到 99.0%/100.0%、96.0%/100.0% 和 98.0%/99.2%,这也直接暴露了感知瓶颈。
| LIBERO-PRO 扰动 | RoboFoundry TSR / CSR | CaP-Agent0 TSR / CSR | RoboFoundry 有特权位姿 TSR / CSR |
|---|---|---|---|
| Object | 96.0 / 98.0 | 21.8 / 18.2 | 99.0 / 100.0 |
| Goal | 88.0 / 86.0 | 25.6 / 16.8 | 96.0 / 100.0 |
| Spatial | 92.0 / 91.5 | 11.8 / 14.0 | 98.0 / 99.2 |
11. 案例分析:哪些修改真正改变了行为
EmbodiedBench 的清洁剂任务展示了计划抽象的作用。初始系统生成很长的动作序列,最多达到二十步;演化后把重复操作压缩成一到两个高层步骤。这里的收益不是模型生成了更漂亮的计划,而是系统把可复用子流程封装起来,减少了每一步重新推理的机会。
红星插柱案例展示了失败条件恢复。原系统执行十五个有效动作仍然失败,因为它没有在抓取后保持夹爪闭合,物体在进入开口前滑脱。修改后的技能要求抓取后持续闭合,直到物体进入孔洞;第六个动作就完成任务。该规则随后被抽象为可迁移的抓取恢复,而不是写成“红星任务专用提示”。
报纸任务展示了语义目标与物理支撑面的区分。模型最初把“左侧笔记本电脑”错误绑定到附近表面,系统修复后明确区分要移动的语义对象和它所在的沙发支撑面。导航任务则把目标距离从 3.9 米降到 0.9 米,修复的是可达地面推理,而不是底层路径控制参数。
RoboMemArena 的奶油与奶油奶酪转移任务中,系统显式记录下一未完成阶段,完整成功率从 40% 提升到 70%。遮挡任务中,系统学会把当前帧当作权威,把历史帧当作提醒,并区分“发送过尝试命令”和“动作实际成功”;阶段完成率从 50% 提升到 75%。计数任务使用阶段条件化上下文,把完整任务成功率从 60% 提升到 80%。序列任务只改善了中间阶段,没有解决完整任务,论文如实保留了这个失败边界。
12. 局限与风险
作者明确承认感知仍是主要瓶颈。LIBERO-PRO 在提供特权物体位姿后,三个扰动类别的结果都进一步提升,说明系统演化无法完全弥补视觉定位和状态估计的不准确。对真实机器人而言,传感器噪声、遮挡、标定漂移和接触动力学比仿真更复杂,语义层修复不能替代可靠感知。
第二个限制来自冻结基础模型。RoboFoundry 可以改善上下文、技能和接口,却不能改变模型本身的视觉常识、语言理解和动作先验。若失败需要新的底层操作能力或大规模领域知识,仅修改外围系统可能触及性能上限。论文中不同基础模型仍有明显差距,也说明系统优化不是模型能力的完全替代品。
第三,自生成修复和自验证可能产生验证器偏差。系统用执行评分与留出轨迹选择修改,但评分器、任务成功判定和轨迹采样都可能偏向容易观测的指标。若一个错误规则恰好提高短期成功率,却损害长期鲁棒性,零阈值晋升条件未必能识别。留出任务仍与训练任务共享基准和领域假设,不能证明开放世界泛化。
第四,真实机器人评估规模有限。每类任务约十次试验,场景和物体数量较少,结果适合展示机制可行性,不足以估计生产环境中的长尾失败率。持久文件修改还可能积累复杂度、冲突或错误捷径,需要版本控制、回滚、依赖审计和定期回归。当前公开仓库尚未包含核心基准实现,独立复现也受到限制。
13. 结论与展望
RoboFoundry 的主要贡献不是提出一个新基础模型,而是把具身智能体的执行支撑系统提升为可优化对象。它用内外双循环把轨迹变成经过验证的任务修改,再通过能力条件化留出检验把局部修复晋升为一般系统。上下文、技能、语义绑定和执行绑定共同组成策略,使冻结模型也能通过文件级修改获得持续改进。
这项工作给机器人系统设计一个明确方向:与其把所有经验塞进提示词或重新训练权重,不如让记忆、技能和接口拥有清晰边界、可验证修改和可回滚版本。下一步真正需要解决的是感知可靠性、验证器校准、开放世界留出集、长期文件治理和跨本体安全迁移。只有这些工程条件与闭环算法一起成熟,自我学习具身智能体才可能从基准走向长期部署。
金句:真正可自我改进的机器人策略,不是会写更多反思文字的模型,而是能把失败变成可验证、可回滚、可迁移的系统修改。