PAPER DEEP DIVE
DeFM:从深度图像学习机器人基础表示
DeFM 是一个完全用深度图像训练的机器人自监督基础模型。它采用 DINO 式自蒸馏,从 60.4M 张深度图像中学习几何与语义表征,并通过多尺度输入归一化保持度量感知。作者还把模型蒸馏到适合机器人机载计算的紧凑网络中。该模型在基于深度的分类、分割、导航、运动控制和操作任务上优于对比表征,并能从仿真泛化到真实环境。
作者:Manthan Patel、Jonas Frey、Mayank Mittal、Fan Yang、Alexander Hansson、Amir Bar、Cesar Cadena、Marco Hutter。工作来自苏黎世联邦理工学院机器人系统实验室,并与伯克利、英伟达、帝国理工学院合作。arXiv 页面:https://arxiv.org/abs/2601.18923,项目页:DeFM,代码:leggedrobotics/defm,权重:Hugging Face。
这篇论文把 DINOv2 式自蒸馏搬到了深度图像上。作者没有用文字提示,也没有依赖彩色纹理,而是用 60.4M 张深度图像训练一个 ViT-L/14 教师模型,随后把模型蒸馏成若干个 3.01M 到 303.7M 参数的机器人可部署编码器。实验覆盖分类、分割、导航、灵巧操作和四足爬梯。
一句话总结
DeFM 证明深度通道不只是避障输入,也可以承载可迁移的几何、语义与操作先验;多尺度对数归一化和大规模混合深度数据是它从仿真走到真实机器人的关键。
背景:为什么不是再训练一个 RGB 编码器
机器人学习近年的一个常见结构是把视觉编码器冻结,只训练策略头。这个思路在 RGB 上已经非常成熟,DINO、CLIP、R3M、VIP、MVP 等模型提供了大量可迁移特征。可是 RGB 的仿真渲染很难覆盖真实光照、材质和纹理,策略在仿真里学到的颜色线索经常到真实相机上失灵。
深度是另一种视觉信号。它直接给出沿相机 Z 轴的距离,通常由结构光、双目红外、固态激光或神经深度模型产生。光照和纹理改变后,深度图的几何大体仍然成立;仿真深度也可以很便宜地生成,因而成为运动控制、导航和操作任务常用的 sim-to-real 观测。
问题在于,深度一直缺少自己的基础模型。已有系统要么把 RGB 预训练模型直接套在深度图上,要么为每个任务从零训练一个深度 CNN。前者把深度图当作三通道强度图,损失了度量尺度;后者的表征只在当前环境有效,换任务、换传感器就要重训。
作者把这一点说得很直接:深度天然包含物体尺寸、自由空间和可抓取性,却长期被当作策略训练的原始像素。于是论文提出的问题是——能不能只用深度图像,训练一个跨任务、跨环境和跨传感器的通用编码器。
DeFM 的回答是肯定的。它不是新的任务模型,而是一个可以冻结后进入分类、分割、导航、操作和运动控制的表征模型。作者还强调模型和权重全部开放,方便机器人团队直接当作感知骨干使用。
数据:18 个数据集、60.4M 张深度图
基础模型的第一道门槛是数据。深度数据的麻烦在于没有 ImageNet 级别的自然对象集合:真实深度有传感器噪声,合成深度干净但域窄,单目深度估计能从 RGB 图像中生成大量伪深度却缺少绝对尺度。DeFM 选择把三类数据都放进预训练集合。
全量集合共 60.4M 张图像,来自 18 个数据集。作者统计为单目深度估计派生数据 25.0M、真实数据 22.4M、合成数据 13.0M。单目估计部分包括 ImageNet-21k 和 SA-1B 转换出的伪度量深度,用于补充杯子、水果、工具等对象级结构;真实部分包括 Taskonomy、HM3D、ARKitScenes、ScanNet、GraspNet-1B、DROID、DrivingStereo 等;合成部分包括 Replica、Hypersim、TartanGround、TartanAir 和 SHIFT。
| 来源 | 样本数 | 主要作用 |
|---|---|---|
| 单目深度估计派生 | 25.0M | 补充对象多样性和相对几何 |
| 真实深度 | 22.4M | 学习传感器噪声、缺失值和真实域 |
| 合成深度 | 13.0M | 提供干净度量尺度和环境多样性 |
| 合计 | 60.4M | 18 个数据集,覆盖从近距操作到室外导航 |
混合的关键不是每类数据都最大,而是让三者互补。单目深度能提供相对结构,但没有物理尺度;合成数据有精确度量,但缺少真实噪声;真实数据最贴近部署,却受采集环境限制。后续消融显示,只用任何一类都会在某些分割基准上明显退化。
输入表示:三个通道保留三种尺度
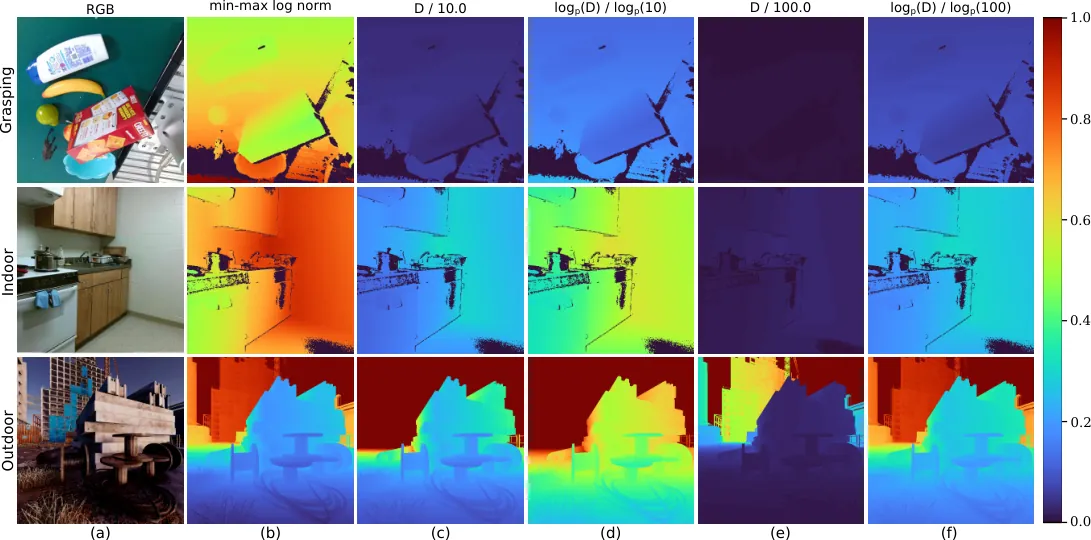
深度值从几毫米到上百米跨越多个数量级。如果把 0 到 100 米线性归一化,桌面上几厘米的高差会被压成极小的灰度差;如果只用局部归一化,模型又失去“这是 3 米还是 30 米”的判断。DeFM 的输入设计围绕这个矛盾展开。
作者先定义对数深度:
$$\log_p(D)=\log(1+D)$$
然后从同一张原始深度图 $D$ 生成三个通道。第一个通道按图像内最小值和最大值归一化:
$$C_1=\frac{\log_p(D)-\log_p(D_{\min})}{\log_p(D_{\max})-\log_p(D_{\min})}$$
这个通道表达相对几何,对抓取边缘、台阶高度这类近场结构最有用。第二个通道以名义 10 米尺度归一化:
$$C_2=\frac{\log_p(D)}{\log_p(10)}$$
第三个通道面向室外导航和长距离感知:
$$C_3=\frac{\log_p(D)}{\log_p(100)}$$
最终输入是三通道堆叠:
$$X_{\text{in}}=[C_1,C_2,C_3]$$
代码实现比论文公式更诚实地暴露了一个细节。defm/utils/utils.py::convert_to_3channel_metric 中,中距离通道的最大值是 9.0 而不是 10.0。注释解释说,预训练时实际使用 $\log(10)$,但推理实现写成 $\log1p(10)$ 会造成数值不一致,于是用 $\log1p(9)\approx\log(10)$ 补偿:
def convert_to_3channel_metric(metric_depth, max_depth_c1=100.0, max_depth_c2=9.0):
    metric_depth = np.nan_to_num(metric_depth, nan=0.0, posinf=0.0, neginf=0.0)
    metric_depth = np.clip(metric_depth, 0, max_depth_c1)
    log_depth = np.log1p(metric_depth)
    c1 = log_depth / np.log1p(max_depth_c1)
    c2 = np.clip(log_depth / np.log1p(max_depth_c2), 0, 1)
    min_log, max_log = np.log1p(metric_depth.min()), np.log1p(metric_depth.max())
    c3 = (log_depth - min_log) / (max_log - min_log) if max_log > min_log else np.zeros_like(log_depth)
    return np.stack([c1, c2, c3], axis=-1)
对 MDE 样本,$C_2$ 和 $C_3$ 只是单调伪尺度,不携带真实米数;$C_1$ 仍然保留相对几何。因此模型既要学会区分“有物理尺度的深度”,也要利用“尺度不变的相对结构”。这比简单把深度图复制三通道更贴合机器人感知的真实情况。
预训练:DINOv2 目标改成深度目标
DeFM 的教师是 ViT-L/14,约 304M 参数。训练使用 DINOv2 的 Fully-Sharded Data Parallel 实现,每张图像准备 2 个 $224^2$ 全局裁剪和 8 个 $98^2$ 局部裁剪。教师只看完整全局裁剪,学生看局部裁剪和被遮蔽的全局裁剪。
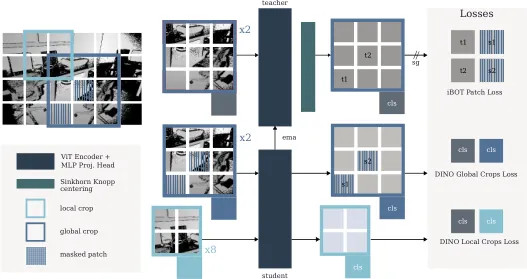
全局裁剪损失把学生看到的遮蔽视图对齐到教师看到的完整视图:
$$\mathcal{L}_{\text{Global}}=\sum_{i=1}^{G}\sum_{j=1,j\neq i}^{G}\mathcal{L}_{\text{DINO}}(f_s(x'_{gi}),f_t(x_{gj}))$$
局部裁剪损失要求学生把小图块解释成整体场景:
$$\mathcal{L}_{\text{Local}}=\sum_{g=1}^{G}\sum_{l=1}^{L}\mathcal{L}_{\text{DINO}}(f_s(x_l),f_t(x_g))$$
iBOT 损失作用在 patch token 上,强制学生重建被遮住的局部区域。设 $p_{ti}$ 是教师目标分布,$p_{si}$ 是学生对被遮 patch 的预测:
$$\mathcal{L}_{\text{iBOT}}=-\sum_{i\in\text{masked}}p_{ti}\log p_{si}$$
总损失再加上 KoLeo 正则,防止表征坍缩:
$$\mathcal{L}_{\text{total}}=\mathcal{L}_{\text{Global}}+\mathcal{L}_{\text{Local}}+\mathcal{L}_{\text{iBOT}}+\alpha\mathcal{L}_{\text{KoLeo}}$$
其中 $\alpha=0.1$。DINO 和 iBOT 使用独立的投影头,原型数为 131,072。iBOT 的遮蔽概率是 0.5,遮蔽比例服从 $[0.1,0.5]$ 上的均匀分布。教师温度从 0.04 升到 0.07,动量从 0.994 升到 1.0。
优化设置没有为了论文自定一套神秘超参。作者沿用 DINOv2 配方:AdamW、峰值学习率 $3.5\times 10^{-4}$、100k 次预热、权重衰减从 0.04 余弦到 0.2、梯度裁剪 3.0,共 625k 次迭代,batch size 3072,96 张 GH200,float16 混合精度。
真正改变的是输入增强。RGB 常用的颜色抖动、灰度化和 solarization 被移除,替换成深度亮度/对比度抖动、高斯噪声和整图共享的像素 dropout。后者模拟真实深度传感器的缺失值,避免模型把空洞当成某种颜色纹理。
flowchart TB
    D[Raw depth image] --> N[Three-channel log normalization]
    N --> C[Global and local crops]
    C --> T[Momentum ViT-L teacher]
    C --> M[Masking]
    M --> S[ViT-L student]
    T --> Q[Teacher targets]
    S --> L[DINO local loss]
    S --> L2[DINO global loss]
    S --> L3[iBOT patch loss]
    S --> L4[KoLeo regularizer]
    Q --> L
    Q --> L2
    Q --> L3
    L --> TOT[Total loss]
    L2 --> TOT
    L3 --> TOT
    L4 --> TOT
这个流程与源码一一对应:defm/models/vision_transformer.py 提供 ViT 前向与中间层接口,defm/layers/dino_head.py 是投影头,defm/utils/utils.py::preprocess_depth_image 负责把任意尺寸深度图转成 patch 对齐的张量。
蒸馏:把 ViT 教师搬进机器人 CNN
大模型适合离线研究,但策略训练要大 batch,真实部署又受显存和延迟限制。作者把 DeFM-L/14 冻结为教师,蒸馏出 ViT-S、ResNet、RegNet 和 EfficientNet 学生。参数量从 3.01M 到 303.7M,训练 200k 次,64 张 GH200,batch size 2048,学习率 $1\times 10^{-3}$。
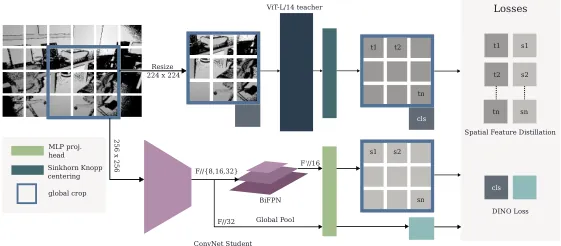
CNN 的问题是把最后一层池化成类别向量后,空间结构会丢失,而 ViT 教师的优势恰好在 patch token。作者在 CNN 的 $F/8$、$F/16$、$F/32$ 特征上叠加 BiFPN,先做自顶向下再自底向上融合,然后输出与教师对齐的稠密表征。
class BiFPNLayer(nn.Module):
    def forward(self, feats):
        td_feats[-1] = feats[-1]
        for i in range(self.n_levels - 2, -1, -1):
            up = F.interpolate(td_feats[i + 1], size=feats[i].shape[-2:], mode="nearest")
            td_feats[i] = self.fuse_topdown[i]([feats[i], up])
        for i in range(1, self.n_levels):
            down = F.max_pool2d(out_feats[i - 1], kernel_size=2, stride=2)
            out_feats[i] = self.fuse_bottomup[i - 1]([td_feats[i], down])
        return [conv(f) for conv, f in zip(self.convs, out_feats)]
全局特征用 CNN 最后一层池化特征,对应教师 class token;空间特征用 BiFPN 在 $F'/16$ 分辨率上的输出,对应 ViT 教师的 patch token。学生输入为 $256\times256$,使空间 token 是 $16\times16$,正好对齐 $224/14\approx16$。权重加载逻辑在 defm/model_factory.py::create_defm_model 中统一处理,CNN 分支显式关闭 torchvision 预训练权重,避免加载 ImageNet 权重污染深度表征。
这个设计不是把大模型单纯砍小。它保留了机器人最需要的两类特征:类别级 embedding 和可上采样的空间图。消融也证明了这一点,ResNet-18 学生不使用特征金字塔时,ScanNet mIoU 只有 14.81;使用 BiFPN 后达到 60.24。
感知结果:分类和分割
作者先构造 ImageNet-1k-Depth:用单目深度估计网络把 RGB 转成深度图,再按 DINOv2 协议做线性探针和 KNN。这一基准衡量模型是否在预训练分布中学到线性可分的类别结构。
| 模型 | Top-1 KNN | Top-5 KNN | Linear |
|---|---|---|---|
| ViT-L/14 DINOv2 | 60.28 | 80.75 | 68.26 |
| ViT-L/16 C-RADIOv3 | 55.23 | 76.96 | 63.92 |
| ViT-L/16 DINOv3 | 64.07 | 83.48 | 69.55 |
| ViT-L/14 DeFM | 63.46 | 84.79 | 71.72 |
| ViT-S/14 DINOv2 | 47.66 | 69.11 | 55.06 |
| ViT-S/16 DINOv3 | 49.50 | 70.93 | 50.86 |
| ViT-S/14 DeFM | 55.27 | 78.06 | 61.54 |
DeFM-L 在 Top-5 KNN 和线性探针上最高,Top-1 KNN 只比 DINOv3 低 0.61 个百分点。更有意义的是小模型:DeFM-S 相对同规模 RGB 蒸馏模型最多提高约 10 个百分点。说明深度通道不是只能靠大容量才能学出语义,小容量模型同样需要深度原生预训练。
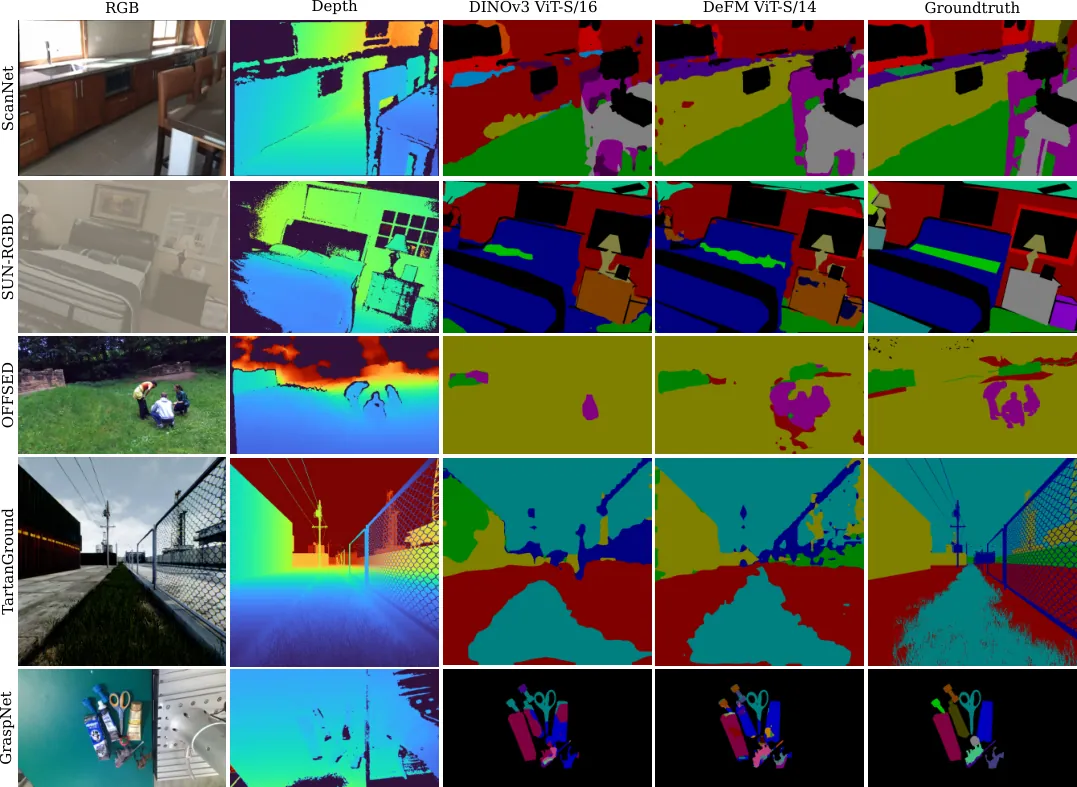
分割探针覆盖 ScanNet、SUN-RGBD、OFFSED、TartanGround 和 GraspNet-1B,取最后一个 block 的 patch token,训练线性分类头后双线性上采样。这是一个严格测试:编码器完全冻结,只训练线性层。
| 模型 | ScanNet | SUN-RGBD | OFFSED | TartanGround | GraspNet-1B |
|---|---|---|---|---|---|
| ViT-L/14 DINOv2 | 29.91 | 32.71 | 53.98 | 65.88 | 24.12 |
| ViT-L/16 DINOv3 | 34.86 | 39.23 | 54.32 | 68.61 | 25.52 |
| ViT-L/14 DAv2 | 29.91 | 32.68 | 55.87 | 67.25 | 25.43 |
| ViT-L/14 DeFM | 38.26 | 36.88 | 57.15 | 73.22 | 27.57 |
| ViT-S/14 DeFM | 33.79 | 33.27 | 58.10 | 70.82 | 20.53 |
| ResNet-50 DeFM | 35.34 | 32.19 | 52.55 | 70.89 | 31.95 |
| ResNet-18 DeFM | 28.01 | 25.97 | 46.87 | 65.49 | 23.27 |
| PTv3-L Concerto | 21.52 | 16.18 | 32.25 | 58.35 | 4.44 |
| RE-PTv3 Utonia | 23.06 | 20.70 | 30.36 | 59.79 | 4.34 |
DeFM-L 在五个数据集中的四个最高。ViT-S 的优势更大,例如 ScanNet 上比 DINOv3-S 高 7.48,比 Theia-S 高 14.23。点云基础模型在单视角深度反投影出的稀疏点云上反而较差,因为它们预训练时多见完整房间扫描、隔离物体或激光扫描,与相机深度有显著域差。
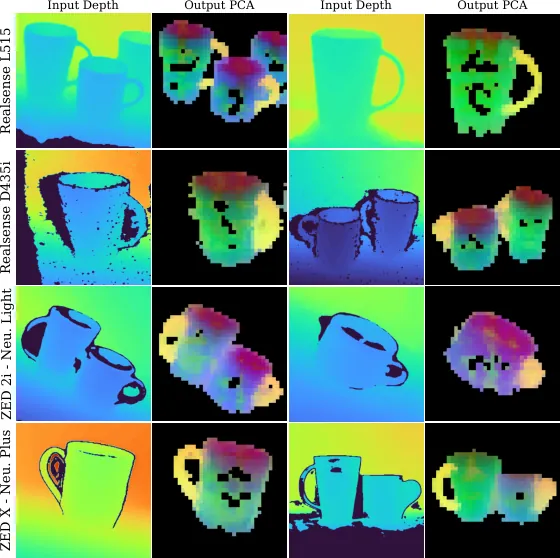
PCA 可视化进一步说明语义来自深度。不同传感器拍摄的杯子、把手和杯口在特征空间中保持一致聚类;抽屉和柜子的把手也能被同一套特征高亮。这对操作策略很有价值,因为抓取决策往往要定位可交互部位,而不是识别整张图。
消融:三通道与混合数据真的有用
作者用较小的 ViT-S 做 125k 步消融,避免大模型结果掩盖设计差异。三种消融分别针对输入归一化、预训练数据和 CNN 蒸馏结构,均以分割 mIoU 为指标。
| 变体 | ScanNet | SUN-RGBD | OFFSED | TartanGround | GraspNet-1B |
|---|---|---|---|---|---|
| 仅全局对数相对深度 $C_1$ | 20.83 | 17.81 | 50.01 | 65.39 | 16.68 |
| 仅远距离度量 $C_3$ | 24.23 | 20.93 | 51.63 | 65.76 | 15.38 |
| 三通道 $[C_1,C_2,C_3]$ | 24.43 | 20.76 | 52.06 | 67.11 | 17.07 |
| 仅真实数据 | 27.80 | 22.62 | 49.20 | 65.01 | 15.06 |
| 仅合成数据 | 21.75 | 18.66 | 50.23 | 67.14 | 15.31 |
| 仅 MDE 数据 | 22.74 | 18.93 | 49.78 | 65.87 | 14.12 |
| 完整混合 | 24.43 | 20.76 | 52.06 | 67.11 | 17.07 |
| ResNet-18 无 FPN | 14.81 | 12.96 | 40.50 | 57.75 | 18.30 |
| ResNet-18 标准 FPN | 17.18 | 15.46 | 45.81 | 58.93 | 16.88 |
| ResNet-18 BiFPN | 17.13 | 16.35 | 42.39 | 60.24 | 19.32 |
三通道在五项中四项最高;仅在 SUN-RGBD 略低于 $C_3$。$C_3$ 是远距离度量通道,在多数室内外场景更好,却在 GraspNet-1B 上不如相对通道,说明过度压缩会破坏桌面厘米级细节。三通道不是机械堆叠,而是让模型按任务选择可用的先验。
数据消融中,仅真实数据在 ScanNet 最强,仅合成数据在 TartanGround 最强,MDE 数据在部分基准反而偏弱,但完整混合的平均 mIoU最高,并且不是任何一项的最差者。作者也明确说这是小规模验证,不证明全量数据的最优配比。
CNN 蒸馏消融显示多尺度融合是必要条件。BiFPN 在 TartanGround 上比无 FPN 高 2.49,在 GraspNet-1B 上高 1.02;标准 FPN 在 ScanNet 和 OFFSED 有时更好。也就是说,BiFPN 不是唯一解,但没有空间融合几乎一定丢掉 ViT 教师的密集特征。
导航:跨环境成功率
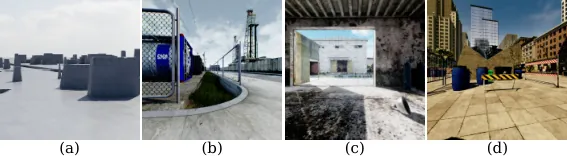
导航实验使用 Unitree B2W,任务是 embodiment aware point-goal navigation。前端是冻结的 RegNetX-400MF 加 FPN,稠密特征与本体状态交叉注意,经 SRU 和 MLP 输出速度命令。训练环境由迷宫、坑和楼梯组成,测试环境换成工业机库、废弃电缆区和现代城市街区。
| 模型 | 训练环境 | 工业机库 | 废弃电缆 | 现代城市 |
|---|---|---|---|---|
| ImageNet | 77.61 | 50.00 | 38.33 | 65.00 |
| VAE | 90.23 | 89.67 | 83.00 | 73.67 |
| DINOv3 | 83.64 | 90.00 | 74.67 | 72.67 |
| DeFM | 90.31 | 92.67 | 84.33 | 79.00 |
训练环境中 VAE 与 DeFM 几乎持平,但三个分布外环境中 DeFM 全部最高。失败模式分解显示,DeFM 的碰撞数一致较低;作者认为它能识别栏杆、交通牌、灯柱等细长异形障碍,并给这些特征更高的代价。DINOv3 的问题被归因于输入被当作普通强度通道,缺少多尺度度量感知。
真实部署覆盖室内、城市、公园和施工场地,起终点距离 5 到 100 米。策略能处理行人、滑板车、栅栏、家具和不平地面。作者也给出局限:即使仿真里,$64\times40$ 的低分辨率输入仍会让电线、细杆和网格漏过,提升分辨率和仿真多样性是后续方向。
操作与运动控制
灵巧抓取实验来自 DexTRAH:状态教师包含物体状态和 one-hot 编码,学生只看深度图,并把 ResNet-18 特征与本体信息一起送入 LSTM 和 MLP。训练在 8 张 L40S 上进行,每张 256 个并行环境,深度图加入散斑、高斯噪声、像素丢失和条状噪声。
| 预训练 | 冻结,训练噪声 | 冻结,Kinect 噪声 | 微调,训练噪声 | 微调,Kinect 噪声 |
|---|---|---|---|---|
| Scratch | — | — | 0.7774 | 0.7247 |
| ImageNet | 0.6576 | 0.0043 | 0.7950 | 0.7366 |
| VAE | 0.6894 | 0.0219 | 0.8105 | 0.0379 |
| DINOv3 | 0.6532 | 0.2075 | 0.8243 | 0.7837 |
| DeFM | 0.8089 | 0.4860 | 0.8936 | 0.8763 |
冻结 DeFM 的训练噪声成功率比 scratch 学生高 0.0315,比 ImageNet 高 0.1513;换到 Kinect 噪声后,DeFM 只从 0.8089 降到 0.4860,ImageNet 和 VAE 几乎崩掉。微调后 DeFM 达到 0.8936 和 0.8763,说明预训练特征既可冻结使用,也支持端到端适配。
爬梯实验用 ANYmal 四足机器人。视觉学生由 CNN 编码器、本体输入和 RNN 组成,训练在 IsaacGym 中用 1024 个环境、每批 120 步、1 万个 epoch。测试包括 15 到 45 毫米梯杆半径、70 到 90 度梯角和随机扰动。
| CNN-Scratch | ImageNet | VAE | DINOv3 | DeFM |
|---|---|---|---|---|
| 90.45 | 89.29 | 89.75 | 89.59 | 90.14 |
DeFM 是冻结模型中最高的,但仍低于从零训练 CNN 0.31 个百分点。这是论文最诚实的部分:预训练不是在所有任务上都压倒任务专用训练。作者推测深度预训练带来的传感器鲁棒性会在真实部署中体现,并用真实爬梯 PCA 展示梯子结构在强噪声下仍被稳定聚类。
局限与未来工作
作者承认数据整理仍然粗放。序列数据按 1 到 5 Hz 子采样,另一些数据集全量使用,还没有做去重;他们预计去重、扩数据、扩模型和延长训练会继续提升能力。第二个作者自述的弱点是 MDE 依赖:25.0M 张单目估计深度可能把几何伪影、相对尺度歧义和 RGB 偏置带进表征。
第三个问题是度量与横向歧义。三通道设计保留了尺度感知,但没有相机内参时横向尺度仍可能漂移。作者提出可学习内参、显式度量 token 或辅助深度重建损失来加强约束。第四个问题是标准 ViT 的 patch 级伪影,未来可用 register token 缓解。第五个问题是当前只覆盖 stereo 与主动红外深度,固态 LiDAR 距离图还没有纳入。
从工程角度看还有一个隐性成本:60.4M 张数据、96 张 GH200 和 625k 步不是普通实验室能复现的。小模型解决了部署端成本,但基础模型本身仍是重资产;对多数团队,价值在于直接下载权重,而不是重训。
总结
DeFM 的价值不在发明一个全新的自监督公式,而在把“深度该有自己的基础模型”这件事做完整:数据混合、尺度感知输入、DINOv2/iBOT/KoLeo 训练、CNN/ViT 蒸馏、分类分割和三类机器人控制验证、权重开放。它说明深度信号在无颜色条件下也能形成部件级语义。
对机器人工程实践来说,最直接的用法是用 preprocess_depth_image 把传感器深度转成三通道输入,再从 get_intermediate_layers 取 class token 或 patch token。CNN 学生则返回 global_backbone 与 dense_bifpn,后者适合需要空间结构的控制头。DeFM 并不是终结任务专用编码器,而是把通用部分先替你学好,让策略训练从几何和语义先验起步。
真正的基础模型不是只会认颜色,而是能在没有纹理的深度图上稳定指出可以抓、可以走和不能撞的地方。