PAPER DEEP DIVE
PhiZero:围绕物理语言构建的世界模型
提出物理语言——世界状态转移的紧凑离散表示。PhiZero 采用先推理后渲染范式:先从真实视频自监督学习物理语言,推理出未来世界演化的语言序列,再渲染为视频;在生成与理解基准上验证了物理一致性,并展示交互式建模、细粒度动作条件仿真与零样本运动迁移的潜力。
论文元信息
| 项目 | 内容 |
|---|---|
| 标题 | PhiZero: A World Model Built Around Physical Language |
| 作者 | Shuyao Shang, Yuqi Wang, Ruopeng Gao, Xu Chen, Tieniu Tan, Lue Fan, Zhaoxiang Zhang (中科院自动化所 NLPR) |
| 论文链接 | arXiv:2607.28624 |
| 项目主页 | Phi-Zero.github.io |
一句话总结:PhiZero 提出了一种围绕"物理语言"构建的世界模型——从野外视频中自监督学习紧凑的离散状态转移表示,先推理未来世界演化为物理语言序列,再渲染为视频,在 Physics-IQ 基准上取得最佳物理保真度(IQ-Score 41.2)。
研究背景与动机
视频世界模型能够生成高视觉保真度的未来视频,因此越来越被视为物理世界的有前景的模拟器。但这类模型的中心目标必须超越视觉保真度,转向学习物理世界如何演化。主流方法主要通过像素空间的直接预测训练,将底层动力学隐含在高维视觉表示中,经常导致物理不一致的结果。
作者从人类智能中汲取灵感。人类不是记忆个别视觉结果,而是从视觉经验中抽象出关于世界如何演化的可泛化知识。自然语言作为组织和表达这种知识的主要媒介,提供了可以显式推理的符号空间。语言模型在数字领域的成功进一步证明了语言作为学习和推理基础的扩展性。
然而,当建模目标从数字世界转向物理世界时,自然语言往往太粗糙,无法忠实地表示视觉经验中观察到的复杂状态转移。因此作者提出:能否超越自然语言,学习一种更细粒度的物理世界转移表示,以实现显式推理?
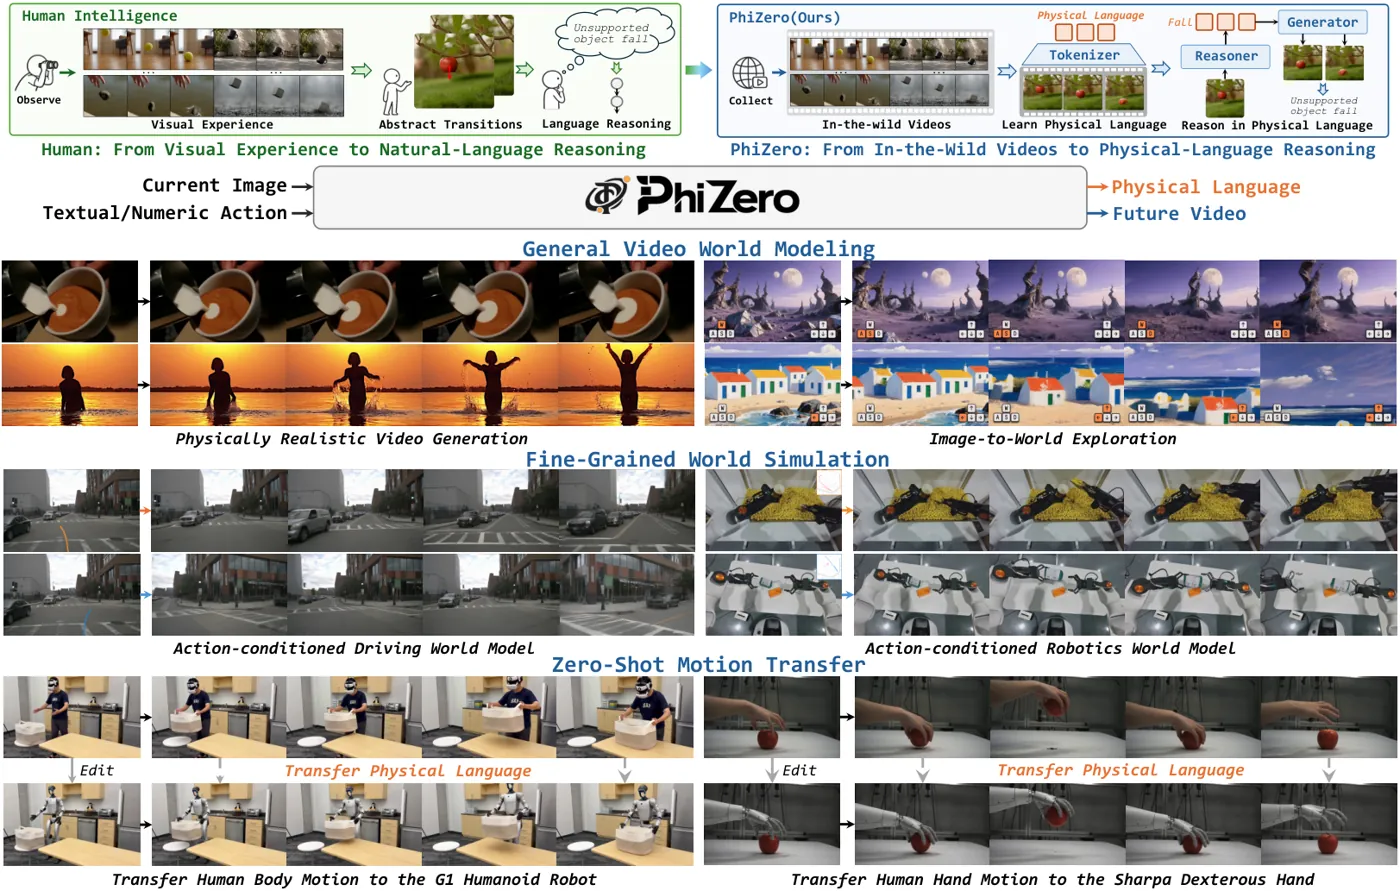
图1:PhiZero 从野外视频学习紧凑离散的物理语言,在此空间中推理世界演化,再将推断的转移渲染为视频。
方法详解
核心范式:先推理后渲染
PhiZero 采用"先推理后渲染"(reason-then-render)范式:首先将未来世界演化推断为物理语言序列,然后将推断的转移渲染为视频。这一范式将动力学推理与像素级合成分离,使世界演化成为显式推理目标而非直接像素空间预测。
物理语言分词器
物理语言分词器通过自监督视频重建学习状态转移表示。给定视频,分词器将其状态转移编码为离散的物理语言序列,与首帧一起条件化重建。关键设计是将世界动力学与视觉外观解耦——物理语言捕获"世界如何变化"而非"世界看起来如何"。
分词器使用 FSQ(Finite Scalar Quantization)诱导的离散词表,将连续的视觉特征量化为 $K$ 个原子符号。每个时间步生成 $N$ 个物理语言 token,形成长度为 $N$ 的序列。训练分两阶段:(1) 预训练——在约 5M 个四秒视频片段上,从 256×448 分辨率逐步增加时长(1s→2s→4s);(2) SFT——提升到 512×896 分辨率,在精选语料上微调。
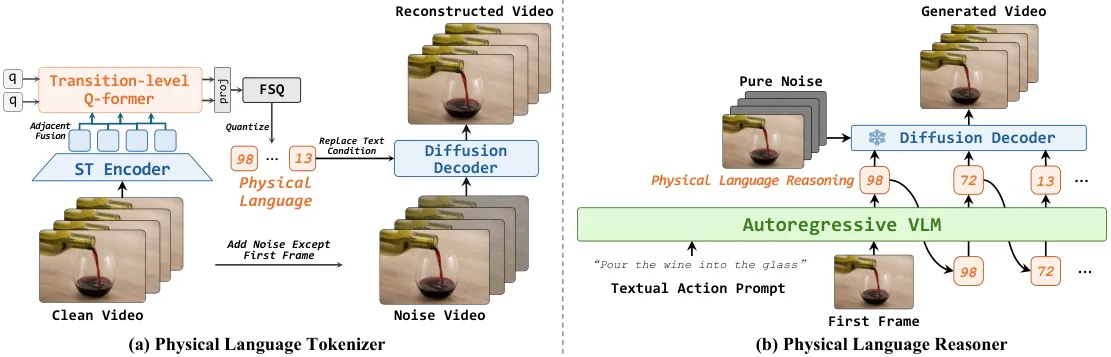
图2:PhiZero 流程。物理语言分词器学习离散状态转移表示,推理器自回归预测物理语言,扩散解码器渲染为视频。
物理语言推理器
推理器从预训练 VLM 初始化,扩展词表以包含 FSQ 索引的原子符号。给定首帧 $I^0$ 和文本提示 $c$,推理器自回归预测长度为 $N$ 的物理语言序列。条件分布按时间顺序分解:
$$p_\theta(\mathbf{z} \mid I^0, c) = \prod_{j=1}^{N} p_\theta(z_j \mid I^0, c, z_{<j})$$
训练使用教师强制下的自回归交叉熵目标:
$$\mathcal{L}_{\text{VLM}} = -\sum_{j=1}^{N} \log p_\theta(z_j \mid I^0, c, z_{<j})$$
训练分两阶段:(1) 持续预训练——在 5M 通用片段语料上,建立文本意图、当前视觉状态和状态转移之间的对应关系;(2) SFT——在约 1M 运动丰富且物理信息丰富的片段上微调,提高状态转移的物理合理性和精度。
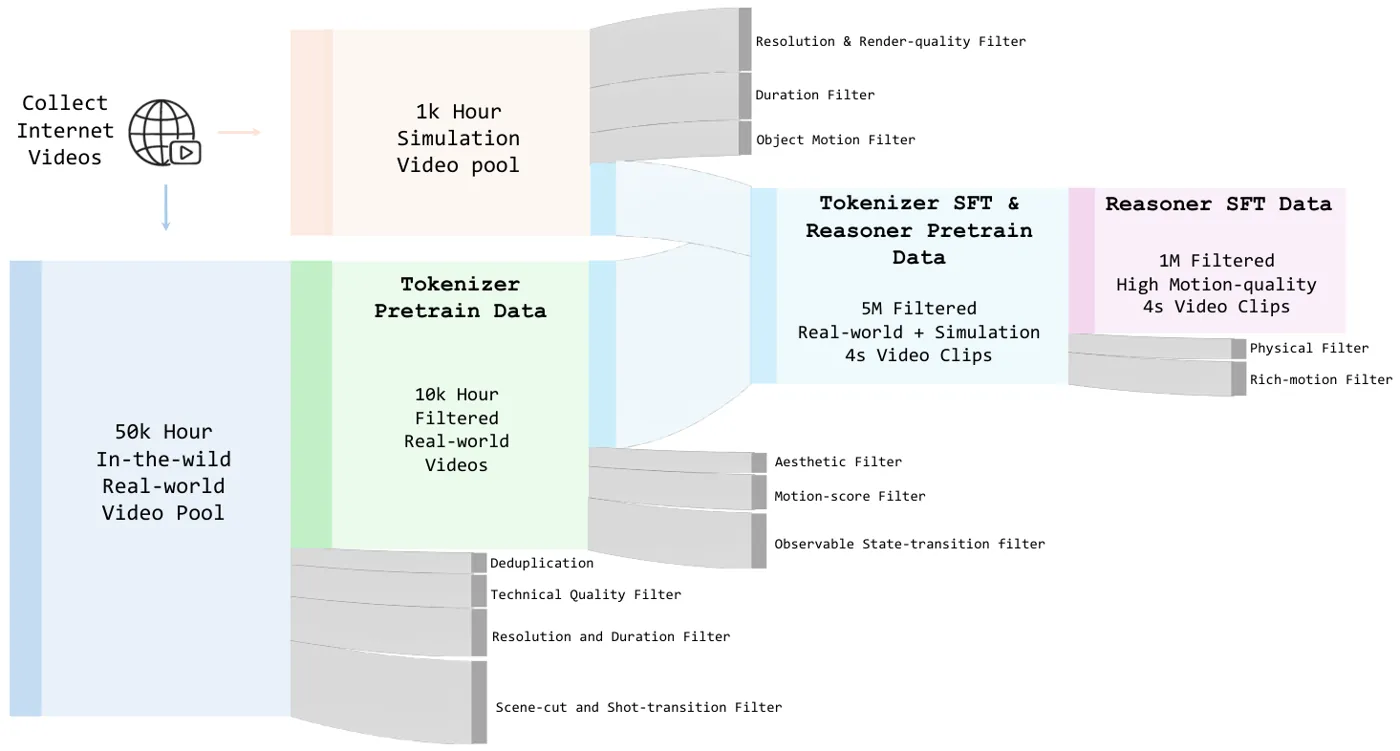
图3:数据管线。VLM 生成高层动作摘要作为条件,冻结的分词器提供物理语言目标。
graph LR
    A["野外视频"] --> B["物理语言分词器
自监督学习"]
    B --> C["离散状态转移序列
(物理语言)"]
    D["首帧 + 文本指令"] --> E["物理语言推理器
(VLM初始化)"]
    C --> E
    E --> F["预测物理语言序列"]
    F --> G["扩散解码器"]
    G --> H["未来视频"]
图4:PhiZero 推理流程。先推理物理语言序列,再渲染为视频。
实验结果
物理结果保真度
在 Physics-IQ Verified 基准上评估物理结果保真度,包含 S-IoU(结构)、ST-IoU(时空)、WS-IoU(世界状态)和 IQ-Score 综合指标。
| 模型 | S-IoU | ST-IoU | WS-IoU | IQ-Score |
|---|---|---|---|---|
| Wan2.2-5B | 24.7 | 22.6 | 13.3 | 21.2 |
| Sora 2 | 37.3 | 27.0 | 26.9 | 26.5 |
| Cosmos3-Nano | 40.4 | 22.0 | 24.6 | 29.1 |
| Wan2.2-14B | 51.1 | 20.5 | 28.5 | 32.2 |
| Hunyuan-Video | 47.1 | 26.9 | 29.7 | 33.4 |
| Grok-Video | 52.7 | 21.4 | 35.7 | 34.8 |
| Cosmos3-Super | — | — | — | 39.5 |
| PhiZero | 58.2 | 36.8 | 27.6 | 41.2 |
表1:Physics-IQ Verified 上的物理结果保真度。PhiZero 在 IQ-Score 上取得最佳。
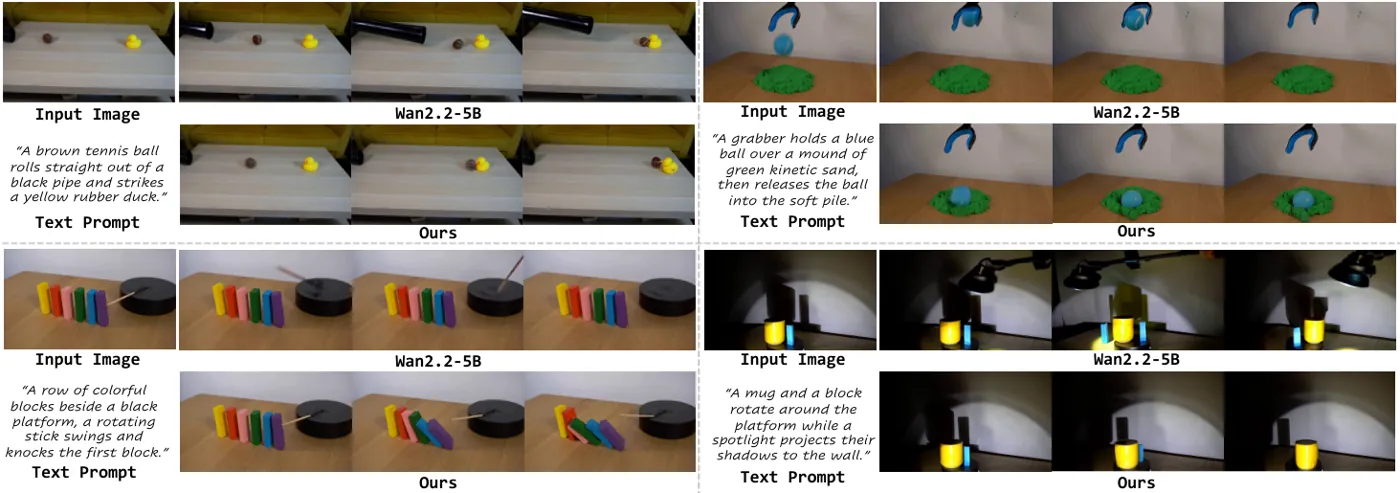
图5:物理保真度可视化对比。PhiZero 生成的视频在物理一致性上优于其他模型。
更广泛的应用
PhiZero 还展示了在可控交互式世界建模、细粒度动作条件仿真和零样本运动迁移方面的潜力。
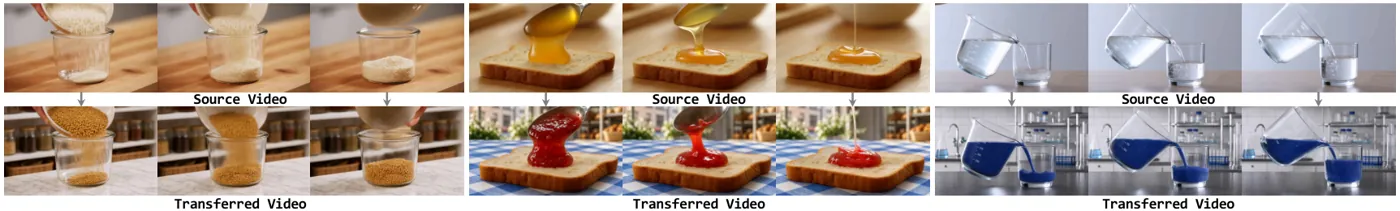
图6:零样本运动迁移。PhiZero 可将一个视频中的运动模式迁移到新场景。
局限性
1. WS-IoU 非最优:虽然 PhiZero 在 IQ-Score 上最高,但在 WS-IoU(世界状态 IoU)上未达最优,表明物理语言表示在某些细粒度状态捕获上仍有改进空间。
2. 训练数据规模:需要约 5M 视频片段进行分词器训练和约 1M 精选片段进行推理器 SFT,训练成本较高。
3. 分辨率限制:当前在 512×896 分辨率上训练,可能不足以满足高分辨率物理仿真需求。
总结与展望
PhiZero 的核心贡献是提出了"物理语言"这一中间表示——一种从野外视频自监督学习的紧凑离散状态转移编码。这一表示将世界动力学从视觉外观中解耦,使得世界演化成为显式推理目标。"先推理后渲染"范式将动力学推理与像素合成分离,避免了直接像素预测中动力学隐含的问题。
实验结果有力地验证了这一范式:在 Physics-IQ Verified 基准上,PhiZero 的 IQ-Score 达到 41.2,超过 Sora 2(26.5)和 Cosmos3-Super(39.5)等强基线。特别是在 S-IoU(58.2 vs 次高 52.7)和 ST-IoU(36.8 vs 次高 27.0)上的大幅领先,表明物理语言推理器能够更准确地预测物理结构演化。
"先推理后渲染"——这一范式转移揭示了世界建模的一个根本问题:直接在像素空间预测未来,如同不看棋盘直接画棋局;而先推理物理状态转移再渲染,才真正理解了"世界如何演化"。