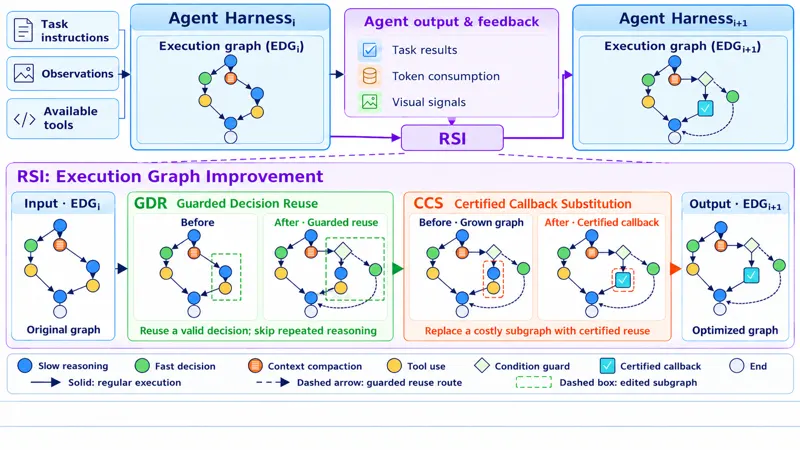
HarnessMM:面向智能体执行框架 Token 效率的递归自我改进智能体执行框架常在工具返回反馈后反复调用推理模型,即使前一次调用已经确定了下一步动作。HarnessMM 在模型与工具边界复用已验证的可执行决策,以可执行决策图保存动作、字面参数、因果依赖和公共守卫,并通过受保护决策复用与认证回调替换跳过后续慢推理;遇到新语义、证据不足或选择器弃权时仍回到原始执行器。方法还以训练反馈递归改进配套框架配置,并由验证集选择部署配置。HumanEval、工业框架、MBPP、ALFWorld 与 GAIA2 等实验显示,在完整任务口径下可显著降低 Token 消耗,部分设置还提升成功率。Yuhua Jiang, Chang Xu, Feifei Gao · 419次阅读 · 2026年10月23日智能体运行时递归自我提升2026年10月23日
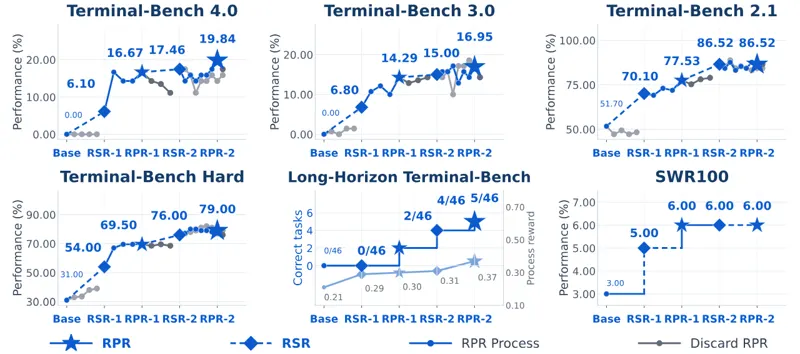
Terminal-RSI:递归自改进终端智能体递归自重写验证轨迹并继承评论家做策略精炼,配 TB-GAE 与成功优先奖励,27B 模型 Terminal-Bench 4.0 达 19.84%。Junyao Yang, Zongxia Li, Yucheng Shi · 431次阅读 · 2026年10月15日Terminal Agent强化学习2026年10月15日
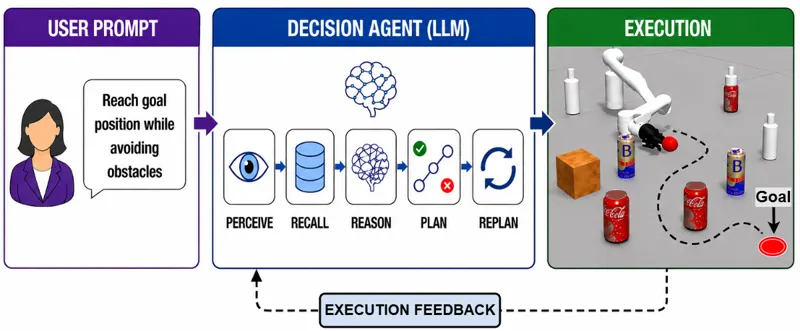
RoboNav-Arm:智能体驱动的机械臂避障框架提出RoboNav-Arm框架:LLM决策智能体调度场景理解、记忆检索与轨迹规划三大模块,自适应选择RRT系规划器并做安全膨胀校验,四场景无碰撞成功率100%至83.3%。Aachal Sharma, Narendra Kumar Dhar · 614次阅读 · 2026年6月25日机械臂避障2026年6月25日

 0:52