PAPER DEEP DIVE
HarnessMM:面向智能体执行框架 Token 效率的递归自我改进
智能体执行框架常在工具返回反馈后反复调用推理模型,即使前一次调用已经确定了下一步动作。HarnessMM 在模型与工具边界复用已验证的可执行决策,以可执行决策图保存动作、字面参数、因果依赖和公共守卫,并通过受保护决策复用与认证回调替换跳过后续慢推理;遇到新语义、证据不足或选择器弃权时仍回到原始执行器。方法还以训练反馈递归改进配套框架配置,并由验证集选择部署配置。HumanEval、工业框架、MBPP、ALFWorld 与 GAIA2 等实验显示,在完整任务口径下可显著降低 Token 消耗,部分设置还提升成功率。
一句话总结
HarnessMM 不让模型权重或工具接口改变,而是在工具返回之后判断此前已经确定的动作能否直接执行;只有动作语义、参数或证据仍不确定时,才重新调用慢速推理模型。
研究背景与动机
智能体执行框架通常把模型推理与外部工具交替编排。模型先写代码,工具返回编译结果,框架再把结果放回上下文并调用模型,决定是否运行测试。问题在于,有些后续动作在第一次推理时已经完整确定,例如测试命令、要读取的文件或下一项参数。工具反馈只是告诉框架“现在能不能执行”,并不必然要求重新生成动作。
现有 Token 优化大多作用在一次调用的内部。提示压缩减少输入,轨迹裁剪减少历史,思考预算降低输出,快慢模型路由改变由谁推理。这些方法都重要,却没有回答另一个问题:这一次推理调用是否本来就可以消失。模型输出变短也不等于调用被消除;如果多了一次分类器调用而原推理仍然存在,系统可能只是增加了成本。
论文把这种会计陷阱称为“替换悖论”。一个快速阶段花了 Cf,但若没有删掉原流程中的 Cn,总成本是两者相加;只有被删除的计算严格大于新引入的作者、选择、恢复和上下文成本,替换才可能带来净收益。这个判断把“看起来更快”拉回到完整任务账本。
HarnessMM 的出发点因此不是训练更强的机器人策略,也不是再造一个通用规划器,而是研究执行框架在何处调用语言模型。作者把慢速模型已经确定动作与字面参数的状态称为“已解决”。工具回执的不确定性只用于激活动作,不重新决定动作本身。
论文将这种方法用于编码与多步骤智能体。对具身智能开发者而言,最直接的关联是执行框架层:机器人任务同样经常出现“抓取完成后执行预先确定的放置”“定位成功后调用预设检查”这类结构。HarnessMM 没有直接做机器人控制实验,但它提出的可执行决策、公开守卫、回执和回退边界值得被机器人智能体系统借鉴。
预备知识:从调用图到可执行承诺
论文把一个任务在框架 h 下的执行展开为有限计算图 Gh(x)=(V,E)。节点可以是推理、检索、路由、工具、验证或恢复,边表示执行依赖。策略 π 决定哪些节点真的被调用。节点 v 的模型 Token 成本记为 cv,于是总成本可以写成:
$$C(\pi)=\mathbb{E}\left[\sum_{v\in V}\mathbf{1}\{v\text{ invoked under }\pi\}\,c_v\right].$$
这个式子看似普通,却把优化对象说清楚了:HarnessMM 改变的是指示函数,也就是某个推理节点会不会出现,而不只是缩短该节点的输出。确定性工具本身不消耗演员 Token,但会改变后续调用概率和任务成败,所以必须和最终质量一起测量。
能力约束写成相对原框架 h0 的后悔值。基准 b 的官方分数为 Qb,新框架与原框架的差是 Rb(π)=Qb(h0)-Qb(hπ)。优化目标是:
$$\min_{\pi} C(\pi)\quad\text{subject to}\quad R_b(\pi)\leq\epsilon_b.$$
这里不是用某个动作是否“看起来正确”代替任务评估。零后悔协议把 ϵb 设为 0,并要求所有失败任务仍进入分母。也正因为有质量约束,“少调用模型”才不能被当成唯一胜利条件。
方法详解
1. 可执行决策图保存的是承诺,不是摘要
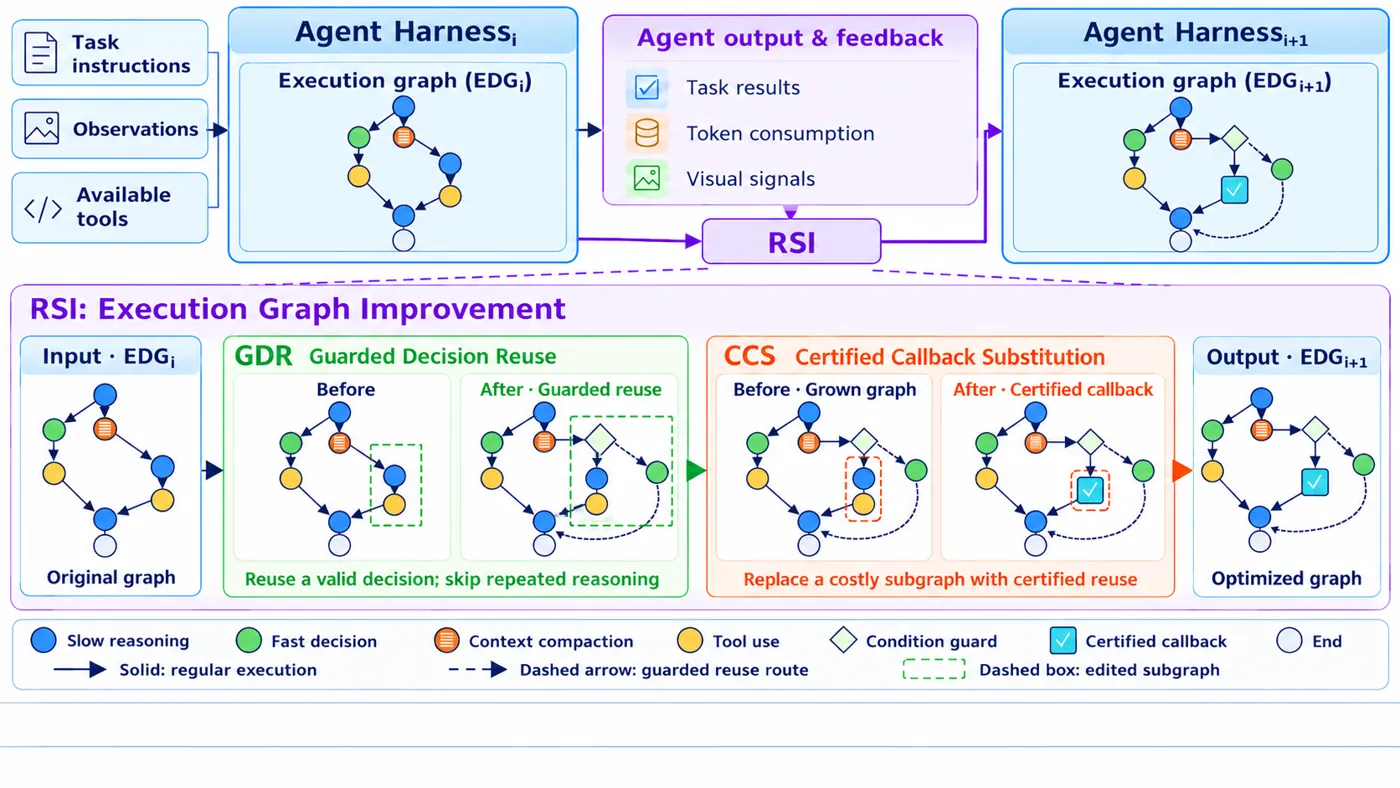
慢速演员 H0 在第 i 次决策时不仅产生当前动作,还可以产生一个有界的可执行后续图 Gi=(Vi,Ei)。未来节点集合为 Bi={d1,...,dm},每个节点包含原生动作、完整字面参数、前驱和公开守卫:
$$d_j=(a_j,\mathrm{arg}_j,\mathrm{pred}_j,g_j).$$
这里的关键不是保存一句“下一步运行测试”的自然语言建议,而是保存工具名、精确参数和依赖。守卫 gj:Spublic→{true,false} 只读取已经发生的公开状态与工具回执。作者在生成节点时同时固定守卫,运行时不能为了通过检查而临时改写检查条件。
图中所有边必须形成有向无环结构。缺失回执、未知守卫、前驱未完成或参数需要新推理时,控制器退回慢速演员。这种设计避免把“计划”误当成“可以无条件执行的命令”。
2. 守卫决策复用把“可做”与“该想”分开
Guarded Decision Reuse,简称 GDR,会在工具转变之间保留图。对节点 dj 和状态 st,可执行条件为三个指示函数的乘积:
$$\begin{aligned} \operatorname{eligible}(d_j,s_t) ={}&\mathbf{1}\{\mathrm{pred}_j\text{ completed}\}\\ &\cdot\mathbf{1}\{g_j(s_t)=\mathrm{true}\}\\ &\cdot\mathbf{1}\{\mathrm{arg}_j\text{ closed}\}. \end{aligned}$$
第一项保证因果顺序,第二项保证观测证据满足守卫,第三项保证动作参数已经闭合。论文明确要求守卫消费真实回执,而不是预测工具结果。某个命令返回 0 可以激活预先写好的测试动作;返回非零、超时或状态格式不认识时,应当由慢速演员重新判断。
只有一个候选满足条件时,可以走确定性路径,选择成本接近零。有多个合法候选时需要带类型的轻量选择器,它只能返回候选编号或弃权符号,不能改写参数。候选为空或选择器返回弃权时,原演员恢复。这一点很关键:快速路径不是强迫分类器在坏选项中挑一个。
EDG 与技能库的区别也在这里。技能通常是跨任务复用的过程,而 EDG 保存的是当前任务中已经解决的逐项动作。它不要求把一段成功经验抽象成通用策略,而是要求这一次推理已经把所有语义选择做完。
3. 认证回调替换证明的是执行路径
Certified Callback Substitution,简称 CCS,把被允许的决策变成真正的原生工具调用,并删掉本来注册在该边界的慢速回调。原始路径可写为 st→H0→at,替换路径则是 st→dj→at。两条路最终使用同一个工具接口,但后者少了一次演员推理。
每个替换证书绑定图哈希、决策编号、前驱回执、精确参数、工具回执和被绕过的回调编号:
$$\begin{aligned} \kappa_t=(&\mathrm{graph\_hash},\mathrm{decision\_id},\\ &\mathrm{predecessor\_receipt},\mathrm{exact\_args},\\ &\mathrm{tool\_receipt},\mathrm{bypassed\_callback\_id}). \end{aligned}$$
论文还用慢调用计数表达“至少少了一次”:
$$N^{\mathrm{parent}}_{\mathrm{slow},t}-N^{\mathrm{HarnessMM}}_{\mathrm{slow},t}\geq 1.$$
证书只证明动作以精确参数执行,且指定慢速调用没有发生。它不自动证明任务正确。守卫通过也只证明声明过的公开条件成立,不证明整个语义判断无误。作者把结构证明和质量评估分开,这是一个必要的边界。
源码中的 integrations/deepseek_harness/sar_v2.mjs:159-186 展现了守卫如何拒绝不完整证据。下面的摘录保留了核心控制流:
export function localGuard(node, receipt) {
  const guard = node.guard;
  if (!guard || typeof guard !== 'object' || Array.isArray(guard) || !Object.keys(guard).length)
    return {known:false, eligible:false, reason:'invalid_guard'};
  let r=receipt?.value?.native_text ?? receipt?.value;
  for(let i=0;i<3 && typeof r==='string';i++) {
    try {r=JSON.parse(r);} catch {return {known:false,eligible:false,reason:'non_json_receipt'};}
  }
  if(!r || typeof r!=='object')
    return {known:false,eligible:false,reason:'missing_receipt'};
  if(receipt?.is_error)
    return {known:true,eligible:false,reason:'native_error'};
}
deterministicAdmission 位于同文件 187-205 行。它同时检查依赖、原生错误、净节省阈值和候选数量;当净估计不超过 1024 Token 时,宁可回到慢速演员。这个实现细节说明快速路径并不是“能匹配就执行”,还需要面对新增选择成本。
真正生成替换证书的代码在 sar_v2.mjs:259-279。它记录图哈希、候选编号、精确工具名与参数、原生回执哈希,并把慢请求序号在边界前后都写为一致值。以下为节选:
this.record({kind:'sar/substitution-certificate',
  schema:'certified-native-substitution/v1',
  bank_hash:item.bank_sha256,
  candidate_id:item.candidate.label,
  ...item.boundary,
  exact_native_tool:e.name,
  exact_arguments:e.arguments,
  native_receipt_hash:hash(e.result),
  slow_requests_at_boundary:0,
  slow_sequence_before:item.slow_snapshot,
  slow_sequence_after:this.slowSequence.length,
  valid_substitution:true});
Codex 原生适配器 phiagent/harness/codex_native_app_bank.py:75-159 采用相似结构:先执行原生根动作,再按前驱寻找候选;选择器弃权或候选耗尽时停止,工具错误也终止快速链。它不扩充工具权限,只复用原框架已有的动作空间。
4. 递归自我改进只修改受限伴随配置
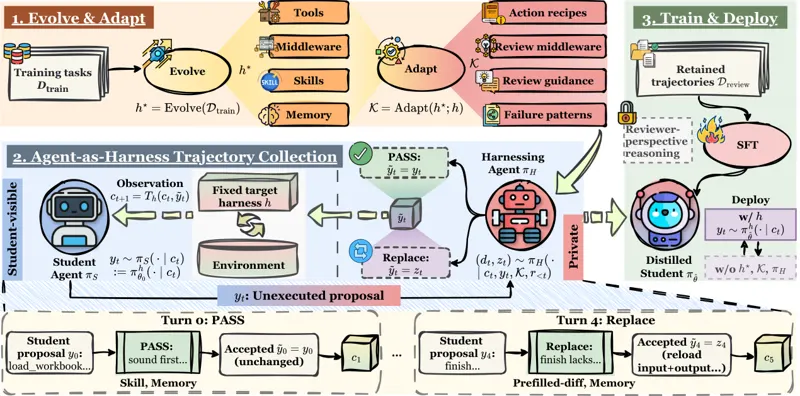
HarnessMM 名称中的 RSI 不是在线训练模型权重。训练反馈用于修改作者提示、上下文字段、适配器和最终化规则等伴随配置;验证集选择冻结候选,测试前再锁定选中配置。模型、权限、任务接口和评分器保持不变。
图中上半部分是框架 RSI,下半部分是任务内的 GDR/CCS 执行。二者不能混为同一个机制。即使某个基准的配置被标成 HarnessMM,只要它只改了指令或上下文、没有持久图执行,它也不能被当作核心替换机制的证据。论文附录 D.5 专门列出了这种归属差异。
下面是该方法的实际闭环:
flowchart TB
    Slow[Slow actor H0] --> Author[Author exact actions and public guards]
    Author --> Graph[Persistent executable decision graph]
    Graph --> Root[Execute native root action]
    Root --> Receipt[Observe public tool receipt]
    Receipt --> Check{Guard known and true}
    Check -- no or unknown --> Slow
    Check -- yes --> Select{One or many eligible nodes}
    Select -- unique --> CCS[Execute exact native action]
    Select -- many --> Typed[Typed selector or abstain]
    Typed -- eligible --> CCS
    Typed -- abstain --> Slow
    CCS --> Cert[Bind graph args receipt and bypassed callback]
    Cert --> Receipt
    CCS --> SlowNew[New semantic decision needed]
    SlowNew --> Slow
5. 完整任务会计决定方法是否真的便宜
论文把一次任务的实际演员输入与输出相加:
$$C_{\mathrm{episode}}(h;x)=\sum_{c\in\mathcal{C}(h,x)}(T_c^{\mathrm{in}}+T_c^{\mathrm{out}}).$$
集合包含作者、选择、剩余慢调用、最终化、恢复和失败任务。开发成本 Cdev 则单独报告;部署到 N 个任务时,摊销账本为:
$$\overline{C}_{N}=\frac{C_{\mathrm{dev}}}{N}+\mathbb{E}_{x}[C_{\mathrm{episode}}(h;x)].$$
因此,某次执行节省 30% Token,不等于包含训练、验证和失败尝试的全部成本也节省 30%。这篇论文明确要求把运行节省与全流程 RSI 节省分开。代码 phiagent/evaluation/deployment_token_accounting.py:126-139 甚至检查 total_tokens 必须等于输入加输出,避免账本口径在汇总时悄悄漂移。
实验分析
编码框架的主结果
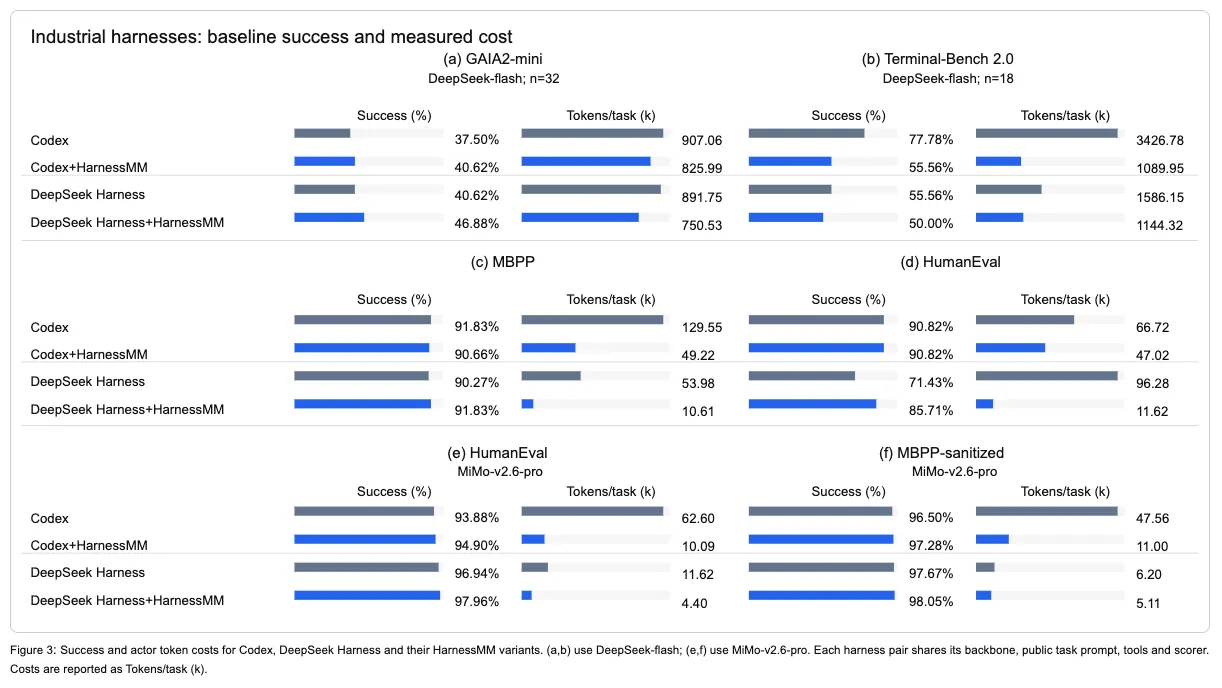
HumanEval 使用完整的 98 个测试任务。Codex 的成功率保持 90.82%,每任务 Token 从 66.72k 降到 47.02k;DeepSeek Harness 的成功率从 71.43% 升到 85.71%,Token 从 96.28k 降到 11.62k。DeepSeek 的成对结果有两边精确 McNemar 检验 p=0.0161,不是只比较两个汇总百分比。
但作者自己指出,HumanEval 是“集成框架”比较,同时改变了字面动作复用、上下文管理和最终化。因此,调用次数下降不能全部归功于 CCS。最能隔离机制的,是相同作者提示、公共上下文、工具和限制下改变图执行方式的 MBPP 消融。
| 任务集 | 框架 | 成功率和 Token 变化 | 认证替换 |
|---|---|---|---|
| HumanEval,98 题 | Codex → HarnessMM | 90.82% → 90.82%;66.72k → 47.02k | 18 次,每任务 0.18 次 |
| HumanEval,98 题 | DeepSeek → HarnessMM | 71.43% → 85.71%;96.28k → 11.62k | 147 次,每任务 1.50 次 |
| MBPP-sanitized,257 题 | DeepSeek → HarnessMM | 90.27% → 91.83%;53.98k → 10.61k | 472 次,每任务 1.84 次 |
| MBPP-sanitized,257 题 | Codex → HarnessMM | 91.83% → 90.66%;129.55k → 49.22k | 158 次,每任务 0.61 次 |
Codex 在 MBPP 上的成功率下降 1.17 个百分点,却减少了约 62% Token;论文没有把这个代价藏起来。DeepSeek 在 HumanEval 上出现 22 次改善、8 次退步,说明汇总提升仍包含真实失败。对于执行框架研究,这种成对结果比单一平均值更有解释力。
MBPP 消融真正分离了持久复用与回调删除
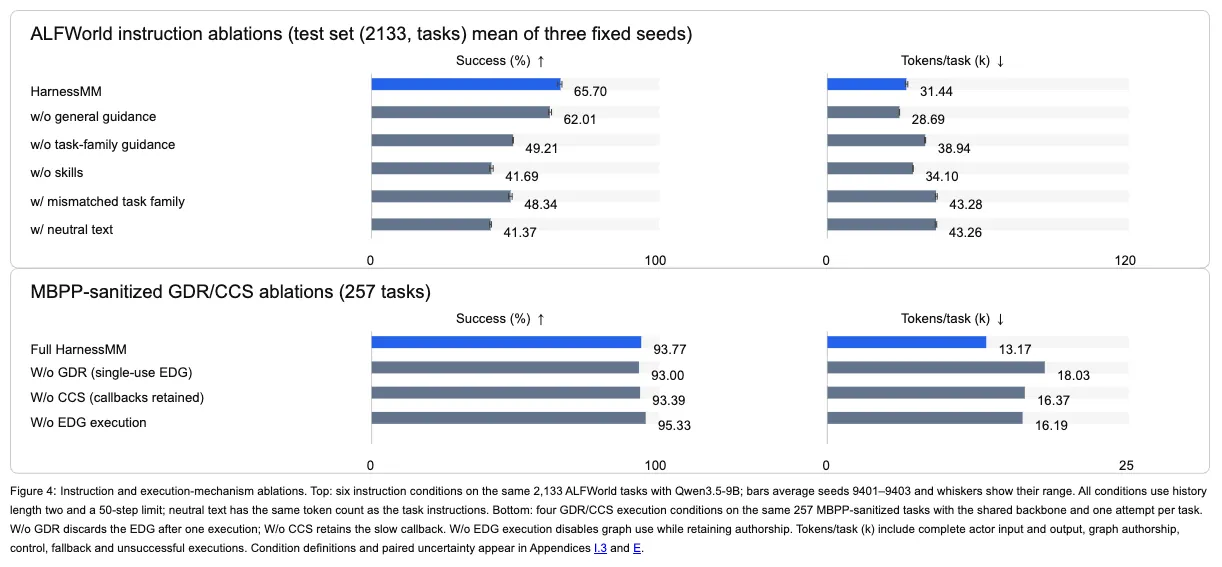
完整 HarnessMM 在 257 个 MBPP 任务上达到 93.77%,每任务 13.17k Token。去掉 GDR、把每个 EDG 限制为一次使用后,成功率为 93.00%,成本升到 18.03k;从完整方法看,持久图复用降低 26.91% 成本。去掉 CCS、保留慢回调后,成功率为 93.39%,成本为 16.37k,完整方法仍便宜 19.52%。
“禁用 EDG 执行但保留作者”条件最耐人寻味:它达到 95.33%,每任务 16.19k Token。HarnessMM 相对它节省 18.62% Token,却少解 4 道题。这个结果不允许把方法写成普遍提高质量;更准确的结论是,持久复用和回调删除有可测的成本收益,但当前作者与守卫策略存在质量取舍。
| MBPP 条件 | 成功率 | Tokens/task | 相对完整方法 |
|---|---|---|---|
| 完整 HarnessMM | 93.77% | 13.17k | 基准 |
| 无 GDR,单次 EDG | 93.00% | 18.03k | 完整方法便宜 26.91% |
| 无 CCS,保留回调 | 93.39% | 16.37k | 完整方法便宜 19.52% |
| 禁用 EDG 执行 | 95.33% | 16.19k | 完整方法便宜 18.62%,但少解 4 题 |
六个伴随基准不能混成一张总榜
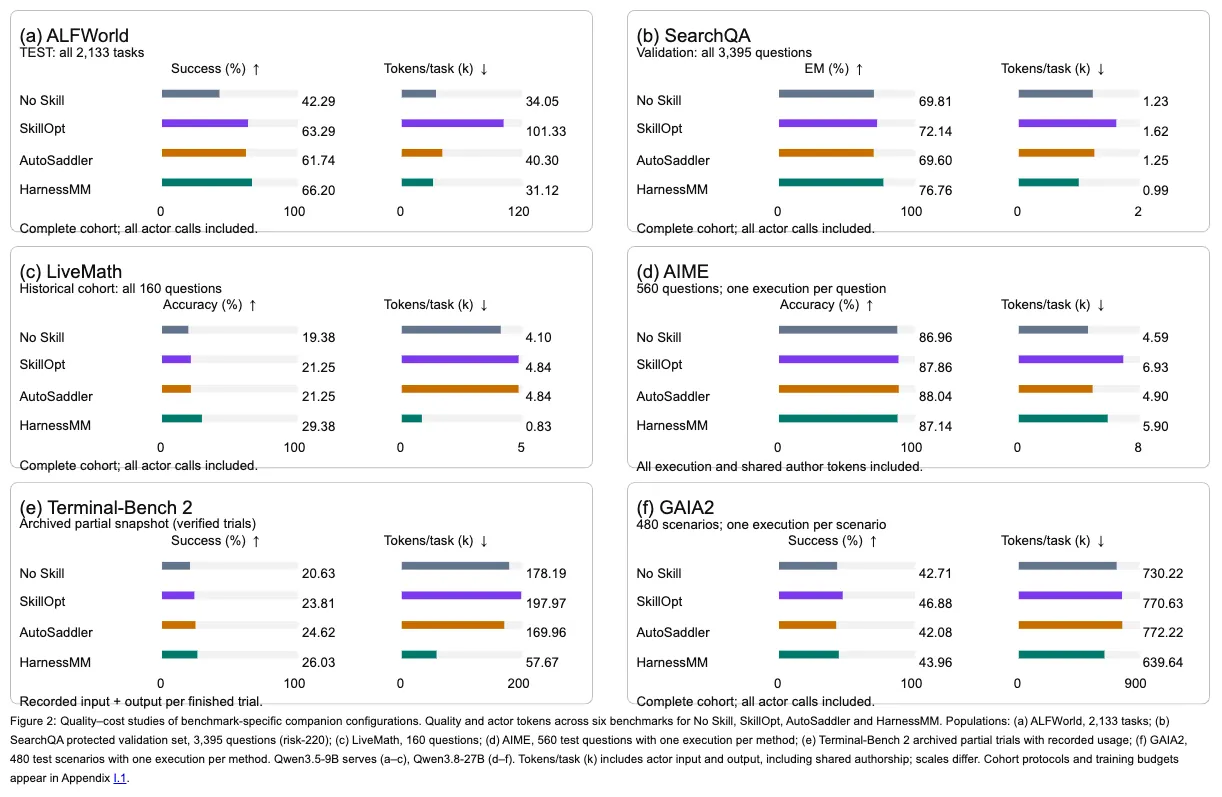
Figure 2 的六个面板使用了不同机制、任务总体和成本边界。ALFWorld、SearchQA、LiveMath、AIME、Terminal-Bench 2 与 GAIA2 不能被视为核心 EDG 的六次重复实验。例如 ALFWorld 图中主要是任务族指令的内容效应,控制器被禁用;LiveMath 只改变答案优先提示和输出上限;AIME 是冻结的编译决策策略;GAIA2 才把字面动作库与上下文处理集成起来。
ALFWorld 完整测试集有 2,133 个任务。无技能条件为 42.29%、每任务 34.05k Token,HarnessMM 为 66.20%、31.12k;SkillOpt 达到 63.29%,但成本 101.33k。SearchQA 保护验证集有 3,395 题,HarnessMM 为 76.76 EM、0.99k,无技能为 69.81 EM、1.23k。它们说明选定的伴随配置有价值,却不说明每一次收益都来自回调替换。
| 研究 | 无技能基线 | HarnessMM 配置 | 需要保留的边界 |
|---|---|---|---|
| ALFWorld,2,133 题 | 42.29%,34.05k | 66.20%,31.12k | 任务指令内容效应,控制器禁用 |
| SearchQA,3,395 题 | 69.81 EM,1.23k | 76.76 EM,0.99k | 输入路由、规则句、草稿与回退组成 |
| LiveMath,160 题 | 19.38%,4.10k | 29.38%,0.83k | 单次调用提示与输出上限变化 |
| AIME,560 题 | 86.96%,4.59k | 87.14%,5.90k | 质量接近但 HarnessMM 更贵 |
| Terminal-Bench 2 | 20.63%,178.19k | 26.03%,57.67k | 归档的部分测试快照,不是完整终测 |
| GAIA2,480 个场景 | 42.71%,730.22k | 43.96%,639.64k | 集成上下文与动作库,低于 SkillOpt 的 46.88% |
AIME 是特别重要的反例。HarnessMM 运行成本为 5.90k,而原框架是 4.59k;它的输入为 0.54k、输出 4.28k,共享作者成本 1.08k。输出仅小幅下降,新增作者成本却更大,所以完整执行账本不便宜。数学题主要由输出推理支配,正好缺少可反复复用、参数已闭合的工具动作。
GAIA2 中 HarnessMM 每任务为 639.64k,比无技能基线低约 12%,但只达到 43.96%,仍低于 SkillOpt 的 46.88%。论文还报告 146 次已验证快速执行,只占所有动作尝试的 1.40%,输入占其演员成本 99.47%。这说明在这个总体里,上下文输入远比少量回调消除更能解释总成本。
RSI 迭代显示持久复用的收益,但仍需独立开发账
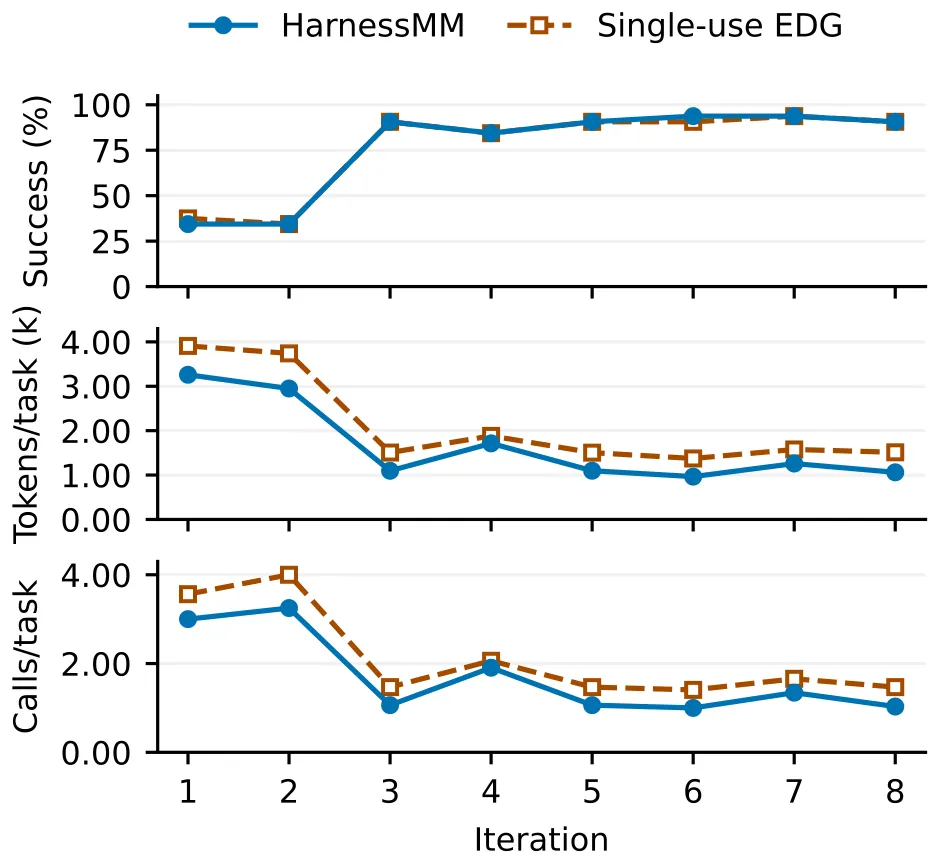
MiniWoB++ 的八个训练引导迭代使用同一组 32 个任务、Qwen3.5-9B、完整截图、15 个动作和 180 秒时限。成功率从 34.38% 升到 90.63%,每任务 Token 从 3.26k 降到 1.06k。到第八轮时,两臂都解出 29/32,持久复用仍节省 29.83%,即 1.51k 对 1.06k。
这组曲线把优化效果与执行替换放在一起观察,但仍只证明固定任务集上的候选执行效率。训练、候选选择、验证和历史研究成本在单独账本里,不能把 67.43% 的执行 Token 降幅直接当成端到端 RSI 回报。
代码复现与工程可读性
仓库把论文概念映射得较清楚。cot_jev.mjs 负责生成并验证动作库,sar_v2.mjs 负责守卫、持久图和证书,codex_native_app_bank.py 提供 Codex 原生边界,deployment_token_accounting.py 统一物理调用计量。模块名仍保留 SAR、Jev、CHISEL 等研究阶段内部名称,但文档明确说明这些不是新的科学协议。
本地运行 node examples/guarded_reuse.mjs 得到三次有证书的原生替换;图执行期间没有慢调用,图耗尽后出现一次慢调用。这验证了控制流,不代表基准得分。运行 python examples/partition.py 得到合成的 2/2/6 划分,验证分组划分逻辑。完整 Python 与 Node 测试套件此次没有执行,因此不能把两个示例结果外推成整个仓库发布就绪。
从集成角度看,最难的部分不是证书哈希,而是为具体框架定义公共状态。守卫必须只看到允许的事后证据,不能泄漏未来结果;工具适配器必须保留精确参数;慢调用日志必须能证明指定回调缺席。只要其中一项由“事后重放”伪造,证书的结构就不会对应真实执行路径。
局限分析
第一项作者自述局限是收益依赖具体任务中存在已经解决的动作。新语义决策必须回到慢速推理;作者开销、选择开销和恢复开销可能超过被消除调用。对于数学、开放式研究或每次观测都改变语义的任务,可复用动作比例低,HarnessMM 可能只增加记账复杂度。
第二项作者自述局限是公开状态适配器具有任务特异性,小开发集无法稳定确定策略级质量差异。不同提供商的输入计量、缓存和上下文截断也会改变 Token 结论。代码里的守卫只能证明声明条件,不能替代工具语义安全、参数正确性和最终任务评分。
独立判断上,最值得警惕的是“集成标签外溢”。HumanEval、ALFWorld、SearchQA 和 GAIA2 都包含伴随配置,不能把它们的增益全部归因于核心 EDG。论文附录已经主动拆开证据,但二手传播很容易只留下摘要中的 87.93% 和 29.54%。读者应优先看 MBPP 消融,再看各伴随配置的实验总体。
另一个工程问题是全流程摊销。开发成本必须除以真实部署任务数 N。若一个工作流只运行几十次,离线作者和验证成本可能抵消每次执行节省;若运行成千上万次,固定开发成本才会被摊薄。论文保留这一公式,但没有用一个统一的商业部署场景给出盈亏平衡。
论文的负结果同样重要。较紧的 SearchQA 上下文降到 70.54 EM,而新完整上下文 HarnessMM 为 75.46;电子表格状态控制器只有 0.00%,父方法为 1.03% 且成本更低;早期 Terminal-Bench 子集为 8.33% 对 25.00%;视觉网页子集为 25.00% 对 33.33%。GQA 中专用视觉接地指令与等长通用提示的准确率完全相同,MMMU 指令库在零输出上限下也只能节省约 0.366%,低于 10% 目标。
这些话可能削弱摘要中的乐观印象,却使论文更可信。它没有宣称所有任务都能通过“少调用模型”获胜,而是提供了一个何时该复用、何时该回退,以及如何核验调用被删除的机制。
总结与展望
HarnessMM 的核心贡献不是新的语言模型,也不是通用技能库,而是把“已解决动作”从一次性推理轨迹中提取为可执行、可守卫、可认证的承诺。GDR 决定动作何时能执行,CCS 通过原生接口执行并证明指定回调缺席,完整账本则防止把新增调用误算成节省。
对机器人智能体,下一步可以把这一框架扩展到带连续参数和安全约束的动作。机器人动作不像文件路径那样天然离散,抓取位姿、速度和力限制都需要参数闭合条件、公开传感器证据和严格的失败回退。若把视觉观测直接当作守卫,还必须处理遮挡、延迟和分布漂移,不能把一次成功回执当成长期正确性证明。
更现实的应用起点是机器人软件栈中的确定性流程:构建、测试、日志检查、资源加载、设备自检和预设实验序列。它们具备 EDG 所需的精确工具边界和公开回执,也可能产生足够高的重复次数来摊薄作者成本。对于开放世界操作,则更适合把 HarnessMM 作为混合控制器的快速分支,而不是替代全部语义推理。
“省下一次调用”只有在动作仍然精确、回执仍然可信、失败仍能回到慢速推理时,才是一项真正的系统优化。