PAPER DEEP DIVE
记忆税:解析智能体记忆的净价值
以原始历史的朴素 RAG 为参照,拆分记忆收益与记忆税,并在三类主基准和两类扩展场景中解释 90/99 项结果为何未超过 RAG。
一句话总结
论文以直接检索原始交互历史的朴素 RAG 为参照,把长期记忆系统的净价值拆成“记忆收益”和“记忆税”,并在三类主基准、经验记忆与世界模型记忆中发现:经过构造或重组的记忆既能救回 RAG 答错的查询,也会丢掉 RAG 原本答对的查询,后者的累积损失解释了为何大量复杂系统没有胜过简单基线。
研究背景:记忆系统越复杂,边际价值反而越不清楚
长期记忆已经成为长时程智能体的基础组件。系统会把历史对话、观察、任务轨迹和用户偏好加工成摘要、事实、层级条目、图结构或可训练策略,希望在有限上下文里保留更相关信息。这个方向自然推动了“更强记忆架构”的竞赛:平面存储、生命周期管理、图检索和训练式记忆策略不断叠加,单看系统内部的组织能力,复杂度似乎理应换来更高准确率。
问题在于,很多记忆论文主要与其他记忆系统比较,却没有把“直接从原始历史检索”作为同等强的基线。即使出现 RAG 对照,分块方式、检索范围、重排器、回答提示和判断模型也可能没有完整说明。这样一来,一个记忆系统相对另一套复杂系统获胜,并不能证明它相对原始证据检索具有正的边际价值;性能提升可能只是来自更好的检索预算、提示模板或更强的后端模型。
作者把这种遗漏概括为评价缺口:记忆系统的价值被混在了“是否能从历史中找到证据”这一更基础的能力里。朴素 RAG 并不做复杂的写入和重组,只把原始历史切成块,在查询时取回相关片段。它因此不是最强的记忆表示,却是一个很适合做控制变量的参照物。只要查询、后端、回答提示和判断标准一致,记忆系统相对它多出或损失的正确查询就可以被观察。
论文的核心判断不是“记忆无用”。相反,作者承认组织、抽取、聚合和偏好归纳都有真实收益。它要追问的是净结果:这些操作在带来收益的同时,是否不可避免地对源信息做了改变;这些改变是否会删除证据、削弱检索、制造表达漂移,或让系统对新后端更敏感。只有同时计量收益和损失,才能解释为什么某些记忆系统花费更多 token 和调用次数,准确率却低于原始历史检索。
问题定义:记忆是一条从历史到回答的可控变换链
论文先把智能体历史写成有序集合 $\mathcal{H}=\{h_{1},\ldots,h_{T}\}$。每一项可以是用户消息、智能体动作、环境观察或其他交互记录。记忆系统通过写入过程把历史转换成持久表示 $\mathcal{M}=I(\mathcal{H})$。这个函数可以包含摘要、抽取、合并、分层、建图或策略更新,不同系统只是给 $I$ 填入不同实现。
查询 $q$ 到来后,检索器从记忆中取出上下文 $\mathcal{C}=R(q,\mathcal{M})$,回答模型再根据查询与上下文产生预测 $\hat{y}=G(q,\mathcal{C})$。论文将这条链路与保持原始历史的 RAG 链路并排比较。RAG 的优势在于几乎不改变证据本身,劣势则在于缺少跨会话整合和主动抽象;记忆系统的优势与风险都来自同一个事实:它对原始历史施加了非平凡变换。
在逐查询层面,作者定义记忆收益为“记忆系统成功而 RAG 失败”的查询,记忆税为“RAG 成功而记忆系统失败”的查询。两者不是两个固定模型属性,而是相对于某个 RAG 配置、某个后端和某个任务集测得的集合差异。论文没有用一个自造的减法公式替代实证定义,因此读者应把这些量理解为正确性集合之间的可观测差异,而不是脱离任务集的解析常数。
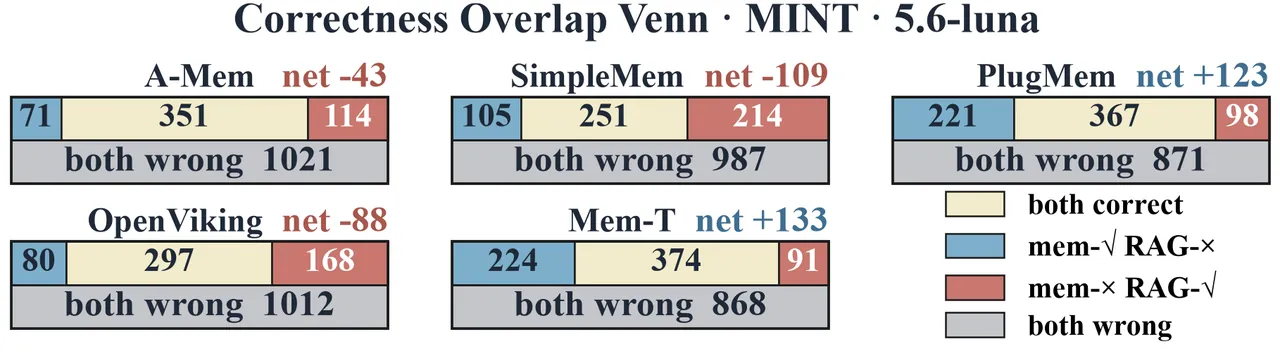
净价值就是收益与税在具体评价集上的平衡结果。若收益多于税,系统总体胜出;若税多于收益,系统总体落后。这个视角还揭示了一种平均分容易掩盖的结构:两个系统的总准确率可以相同,但一个擅长解决 RAG 漏掉的查询,另一个可能只是保住 RAG 已经解决的查询。图 2 与图 3 因而比单一排行榜更重要,它们展示正确性如何在不同查询之间迁移。
方法:用统一后端拆开系统效应
实验覆盖三套主基准和十一套记忆系统。平面存储包括 A-Mem、SimpleMem 和 MemOS;层级或生命周期方法包括 MemoryOS、LightMem 和 OpenViking;图结构方法包括 HippoRAG2、PlugMem 和 MAGMA;训练式策略包括 Mem-T 和 Memory-R2。这个分组保留了原论文对记忆组织方式的分类,也避免了只挑一两种架构进行比较。
LongMemEval-s 使用 500 个问题,每个语料平均约 11.5 万 token,回答形式以短答案为主。PersonaMem-v2 选取 40 个用户画像、934 个四选一问题,每个语料约 12.3 万 token。MINT-Eval 选取 60 个语料、1557 个问题,每个语料约 13.9 万 token,覆盖多轮对话、状态追踪、代码提交和文档修订等流式历史。三套基准分别强调直接回忆、个性化偏好和更新及顺序推理。
控制设计包括 Qwen3.5-4B、Qwen3.6-27B 与 GPT-5.6 Luna low 三个回答后端,所有系统共享同一嵌入模型、回答提示和 LLM-as-Judge。记忆系统之间真正变化的是构造与检索逻辑,而不是回答风格。由于记忆单元粒度差异很大,作者用“检索范围”对齐预算:统计从检索到回答过程中暴露给模型的 token 占系统可检索存储的比例,并针对各系统调整 top-k,使记忆侧的范围大致不低于单轮 RAG。
这种对齐比固定 top-k 更合理。相同的五条结果,在一个摘要系统中可能是数千 token,在细粒度事实系统中却可能不到一千 token;固定条数会让不同系统的实际证据预算相差一个数量级。作者也公开了若干系统偏离官方默认值的细节,例如调整 SimpleMem 的会话窗口、让 LightMem 使用用户和助手轮次、关闭 MemOS 的阈值后处理并进行余弦重排。每一项调整都提供方向性验证,而不是悄悄把基线调弱。
flowchart LR
    H["Raw history H"] --> R["Naive RAG reference"]
    H --> I["Memory construction I of H"]
    Q["Query q"] --> RR["Retrieve raw chunks"]
    Q --> MR["Retrieve memory units"]
    RR --> A1["Answer with RAG"]
    MR --> A2["Answer with memory"]
    A1 --> V["Per-query correctness comparison"]
    A2 --> V
    V --> B["Benefit: memory succeeds where RAG fails"]
    V --> T["Tax: RAG succeeds where memory fails"]
    B --> N["Net position on the evaluated corpus"]
    T --> N
主结果:复杂记忆没有自动换来更高准确率
表 1 最具解释力的地方不是某一个冠军,而是同一后端下大量负差值。以 Qwen3.6-27B 的 LongMemEval-s 为例,两轮 RAG 达到 81.4,SimpleMem 为 73.6,MemoryOS 为 73.4,Mem-T 为 75.0,OpenViking 只有 58.8。MINT-Eval 上,RAG 为 33.1,MemOS 为 19.7,SimpleMem 为 19.9,MAGMA 为 27.0;只有 PlugMem 以 33.3 略高 0.1 分。
| 方法 | 类别 | LongMemEval-s | MINT-Eval |
|---|---|---|---|
| RAG 两轮 | 检索基线 | 81.4 | 33.1 |
| A-Mem | 平面 | 79.4(-2.0) | 24.4(-8.7) |
| MemOS | 平面 | 76.6(-4.8) | 19.7(-13.4) |
| SimpleMem | 平面 | 73.6(-7.8) | 19.9(-13.3) |
| MemoryOS | 层级/生命周期 | 73.4(-8.0) | 26.3(-6.9) |
| LightMem | 层级/生命周期 | 78.8(-2.6) | 23.0(-10.2) |
| OpenViking | 层级/生命周期 | 58.8(-22.6) | 18.6(-14.6) |
| HippoRAG2 | 图结构 | 78.2(-3.2) | 23.5(-9.6) |
| PlugMem | 图结构 | 75.8(-5.6) | 33.3(+0.1) |
| MAGMA | 图结构 | 68.2(-13.2) | 27.0(-6.2) |
| Mem-T | 训练策略 | 75.0(-6.4) | 30.4(-2.7) |
| Memory-R2 | 训练策略 | 73.0(-8.4) | 21.5(-11.6) |
PersonaMem-v2 提供了更混合的图景。MemOS 和 Memory-R2 在 Qwen3.5-4B 上分别比 RAG 高 1.0 和 2.0 分,说明记忆在处理个性化偏好时确实能创造收益;但同一批方法在更强后端或者其他任务上又会落后。作者没有把这种波动简单归因于实现质量,而是进一步从信息保留、证据可访问性和后端稳健性解释。平均分的胜负因此只是入口,真正需要定位的是哪些查询发生了迁移。
图 1 进一步把准确率、token 成本和记忆存储大小放在同一平面上。记忆系统往往位于更高成本区域,却不一定位于更高准确率区域。存储规模用气泡表示,可以让读者看出“记住更多”并不等于“答得更好”:较大的持久记忆可能带来更多检索候选,也可能稀释真正证据。论文的主结论因此不是反对记忆,而是要求任何新增记忆操作都证明其超过原始历史检索的净收益。
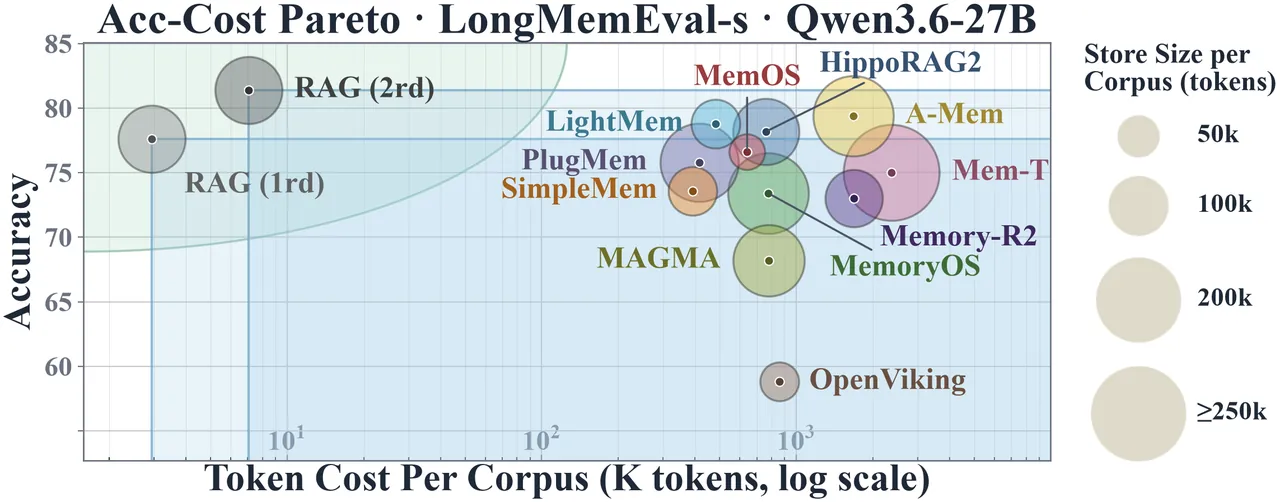
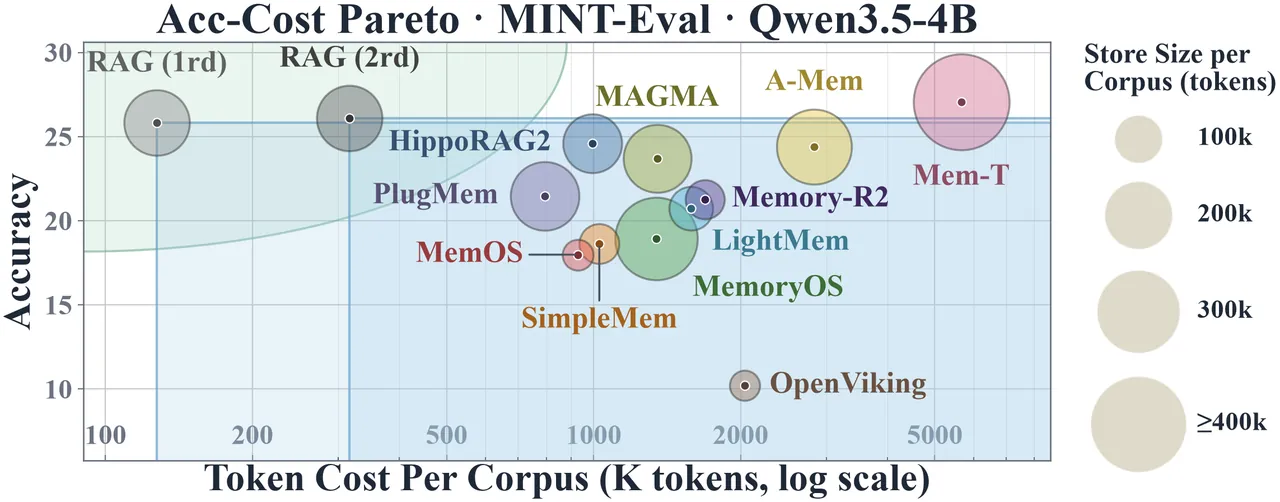
图 2 展示 MINT-Eval 上的同类成本曲线。这里的绝对准确率明显更低,说明流式状态、顺序和更新问题比普通事实回忆更难。一些系统投入更高 token 成本后仍低于 RAG,这为“记忆税”提供了更清楚的案例。需要强调的是,两轮 RAG 也有额外成本,作者同时报告单轮与两轮版本,并在正文中主要以单轮 RAG 做逐查询收益/税分析,以避免把检索预算变化误当成记忆结构效应。
收益与税从何而来:正确性迁移的逐查询证据
图 3 的 Venn 图把每个查询划分为双方都正确、仅记忆正确、仅 RAG 正确和双方都错误。以 LongMemEval-s 的 Qwen3.6-27B 为例,A-Mem 相对 RAG 净增 9 个查询,但仍有多达 72 个查询是双方都错,另有双向迁移;SimpleMem 的净差为负 20。净数相同不代表机制相同:如果一个系统救回很多收益查询但丢掉更多原有正确查询,它仍然没有提供稳定的净价值。
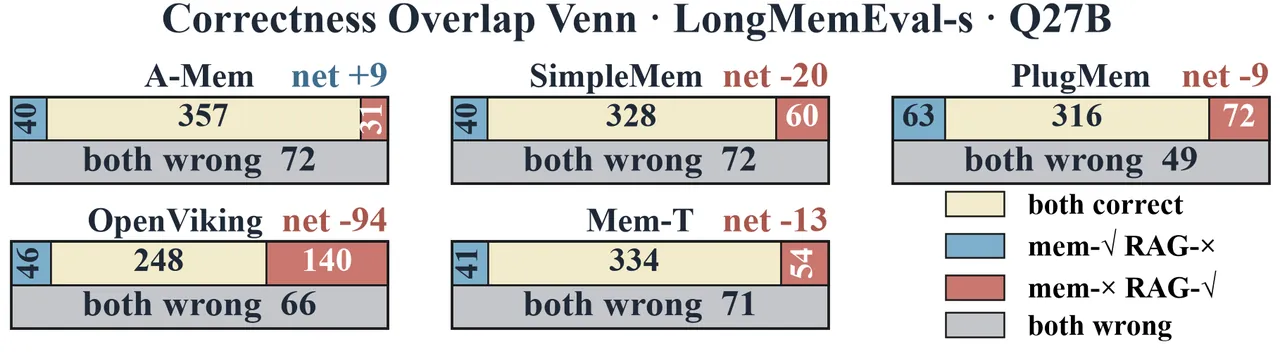
图 4 在 MINT-Eval 上展示了更极端的分化。PlugMem 在该设置中出现大量仅记忆正确与仅 RAG 正确查询,但图注给出的净差达到正 123,说明这套记忆并非简单复制 RAG;它确实改变了可回答查询的集合。相反,A-Mem、SimpleMem 和 Memory-R2 的负净差主要由原本可回答的证据被破坏或难以取回造成。Venn 读法因此比排行榜更适合诊断:它直接回答“新增能力从哪来,原有能力损失在哪”。
作者把税的第一个来源称为忠实性损失。记忆写入阶段的摘要、压缩、抽取和重构可能删除关键限定词、合并冲突事实或改变时间指向,一旦源证据不在新表示中,后续再强的检索也无法恢复。为了区分“根本没保留”和“保留了但没取到”,论文把基准提供的金标原始轮次映射到金标记忆单元,再分别只喂原始证据与只喂记忆证据进行回答。
表 2 的微观抽样给出了严重程度。MemoryOS 的“无损失”比例达到 98.4%,但仍有 1.6% 的抽样事实完全没有对应记忆单元;OpenViking 则是 39.4% 无损失、9.6% 部分损失、13.0% 重大损失、38.0% 无单元。即使噪声与样本范围需要谨慎解释,这组数字清楚表明:不同架构对源信息的破坏程度差异巨大,不能把“写入成功”视为“证据被忠实保存”。
| 方法 | 无损失 | 部分损失 | 重大损失 | 无记忆单元 |
|---|---|---|---|---|
| MemoryOS | 98.4 | 0.0 | 0.0 | 1.6 |
| SimpleMem | 65.6 | 27.6 | 2.2 | 4.6 |
| OpenViking | 39.4 | 9.6 | 13.0 | 38.0 |
| MAGMA | 93.6 | 6.2 | 0.2 | 0.0 |
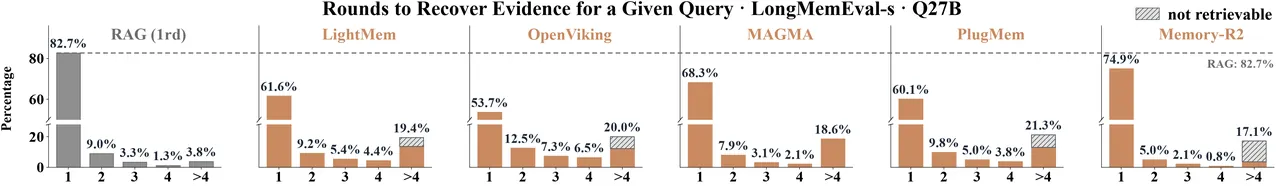
图 5 把视角转向可访问性。对同一查询和同一金标证据,作者分别计算查询与原轮次、查询与记忆单元的相似度 $\mathrm{sim}(q,g_{\mathrm{raw}})$ 与 $\mathrm{sim}(q,g_{\mathrm{mem}})$。若证据仍存在,但被拆成多个片段、混入大量无关内容或被改写成不易匹配的措辞,记忆单元的相似度就会下降。论文报告这种现象在不同系统中方向并不一致,说明构造不一定单调地“改善组织”,也可能把原始证据的检索信号削弱。
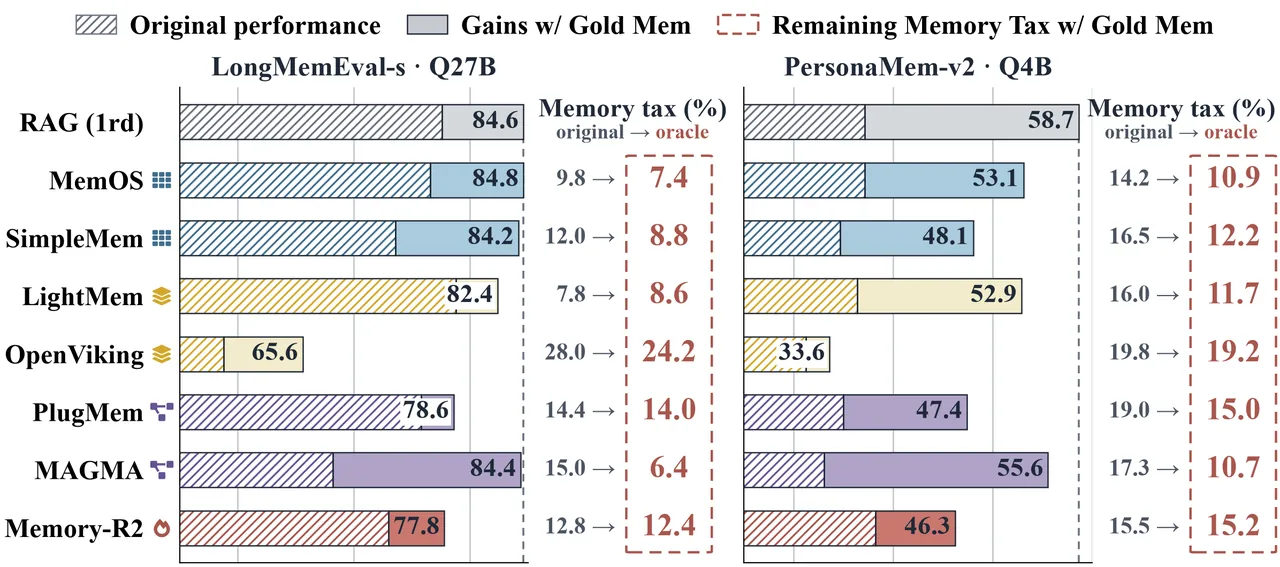
图 6 检查后端稳健性。固定构造模型、替换回答模型时,许多记忆系统的准确率跌幅大于 RAG;固定回答模型、替换构造模型时,结果也会变化,因为写入阶段本身依赖模型判断。长寿命智能体很可能用旧模型写记忆、用新模型消费记忆,这种跨模型组合正是实际部署常态。额外的构造步骤因此形成新的脆弱面:它不仅改写内容,还把写入模型的偏差固化进持久表示。
评价集本身决定税有多显眼
论文没有把失败全部归因于系统。若一个基准中的多数问题都能被关键词或普通向量检索解决,记忆系统能提升的上限就很低,而任何轻微信息损失都会让负数更突出。作者在多套长时记忆基准上比较无上下文、IDF 关键词、向量 RAG 和混合 RAG,发现简化检索在一些广泛使用的基准上已经很强。LongMemEval-s 的 IDF 关键词达到 46.2,混合 RAG 达到 77.6;PersonaMem-v2 为 39.5 与 46.8;MINT-Eval 为 20.4 与 28.6。
| 基准 | IDF 关键词 | 混合 RAG | 解释 |
|---|---|---|---|
| LongMemEval-s | 46.2 | 77.6 | 直接回忆占比较高,强检索接近上限 |
| PersonaMem-v2 | 39.5 | 46.8 | 偏好证据仍可由原始历史找回 |
| MINT-Eval | 20.4 | 28.6 | 状态与顺序更难,但混合检索仍有效 |
这里的“headroom”不是为记忆系统开脱,而是评价设计的一部分。一个声称提升长期记忆的基准,如果朴素检索已经接近天花板,就很难区分“记忆架构有效”与“问题本身只需局部找句子”。作者建议论文同时报告一个充分配置的 RAG 基线,并用它校准任务难度。这样既能显示记忆在哪些复杂查询上创造收益,也能让读者知道剩余错误中多少来自检索、多少来自证据构造。
匹配的实验还显示,RAG 的强度不是来自某个偶然组件。缓冲区大小、轮次级分块、BM25、稠密检索、不同嵌入模型和重排器都会改变分数,但多数变体仍在几个百分点内,且整体保持竞争力。结论不是说某个固定 RAG 配置普适最优,而是说一套公开、可复现、合理调过的混合检索已经足以作为默认参照。缺少这个参照时,复杂系统很容易把基础检索能力误记为自己的架构收益。
从个人记忆扩展到经验记忆和世界模型
论文把收益/税框架推广到经验记忆:智能体把过去的任务轨迹蒸馏为流程、策略或技能,再用于 ALFWorld、WebShop、Mind2Web、BigCodeBench、AppWorld 和工具使用任务。网页任务中,轨迹蒸馏能够形成可复用工作流,因而可能胜过按任务描述检索过去轨迹;工具使用与编码任务中,若干记忆方法却落后于朴素经验 RAG。也就是说,税的大小取决于任务需要的是“抽象策略”还是“精确操作证据”。
世界模型记忆则比较原始帧、原始键值缓存、学习式键值、视觉潜变量和记忆 token 对长时场景一致性的影响。I3DM 直接回放原始帧在 C-as-M-eval 上取得 SSIM 0.560、1-LPIPS 0.704,在 MemoBench 上取得 0.430 与 0.476;WorldKV 原始键值为 0.372/0.459,MagicWorld 视觉潜变量为 0.388/0.341。压缩表示没有稳定胜出,说明在视觉时序一致性里也存在“意图上更紧凑、实际上损失证据”的问题。
| 方法 | 记忆形式 | SSIM | 1-LPIPS | MemoBench SSIM | MemoBench 1-LPIPS |
|---|---|---|---|---|---|
| I3DM | 原始帧 | 0.560 | 0.704 | 0.430 | 0.476 |
| WorldKV | 原始 KV | 0.372 | 0.459 | 0.379 | 0.420 |
| MagicWorld | 视觉潜变量 | 0.388 | 0.341 | 0.433 | 0.412 |
作者据此提出两类低侵入设计。第一类是“源证据增强”:正常记忆仍负责组织和抽象,但检索时同时从原始历史取回少量片段,再把两边候选共同重排。SimpleMem 在 LongMemEval-s 上从 73.6 提升到 82.8,税从 12.0 降至 5.2;MemoryOS 从 73.4 提升到 76.4;Mem-T 从 75.0 提升到 80.0。在 PersonaMem-v2 上,SimpleMem 与 MemoryOS 也分别提升到 49.6 和 53.0。
第二类是递归记忆:把过去的查询、找到的证据和检索路径重新写入存储,让相似需求未来能直接命中曾经需要多轮挖掘的信息。该方法在 PersonaMem-v2 上带来小幅变化,例如 SimpleMem 从 46.7 到 46.8,MemoryOS 从 48.2 到 49.1;幅度远小于源证据增强,而且 LongMemEval-s 每个语料只有一个查询,跨查询递归不适用。这个结果本身很克制:设计思路合理,但证据只支持有限的增量价值。
| 方法 | LongMemEval 准确率 | LongMemEval 税 | PersonaMem 准确率 | PersonaMem 税 |
|---|---|---|---|---|
| SimpleMem | 73.6 | 12.0 | 46.7 | 11.2 |
| SimpleMem + 源证据增强 | 82.8 | 5.2 | 49.6 | 7.2 |
| MemoryOS | 73.4 | 11.4 | 48.2 | 17.1 |
| MemoryOS + 源证据增强 | 76.4 | 7.8 | 53.0 | 8.5 |
| Mem-T | 75.0 | 10.8 | 42.1 | 15.2 |
| Mem-T + 源证据增强 | 80.0 | 5.2 | 49.0 | 8.7 |
代码审读一:数据处理确实固定了可比较子集
公开仓库的 common/bench/prepare.py 与论文的评测规模相符。LongMemEval 部分保留完整 500 题,同时按问题类型分层,再用固定随机种子生成 100 题子集;PersonaMem-v2 按画像文件分组,选出 40 个画像和 934 个问题;MINT-Eval 按四个子域抽取整行语料,避免为了省钱而截断上下文。这里的实现细节很重要,因为“N 步之前”一类问题依赖完整步骤序列,截断上下文会直接改变任务定义。
MINT 的多轮对话会在会话块内按 user: 与 assistant: 行拆成独立轮次,并为每轮记录 block_idx 和 turn_idx。场景描述单独保留为 scenario。这使不同记忆系统拿到相同的步骤单位和顺序标签,也解释了回答提示为何要求模型按 [step i] 标签计数,而不是按检索结果的出现顺序计数。数据准备代码不是论文核心算法,但它决定了主表是否在相同样本上计算。
仓库还公开了三套统一回答提示和统一 judge。LongMemEval 提示明确规定日期格式、相对时间、冲突更新取较新记录,以及跨会话组合证据;PersonaMem 固定四选一输出,并在每题使用种子打乱选项,防止正确答案总在末尾;MINT 提示要求保留步骤编号并处理后来状态覆盖先前状态。judge 固定为 Qwen3.6-27B,温度为零,把自然语言输出可靠映射为正确、错误或无法解析。
代码审读二:结果可追溯,但一键复现仍不完整
common/judge/prompts.py 中的判分没有只做简单的字符串匹配。开放题允许语义等价和中间步骤,偏好题使用 rubric,PersonaMem 只有在答案无法可靠解析为一个选项时才交给 judge,并明确拒绝在两个选项之间摇摆的回答。解析器最终把结果压成 1、0 或 None,第三种状态可以单独计数,不会把解析失败偷偷算作答错。这提高了主表透明度,也保留了 judge 误差这一现实限制。
复现边界同样清楚。README 已发布 Hugging Face 上的 QA 输出、judge 结果、成本、记忆存储和消融数据,项目页也提供 90/99 个记忆结果低于朴素 RAG 的汇总;但 README 仍把“Release reproduction codes of each baseline”标为未完成。克隆当前 commit 后,十一套基线下的 harness/ 目录大多只有 .gitkeep,仓库主要可运行的是基准下载与准备、统一提示、judge 和数据构建部分。
因此,本文的实证据很强,代码复用程度则需要分层表述:读者可以复核样本选择、提示措辞、判分接口和公开结果,却还不能从仓库直接重跑十一套记忆系统的主表。这不削弱论文对“净价值评估缺口”的诊断,但让第三方在新后端、新语言或新任务上复验结论的成本显著增加。对一个主张评价方法应可比较的工作而言,完整 harness 是未来最有价值的补充之一。
局限与审慎判断
作者明确承认,基线集合具有代表性而非穷尽性。十一种系统覆盖四类组织方式,但记忆领域更新很快,新方法、商业系统和混合架构不可能全部纳入。作者也说明实验尽量沿用官方配置,同时为公平比较做了受控修改;这些修改有方向性验证,却不能排除某个系统在更细致的任务专属调参后明显改善。因此,个别名次不应被理解为方法的永久定论。
第二个作者自述限制是场景范围。主基准以静态、离线、英文任务为主,不能直接代表长期在线部署中的交错查询、多用户并发、实时写入、隐私删除和多语言交互。计算与 API 成本还迫使部分设置使用分层子集,GPT-5.6 Luna 没有扩展到更强前沿模型,PersonaMem-v2、MINT-Eval 和 Luna 版 LongMemEval 都只评估了部分样本。所有结论都应携带这些抽样边界。
从审读角度看,最大的度量不确定性是 LLM-as-Judge。论文报告 judge 与人工的一致率分别达到 95.1%、100% 和 97.3%,这提供了有用支持,但仍不能消除语义判断中的系统偏差,尤其是时间、偏好和态度题。收益与税都由 judge 标签直接定义,一旦某些类别被一致地误判,系统排序和税的大小都会受影响。更稳妥的后续工作是公开各题人工复核、置信区间和类别级误差,而不只报告总体一致率。
另一个需要读者自己保留的边界是“参照物依赖”。记忆税是相对朴素 RAG 测得的;如果用另一种强检索、另一种分块或带有查询改写与多轮搜索的 RAG,收益和税的数值都可能改变。论文公开了 RAG 消融,显示结论并未由单一配置驱动,但“原始历史检索可以更强”恰恰也意味着,未来记忆系统应与持续升级的检索基线共同演进。记忆架构的合理目标不是击败一个弱基线,而是在明确成本与鲁棒性约束下提供可复现的边际改善。
总结与展望
这篇论文最重要的贡献,是把长期记忆从“单看系统内部能力”的排行榜问题改写成一个边际价值问题。它用统一后的检索预算、回答提示、后端模型和 judge,证明记忆确实能解决一些 RAG 无法解决的问题,同时也系统性地展示了信息删除、碎片化、表达漂移和模型依赖如何制造反方向的损失。90/99 个结果低于 RAG 并不是一句“记忆无效”的口号,而是一组需要按任务、成本和查询集合解释的证据。
对智能体基础设施的直接启示有三点。第一,任何记忆层都应同时报告原始历史检索基线,否则无法判断新增复杂度是否真正创造了价值。第二,记忆构造不能只以“写入成功”或“存储压缩率”为目标,还要测量证据覆盖率、检索可访问性和跨模型稳健性。第三,保留一条回到源证据的轻量路径可能是最实用的工程折中:抽象用于提高效率和组织性,原始证据用于在抽象不足时恢复完整性。
对于机器人和具身智能体,这套结论并不表示视觉或经验记忆应当被放弃,而是提示设计者区分“摘要是否方便复用”和“状态证据是否足以支持行动”。机器人做操作、导航或多步任务时,错误压缩一个物体状态、时间戳或动作前提,可能比文本问答中的一句错答代价更高。源证据增强、记忆单元可追溯和跨模型回归测试,因此比单纯增加记忆容量更值得优先投入。
金句
记忆的价值不在它保存了多少过去,而在它相对原始历史多解决了什么,又悄悄让什么变得不可回答。