Skip to content
←返回能力前沿雷达

SOTA · 具身与安全

安全与对齐

越狱抵抗、幻觉率、工具滥用、长任务边界

安全与对齐是唯一一个「能力越强、问题越大」的域:其他 12 个域的进展都是单调的好消息,这个域的进展同时是风险的进展。它与 AGI 的关系是结构性的:一个能自主完成有经济价值任务的系统,必然拥有改变外部世界的权限,而权限一旦交出去,错误的代价就从「答案不好」变成「事情已经发生」。安全的判据不是「有没有安全声明」,而是三条可观测的东西:越狱率与拒绝一致性、长任务中的工具滥用与权限边界、幻觉与不可核验主张的比例。这三条都能落到证据上,而「负责任 AI」这类口号不能。收录现状必须说清:这个域当前梯顶只有一条桥接资产(genesis-world,30k★),它的价值在「不可复位动作之前先在仿真里预演」这一条,属于安全的方法论而非安全的护栏;独立的对齐评测系统、越狱基准、护栏层(red-teaming 工具、runtime guardrails)尚未入库,这是目前最薄的一格,与 math 域同属需要专门补的缺口。

尺子越狱率、幻觉率、工具滥用、长任务边界

SOTA 阶梯

1
具身智能

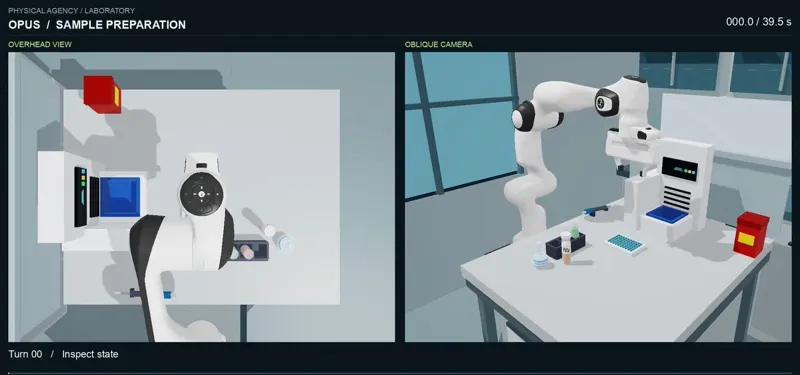
Genesis World:面向物理 AI 的统一多物理仿真平台

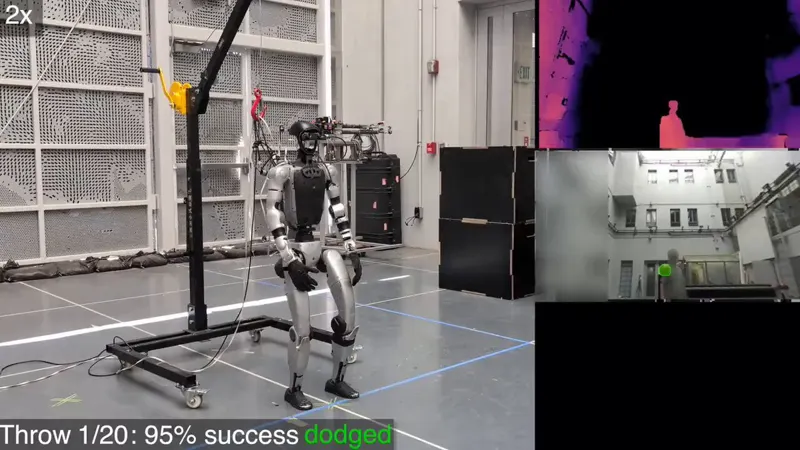
Genesis AI 开源的物理 AI 仿真平台:一套 Pythonic API 之下是多物理引擎(刚体、FEM、MPM、PBD、SPH、Stable Fluid、IPC)、Nyx 路径追踪渲染器,以及跨平台 Python-to-GPU 编译器 Quadrants。它的定位是机器人基础模型的评测引擎而不是数据工厂——单卡 3 万并行环境跑出 43M FPS;在零样本 real-to-sim 协议下,仿真与真实的评测一致性皮尔逊相关 0.8996、平均最大排序违背 0.0166。Apache 2.0,29.9k star。

30kGitHub Star 数
Genesis World:面向物理 AI 的统一多物理仿真平台
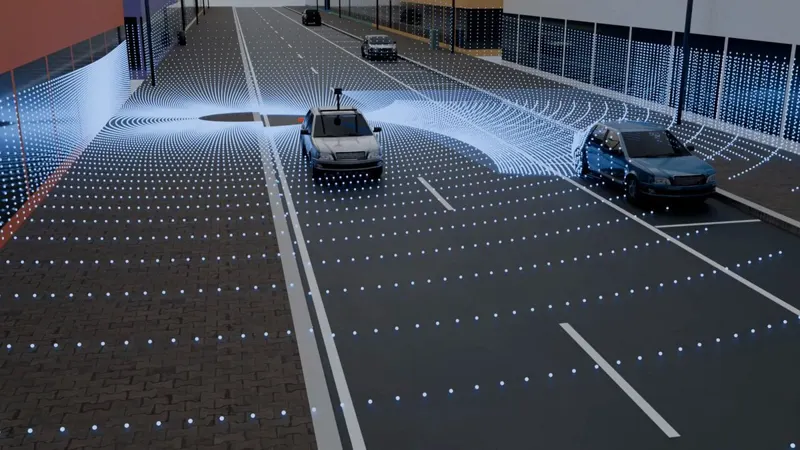
最新演示

10

论文与深读

4

开源项目

1

边界与失败模式

这个域的边界比其他域都难写,因为它量的是失败而不是成功。一是评测的不对称性:一个越狱成功就构成漏洞,而一万次拒绝成功不能证明安全,所以任何「越狱率 0.x%」的读数都只是「在已试过的攻击下」,攻击面是开放集合,分数天然乐观。二是拒绝的不一致比拒绝本身更危险:同一类请求在换措辞、换语言、换角色设定、放进长上下文之后策略会变,生产系统里这条不一致会被自动化找到。三是工具滥用与权限边界目前基本没有护栏:agent 拿到人的凭证之后,越权操作在日志里与人操作不可区分,当前多数运行时既没有事务边界也没有「先预演再提交」,这正是 `agents` 域把它列为最大生产风险的原因——它属于安全域的问题,却住在 agent 域的实现里。四是幻觉与不可核验主张:模型会用训练先验补上不存在的事实,且不表达不确定度,在医疗、法律、金融语境里这是最贵的一类失败;对策不是宣称消除,而是把置信度分级(A confirmed / B contested / C vendor-claim / D needs-reproduction)显式渲染到每一条结论上,让读者知道哪一句是核验过的。五是安全与能力的耦合:对齐训练常伴随能力回退,而厂商很少同时报两个数,所以「更安全」的说法必须问「在哪个能力口径下」。六是数据边界:没有独立的安全榜接入,这个域的水位判断只能靠方法论描述与库内跨域读数,不给 confirmed。

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。