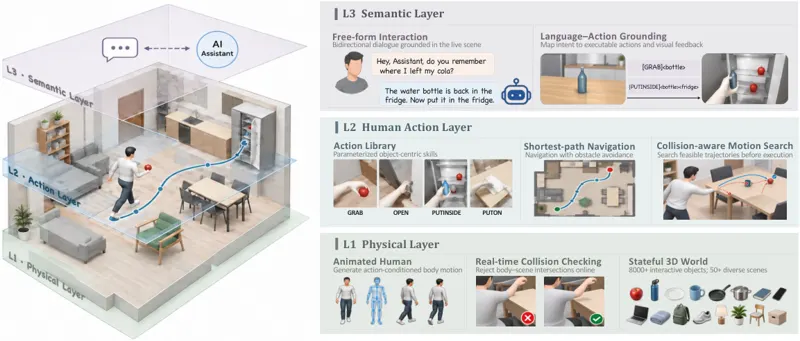
Meta 与 Duke 提出 InteractiveWorld:首个可验证的人—助手闭环交互环境。助手共享用户的第一人称视角,用自然语言给出指导;由 MLLM 驱动的人类智能体把指导落成 36 个动作原语之一,Isaac Sim 执行动作、更新世界状态并渲染下一段视角。在其之上构建 InteractiveBench:6 类共 120 个人工复核的多轮任务,成败由最终物体状态自动判定,不靠文本评判。12 个前沿 MLLM 的评测显示,最强的 Claude Fable 5.1 也只通过 41.7% 的任务,长程 Guidance 与 Planning 仅 20.0% 与 25.0%;失败任务的首个错误中 70.4%—85.7% 来自视觉感知与记忆。
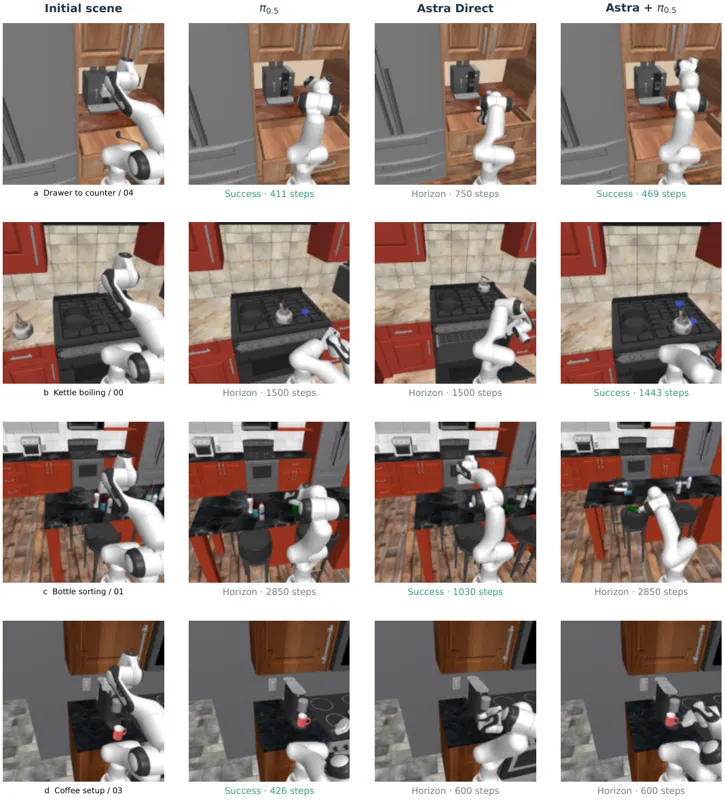
六域评测GPT-6 Astra具身策略:混合控制RoboDojo成功率48%、导航RxR达92%,但手内操作与密集步态仍不可靠,推理延迟制约实用控制。
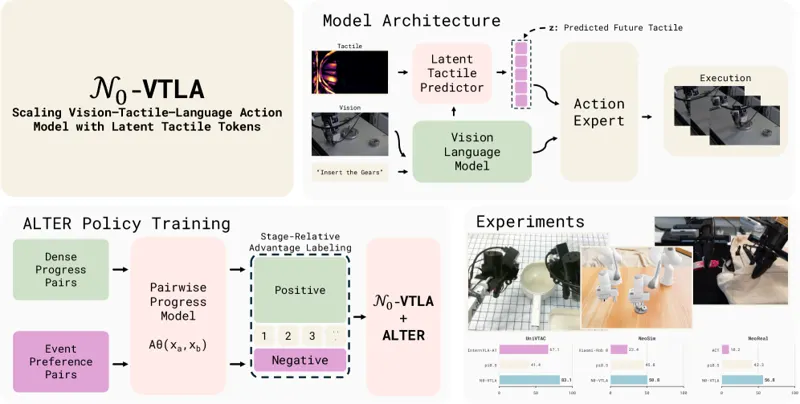
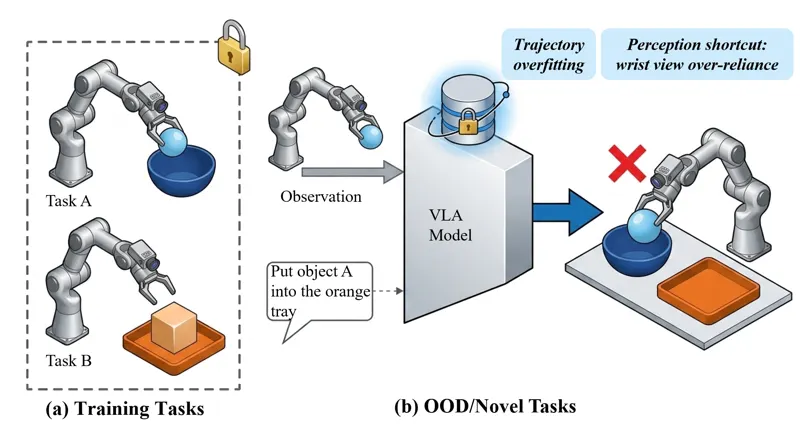
提出N0-VTLA,通过潜在触觉token扩展视觉-触觉-语言-动作模型,在视触觉多模态VLA上实现大规模训练与contact-rich任务能力。
提出通过可行动作映射桥接强化学习与最优控制的方法,在RL探索与最优控制约束间建立映射,提升机器人控制的稳定性与可解释性。
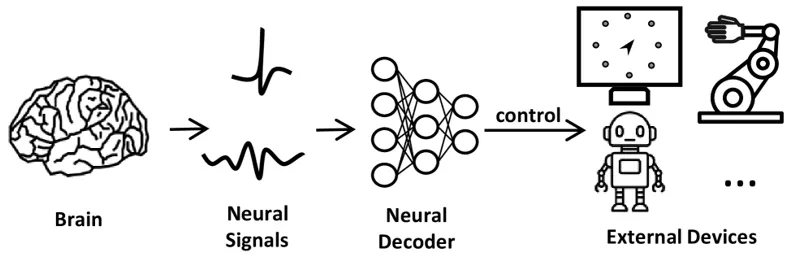
提出自监督一致性增强的解耦学习方法,用于神经解码,提升脑机接口等场景下神经信号解码的鲁棒性与泛化。
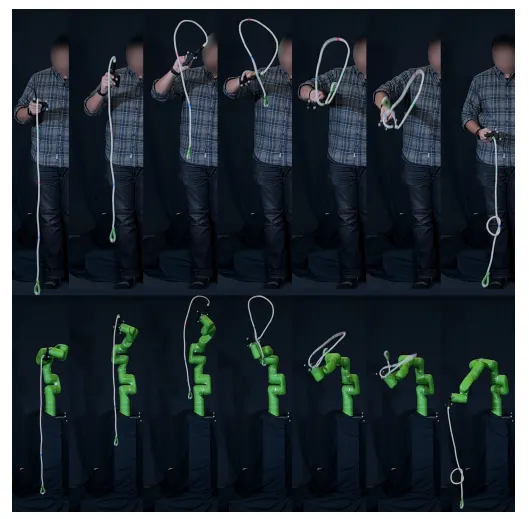
提出绳驱机器人的移动时域估计与非线性模型预测控制方法,处理绳驱系统的柔性与时变特性,提升轨迹跟踪精度。
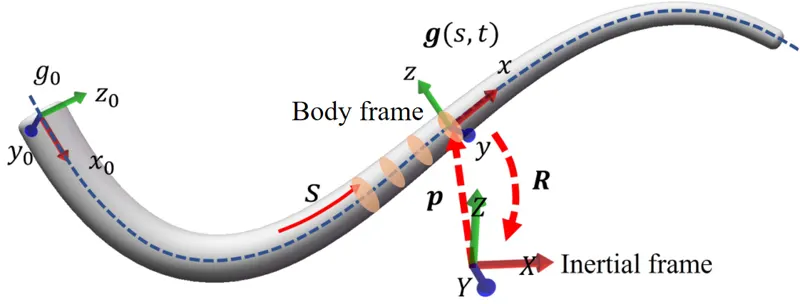
将重正化思想引入机器人学,从无穷维到有限维分析有效参数与真实行为的关系,为机器人动力学建模提供理论框架。
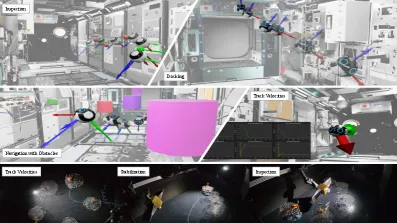
提出基于超网络的自适应多任务制导、导航与控制学习方法,在多任务间共享与特化策略,提升无人机/机器人多任务GNC的效率。
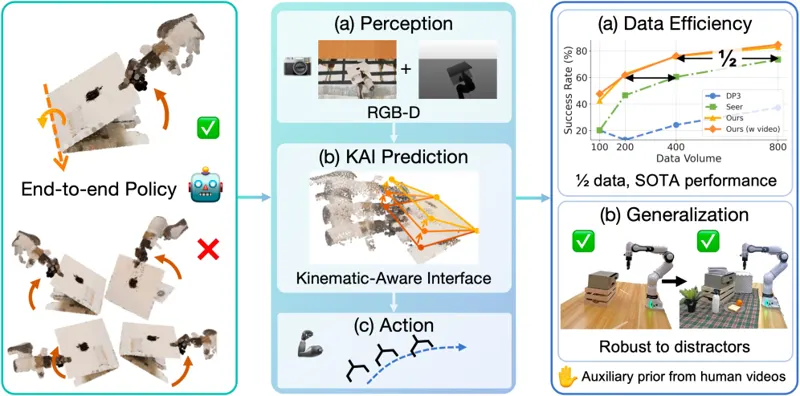
提出KAI运动学感知接口,通过运动学先验提升铰接物体操作的数据效率,降低机器人操作策略的样本需求。
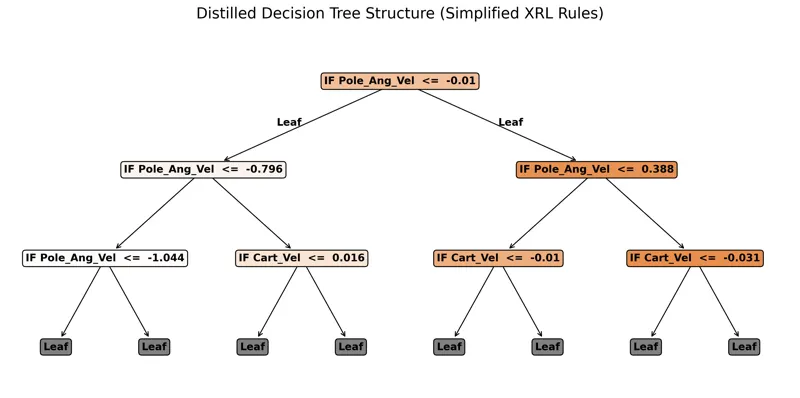
提出物理感知策略蒸馏方法,将物理先验蒸馏进RL策略,提升强化学习的可解释性与鲁棒性,服务于机器人控制。
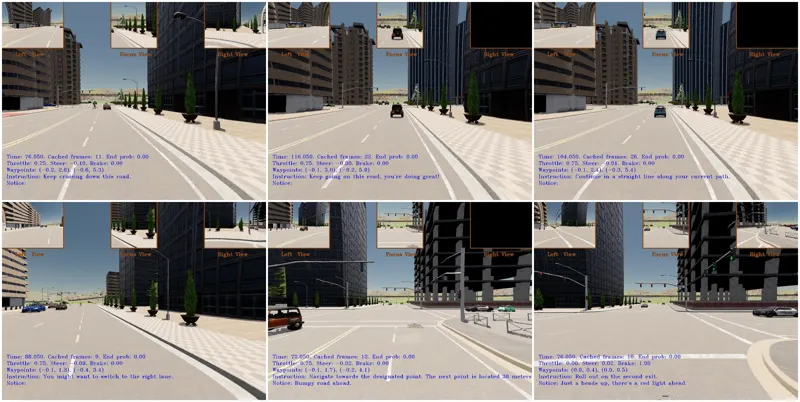
综述自动驾驶仿真测试方法,涵盖仿真平台、测试策略和有效性评估。
利用仿真进行触觉感知推断,支持接触丰富的机器人操作。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。