PAPER DEEP DIVE
T2-z:面向机器人世界模型的环境潜变量测试时优化
T2-z 将机器人世界模型拆为共享动力学与环境潜变量,并从少量真实交互中测试时更新环境表示。
一句话总结
T2-z 把机器人世界模型分为共享动力学与紧凑环境潜变量,并在测试时冻结模型,仅用少量真实交互直接优化环境潜变量,从而让同一套动作预测适应摩擦、质量、重力、背景和隐藏规则等未显式说明的变化。
研究背景与问题定位
动作条件机器人世界模型的目标,是给定当前观察和候选动作,预测未来视觉状态以及任务相关对象如何变化。若模型能够在部署前准确模拟环境,机器人就可以在内部比较多个动作,减少真实试错。然而,视觉观察通常只呈现当前场景的一部分属性。物体质量、表面摩擦、关节弹簧刚度、软体材料响应,以及“按下某个开关后灯是否亮起”这类由人设定的隐藏规则,往往不能从单帧图像中稳定读出。相同观察和相同动作因此可能产生不同结果。
论文把这类信息称为环境变化。它不是简单的视觉域差异,而是决定动作后果的动力学条件。只用大量场景联合训练一个动作条件模型,会学到跨环境的平均响应。遇到训练分布之外的摩擦或质量时,平均模型可能生成视觉上合理、物理上错误的轨迹。若要求模型输入物理参数,又需要人工定义参数表、测量设备或环境标签,这会把开放环境压缩成预先写好的有限任务集。
已有路线大致可分为三类。第一类是标准世界模型,不做测试时适应,直接依赖训练分布覆盖目标环境。第二类是模块化系统辨识,先推断预定义物理参数,再把参数送入模拟器。第三类是历史编码器或快速权重方法,用一段交互学习从历史到环境的映射,或更新模型内部的小部分参数。它们都能利用测试时证据,但共同问题是表示空间或适应路径已经由训练目标固定。
T2-z 的出发点更直接:不要预先告诉模型环境里究竟有哪些因素,也不要另学一个从历史序列映射到环境向量的编码器。为每个环境保留一个低维潜变量,使用未来观测预测误差作为唯一监督。只要潜变量能够帮助冻结的世界模型解释当前交互,它就会在优化中形成;不同环境需要不同解释时,潜变量自然会分开。
这一设计把“是否会模拟”与“当前环境是什么”拆开。共享动力学参数负责学习动作如何推动对象、画面如何演化;环境潜变量负责选择或调节当前动力学响应。测试时只更新后者,既避免破坏已经学到的通用模型,也避免把测试时适应变成对整个大型视频扩散模型的微调。
问题形式与流匹配基础
令观察为 x,动作为 a,未来视觉结果为 y,共享世界模型参数为 θ,环境潜变量为 ze。T2-z 建模的是环境条件预测分布:
$$p_{\theta}(\mathbf{y}\mid\mathbf{x},\mathbf{a},\mathbf{z}_{e}).$$
公式中的 ze 没有物理语义标签。模型不知道第一维代表摩擦,也不知道第二维代表质量;它只被要求让预测分布更符合真实交互。
基础世界模型采用流匹配目标。设 yt 是在流时间 t 上的带噪或插值未来观察,ut 是对应目标速度,模型预测速度为 vθ。训练损失为:
$$\mathcal{L}_{\mathrm{FM}}(\theta,\mathbf{z}_{e})=\mathbb{E}\left[\left\|\mathbf{v}_{\theta}(\mathbf{y}_{t},t\mid\mathbf{x},\mathbf{a},\mathbf{z}_{e})-\mathbf{u}_{t}\right\|_{2}^{2}\right].$$
这条公式在说,世界模型应当在每个流时间点给出正确的演化方向。T2-z 的关键并不只是换了一个生成损失,而是把这个损失分别用于更新共享模型和环境潜变量,形成慢速与快速两个时间尺度。
每个训练环境开始时都有一个独立初始化的潜变量:
$$\mathbf{z}_{e}^{(0)}\sim\mathcal{U}(0,1).$$
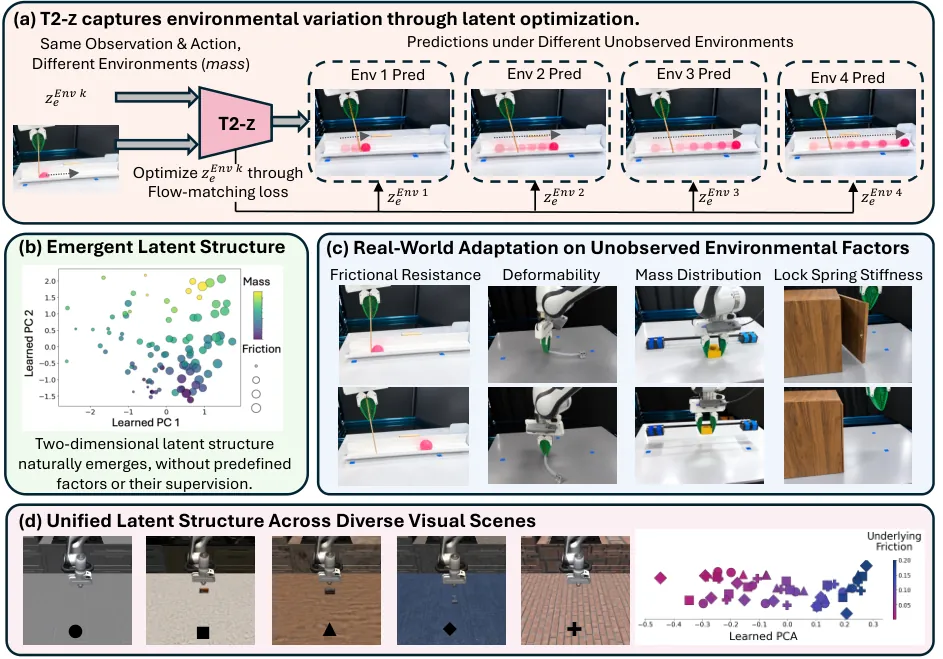
图 1:论文 teaser。相同观察和动作在不同隐藏环境下可能产生不同结果;右侧主成分投影显示,学习到的环境潜变量会按环境差异组织。
方法详解
一、共享动力学与快速环境变量的分离
论文没有把整个世界模型视为一个需要测试时重训的黑箱,而是假设其中大部分能力可以跨环境共享。推动物体、保持物体形状、渲染接触和运动趋势等规律适用于很多场景;真正需要现场确定的是当前场景处于哪一种动力学条件。T2-z 用大模型承载共享部分,用 32 维、单 token 的潜变量承载现场部分。
这种分离不是把潜变量作为普通输入拼接就结束。环境信息会同时进入两条条件路径,一条提供可参与注意力交互的 token,另一条调节扩散 Transformer 的自适应归一化参数。这样,潜变量既能告诉注意力模块“当前有哪些环境线索”,也能改变不同网络层对时间步和动作条件的响应强度。
二、训练阶段一:固定环境变量,学习共享动力学
第一阶段固定所有 ze,只更新世界模型参数。令 De 表示环境 e 下采集的数据,第 k 个外层循环的更新可以写成:
$$\theta^{(k+1)}=\arg\min_{\theta}\mathbb{E}_{e,\,(\mathbf{x},\mathbf{a},\mathbf{y})\sim\mathcal{D}_{e}}\left[\mathcal{L}_{\mathrm{FM}}\left(\theta,\mathbf{z}_{e}^{(k)}\right)\right].$$
这一步要学到的是跨环境共享的动作后果。因为环境变量保持固定,模型不能通过改变环境表示来逃避预测误差;它必须调整自身,使同一套网络能够利用已有潜变量区分不同轨迹。论文从 300 次世界模型更新开始训练,学习率为 10-5。
三、训练阶段二:冻结模型,让潜变量解释环境差异
第二阶段反转优化对象:世界模型冻结,只更新每个环境对应的潜变量:
$$\mathbf{z}_{e}^{(k+1)}=\arg\min_{\mathbf{z}_{e}}\mathbb{E}_{(\mathbf{x},\mathbf{a},\mathbf{y})\sim\mathcal{D}_{e}}\left[\mathcal{L}_{\mathrm{FM}}\left(\theta^{(k+1)},\mathbf{z}_{e}\right)\right].$$
由于模型参数不可变,降低误差的唯一途径是找到更能解释当前环境交互的 ze。若环境中的摩擦使物体比平均水平移动更远,潜变量就朝能让模型复现这种移动的区域移动;若隐藏规则让同一种动作产生相反结果,潜变量也必须编码这一差异。潜变量的学习率为 0.03,明显高于模型学习率,体现快速适应。
两个阶段随后按固定预算交替。论文的默认设置是阶段一和阶段二每次各 200 步。交替训练让模型和潜变量共同进步:模型越准确,潜变量得到的预测误差信号越有意义;潜变量越能区分环境,下一轮模型学到的共享动力学就越纯净。
flowchart TD
    A["Training environments"] --> B["Initialize one latent per environment"]
    B --> C["Stage I: freeze z, update world model"]
    C --> D["Stage II: freeze world model, update z"]
    D --> E{"Alternation complete?"}
    E -->|No| C
    E -->|Yes| F["Frozen shared world model"]
    F --> G["New test environment"]
    G --> H["Collect one or two support trajectories"]
    H --> I["Randomly initialize one test latent"]
    I --> J["40 latent-only flow-matching updates"]
    J --> K["Reuse adapted latent for unseen actions"]
图 2:依据论文第 3 节和算法 1 绘制的训练与测试流程。测试时没有历史编码器,也没有世界模型参数更新。
四、双路径注入:token 与调制分支
论文附录和图 3 给出的接口是:环境潜变量为 32 维单 token,扩散 Transformer 宽度为 3072。编码器包含两个无偏置投影分支,每个分支都执行 32 到 128 再到 3072 的映射,并采用层归一化和 GELU。可以把 token 分支写成:
$$q_{b}(\mathbf{z}_{e})=W_{b2}\operatorname{GELU}(W_{b1}\operatorname{LN}(\mathbf{z}_{e})),\quad b\in\{\mathrm{token},\mathrm{mod}\}.$$
token 分支的输出与动作 token 组成条件序列:
$$C_{e}=[q_{\mathrm{token}}(\mathbf{z}_{e});A_{\mathrm{token}}(\mathbf{a})].$$
这使环境 token 能与动作和视觉 token 一起参与跨注意力。调制分支则把环境嵌入加到时间步和动作调制上:
$$\tilde{\mathbf{b}}_{t}=\mathbf{b}_{\mathrm{time}}+\mathbf{a}_{\mathrm{mod}}+q_{\mathrm{mod}}(\mathbf{z}_{e}),\qquad M=\operatorname{TimeProj}(\tilde{\mathbf{b}}_{t}).$$
最终得到六组自适应归一化向量。直观地说,token 路径改变网络“看什么条件”,调制路径改变网络“以多强的响应处理这些条件”。两条路径共享同一个环境潜变量,但使用独立投影,避免一种注入方式被迫兼顾两种完全不同的功能。
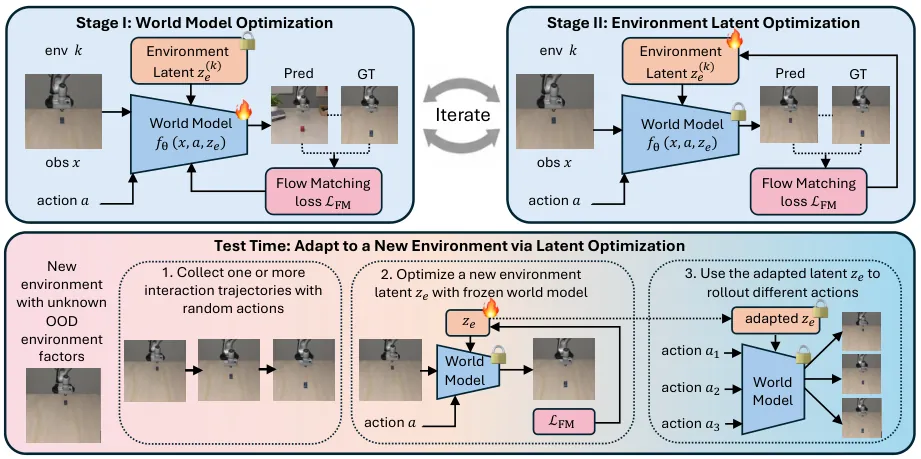
图 3:论文框架图。训练时交替优化共享模型和环境潜变量;测试时只优化新潜变量,随后将其复用于新动作预测。
五、测试时优化为什么不需要历史编码器
测试环境提供一组支持交互:
$$\mathcal{D}_{\mathrm{test}}=\{(\mathbf{x}_{i},\mathbf{a}_{i},\mathbf{y}_{i})\}_{i=1}^{N}.$$
模型从随机初始化的测试潜变量开始,在冻结参数 θ* 下执行梯度下降:
$$\mathbf{z}_{\mathrm{test}}^{(s+1)}=\mathbf{z}_{\mathrm{test}}^{(s)}-\eta_{z}^{(s)}\nabla_{\mathbf{z}_{\mathrm{test}}^{(s)}}\frac{1}{|\mathcal{D}_{\mathrm{test}}|}\sum_{(\mathbf{x},\mathbf{a},\mathbf{y})\in\mathcal{D}_{\mathrm{test}}}\mathcal{L}_{\mathrm{FM}}\left(\theta^{*},\mathbf{z}_{\mathrm{test}}^{(s)};\mathbf{x},\mathbf{a},\mathbf{y}\right).$$
与摊销式编码不同,这里没有固定长度的历史输入,也没有训练好的历史到环境映射。支持轨迹数量可以随现场证据变化;一条轨迹不够时可以增加,证据很多时也可以对损失取平均。优化本身在寻找“哪一个环境表示最能解释当前数据”,而不是把数据压缩进一个事先学好的统计量。
测试时采用粗到细学习率:3.0、1.5、0.5、0.15,每档 10 步,总共 40 步。较大步长先让潜变量进入正确区域,较小步长再减少抖动。论文在 7 个仿真任务中的 6 个只用一条支持轨迹,在 Light Switch、Mass Balance、Door Close 和 Stick Balance 四个较难任务中使用两条。
六、测试潜变量的复用
完成适应后,潜变量不是只对支持轨迹有效。给定未在支持集中出现的动作 a',预测为:
$$\hat{\mathbf{y}}'\sim p_{\theta^{*}}(\mathbf{y}\mid\mathbf{x},\mathbf{a}',\mathbf{z}_{\mathrm{test}}^{*}).$$
这一步是方法能否作为世界模型使用的关键。若潜变量只是记住了支持动作,它无法帮助动作选择;论文的结果表明,适应后的潜变量可以迁移到候选动作,使模型针对当前环境的摩擦、质量或规则比较不同动作的未来。
七、代码与论文的对应关系
公开代码中的 wan_video_action/models/physical_context.py 提供了环境上下文编码器。第 52 至 75 行定义上下文维度、token 数量、默认上下文和两个独立投影器;第 128 至 144 行分别产生 token 嵌入与调制嵌入。这与论文中的双路径设计一致。
self.token_projector = BiasFreeMLP(
    context_dim, hidden_dim, model_dim,
    input_norm=input_norm
)
self.mod_projector = BiasFreeMLP(
    context_dim, hidden_dim, model_dim,
    input_norm=input_norm
)
token_emb = self.token_projector(context)
mod_emb = self.mod_projector(context)
t2z/inference/ours.py 的第 505 至 594 行实现测试时适应:冻结世界模型组件,将上下文设为可训练参数,按支持样本计算流匹配损失,再使用当前学习率更新上下文。第 585 至 590 行明确执行梯度缩放、上下文步进与可选裁剪。
context = context0.clone()
context = context.requires_grad_(True)
support_loss = getattr(torch.stack(support_losses),
                       support_loss_reduction)()
context = _clamp_context(
    context - float(inner_lr) * context_grad,
    args,
).detach().requires_grad_(True)
代码配置中常见的 physical_context_dim: 32、physical_context_tokens: 1 和 physical_context_mode: both 对应论文的紧凑潜变量与双路径条件。需要注意,公开配置会按任务调整初始化、上下文学习率和支持轨迹数量,因此不能把某个单独配置文件当作论文全部实验参数的完整复刻;但 32 维、单 token、双分支和潜变量更新这些核心接口在代码中是稳定可查的。
八、方法有效的核心原因
第一,预测误差比人工物理标签更通用。模型不必事先知道环境因素是连续摩擦、离散规则还是两者的组合,只要该因素会改变未来观测,它就能通过流匹配损失影响潜变量。第二,冻结共享模型使测试时优化只搜索低维空间,参数规模从数十亿级模型权重缩减到 32 维变量。第三,显式潜变量比更新 LoRA 或快速权重的干预范围更小,也更容易在不同动作间复用。
这一方法也有明确边界。它要求测试时能够获得动作和对应结果,且这些结果对未来预测有信息量。若支持轨迹太短、动作变化不足,或者真实世界噪声淹没了预测误差,单条轨迹可能不足。论文用两条轨迹处理较难任务,并显示性能在所选轨迹数后趋于饱和,但这些选择仍然依赖任务。
实验设计与主要结果
仿真部分包含七个设置:摩擦、重力、质量碰撞、灯光开关、质量平衡、质量与摩擦联合变化,以及跨 30 种视觉背景的同摩擦任务。前几项考察连续物理量,Light Switch 考察人为设定的离散交互规则,联合因素考察模型能否在不被告知因素数量的情况下形成二维结构。真实世界包含四类任务:门关闭、球体摩擦、木棍平衡和软体拉动。
评价指标覆盖任务相关物理误差、最终帧误差、感知指标 LPIPS、峰值信噪比 PSNR 和动作成功率。物理误差不是单一通用单位:仿真中摩擦、重力、质量碰撞、联合因素和背景任务使用像素误差,Light Switch 使用灯光状态得分误差,Mass Balance 使用角度误差;真实世界使用跟踪状态像素误差。因此,表格中的平均值用于整体比较,但单项数值不能脱离任务定义解释。
仿真主结果
| 方法 | 平均物理误差 | 最终帧误差 | LPIPS | PSNR | 动作成功率 |
|---|---|---|---|---|---|
| 标准世界模型 | 12.8575 | 21.9759 | 0.0574 | 31.185 | 37.9% |
| LoRA 测试时适应 | 9.3496 | 17.5336 | 0.0584 | 30.182 | 44.8% |
| DINOv2 环境上下文 | 8.1546 | 14.8014 | 0.0492 | 31.648 | 51.8% |
| TTT-KQV | 12.9233 | 22.5528 | 0.0585 | 30.815 | 42.1% |
| T2-z | 4.7971 | 7.6682 | 0.0430 | 31.760 | 74.2% |
表 1:论文表 1 的七任务平均值。T2-z 相对标准模型将平均物理误差降低约 62.7%,动作成功率提高 36.3 个百分点。
从平均值看,提升并不只来自视觉画质。T2-z 的 LPIPS 最低,但 PSNR 只比标准模型高 0.575 分贝,说明其优势主要体现为任务相关对象位置、状态和最终配置更正确,而不是单纯更接近每个像素。对于世界模型,这种指标组合比单独追求 PSNR 更符合动作选择的用途。
单任务差异也很大。摩擦任务中,平均物理误差从 11.0626 降至 3.8540,动作成功率从 32.0% 升至 72.0%;质量碰撞从 21.9329 降至 6.4522;Mass Balance 的角度误差从 1.1844 度降至 0.6403 度,成功率从 40.0% 升至 80.0%。这些任务都需要从后果反推不可见条件,说明潜变量确实承载了任务相关动力学信息。
DINOv2 环境上下文是强基线,其仿真平均值优于 LoRA 和 TTT-KQV,但仍明显落后 T2-z。在重力任务中,DINOv2 的平均误差为 5.9300,优于 T2-z 的 7.3408,动作成功率为 76.5%,也接近 T2-z 的 82.4%,说明 T2-z 并非在每个单项上都占优。摊销历史编码在部分单因素任务上可以很有竞争力,T2-z 的主要优势仍体现在跨任务平均和更复杂的组合变化上。
真实世界结果
| 方法 | 平均跟踪误差 | 最终帧误差 | LPIPS | PSNR | 动作成功率 |
|---|---|---|---|---|---|
| 标准世界模型 | 19.30 | 38.24 | 0.05194 | 32.80 | 26.47% |
| LoRA 测试时适应 | 19.27 | 34.42 | 0.04931 | 32.93 | 43.97% |
| DINOv2 环境上下文 | 17.50 | 32.04 | 0.04788 | 33.41 | 31.86% |
| TTT-KQV | 18.10 | 35.85 | 0.04694 | 33.66 | 36.24% |
| T2-z | 10.85 | 16.66 | 0.04341 | 33.24 | 70.80% |
表 2:论文表 2 的四项真实机器人任务平均值。T2-z 将平均跟踪误差降低 43.8%,最终帧误差降低 56.4%,动作成功率提升 44.33 个百分点。
真实世界平均结果比仿真更能支持方法动机。标准模型平均成功率只有 26.47%,T2-z 达到 70.80%。Stick Balance 从 20.00% 提升到 83.33%,说明在接触和平衡受附加质量影响时,现场潜变量优化能改变动作选择。门关闭任务从 22.22% 提升到 55.56%,最终误差从 41.22 降至 13.47,表明潜变量并非只对连续摩擦有效,也能响应弹簧锁刚度等机械条件。
论文没有掩盖 Soft Pull 的反例。T2-z 的平均误差为 18.71,略差于 TTT-KQV 的 18.23;它的 LPIPS 0.07580 也不如其他方法。不过 T2-z 的最终帧误差为 23.59,优于 TTT-KQV 的 29.69,动作成功率为 81.82%,也高于 72.73%。这说明软体形变的逐帧平均视觉误差不适合作为唯一判断,动作结果和最终状态可能更重要,同时也提醒读者不能把方法描述为所有指标上的全面胜利。
潜变量结构与定性结果
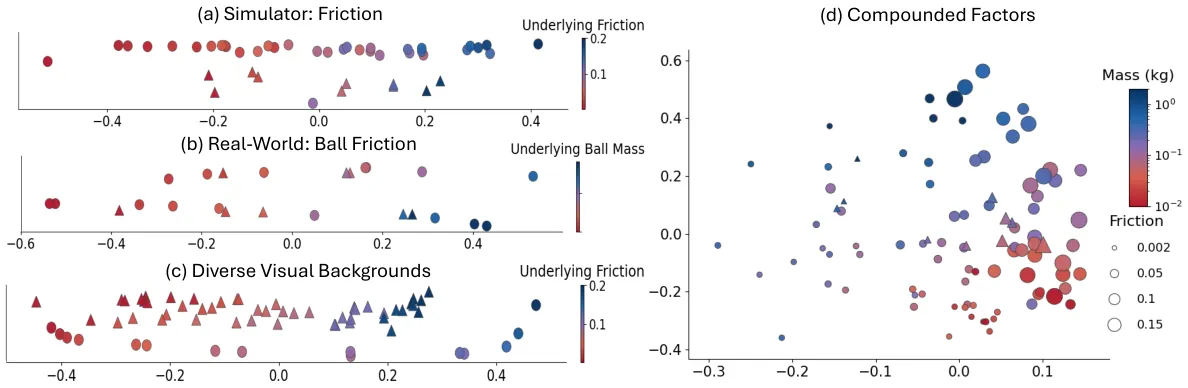
图 4:论文对学习到的环境潜变量做二维主成分可视化。颜色和形状只用于阅读,训练时没有提供对应物理值。
图 4 是方法解释力最强的一组证据。仿真摩擦任务中,潜变量沿主成分形成一维有序结构,颜色对应的摩擦值沿同一方向变化;真实世界摩擦任务也呈现清晰结构。更有意义的是,跨 30 种背景的同一摩擦变化没有按图像外观分群,而是共享同一潜在组织;当质量和摩擦同时变化时,二维投影近似形成两条轴,虽然模型从未被告知存在两个因素。这些图不证明潜变量具有唯一或完全解耦的物理语义,但能支持“预测误差足以塑造结构化表示”的论点。
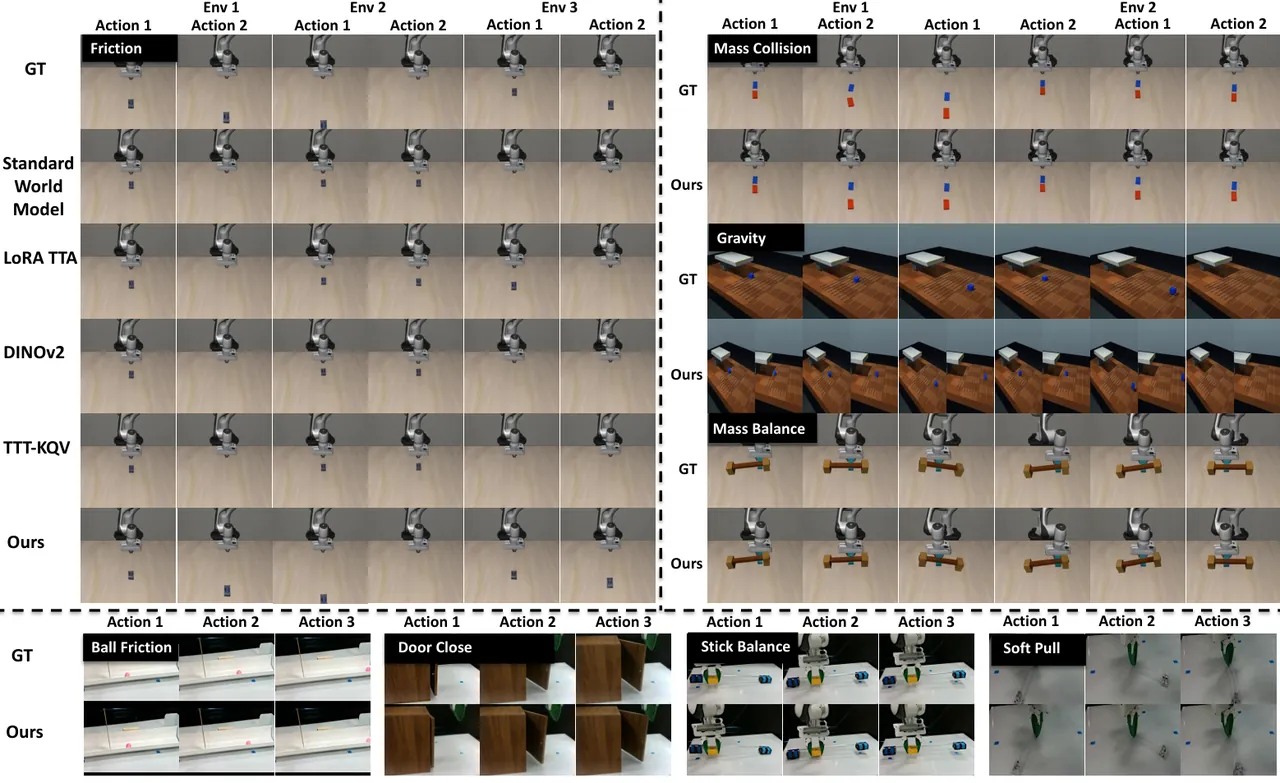
图 6:同一组动作在不同环境下的定性预测。T2-z 更接近真实最终配置,基线更容易产生随机运动或错误停止位置。
消融实验
| 变体 | 平均误差 | 最终误差 | LPIPS | PSNR | 成功率 |
|---|---|---|---|---|---|
| T2-z | 3.85 | 7.59 | 0.0495 | 31.976 | 72% |
| 模型与潜变量联合训练 | 7.03 | 15.66 | 0.0657 | 31.203 | 68% |
| 直接优化 3072 维 token | 94.50 | 80.49 | 0.7626 | 15.218 | 24% |
| 32 维随机初始化 [-0.05, 0.05] | 4.81 | 9.73 | 0.0495 | 32.172 | 60% |
| 交替预算 100/100 | 5.41 | 11.50 | 0.0484 | 32.208 | 56% |
| 交替预算 400/400 | 4.31 | 8.80 | 0.0507 | 32.430 | 68% |
表 3:论文表 3 的进一步消融。直接优化完整 3072 维条件 token 显著失败,支持低维瓶颈而非任意大容量变量。
最醒目的消融是把 32 维环境潜变量替换成直接优化 3072 维 token。平均误差升至 94.50,LPIPS 达到 0.7626,成功率仅 24%。这说明低维瓶颈不是可有可无的压缩技巧,而是防止测试时高维变量过拟合少量交互、破坏共享动力学的重要约束。联合训练同样明显变差,说明“固定一方、更新另一方”的交替分离有效,不能让模型和潜变量同时追逐短期预测误差。
交替预算也有明显权衡。100/100 的误差为 5.41、成功率为 56%,400/400 的误差为 4.31、成功率为 68%,默认 200/200 为 3.85 和 72%。这并不表示更长训练总会更好;不同阶段的步数会改变模型与潜变量的收敛节奏。随机初始化范围从 [0,1] 改为 [-0.05,0.05] 后,平均误差 4.81、成功率 60%,说明初始化覆盖范围和默认上下文附近的可达性会影响优化。
计算代价与交互效率
论文附录在单张 H200 上给出仅计算部分的剖析。当支持轨迹数为 1 时,T2-z 在包含潜变量适应和五次查询生成的条件下耗时 18.09 秒;LoRA TTA 为 32.73 秒,缓存 TTT-KQV 为 37.57 秒。该计时排除了模型和样本加载、数据集读取以及 MP4 写出,因此只能用于比较三类适应流程自身的计算路径,不能当作完整机器人系统的端到端延迟。
交互效率方面,大多数任务只需一条支持轨迹,四个较难设置使用两条。图 5 显示,在所选轨迹数之后性能大体饱和。这是 T2-z 的工程吸引力之一:它没有为每个测试环境重训大模型,而是用几十步低维优化换取环境特化。另一方面,它仍然比完全没有适应的标准模型多出一段迭代优化,在需要极低延迟的闭环控制中必须与预测质量和动作成功率一起权衡。
讨论:这项工作的真正变化
T2-z 把环境适应从“学习一个历史编码器”改写为“为当前环境求解一个潜变量”。摊销方法一旦训练完成,推断是前馈的,延迟低;但编码器必须覆盖训练时见过的交互长度、场景类型和数据分布。直接优化牺牲一部分推断便利,换取测试时根据实际证据调整搜索目标的自由。两者不是简单替代关系,而是部署条件不同。
另一个重要点是慢速与快速参数的职责分离。共享模型学习跨环境不变的动力学,环境潜变量学习当前场景下的变化。测试时冻结前者可以保护通用能力,但若新环境违反共享动力学假设,低维潜变量也无法修复。例如完全陌生的机器人本体、传感器几何或严重遮挡,可能不是环境潜变量能够表达的。方法适合“动力学结构共享、环境条件不同”的设定,而不是任意分布迁移。
论文的 PCA 结果也提示一种可解释性希望:无需定义摩擦和质量标签,模型仍可能形成低维有序结构。但这不是物理量的自动发现证明。潜变量可能混合多种因素,主成分方向也可能随任务、数据量和优化步数变化。比较稳妥的结论是,潜变量具有与任务相关变化一致的结构,而非已经获得可直接命名的物理语义。
局限与适用边界
论文没有一个独立命名为“局限”的作者章节,因此这里只陈述能够由论文设置和代码直接支持的边界,不替作者补写未声明的自评。第一,真实世界评价仅使用一个固定的 Intel RealSense D435i 主 RGB 视角,分辨率 640x480,帧率 20 帧每秒。多视角、深度缺失、相机位姿变化和传感器噪声对测试时潜变量的影响尚未被系统评估。
第二,评估规模仍有限,共七个仿真设置和四个真实任务。任务覆盖摩擦、重力、质量、灯光规则、平衡和软体,但还不足以证明方法能处理任意开放环境。真实任务中的隐藏因素数量、动作复杂度和场景多样性都受到实验设计约束。尤其是多因素联合变化只在仿真中进行主分析,真实世界主要是单个目标差异。
第三,适应需要带结果的交互轨迹。世界模型在测试时通过支持样本的未来观测计算流匹配损失;如果现场无法自动获得可靠结果,或结果存在标注延迟,优化就无法直接完成。机器人可以采集自身动作后的视频,但如何判断哪些帧、哪些对象和哪些接触事件可作为稳定监督,仍是部署问题。
第四,效率数字是单张 H200 的计算剖析,排除模型与样本加载、数据读取和视频写出。T2-z 比标准模型多出迭代优化过程,文中也没有给出在低功耗机器人计算平台上的实时性。把它用于高频闭环控制之前,需要测量实际端到端延迟、内存带宽和能耗,而不只是比较优化器内部耗时。
第五,交替训练和测试时更新都包含需要调度的超参数。论文使用 300 次初始模型更新、200/200 交替、测试学习率 3.0/1.5/0.5/0.15、共 40 步,并提供消融说明这些选择并非完全无关。不同世界模型骨干、不同视频长度和不同动作空间可能需要重新调整;这增加了复现和跨平台迁移成本。
总结与展望
T2-z 的核心贡献不是又一个更大的视频生成模型,而是把机器人世界模型中的环境身份变成一个可在现场求解的变量。它用共享模型承载常见动力学,用一个 32 维单 token 潜变量承载未显式观察的环境条件;训练时交替优化二者,测试时只更新潜变量。这个结构同时解释了为什么少量交互可能足够,以及为什么直接优化高维 token 会破坏泛化。
结果上,七项仿真任务的平均物理误差从 12.8575 降到 4.7971,动作成功率从 37.9% 升到 74.2%;四项真实任务的平均跟踪误差从 19.30 降到 10.85,动作成功率从 26.47% 升到 70.80%。这些数字并不意味着方法在所有单任务和所有指标上占优,Soft Pull 的平均误差和 LPIPS 就暴露了软体任务的困难,但它们共同支持一个清晰结论:测试时直接优化小型环境状态,比更新整个模型或依赖固定历史编码器更适合当前这批环境变化任务。
下一步值得关注三类验证:跨相机、跨机器人和跨传感器的真实部署;在线连续适应时如何防止潜变量漂移;以及把潜变量从被动条件变量扩展为不确定性或安全约束。若这些方向成立,T2-z 可能成为“世界模型适应层”的一个基础接口:不改变共享动力学,只在现场估计当前世界为什么与默认世界不同。