PAPER DEEP DIVE
AgentGarten:给进化智能体的代码世界
引擎维护显式状态与规则,共享的实时神经渲染器把几何条件渲染成第一人称画面;预训练智能体只看画面练习,每轮把经验写进 playbook 传给下一轮。
AgentGarten: Code Worlds for Evolving Agents
Jiawei Chi、Shangchen Miao、Zhiyuan Shi、Kailu Wu、Hanyang Wang、Weiliang Chen、Qiyu Dai、Jinshan Ren、Jun Gao、Mingsheng Long、Yueqi Duan、Jiangran Lyu、Jialong Wu†、Fangfu Liu†(MirroS / 清华大学 / 北京大学,† 项目负责人)
arXiv:2610.12374v1 [cs.CV],提交于 2026-10-08 · arXiv:2610.12374 · 项目页 · 代码仓库 MirroS-Lab/AgentGarten(Apache-2.0)
代码状态:神经渲染器的训练配方(bidirectional → autoregressive → Adversarial Forcing 三阶段)与流式推理服务已开源,权重在 HuggingFace MirroS-Lab/AgentGarten-renderer;README 的 TODO 里「实时渲染引擎:流式服务与交互前端」与「代码世界 + 智能体练习回合」两项仍未勾选。
一句话总结
AgentGarten 把「环境」拆成两半:模拟器或游戏引擎维护可检查、可编辑的持久状态并执行显式交互规则,一个共享的神经渲染器把引擎导出的深度/法向条件实时渲染成第一人称画面;渲染器由 Adversarial Forcing 蒸馏成四步块因果模型,在单张 H100 上跑出 36.5 fps(480×832)。预训练智能体只看这些生成画面、把每轮经验写成 playbook 传给下一轮,在躲猫猫里第 4 轮出现搭掩体、第 10 轮出现用斜坡翻墙——OpenAI 2019 年那套自博弈 RL 分别花了约 2500 万和 1 亿局。
一、问题:模拟器和视频世界模型,各自缺了对方那一半
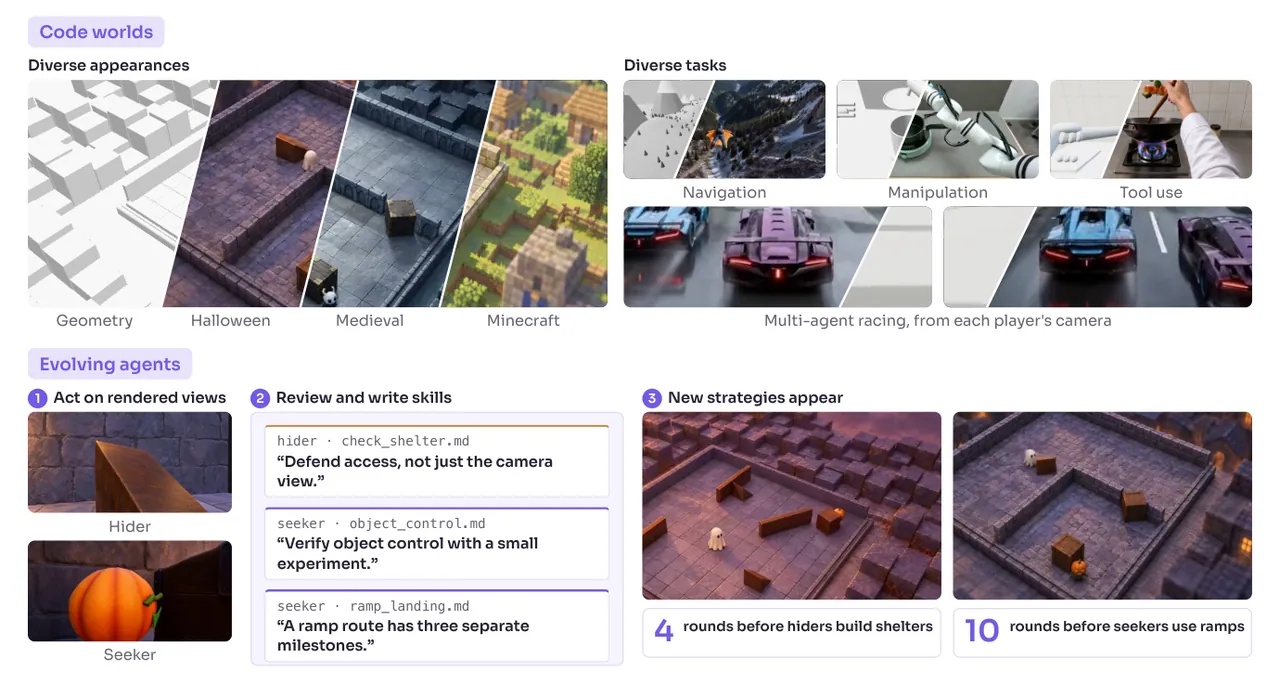
图1(论文 teaser):AgentGarten 的整体主张——左边是可编程的代码世界,右边是共享的实时神经渲染器,中间只通过结构化几何条件相连。
智能体从「动作—观测」轨迹里学习,所以要做出可扩展、可泛化的智能体能力,环境必须同时满足两件看起来矛盾的事:忠实(在长交互里保住过去动作的后果,状态、规则、动力学一致)与真实(观测服从真实世界的视觉分布)。论文开篇就把现有两条路线的短板点得很干净。
模拟器和游戏引擎(Habitat 2.0、ManiSkill2、ProcTHOR)靠显式状态和可编程交互规则支撑智能体学习,状态可查、规则可改、结果可复现。代价在视觉这一侧:想扩展画面多样性就得造大量 3D 资产、搭复杂渲染管线,于是「新建一个环境」本身就是昂贵的美术工程。
视频世界模型(Genie、WorldPlay 一类)反过来,从数据里合成丰富、可交互的视觉观测,画面不是问题。但任务相关的状态和物理转移规则隐式地待在生成历史和学到的表征里,你无法直接检查它、编辑它、单元测试它——环境「行为对不对」这件事无从验证,渲染误差还会顺着状态一路累积。
AgentGarten 的解法是分工:每个场景程序跑在模拟器或游戏引擎里,引擎负责持久状态和显式交互规则;一个共享的神经渲染器从引擎通过统一接口导出的结构化条件合成智能体的视觉观测。这样状态与规则的严格控制权留在代码里,而兼容的引擎可以共用同一个渲染器。新环境可以由编码智能体从一句文本或一张图片写出来,之后完全在代码里编辑扩展,不必为每个场景单独做视觉资产。
二、代码世界的形式化:状态转移函数不吃渲染结果
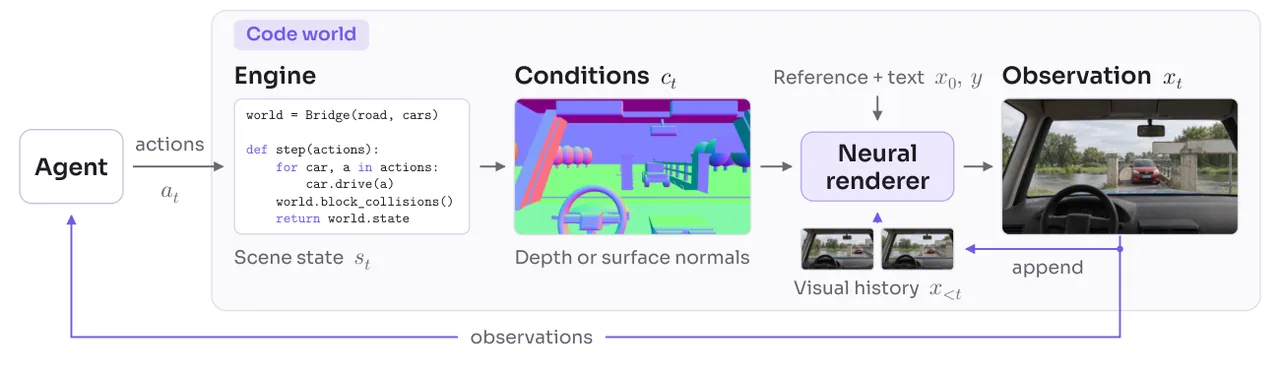
图2(论文 Fig.1):代码世界里的交互与渲染。智能体提交动作、接收生成观测;引擎维护场景状态并导出结构化条件(图中是表面法向);神经渲染器把条件与外观参考、文本、缓存的视觉历史结合,新观测回到智能体并加入历史。
一个代码世界由三件东西组成:场景程序 $p$、执行它的引擎、以及神经渲染器 $R_{\theta}$。程序规定场景和交互规则。令 $s_t$ 为场景状态(物体位姿、铰接、任务变量),$\pi_t$ 为观察相机位姿,$a_t$ 为一个或多个智能体的动作。引擎更新状态,并从相机采集结构化条件 $c_t$:
$$(s_{t+1},\pi_{t+1}) = f_p(s_t,\pi_t,a_t), \qquad c_t = h_p(s_t,\pi_t) \tag{1}$$
其中 $f_p$ 实现状态转移,$h_p$ 渲染可见几何。给定外观参考 $x_0$ 和文本描述 $y$,神经渲染器从视觉历史生成后续观测:
$$x_t = R_{\theta}\!\left(x_{{<t}},\ c_{\leq t},\ x_0,\ y\right), \qquad t \geq 1 \tag{2}$$
智能体收到 $x_t$、选出 $a_t$,$a_t$ 再经 Eq.(1) 决定下一个状态和条件。这里有一个容易被读过去、但其实是整套设计承重点的性质:$f_p$ 的输入里没有任何渲染观测。渲染器只能通过智能体选择的动作影响状态,所以渲染误差无法在状态里累积。推论是一条录像级的可复现性——一段记录下来的状态轨迹可以在换一个外观参考、换一个相机之后重新渲染,而底下发生的事件一个字都不变。论文第 5.1 节把这条性质直接用成了产品能力:同一段 rollout 可以换一种视觉风格重拍,或者换机位重拍。
反过来,渲染器只能通过 $c_{\leq t}$ 观察状态。条件没有规定的属性——颜色、材质、物体身份——由 $x_0$ 和 $y$ 指定,并靠视觉历史一路携带。这也提前解释了这个系统最硬的局限:几何条件没编码的状态,渲染器就是看不见(第七节会回到这一点,作者自己在 §7 里举的例子是一颗绕长轴自转的子弹)。
要把一个视频模型当成交互式神经渲染器用,论文列了三条硬要求:严格跟随引擎更新的条件、在长 rollout 里保持视觉一致、以细粒度短块合成观测好让智能体在短暂动作后立刻拿到反馈。后面三节就是把一个预训练双向视频模型改造成满足这三条的实时渲染器的全过程。
flowchart LR
    TASK[文本或单张图片] --> CA[编码智能体
写场景程序 p 与外观参考 x0]
    CA --> ENG[引擎或模拟器
持久状态 s_t 与显式交互规则]
    ENG -->|f_p 状态转移| ENG
    AG[智能体动作 a_t
提交短 Python 程序] --> ENG
    ENG -->|h_p 导出结构化条件 c_t
深度或法向 每帧 28 token| REND[共享神经渲染器 R_theta
Cosmos3-Nano 块因果 四步]
    X0[外观参考 x0] --> REND
    TXT[文本 y] --> REND
    REND -->|480x832 36.5 fps| OBS[第一人称观测 x_t]
    OBS --> AG
    OBS -->|写入有界 KV cache
5 sink + 44 recent| REND
三、结构化条件:用 28 个 token 表达一帧几何
条件选的是上色深度图或表面法向图。理由很工程:两者都能从真实视频估计出来、也能由引擎直接渲染出来,而且都是三通道表示,于是预训练的视频编码器和 Transformer 可以原样复用。真实视频的深度用 ViPE(深度后端是 Depth Anything 3),法向用 NormalCrafter;仿真场景直接从几何给出这两张图,不需要精细材质和纹理。训练时每个样本随机选一种模态。
深度按 Vision Banana 映射编码。有效深度 $d>0$ 映到
$$u(d) = 1 - \left(1 + \frac{\alpha d}{10}\right)^{-2} \tag{14}$$
$\alpha$ 在整段 clip 内共享:度量深度取 $\alpha=1$;尺度未知的深度先估计整段有效深度的中位数 $m$,取 $\alpha = 10(\sqrt{2}-1)/m$,把中位数放到 $u=0.5$ 上。$u\in[0,1)$ 沿 RGB 立方体的七段等长线性插值走一圈:黑、红、黄、绿、青、蓝、品红、白,无效深度映射为黑。法向在自编码器输入端保持在 $[-1,1]$,对应显示编码 $(n+1)/2$,NormalCrafter 的预测要把 $x$ 分量取反以对齐相机系朝向。
条件 token 的构造是
$$G_t = W_{\mathrm{in}}\,\mathcal{P}\!\big([E(S(c))]_t\big) + e_{\mathrm{geo}} \tag{3}$$
$S$ 先对条件视频做空间平均池化(每轴 4 倍,再用分段双线性拉伸铺到条件画布上),$E$ 是冻结的视频编码器,$\mathcal{P}$ 把 latent patch 分组,$W_{\mathrm{in}}$ 直接复用预训练的 RGB 输入投影,另加一个零初始化的模态嵌入 $e_{\mathrm{geo}}$。条件 token 不带扩散时间步。在 480×832 输出分辨率下,这样每个 latent 帧只有 28 个条件 token,对比 390 个 RGB token——差不多是 14 倍的成本差,这也是「条件几乎白送」的原因。
几何 token 和 RGB token 沿序列维拼接,走同一批 Transformer 层:
$$[\,G_0, G_1, \dots\,]\;[\,R_0, R_1, \dots\,] \tag{4}$$
$R_0$ 编码外观参考 $x_0$,文本的 key/value 通过 cross-attention 注入。几何和 RGB 共享时间旋转坐标;空间坐标把两个网格映射到同一个图像范围,条件网格坐标 $u$ 按 $(u+\tfrac{1}{2})(N_{\mathrm{rgb}}/N_{\mathrm{geo}})-\tfrac{1}{2}$ 对齐。论文明确说他们既不用通道拼接也不用 ControlNet 式控制分支,为的是不强加「像素级对齐」的归纳偏置——只有带噪 RGB token 产出速度预测。
真实视频估出来的几何和引擎渲染出来的几何并不一样:有纹理泄漏、有对齐误差、有缺失观测。为了让模型别依赖某个估计器的特有线索,训练里做了一整套条件增强:随机只保留深度或法向,以小概率 0.1 把两者都丢掉(丢掉的输入置黑);以 0.5 概率做纹理抑制(下采样倍数从 $[1.5,3]$ 里抽,再上采样回去);以 0.5 概率做锚定首帧的平滑空间扭曲(尺度至多 1.15,沿 clip 衰减);编码后再给条件 latent 加标准差 0.4 的高斯噪声。
四、建世界:一张图或一句话,产出一个可执行场景程序
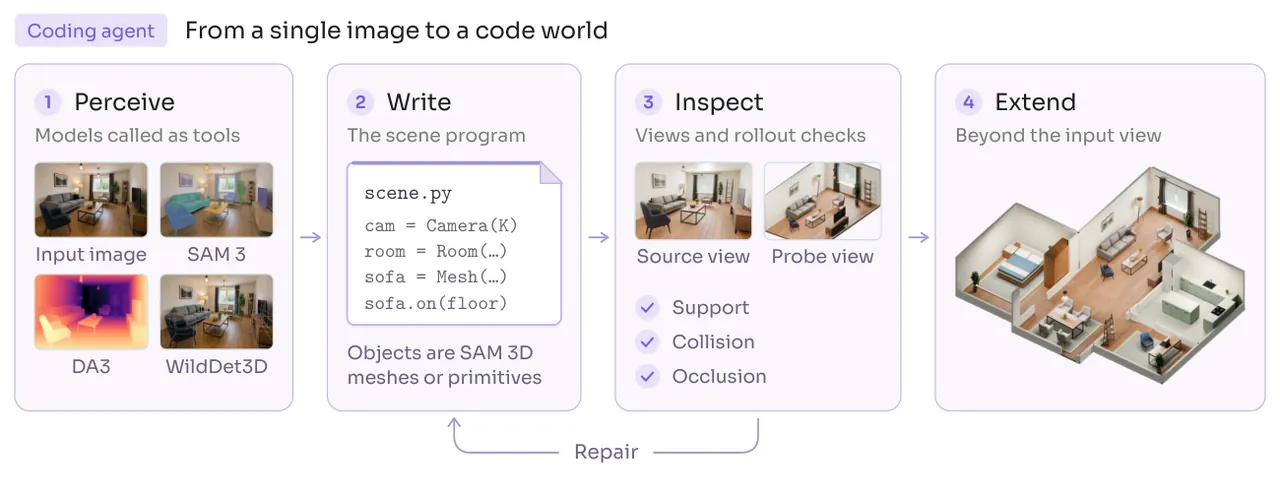
图3(论文 Fig.2):编码智能体从单张图片建一个代码世界(客厅示例)。它把感知与生成模型当工具调用,用它们的输出写场景程序,并在检查渲染视图和 rollout 检查之后修复程序。扩展后的场景保留观测到的房间,并在输入视野之外补上相连房间作为作者式延展;输入图片本身提供外观参考 $x_0$。
因为外观这件事整个交给了神经渲染器,场景程序不需要精细材质和叶子级资产,只要粗糙几何能忠实传达布局、轮廓、遮挡和运动动力学就够。这是「新世界很便宜」这句话的技术根据。
从图片建:输入图片同时充当 $x_0$ 和布局参考。感知与生成模型把可见内容抬升成实例掩码、单目深度与相机内参、3D 包围盒、抽取出的物体网格;编码智能体把这些资产拟合到估计几何上,把未观测区域补成合理的空间延展,再绑定物理属性和交互规则。
从文本建:智能体直接用几何基元和引擎资产写场景程序,第一次渲染的结果交给一个图像编辑模型转成 $x_0$,同时保住场景布局。
两条路都收在同一个交互式精修回路上:智能体从多个探针相机跑测试 rollout,查询引擎的验证接口(接触、碰撞间隙、遮挡),迭代修掉错误位姿、无支撑结构、含糊运动,然后才部署。这一段是论文里最不「模型」的部分,但它决定了世界能不能真的用——一个穿模的斜坡会让后面所有智能体的经验都变成噪声。
五、三阶段训练:从双向教师到四步学生
渲染器从 Cosmos 3-Nano 的视频流初始化:36 层 Transformer、隐藏宽度 4096、32 个 query head、8 个 key-value head。理解塔(UND)与生成塔(GEN)拆开,冻结的 UND 把 caption $y$ 编码成逐层 key/value 供 GEN 消费——这个拆分让两座塔可以独立编译和分布式执行,蒸馏时学生、教师、fake-score 三个网络共享同一座 UND 塔并复用同一 caption 的输出。视频自编码器是冻结的 Wan VAE(时间压 4 倍、空间压 16 倍),$2\times2$ patch embedding 在 480×832 下每 latent 帧产出 390 个 token;模型的时间网格按 16 fps 处理。5 秒训练窗含 81 帧(1 张参考 + 20 个 latent 帧 = 5 个目标块),15 秒窗含 241 帧(参考 + 60 个 latent 帧 = 15 个目标块)。外观参考 $x_0$ 走骨干原生的 clean-frame 表示:不给扩散时间步,也永不被去噪。
训练数据是 RGB 视频配文本描述、深度和法向:DL3DV-10K 的场景采集、OpenDV 的驾驶视频、互联网上的游戏/导航/机器人交互视频,再加一小批渲染合成场景(这批的条件由渲染器导出而不是估计出来)。所有阶段都跑在 32 张 H100 上、FSDP、每卡一个 clip、两步梯度累积,即每次优化器更新 64 个 clip;BF16 计算 + FP32 梯度归约,判别器头用 FP32 参数;优化器一律 AdamW、零权重衰减。
| 阶段 | 更新的参数 | 初始化 | 学习率 | Adam $(\beta_1,\beta_2)$ |
|---|---|---|---|---|
| 1. 几何条件化 | 自注意力投影与 q/k norm;条件嵌入 | Cosmos 3-Nano | $3\times10^{-5}$ | (0.9, 0.99) |
| 2. 因果适配(teacher forcing) | 同阶段 1 | 阶段 1 | $3\times10^{-5}$ | (0.9, 0.99) |
| 3. 蒸馏:学生 | 完整视频流 | 阶段 2 | $2\times10^{-6}$ | (0, 0.999) |
| 3. 蒸馏:fake score | 完整视频流 | 阶段 1 | $4\times10^{-7}$ | (0, 0.999) |
| 3. 蒸馏:判别器 | 只有头;骨干是冻结的教师 | 全新 | $2\times10^{-7}$ | (0, 0.999) |
表1(论文 Table 5):三阶段训练配置。阶段 1、2 先在 5 秒窗、再在 15 秒窗上训练;每个蒸馏阶段用匹配窗长的教师与 fake score。教师是阶段 1 模型且始终冻结;文本流与视频自编码器全程冻结。适配阶段有 100 步线性 warmup(从标称学习率的 10% 起),蒸馏阶段恒定学习率、无 warmup。
阶段 2 把几何条件模型适配成块级自回归生成:参考帧之后的 latent 被切成定长块,每块由自己对齐的几何和已完成的块生成,看不到未来的块。训练时在同一个 Transformer 里放每块的两份拷贝:表示历史的干净拷贝 $P_j$ 和被去噪的带噪拷贝 $Q_j$,各自带自己对齐的条件 token。以 $A_0$ 表示参考帧,注意力掩码允许
$$P_j \longrightarrow A_0 \cup P_{\leq j}, \qquad Q_j \longrightarrow A_0 \cup P_{{<j}} \cup Q_j \tag{5}$$
箭头从 query 指向它可以读的 token,文本对两者都可见。于是带噪拷贝能看到更早的干净块、在自己内部双向注意,但永远看不到自己的干净目标——这让所有目标块可以并行训练,各自独立采样 flow 时间。以 $z_j$ 为干净 latent 块、$\mathcal{C}=(x_0,y,c)$ 为参考、文本与条件:
$$z_{j,t_j} = (1-t_j)z_j + t_j\epsilon_j, \qquad \mathcal{L}_{\mathrm{TF}} = \mathbf{E}\!\left[\frac{1}{M}\sum_{j=1}^{M}\left\lVert v_{\theta}(z_{j,t_j},t_j \mid z_{{<j}},\mathcal{C}) - (\epsilon_j - z_j)\right\rVert_2^2\right] \tag{6}$$
每个目标块含 4 个 latent 帧,参考帧是独立的 clean 前缀(不给时间步、不进 loss、cache 初始化后不再重新发布)。为了让模型别过度信任自己的历史,每一帧可见历史独立地接受四种等概率扰动之一:围绕通道均值的对比度/曝光缩放(因子取自 $[0.3,1.7]$)、高斯噪声混合(强度 $[0,1/3]$)、双线性下采样再上采样(尺度 $[0.9,1]$)、或什么都不做。参考帧从不扰动。
六、Adversarial Forcing(一):在自己的 rollout 上做分布匹配
阶段 3 把 teacher-forced 模型蒸馏成一个在自己 rollout 上训练的少步渲染器,由三件东西组成:对双向教师的分布匹配、让梯度抵达自己写下的历史的精确 replay、以及带精确 R1/R2 正则的真实数据对抗目标。
第一件沿用 Self Forcing 的 DMD 路线:学生从阶段 2 出发,每块用少数几步去噪生成,条件是自己的前序输出;冻结的阶段 1 教师对整段 clip 联合打分;一个从教师初始化的辅助 fake-score 模型学习学生的分布。把学生预测 $\widetilde{z}_{\theta}$ 加噪到 $y_{\tau}=(1-\tau)\widetilde{z}_{\theta}+\tau\epsilon$,令 $f_{\mathrm{T}}$、$f_{\psi}$ 分别是教师和 fake-score 的 clean 估计,学生目标是
$$g = \frac{f_{\psi}(y_{\tau},\tau\mid\mathcal{C}) - f_{\mathrm{T}}(y_{\tau},\tau\mid\mathcal{C})}{a}, \qquad \mathcal{L}_{\mathrm{DMD}} = \mathbf{E}\!\left[\frac{1}{2N}\left\lVert \widetilde{z}_{\theta} - \operatorname{sg}\!\left(\widetilde{z}_{\theta}-g\right)\right\rVert_2^2\right] \tag{7}$$
$a$ 是逐视频归一化,$N$ 是 latent 元素数,$\operatorname{sg}$ 停梯度;fake-score 模型用 detached 学生样本上的 flow matching 训练。四步渲染器的采样轨迹端点(归一化 flow 时间)是
$$\mathcal{E} = \left(1600/1601,\ 15/16,\ 5/6,\ 5/8,\ 0\right) \tag{15}$$
rollout 里所有块共用这条轨迹,replay 重算它的最后一步。教师用 classifier-free guidance 尺度 6,score 时间服从 shift 为 5 的 shifted uniform,fake-score 每 1 次学生更新配 5 次自己的更新。clean 估计由速度预测换算:$f(y_{\tau},\tau) = y_{\tau} - \tau v(y_{\tau},\tau)$。归一化项是
$$a = \max\!\left\{\operatorname{mean}\left(\left\lvert \widetilde{z}_{\theta} - f_{\mathrm{T}}(y_{\tau},\tau\mid\mathcal{C})\right\rvert\right),\ 10^{-5}\right\} \tag{16}$$
均值取每段视频的全部 latent 元素。这个 $\max\{\cdot,10^{-5}\}$ 的下限在代码里能直接找到:wm/models/dmd.py 的 _student_targets 用 clamp_min(1e-5) 实现,防的是训练早期分母塌到 0 把梯度炸掉。
七、Adversarial Forcing(二):exact replay,让「写历史的那次前向」也进梯度
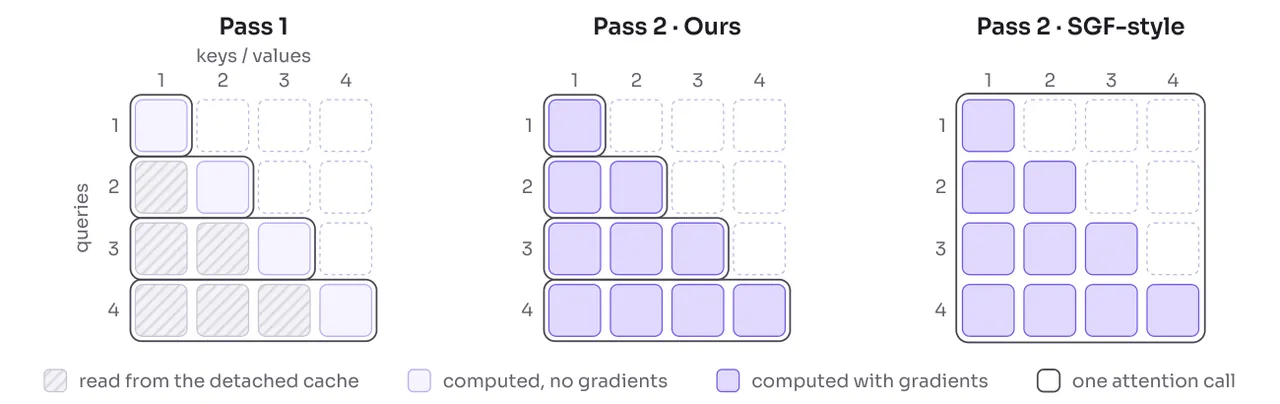
图4(论文 Fig.4):exact replay 画成块级注意力掩码。第 $i$ 行是块 $i$ 的 query,列是它读的 key/value 块。rollout 每块跑一次注意力调用、从 detached cache 读更早的块;本文的 replay 跑同样的调用,但带梯度地重算历史 key/value,保住 rollout 的执行结构。SGF 式 replay 用一次全序列调用算出同一个掩码,数值执行路径就变了。
标准 Self Forcing 把已完成的块编码进一个 detached 的 KV cache。于是后续 loss 监督的是「从这个 cache 出发的预测」,而不是产生这些 key/value 的历史 prefill 计算。想让这段计算在一条串行 rollout 里保持可微,就得把跨块递归相连的 cache 构建图全留下,显存代价巨大。
本文和 Self Gradient Forcing(SGF)一样用两趟解耦 rollout 与梯度传播:第一趟无梯度 rollout 记录每块在最后一个去噪时刻 $t^{*}$ 的输入 $U$ 和它的 clean 输出 $Z$;第二趟可微 replay 按 Eq.(5) 的可见性模式重算历史和预测。对块 $j$:
$$\widetilde{z}_{\theta,j} = \operatorname{sg}(U_j) - t^{*}\, v_{\theta}\!\left(\operatorname{sg}(U_j),\ t^{*} \mid \operatorname{sg}(Z_{{<j}}),\ \mathcal{C};\ \mathcal{M}_{\mathrm{TF}}\right) \tag{8}$$
记录下来的 latent 保持 detached,但它们的历史编码在图内重算。这样后续 loss 就能更新「把历史写进 cache」的那部分参数,而不必对采样轨迹求导。DMD 和生成器对抗损失都用这个 replay 出来的预测。
真正的贡献在下一句。SGF 的第二趟用全序列 FlexAttention 实现:注意力掩码和带 cache 的生成一致,但 kernel、张量形状、归约顺序都不一样,有限精度下 replay 就可能偏离采样出来的轨迹。本文的做法是把 rollout 的执行结构原样保住:注意力逐块用 SDPA 跑,key-value 顺序和调用形状都相同;投影和前馈层用同样的分组(先是参考帧,然后每块先条件 token 再 RGB token)。分组之所以要紧,是因为对整个打包序列做一次投影,和逐块做同一个投影,舍入结果可能不同,而这种差异会在一个训练过的网络里被放大。历史 key/value 被可微地重算并装配,所以这套匹配的执行保住了历史梯度路径。实现上分组循环跑在编译区之外、每组的张量算子保持编译,于是历史长度或 caption 长度变化不会触发重新展开编译。
| 度量 | SGF 式(FlexAttention) | 本文(逐块 SDPA) | 变化 |
|---|---|---|---|
| Replay 误差(相对 $L_2$) | 3.99% | 0(逐位相同) | — |
| 前向耗时 | 2.95 s | 2.79 s | −5.4% |
| 峰值分配显存 | 50.83 GiB | 50.92 GiB | +0.2% |
表2(论文 Table 1):只改注意力执行方式,测 replay 的重算误差与代价。一张 H100、36 层、480×832、61 个 latent 帧、BF16;耗时是三次预热后 replay 前向的中位数,不含 backward 和优化器更新。
「逐位相同」是这篇论文里最硬的一个数字:它把「replay 出来的预测」和「rollout 真正采样出的预测」变成同一个张量,于是第二趟的梯度确实是第一趟那段计算的梯度,而不是一个近似。代价几乎为零——前向还快了 5.4%,显存多 0.2%。实现里每块发两次注意力调用:一次给自己的带噪 query,一次给后续块要读的 clean 发布。
代码对应也很直白。wm/models/dmd.py 的 _student_loss 注释就写着 “Pass 2: teacher forcing over the detached Pass-1 queries and context”,调用 self.student.forward_ar(..., clean=rollout.clean)——把第一趟录下的 clean latent 当上下文重算,正是 Eq.(8)。同一个函数里还回读了一个训练期监控量:
# wm/models/dmd.py
with torch.no_grad():
    recovery = (x0 - rollout.clean).abs().max()
return {**metrics, "metrics/student/sgf_recovery_max_abs": recovery, ...}, loss
sgf_recovery_max_abs 就是 replay 恢复误差的最大绝对值,理论上应恒为 0——它是表2「bitwise」那句话在训练日志里的守门人。名字里带 sgf 也说明了这条路线的来处:他们是在 SGF 的两趟结构上,把第二趟换成了执行结构一致的实现。
八、Adversarial Forcing(三):精确 R1/R2,且不穿过 fused attention 做 double backward
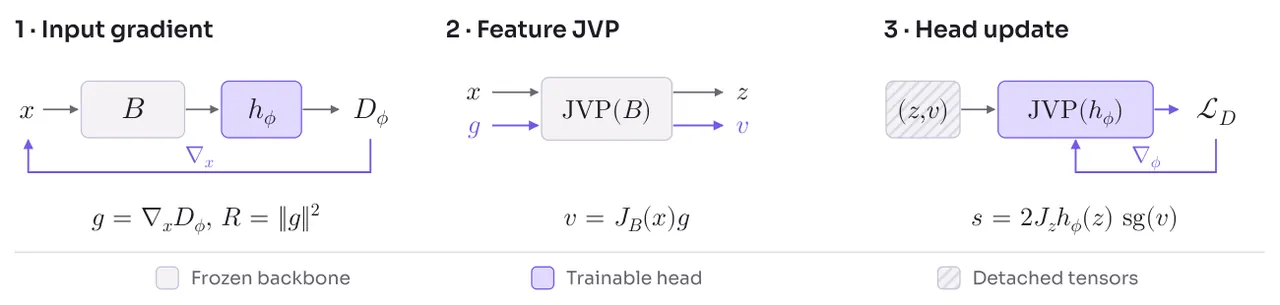
图5(论文 Fig.5):冻结骨干 $B$ + 可训练头 $h_{\phi}$ 的精确 R1/R2。(1) 只对 $x$ 求导得到 $g$ 和 $R$;(2) 跑骨干的 JVP 得到特征 $z$ 和方向 $v$;(3) 在 detached 的 $(z,v)$ 上跑显式的头 JVP,同时返回 logit 和它的方向导数,供出 $s$;最后一次对 $\phi$ 的普通 backward 用完整判别器目标更新头。
纯分布匹配的两侧估计都落在生成样本上,从不与真实视频正面对照。按 DMD2 的做法,本文加一个对抗目标:一个可训练头 $h_{\phi}$ 把冻结教师骨干 $B$ 的中间特征聚合成判别器 logit。骨干以几何和参考帧为条件,判别器因此能同时评判外观和几何一致性。具体读的是教师第 11、23、35 层之后的特征,每个分支用一个 learned query 聚合该层 token、接一个残差 MLP,三个分支输出拼接成一个 logit。
对抗配对用 R3GAN 的 relativistic 形式。令 $r$、$f$ 分别是真实 clip 与学生预测的 logit(两者加同样的噪声、同样的时间步、同样的条件):
$$\mathcal{L}_{\mathrm{G}} = \mathbf{E}\!\left[\operatorname{softplus}\!\left(\operatorname{sg}(r) - f\right)\right], \qquad \mathcal{L}_{\mathrm{rel}} = \mathbf{E}\!\left[\operatorname{softplus}(f - r)\right] \tag{9}$$
学生最小化 $\mathcal{L}_{\mathrm{DMD}}+\lambda_{\mathrm{G}}\mathcal{L}_{\mathrm{G}}$。生成器侧的梯度通过一个线性代理注入第二趟的图:令 $h=\partial\mathcal{L}_{\mathrm{G}}/\partial\widetilde{z}_{\theta}$(critic 参数固定),它以 $\langle \widetilde{z}_{\theta}, \operatorname{sg}(h)\rangle$ 的形式进入学生图,于是对抗目标和 DMD 目标都经由 replay 起作用,而不必保留 rollout 图。代码里就是 loss = loss + (x0 * gan_gradient).sum() 这一行。
难点在正则。R3GAN 用 R1、R2 约束判别器,也就是真实样本和生成样本上的输入梯度平方范数:
$$D_{\phi}(x) = h_{\phi}(B(x)), \quad R_1 = \mathbf{E}_{x\sim p_{\mathrm{data}}}\lVert \nabla_x D_{\phi}(x)\rVert_2^2, \quad R_2 = \mathbf{E}_{x\sim p_{\theta}}\lVert \nabla_x D_{\phi}(x)\rVert_2^2 \tag{10}$$
它们的参数梯度通常要「对一个 backward 再求导」。而骨干里的 fused attention kernel(FlashAttention 之类)不支持这种 double backward。APT 的绕法是用随机扰动近似 R1。本文选择算出精确罚项和精确的头参数梯度,靠的是骨干冻结这一件事。
取单个样本,记 $z=B(x)$、$A=J_B(x)$、$u=\nabla_z h_{\phi}(z)$,则
$$g = A^{\top}u, \qquad R = g^{\top}g, \qquad v = Ag \tag{11}$$
$g$ 由一次 vector-Jacobian product 得到(先对头做一次参数冻结的 backward,再穿过骨干),$v$ 由一次 Jacobian-vector product 得到,把 $g$ 前向推过冻结骨干且不带梯度图。两步都不显式构造 $A$。因为 $z$ 和 $A$ 都不依赖 $\phi$:
$$\nabla_{\phi} R = 2\left(\frac{\partial u}{\partial \phi}\right)^{\!\top} v = \nabla_{\phi}\!\left[\,2\,J_z h_{\phi}(z)\,\operatorname{sg}(v)\,\right] \tag{12}$$
右边是「只属于头」的一个方向导数的梯度,用普通可微算子写出头的 JVP 即可算(附录 B)。令 $s = 2J_z h_{\phi}(z)\operatorname{sg}(v)$,代理项
$$\widetilde{R} = \operatorname{sg}\!\left(\lVert g\rVert_2^2\right) + s - \operatorname{sg}(s) \tag{13}$$
取值等于真罚项,对 $\phi$ 的一阶导数精确。判别器随后最小化 $\lambda_{\mathrm{D}}\big(\mathcal{L}_{\mathrm{rel}}+\tfrac{\gamma}{2}(\widetilde{R}_1+\widetilde{R}_2)\big)$。真实与生成样本的 detached 特征 $z$ 和方向 $v$ 只需要过一次头,就同时产出 relativistic logit 和方向项;一次普通 backward 更新头。没有任何一步对一个 backward kernel 求导,也没有有限差分或随机方向。
这套推导在仓库里是 wm/models/exact_regularization.py::exact_penalties,三段注释几乎逐句对着 Eq.(11)–(13):
# wm/models/exact_regularization.py
# 1. Input gradient through the frozen backbone and a frozen head.
leaf = rows.detach().requires_grad_(True)
with frozen_parameters(head), torch.enable_grad():
    (direction,) = torch.autograd.grad(head([features(leaf)]).sum(), leaf)
direction = direction.detach()
# 2. Feature tangents along that gradient (forward mode, no graph).
with torch.no_grad(), fwAD.dual_level():
    dual = features(fwAD.make_dual(rows.detach(), direction.to(rows.dtype)))
...
# 3. Head directional derivative, differentiable w.r.t. the head only.
return ExactPenalty(logits=logits, penalty=penalty,
                    surrogate=surrogate - surrogate.detach())
第 1 步的 torch.autograd.grad 就是 $g=A^{\top}u$(VJP),第 2 步的 fwAD.make_dual 在 no_grad 下就是 $v=Ag$(前向模式 JVP,不带图),第 3 步只对小头做 create_graph=True 的双重求导。最后那行 surrogate - surrogate.detach() 是 Eq.(13) 的字面实现:值为 0、梯度恰为 $\mathrm{d}R/\mathrm{d}\phi$。配置 wm/configs/experiments/cosmos3/dmd_gan_exact.py 把 exact_regularization_weight 设成 0.075,旁边注释写着 “0.075 = 30 * 0.05^2 matches the local scale of the finite-difference recipe”——即他们把这个精确版的强度对齐到 APT 那类有限差分配方的局部尺度上,可比性是刻意做的。
flowchart TD
    S2[阶段2 教师强制模型] --> P1[Pass1 无梯度 rollout
每块四步去噪 写 detached KV cache
记录输入 U 与 clean 输出 Z]
    P1 --> P2[Pass2 可微 replay
逐块 SDPA 保持同样的 KV 顺序与调用形状
按 Eq5 的可见性重算历史 K V]
    P2 --> DMD[分布匹配 DMD
fake score 减 teacher score 再除以归一化 a]
    P2 --> GAN[生成器对抗项
relativistic softplus 配对
梯度经线性代理注入 replay 图]
    DMD --> STU[学生更新 学习率 2e-6]
    GAN --> STU
    TEA[冻结教师骨干 第 11 23 35 层特征] --> HEAD[判别器头
learned query 聚合 + 残差 MLP]
    HEAD --> PEN[精确 R1 R2
一次 VJP 得 g 一次前向 JVP 得 v
代理项值等于真罚项 一阶导精确]
    PEN --> DISC[判别器更新 学习率 2e-7
一次普通 backward 不做 double backward]
九、流式推理:sink 前缀 + 滑动窗口 + 手写 kernel
推理时渲染器先 prefill 参考帧和文本,然后对到来的块去噪,把 clean 预测提交进一个有界 KV cache。cache 里有一段永久 sink 前缀(开头就是 $x_0$)和一段最近历史的滑动窗口,更旧的帧被逐出;当前块注意所有缓存帧和文本,去噪完成后 clean 块加入最近窗口。实测配置是 5 个 sink + 44 个最近 latent 帧(蒸馏时用过的历史窗之一),加上 4 个当前帧,于是每块注意 49 帧历史。
rollout 超过训练视野时怎么办?论文用顶对齐旋转位置重映射:活动块被夹在视野边界上,最近历史被平移到它之前并重新旋转,从而保住相对时间距离,而几何条件仍跟着真实仿真时间线走。代码在 wm/kernels/stream_cache.py::relocate——「重定位」这个函数名说的就是这件事。
短块上的 Transformer 执行主要被显存带宽和 kernel launch 开销卡住。他们没有依赖 torch.compile(冷启动编译要几分钟),而是写自定义 Triton kernel 把注意力周边的逐元素算子(RMSNorm、RoPE 旋转、门控激活)融掉,省掉中间显存往返;固定形状块用 CUDA graph capture/replay 消掉主机侧 launch 开销(wm/inference/serving.py::_GraphCall);实时服务时可选把标准 VAE 解码器换成蒸馏出来的 tiny decoder,10 ms 内重建像素帧(FP16 运行)。交互部署里引擎把条件推给 GPU worker,解码后的帧经 WebRTC 以有界排队延迟流给智能体或浏览器。
| 一个 16 帧服务块的构成(一张 H100,BF16) | 耗时 | 占比 |
|---|---|---|
| 条件编码 | 10.6 ms | 2.4% |
| Transformer:四步去噪 + cache 发布 | 414.4 ms | 94.4% |
| tiny decoder 与主机传输 | 8.8 ms | 2.0% |
| 总墙钟时间 | 438.8 ms | — |
| 吞吐 | 36.5 帧/秒 | — |
表3(论文 Table 2):稳态推理成本。cache 里 5 个 sink + 44 个最近 latent 帧、当前 4 个 latent 帧,配合手写 kernel、CUDA graph 与 tiny decoder。各阶段是 GPU 时间中位数,总计是每块墙钟均值(还含三阶段之外的工作)。测量取自 48 块、769 帧 rollout 的第 17–48 块,两次 rollout 平均;注意力是 dense 的。占比一列为本文按 438.8 ms 换算。
这张表值得盯的地方是它把「实时视频世界模型」的成本结构摊开了:94% 的时间在 Transformer 的四步去噪和 cache 发布上,条件编码和解码加起来不到 5%。也就是说 28 个条件 token 这个设计确实几乎不要钱,而继续提速的空间全在注意力与步数上——四步已经是很少的步数,49 帧历史也已经是被窗口截断过的。36.5 fps 对 16 fps 的时间网格意味着约 2.3 倍实时余量,这份余量正好可以喂给「一个世界里两个智能体各要一路第一人称画面」这种场景(论文 Fig.8 的赛车列就是两个智能体共享一份世界状态)。
十、代码世界图书馆与「回合制练习」
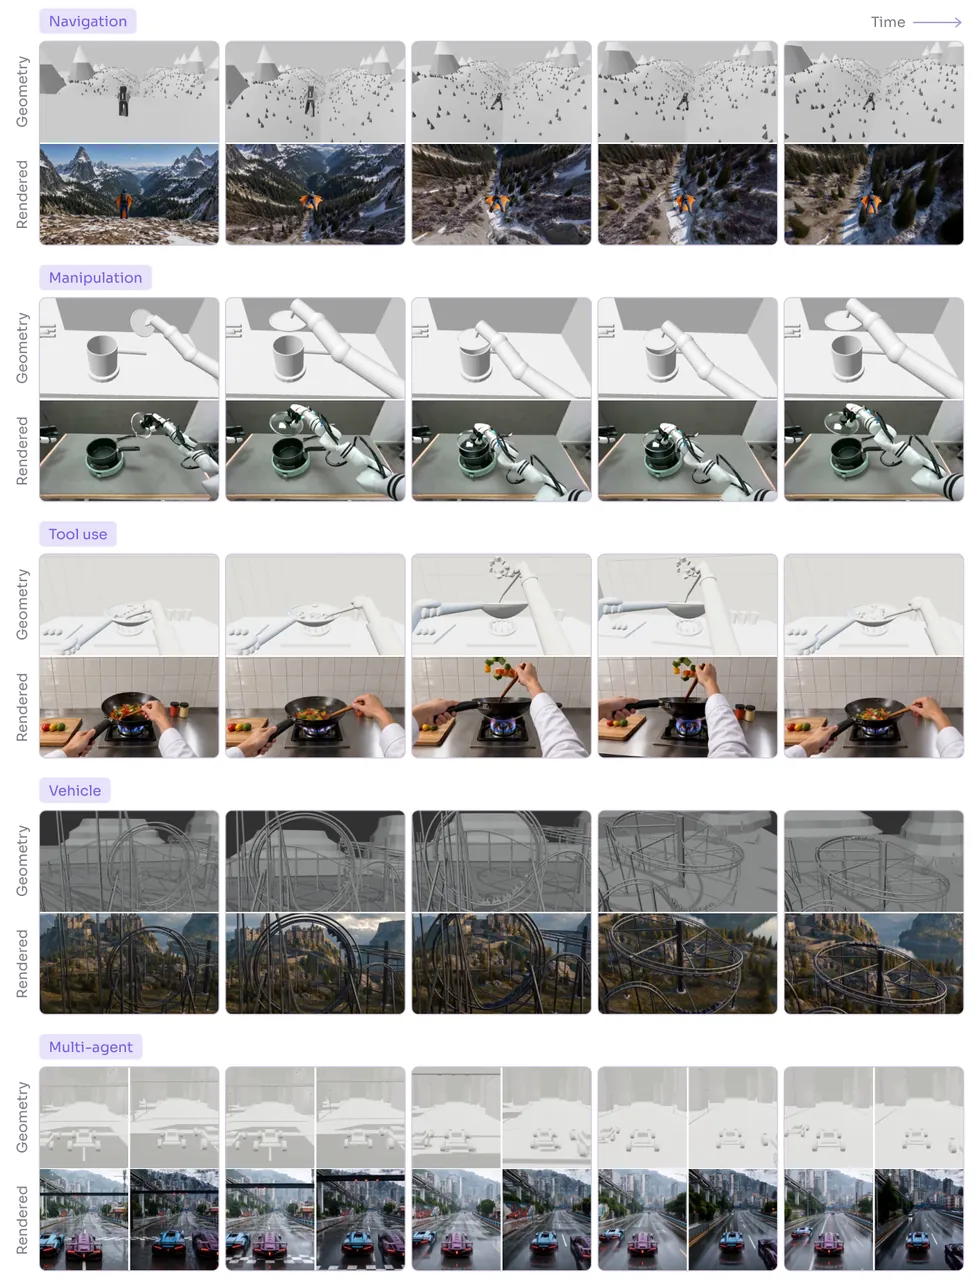
图6(论文 Fig.8):五个代码世界,每个取一段 rollout 的五个时刻。每一列里,上方是无纹理的场景几何,下方是它条件化出的生成观测。赛车那一组包含两个智能体共享同一份世界状态的第一人称视图。场景程序只写粗糙几何,外观由渲染器从初始图片、文本和视觉历史里供给。
不同的场景程序加上兼容的引擎,就构成共享同一个渲染器的代码世界。论文给的例子覆盖导航、操作、工具使用和多智能体交互。交互式部署里还加了规则完全活在代码里的浏览器游戏:保龄球、点球大战、板条箱翻越(crate-vault)谜题——玩家的键盘、鼠标或手柄输入推进代码世界,而渲染出来的流是它唯一的视图。因为状态演化是显式的,它也可以被回放并重新渲染:一段录好的 rollout 可以换一种视觉风格重拍,或换一个机位重拍,而发生的事一点没变。
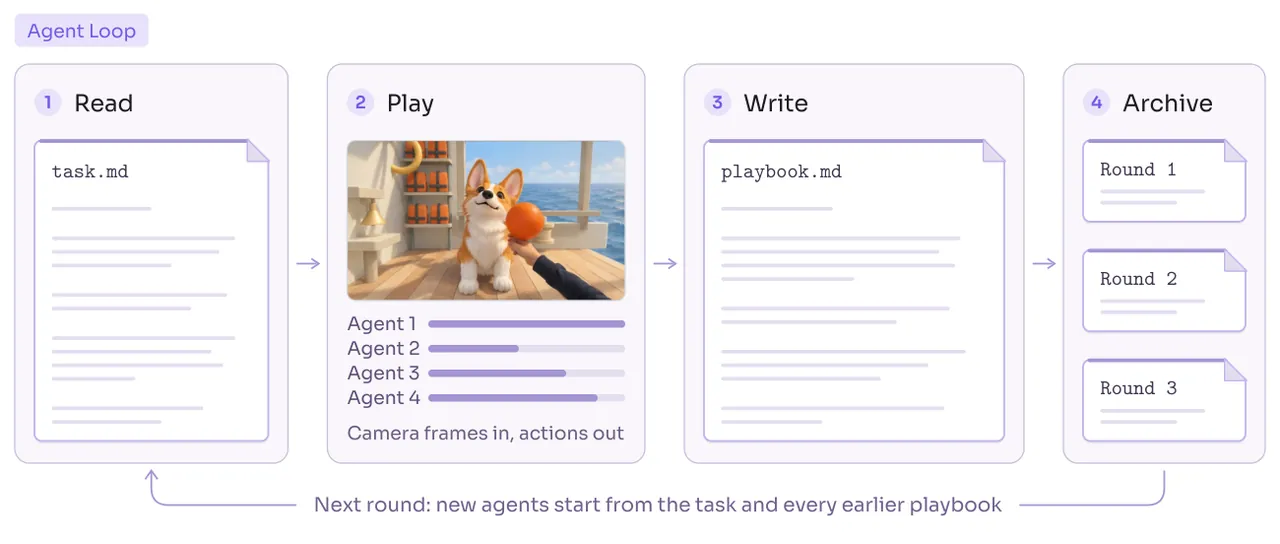
图7(论文 Fig.10):一个练习回合。智能体读 task file(写明目标、可用动作、限制,但不给解法),在固定预算内并行游玩,只看相机帧;结束后各自写 playbook。playbook 归档,下一轮的智能体在全新对话里从 task file 和此前所有 playbook 开始。
躲猫猫只是这套通用流程的一个实例。练习按回合进行:一个回合从一份 task file 开始,它写明目标、可用动作和限制,但不给解法。一个或多个智能体并行游玩,各自有固定的步数或仿真时间预算。他们只能通过神经渲染器合成的相机帧看世界:没有坐标、没有地图、局终之前没有分数。之后每个智能体写一份 playbook,记下自己试过什么、观察到什么、还怀疑什么、下一步想验证什么。playbook 归档,下一轮的智能体在全新对话里启动,拿到 task file 和此前所有回合的 playbook。
这套「回合 + playbook」的结构,和强化学习里的策略梯度完全不同:更新的是上下文而不是权重。它的可读性也是完全不同的——一轮学到的东西是一段人能读、能改、能删的 Markdown,而不是一个 diff 不出语义的参数增量。代价同样明显:playbook 属于某一个世界,且短到能整篇读完;世界一多,就得决定哪些教训留、哪些合并、哪些丢掉。
十一、躲猫猫重访:4 轮对 2500 万局
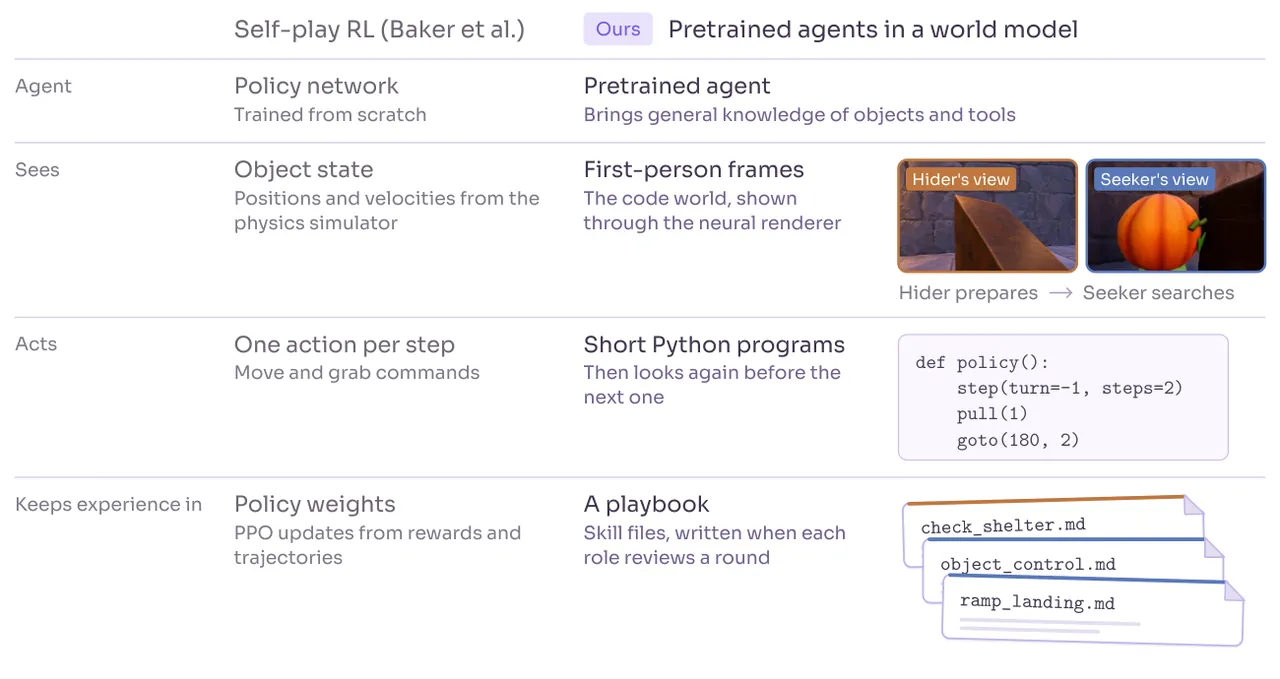
图8(论文 Fig.9):两种设定下的躲猫猫。上:自博弈强化学习在物体状态和奖励上训练策略网络。本文的预训练智能体看神经渲染器给出的第一人称帧,通过提交短 Python 程序行动,把学到的东西存进 playbook 里的 skill 文件。下:这组录制实验里的三局,从俯视相机看。
OpenAI 2019 年的躲猫猫研究里,用自博弈强化学习训练的智能体发展出了搭掩体、用斜坡、以及针对这些工具的防守策略:论文报告掩体搭建出现在约 2500 万局之后,seeker 用斜坡又在那之后 7500 万局(合计约 1 亿局)。那些智能体观察的是物体状态。本文重访同一设定,换成一个能推理「刚才发生了什么」并修改自己行为方式的预训练智能体,且它只通过渲染器看世界。
设定是顺序式的单 hider、单 seeker 变体:hider 先布置场景,然后把控制权交给 seeker。每个智能体收到神经渲染器从环境结构化条件生成的第一人称观测,行动方式是提交用于移动和物体交互的短 Python 程序,然后通过渲染器观察结果变化。它拿不到物体坐标、隐藏世界状态、或对手的私有观测。
每个角色维护自己的 playbook,组织成一个skill 文件库:可以含代码的 Markdown 笔记,一个文件一条教训。这组录制实验从空 playbook 开始,包含若干回合、每回合五局,跑在采样的布局和种子上。每回合结束后,每个角色复盘自己的动作程序和它被允许看到的视觉证据,找出失败,往 playbook 里加 skill 文件。下一回合智能体拿到累积的技能,解读当前场景,判断哪些旧经验相关。成功和失败的尝试都会进入后续修订。
交互中出现的三个特征行为(图8):hider 移动一块挡板重建掩体;seeker 把斜坡搬到内墙翻过去;seeker 第一次跳跃没够着,于是把斜坡挪得离墙更近再试一次。这三段是「多步物理工具使用策略能纯靠神经渲染的第一人称观测获得并精修」的直接证据——尤其第三段,它包含一次失败诊断和一次几何参数修正。
| 策略 | 自博弈 RL(2019) 训练局数 | 本文预训练视觉智能体 回合数 |
|---|---|---|
| 搭建掩体 | 约 2500 万 | 4 |
| 用斜坡进入掩体 | 约 1 亿 | 10 |
表4(论文 Table 3):两种范式下物理工具使用的里程碑。每回合五局,回合 4 约合 20 局、回合 10 约合 50 局。
论文自己把这张表的读法说得很克制,值得原文引一遍意思:这两个数字反映的是两种根本不同的学习范式,而不是一个样本效率比值。2019 年的智能体用随机权重从零学物理动力学和竞争协调,直接操作真值坐标状态;基础模型智能体已经从网络规模预训练里拥有了关于物体、工具、几何的抽象知识。它们的主要挑战不是从无到有发现概念,而是把抽象知识落地成闭环感知运动动作、在拿不到状态的前提下纯靠合成视觉观测诊断空间执行失败、并跨回合精修战术执行。
十二、四个世界的逐轮成绩
同一套流程被搬到另外四个世界,只换世界和它的 task file,每个世界跑四回合。伴侣犬:60 秒会话里让一只狗自愿保持互动(伸手、抚摸、玩球)。单车道桥:两辆车各由一个智能体从挡风玻璃视角驾驶,要在一座只容一辆车的桥上尽快交换两端。牧羊:两只只能从自己眼高看世界的狗,把四只羊赶进栏并保持五秒。采石场装载机:一台轮式装载机要在 360 秒内把两块石头推上暂存台、把其中一块送到墙后的料仓、然后停车。四个世界里智能体都直接对神经渲染器实时合成的第一人称观测行动,拿不到内部仿真状态或引擎的原始几何缓冲。
| 世界 | 度量 | 回合 1 | 回合 2 | 回合 3 | 回合 4 |
|---|---|---|---|---|---|
| 伴侣犬 | 互动分 | 13 | 14 | 19 | 19 |
| 单车道桥 | 两车都到达的秒数(越低越好) | 71 | 68 | 45 | 41 |
| 牧羊 | 百分制得分 | 60 | 90.1 | 87.6 | 88.3 |
| 牧羊 | 入栏羊数(共 4 只) | 3 | 4 | 4 | 4 |
| 采石场装载机 | 百分制得分 | 30 | 0 | 30 | 90.9 |
表5(论文 Table 4):四个世界每一回合的结果。每行是该世界自己的终局度量,每回合一局。
四条曲线的形状并不一样,这比「都变好了」更有信息量。伴侣犬从 13 升到 19 后停在 19;单车道桥 71→68→45→41 单调下降,是唯一一条干净的学习曲线;牧羊第 1 回合超时(4 只里赶进 3 只),此后每回合都赶进 4 只,分数在 88 上下小幅波动。装载机最能说明问题:第 1 回合清掉石头但再没进展得 30 分,第 2 回合得 0 分,第 3 回合回到 30,第 4 回合清石、送料入仓、停车,用掉 360 秒里的 329 秒拿到 90.9。
这个 0 分不该被读成噪声。每回合只有一局、没有多种子方差,所以这条曲线里的每一步都可能被单局的运气推着走;而第 2 回合的归零恰恰说明继承来的 playbook 也可能把智能体带偏——写进去的教训没有经过验证就影响了下一轮的判断。作者在 §7 里其实已经想到了解药:代码世界可以被精确重置和重放,所以一条教训在传下去之前是可以被测试的。目前这组实验里还没有这一步。
十三、局限
(作者自述,§7)几何条件是冗余的,而冗余的代价是丢细节。一旦物体形状已知,它的刚体运动只需几个位姿参数就能描述,而条件视频却在许多像素和帧上重复这些表面。空间下采样能省成本,但会移除精细控制所需的薄结构、窄缝隙和微小接触变化。
(作者自述,§7)几何没有规定的状态,渲染器就无从知道。一个旋转对称的物体可以绕轴自转而深度和法向毫无变化,尽管上面画的标记在转;材质、颜色、物体身份也不由几何决定。视觉历史能保住这些属性,但在长遮挡或超出记忆窗口的重访之后可能丢掉它们。作者提出的方向是更抽象紧凑的条件接口,比如描述物体属性和交互状态的结构化文本(可以写明一颗绕长轴自转的子弹的朝向和角速度,即使深度和法向图没变),或高维 latent 特征。接口同时决定了哪些世界根本没法呈现:只收几何的渲染器分不清转动的轮子和静止的轮子,依赖这类状态的任务今天就够不着。
(作者自述,§7)世界是一个一个手写的。「生成一个世界是容易的那部分」,难的是判断它值不值得一个智能体花时间:任务能不能只靠智能体看见的东西解出来、一个粗心的策略会不会失败、有没有一条能带进下一轮的教训。作者希望这些检查在任何智能体进新世界练习之前自动跑起来。经验侧同样有规模问题:这里的 playbook 属于单个世界且短到能整篇读完,跨很多世界时智能体必须决定哪些教训保留、合并或丢弃,并找出适用于眼前场景的那几条。
(本文判断)渲染质量只有定性对比,没有数值指标。第 4.1 节用 Fig.7 并排展示 30 秒 rollout:Self Forcing 随时间出现重复表面纹理、丢场景细节,Adversarial Forcing 保住自然纹理。这个结论完全靠肉眼——正文没有 FVD、没有 LPIPS、也没有对用户研究的引用。对一篇主张「渲染器可以当智能体的眼睛」的论文,这是最该补的一块证据:智能体的失败究竟有多少来自渲染失真,现在无从归因。
(本文判断)智能体侧的证据不可复现,且统计强度不足。仓库已开源渲染器训练与推理,但 README 的 TODO 里「代码世界与智能体练习回合」仍未勾选,所以第 5 节的全部结果今天无法重跑。同时表4、表5 每个回合只有一局、没有多种子、没有置信区间;表4 那个 2500 万局对 4 轮的对比,作者已经明说不是样本效率比值,但它仍然是最容易被引用时抽掉前提的一组数字。
(本文判断)「逐位相同」的保证有边界。表2 的 0 误差是在 replay 与 rollout 用同一套执行结构时成立的,训练里也确实这样跑(sgf_recovery_max_abs 在盯着它)。但线上服务走的是 CUDA graph + tiny decoder 的另一条路径,多智能体世界里两路第一人称画面的批处理方式也可能与训练时的分组不同。论文没有报告服务路径下的 replay 一致性,所以这条保证应理解为「训练期的历史梯度是精确的」,而不是「任何部署配置下都逐位可复现」。
十四、总结与展望
这篇技术报告的骨架是一次干净的职责划分:状态归引擎,画面归渲染器。引擎那边是可检查、可编辑、可精确重放的显式世界;渲染器那边是一个被改造成块因果、四步、36.5 fps 的视频模型,靠 Adversarial Forcing 里的两项工程贡献站住——exact replay 让历史编码进梯度且逐位对齐,exact R1/R2 让判别器正则在 fused attention 之上仍然精确。两边只通过 28 个几何 token 的窄接口相连,于是任何兼容引擎都能共用这一个渲染器,新世界的成本被压到「写一段粗糙几何代码」。
它给出的最有价值的经验证据不是 36.5 fps,而是「只看渲染画面的预训练智能体,能在几轮之内把网络规模预训练里的抽象工具知识落地成闭环物理执行」——以及与之配套的、把经验外化成可读文本的回合机制。这条路和自博弈 RL 不竞争:一个在权重里累积经验,一个在上下文里累积经验,前者要千万局,后者要几十局但受限于底座已有的先验。
往前看,三个中间台阶最值得盯:一是把条件接口从稠密几何视频换成结构化文本或 latent,让「轮子在转」这类状态可见,这决定能建的世界的边界;二是让编码智能体自动写世界并自动做「值不值得练」的准入检查;三是给 playbook 加一条验证环节——既然代码世界能精确重置重放,一条教训在传给下一轮之前完全可以先被测一遍。这三件事都还没有结果,但每一件都被论文说清了为什么难。
金句
生成一个世界是容易的那部分。更难的问题是它值不值得一个智能体花时间:任务能不能只靠它看见的东西解出来,一个粗心的策略会不会失败,以及有没有一条能带进下一轮的教训。