PAPER DEEP DIVE
HOTICE:人形机器人抱物穿越杂乱环境
HOTICE 以解耦的人-物势场、上下半身双智能体 PPO 与专精到通才蒸馏,让 Unitree G1 抱着箱子穿过侧面、顶部与地面障碍:仿真 2 万次试跑成功率 88.5%,真机 18 次成功 16 次。
原文标题:HOTICE: Whole-Body Humanoid Object Transportation in Cluttered Environments
作者:Toan Nguyen(共同一作)、Weiduo Yuan(共同一作)、Siheng Zhao、Yue Wang(共同指导)、Daniel Seita(共同指导)
机构:美国南加州大学(University of Southern California,USC Physical Superintelligence Lab)
论文链接:https://arxiv.org/abs/2609.25363(arXiv:2609.25363v1 [cs.RO],2026 年 9 月 21 日)
项目页:https://hotice2027.github.io(投稿期匿名)
代码状态:截至入库未开源。论文与项目页均未给出仓库链接,GitHub 检索 HOTICE、HumanoidPF 亦无对应仓库;训练框架为开源的 MuJoCo Playground(google-deepmind/mujoco_playground),势场与场景管线继承自 HumanoidPF(Xue et al., RA-L 2026,《Collision-free Humanoid Traversal in Cluttered Indoor Scenes》),双智能体结构受 FALCON(Zhang et al., L4DC 2026)启发。
一句话总结
HOTICE 把机器人自身的避障与它怀里那个箱子的避障写成两张解耦的势场向量图,让上、下半身两个智能体在 PPO 里各追各的奖励流、又靠共享观测与共享奖励保持整机协调,再把 75 个场景专精教师蒸馏成一个可部署的通才学生:20 个场景 20,000 次仿真试跑成功率 88.5%、平均离目标 0.130 米,真机 Unitree G1 在侧面、顶部、地面三类障碍上 18 次试跑成功 16 次。
研究背景与动机
物体搬运是机器人最基础的能力之一,末端配送、仓储物流、家庭协助都绕不开它。传统上这件事由三类平台承担,而它们各自的假设在开放世界里都会失效:固定基座机械臂工作空间有限,不能靠挪位置绕开障碍;轮式底盘要求地面相对平整可通行,遇到门槛、窄道和不规则通道就卡住;无人机载重小,还要求头顶有开放空域。
人形形态恰好对准这些失效点。整机 loco-manipulation 让它能抬脚跨过地面障碍、俯身钻过顶部遮挡,同时把手里的物体抱稳;与人同尺度的 footprint 让它能穿过为人类设计的窄侧隙与密集杂物;单一形态还能跨环境泛化,不必为每种场景定制一台专用平台。
但难点也在这里叠加。整机 loco-manipulation 本身就要协调上半身与下半身,动作空间高维;杂乱场景里机器人常常要摆出极端、非默认的姿势才能同时维持平衡与通过性;若手里还抱着一个沉重或体积大的物体,附加动力学与被压缩的 Clearance 会让安全通过难上加难。
文献的缺口正好落在两条研究线的交叉处。人形通过这条线——视觉 parkour、接触驱动整机控制、窄地形平衡、地形条件化技能组合,以及把人机关系编码为无碰撞运动方向的 HumanoidPF 和长时程文本导航 TANGO——都假设机器人「空手」,碰撞几何完全由自身运动学决定;人形搬运这条线——规划法联合轨迹、sim2real 箱子搬运、接触式拥抱大件、负载感知控制器、外感知越障与长时程搬运——则大多面向开放或轻度遮挡的场景,靠「绕过去」就能恢复 Clearance。真实杂乱却从地面、侧面、头顶三个方向同时收紧,机器人和它抱着的物体必须一起挤过剩下的自由空间。
于是任务定义得非常干净:机器人从起点 $\mathbf{s}$ 抱着物体 $\mathscr{O}$ 出发,把它送到目标 $\mathbf{g}$,全程不与障碍集合 $\mathscr{C}$ 相撞;成功指 5 秒内到达目标 0.1 米范围内,且没有跌倒、没有掉落、机器人与箱子都没有碰撞。论文以长方体箱子为主(质量上限 3.5 kg、尺寸上限 40×40×40 cm,与 G1 的载重和尺度匹配),但方法对圆柱、球同样适用;为补齐「拿起再搬走」的完整链路,作者另训了一个 pickup 策略从支撑面取箱,而方法描述与主实验默认物体已被抱持。
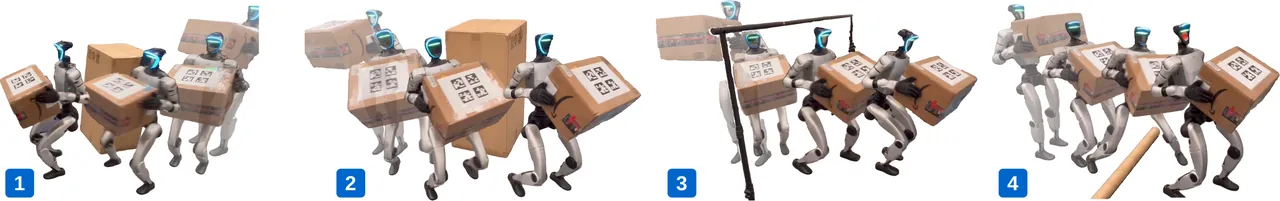
图 1:HOTICE 的任务谱系。(1)(2) 侧面障碍、(3) 头顶横杆、(4) 地面横杆——机器人抱着同一个纸箱,用不同的整机姿势挤过不同类型的 Clearance(论文 Figure 1)。
预备知识:势场、关键点查询与教师-学生蒸馏
人工势场(APF,Khatib 1986)用吸引场与排斥场之和的负梯度给出「朝目标走、离障碍远」的方向,经典问题是局部极小与缺乏全局结构。HumanoidPF 的两点改进被 HOTICE 继承:吸引场改用不穿过障碍的测地距离而非欧氏距离;场不在单点使用,而是在多个身体关键点查询,把「一个点的避障」变成「一组整机避障方向」。
关键点查询的含义值得说透:策略的输入不是场本身,而是各关键点(头、骨盆、脚等)处采样到的引导向量;奖励则让每个部位的笛卡尔速度尽量与该点的引导向量同向。场因此成为一种「可泛化的表示」——同一场景对不同策略给出同一张向量图,策略只学「如何跟随」,不学「如何感知几何」。
第三条预备知识是特权教师-学生蒸馏:教师看到无噪声、无延迟的特权状态,按场景专精训练;学生只看可部署观测(本体感知、物体状态、引导向量),先用 DAgger 对齐教师行为,再用 PPO 精修,并在学生训练里注入传感器噪声与控制延迟以压缩 sim2real 差距。HOTICE 复用 HumanoidPF 的场景构建管线:程序化生成的极限场景,加上从 3D-FRONT 数据集裁出的真实室内场景,前者推策略上限,后者保真现实分布。
方法详解
两张场:标准引导场与物体中心引导场
标准引导场(SGF)沿袭 HumanoidPF:吸引场是位置到目标的测地距离乘系数,排斥场是符号距离的分段函数,
$$\mathbf{U}_{\text{att}}(\mathbf{x}) = \eta\,\mathrm{D}_{\text{geo}}(\mathbf{x},\mathbf{g})$$
$$\mathbf{U}_{\text{rep}}(\mathbf{x}) = \begin{cases} \tfrac{1}{2}\xi\left(\tfrac{1}{\mathrm{sdf}(\mathbf{x})}-\tfrac{1}{d_{0}}\right)^{2}, & \mathrm{sdf}(\mathbf{x}) \leq d_{0} \\ 0, & \mathrm{sdf}(\mathbf{x}) > d_{0} \end{cases}$$
其中 $\mathrm{D}_{\text{geo}}$ 是不穿过障碍的最短路径长度,$\mathrm{sdf}$ 是对障碍集合的符号距离函数,$d_{0}$ 决定障碍影响范围。引导场取合势的负梯度:
$$\mathbf{F}_{\text{standard}}(\mathbf{x}) = -\nabla_{\mathbf{x}}\Big(\mathbf{U}_{\text{att}}(\mathbf{x}) + \mathbf{U}_{\text{rep}}(\mathbf{x})\Big)$$
超参 $d_{0}=0.2$ m、$\eta=0.6$、$\xi=1\times 10^{-3}$ 直接继承自 HumanoidPF。SGF 在头、肩、躯干、骨盆、膝、脚查询;对头、骨盆、脚三个部位,奖励最大化引导向量 $\mathbf{F}_{\text{standard}}(\mathbf{x})$ 与该部位笛卡尔速度 $\mathbf{v}$ 的余弦相似度。
物体中心引导场(OGF)是本文的第一处关键改动:先把障碍膨胀 margin $m=8$ cm 得到 $\mathscr{C}_{\text{inflated}}$,再对膨胀后的集合按完全相同的方式计算吸引场、排斥场与 $\mathbf{F}_{\text{object}}$。动机有两条。其一,物体不被关节直接驱动,margin 为传感器噪声与控制延迟买鲁棒性;其二,物体的避障必须「提前量」更足——脚可以临到地面横杆前才抬,而沉重或大体积的物体一旦贴近障碍就极难再挪,必须更早就开始让路。图 3 里橙色 OGF 在障碍附近比蓝色 SGF 更早弯折,正是这个提前量的可视化。
OGF 在物体关键点(箱子的 8 个角点)与控制物体的双手上查询。状态策略是轻量 MLP,关键点数量不拖累推理延迟,粒度因此可控——这为后文「换形状只换关键点」埋下伏笔。
OGF 的转向奖励是一个「相对量」:最大化 $\left[\mathbf{F}_{\text{object}}(\mathbf{x})-\mathbf{c}\right]$ 与 $\left[\mathbf{v}-\mathbf{c}\right]$ 的余弦相似度,其中 $\mathbf{c}$ 是从头、骨盆、脚的 SGF 向量聚合出的整体导航指令。减去 $\mathbf{c}$ 剥掉了走路本身已经产生的位移,奖励只记功 hands 真正负责的、由障碍驱动的残差调整——否则手会搭 locomotion 的便车,拿着走路的位移冒充避障的功劳。
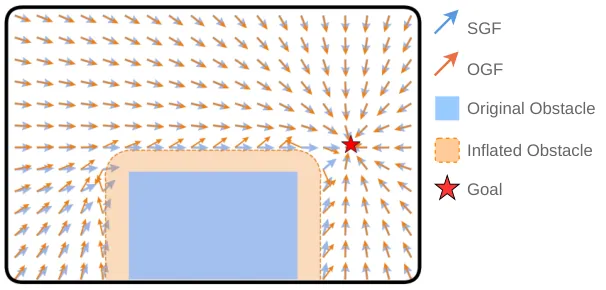
图 2:SGF(蓝)与 OGF(橙)在同一场景的向量场对比。OGF 相对膨胀后的障碍(米色)计算,箭头在障碍边缘更早偏转,给被抱物体留出余量(论文 Figure 3)。
双智能体:把 20 维动作拆成 8 + 12
受 FALCON 启发,HOTICE 不把整条策略当作单一学习智能体:上半身智能体管 8 个手臂关节,下半身智能体管 12 个腿部关节(腰与腕关节经实验验证对本任务无用,被排除)。每个智能体有自己的 actor 与特权 critic,但两者读同一份观测、共享终止条件——耦合发生在环境里,而不是一个单体网络里。两个 actor 分别输出 $\mathbf{a}_{\text{low}}\in\mathbb{R}^{12}$ 与 $\mathbf{a}_{\text{up}}\in\mathbb{R}^{8}$,拼成 20 维动作送进 PD 控制器出力矩。
奖励被划成三组:$\mathcal{L}$(locomotion、平衡)、$\mathcal{U}$(够到物体、维持抓握)、$\mathcal{S}$(抬升物体与 HOD-PF 奖励,其数值同时依赖手臂articulation与躯干姿态)。两条奖励流为
$$r_{\text{low}}=\sum_{i\in\mathcal{L}\cup\mathcal{S}}w_{i}r_{i},\qquad r_{\text{up}}=\sum_{i\in\mathcal{U}\cup\mathcal{S}}w_{i}r_{i}$$
每个智能体用自己的奖励流与价值函数估各自的优势 $\hat{A}_{\text{low}}$、$\hat{A}_{\text{up}}$,两个 PPO 裁剪目标相加后联合优化:
$$\mathcal{J}=\mathcal{J}^{\text{PPO}}_{\text{low}}\big(\hat{A}_{\text{low}}\big)+\mathcal{J}^{\text{PPO}}_{\text{up}}\big(\hat{A}_{\text{up}}\big)$$
共享组 $\mathcal{S}$ 同时进入两条流,于是两个智能体对「抱稳」共同负责;而 locomotion 与 grasping 的信号不再挤在同一个 advantage 估计里互相打架——这正是单智能体版本在极端姿势下失稳的病灶。
从专精到通才:75 个教师蒸成一个学生
教师策略并行训练、看特权状态、按场景专精,且不做任何逐场景奖励调参——解耦势场本身已经是可泛化的表示与奖励结构。训练好的教师经 DAgger 蒸馏进单一学生,学生再按同一套双智能体框架做 PPO 精修,训练时注入传感器噪声与控制延迟以缩小 sim2real 差距;全程在 MuJoCo Playground 中训练。主实验用 20 个场景、每个教师 400M 步;泛化实验把规模推到 75 个教师、75 个场景,蒸出的通才学生再去 50 个未见场景接受检验。
形状泛化住在关键点里
圆柱的关键点取顶缘均布 4 点加底缘均布 4 点;球取世界系下 8 个象限方向、半径处的固定点。三种形状都恰好 8 个关键点,于是观测布局、网络结构、动作空间完全不变;只对手 placement 与物体 upright 做最小的形状特定奖励调整,其余奖励项、权重、超参全部从箱子策略继承。形状信息被压缩成「8 个查询点放在哪」这一件事。
真机部署:SLAM 建图 + AprilTag 箱姿
真机链路上,G1 先空手绕场走一圈用 SLAM 重建障碍;推理时 HOD-PF 引导向量由实时定位与关节角在线计算,箱子位姿由贴在箱上的 AprilTags 加头部相机估计;pickup 策略与搬运策略都以 50 Hz 运行。作者指出活体 LiDAR 重建原则上可行,但 G1 只有一颗 LiDAR、视场又被怀里的箱子挡住——他们把这归为硬件限制而非方法限制。
flowchart TD
  SCN["杂乱场景 侧面 顶部 地面障碍"] --> SDF["障碍符号距离场 sdf"]
  SDF --> SGF["标准引导场 SGF 查询 头 肩 躯干 骨盆 膝 脚"]
  SDF --> INF["障碍膨胀 margin 8cm"]
  INF --> OGF["物体中心引导场 OGF 查询 物体 8 关键点 与双手"]
  SGF --> OBS["共享观测 引导向量 本体感知 物体状态"]
  OGF --> OBS
  OBS --> UP["上半身 actor 与特权 critic 8 个手臂关节"]
  OBS --> LO["下半身 actor 与特权 critic 12 个腿部关节"]
  UP --> RUP["奖励流 r_up 取 U 组并 S 组"]
  LO --> RLO["奖励流 r_low 取 L 组并 S 组"]
  RUP --> JOINT["联合 PPO 目标 J 共享 S 组保持整机协调"]
  RLO --> JOINT
  JOINT --> PD["20 维动作 经 PD 控制器出力矩"]
  PD --> TEA["场景专精特权教师 并行训练 无逐场景调参"]
  TEA --> DAG["DAgger 蒸馏 加 PPO 精修 注入噪声与延迟"]
  DAG --> STU["通才学生策略"]
  STU --> REAL["真机 Unitree G1 SLAM 建图 AprilTag 箱姿 50Hz"]
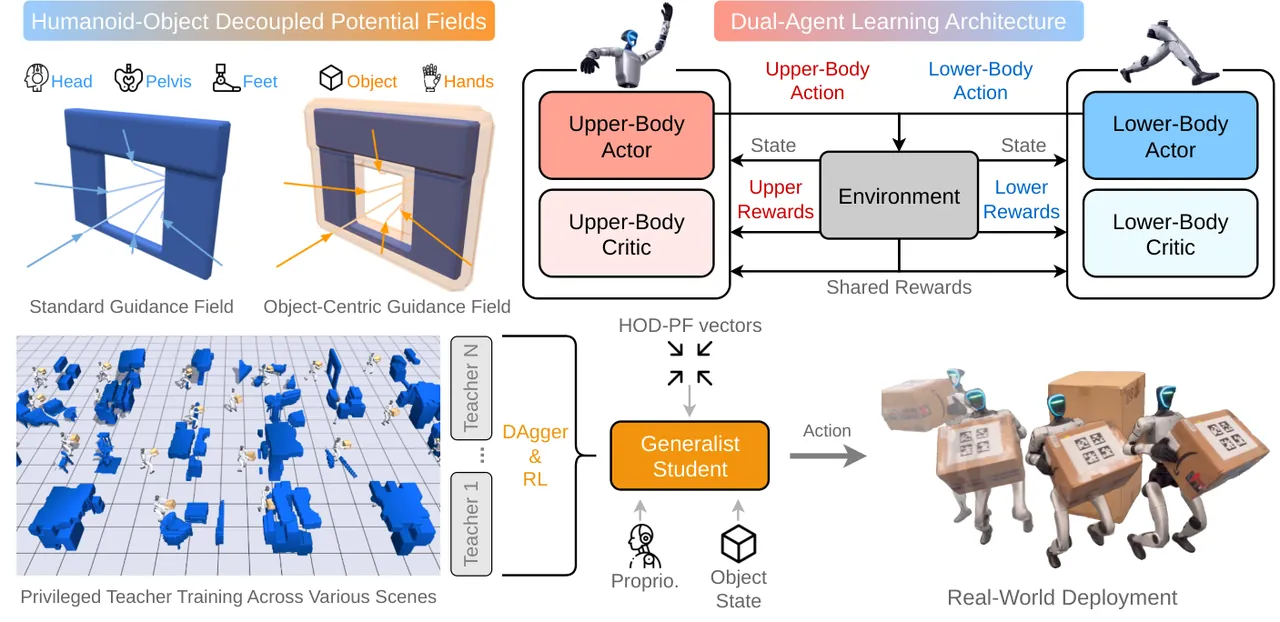
图 3:方法总览。左上为两张解耦引导场,右上为双智能体架构(共享观测与共享奖励、各自奖励流),下方为教师-学生蒸馏与真机部署链路(论文 Figure 2)。
实验结果
主实验的设计是「自消融」:因为没有先前工作直接处理该设定,作者用三个变体当基线——只用 SGF(相当于把 HumanoidPF 朴素地套到机器人加物体的全部关键点)、单智能体加 HOD-PF、单智能体加 SGF。四种方法各自在 20 个场景上训 400M 步教师再蒸成学生;箱子质量与尺寸随机化;评估时注入输入噪声、延迟与扰动;20 个场景各跑 1,000 次、合计 20,000 次试跑。指标为成功率 SR(5 秒内到目标 0.1 m 内、不跌不掉不撞)与平均离目标距离 mDist。
| 方法 | SR (%) ↑ | mDist (m) ↓ |
|---|---|---|
| Single-Agent & SGF | 58.7 | 0.296 |
| Single-Agent & HOD-PF | 65.7 | 0.267 |
| Dual-Agent & SGF | 77.1 | 0.195 |
| Dual-Agent & HOD-PF(HOTICE) | 88.5 | 0.130 |
表 1:仿真主实验,20 场景 × 1,000 次 = 20,000 次试跑(论文 Table I)。
读法是把两个贡献拆开看:单智能体下加 OGF,SR 从 58.7 升到 65.7(+7.0);双智能体配 SGF 已到 77.1(相对单智能体 SGF +18.4);两者齐备才到 88.5(相对双智能体 SGF 再 +11.4)。mDist 从 0.296 米压到 0.130 米,降幅 56%。图 4 的 (A) 组给出两种失败模式的对照:Dual-Agent & SGF 的手与箱子刮蹭障碍——架构对了但场没解耦;Single-Agent & HOD-PF 跨地面横杆时失稳掉箱——场对了但架构撑不住极端姿势。两个贡献因此是互补而非冗余。
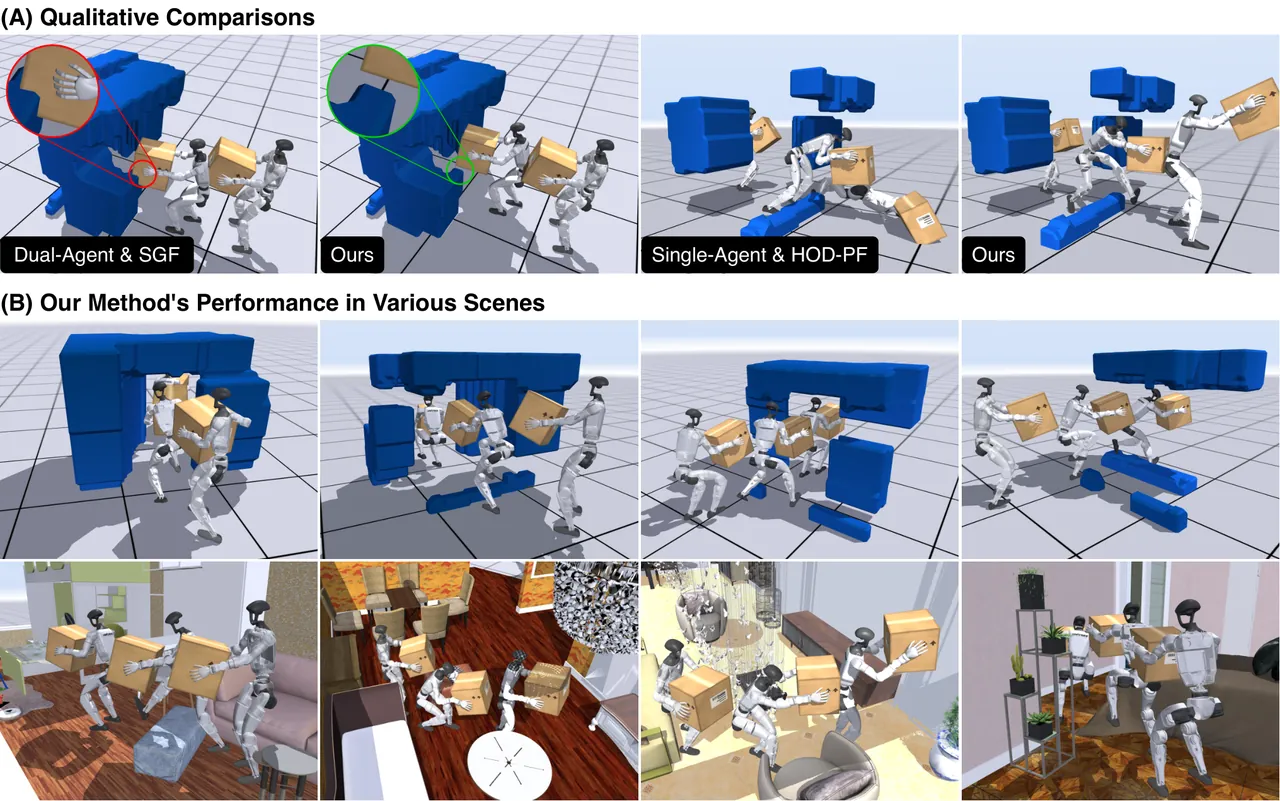
图 4:(A) 消融对照——左对显示解耦势场如何避免手/箱刮蹭,右对显示双智能体如何在跨障时保住平衡;(B) 程序化场景(上排)与 3D-FRONT 真实室内场景(下排)下的搬运过程,全程无逐场景奖励调参(论文 Figure 4)。
泛化实验把教师规模推到 75 个、场景 75 个,蒸出的通才学生在 50 个未见场景上评估。场景相似度定义在方法自己的表示上:把未见场景与训练场景的 SGF、OGF 以 $(0.04\,\mathrm{m})^{3}$ 的分辨率离散化,对两张场、所有位置上的引导向量取平均余弦相似度,再对训练场景取最大值作为该未见场景的相似度。图 5 显示相似度越低 SR 越低、mDist 越高,但退化平缓:平均 SR 80.1%(下限约 70%)、平均 mDist 0.270 m,最小二乘拟合的 RMSE 分别为 6.1 与 0.092。
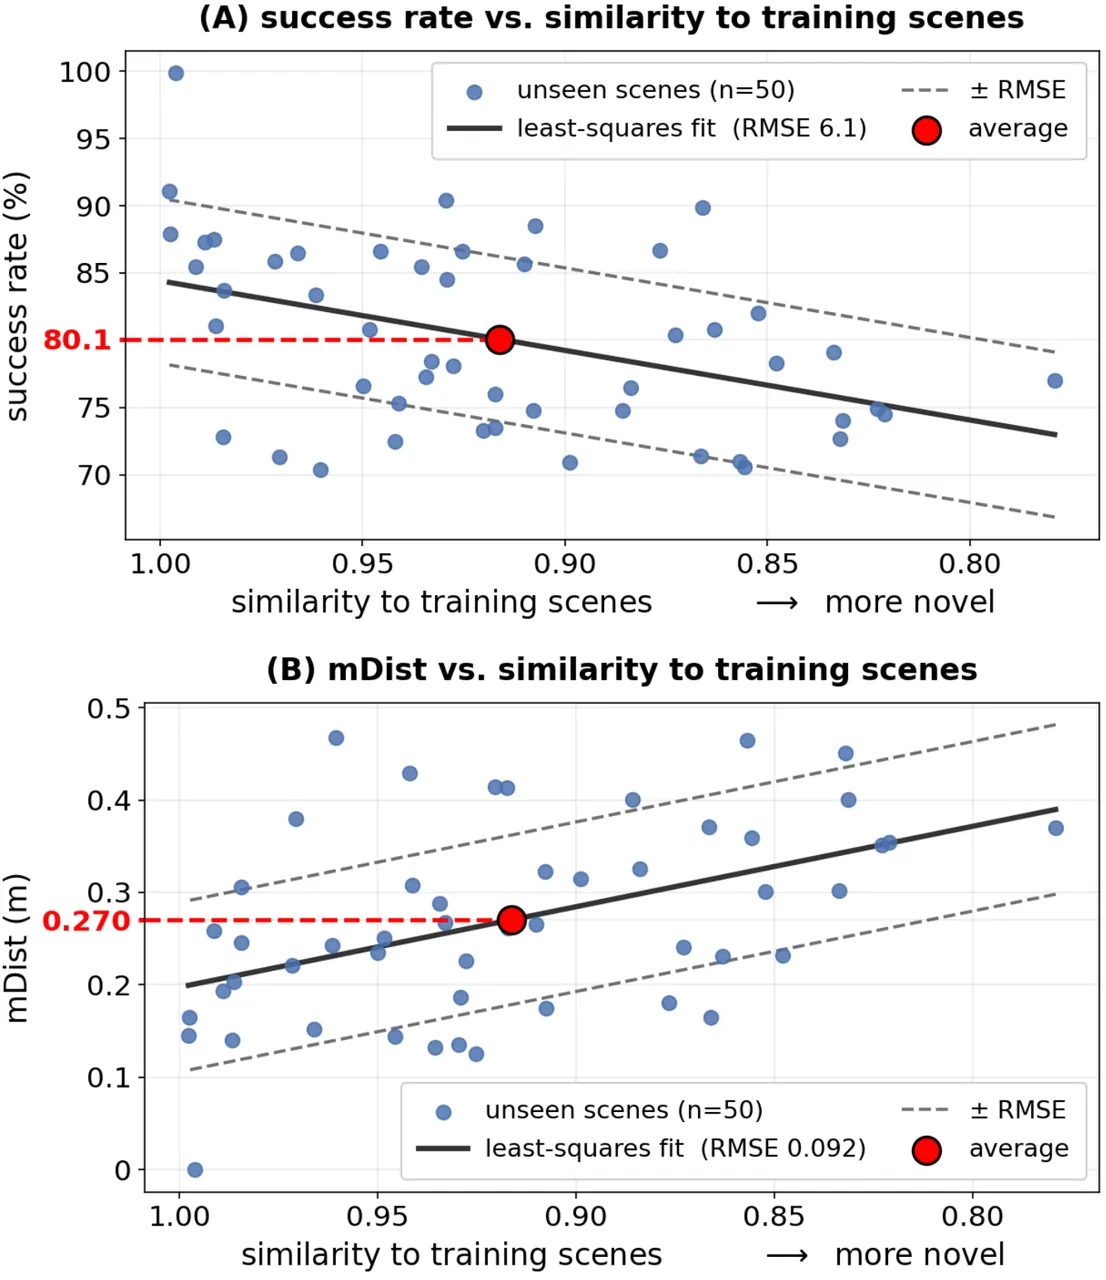
图 5:50 个未见场景散点。(A) 成功率对训练集相似度,均值 80.1%、拟合 RMSE 6.1;(B) mDist 对相似度,均值 0.270 m、拟合 RMSE 0.092(论文 Figure 5)。
| 未见场景泛化指标 | 均值 | 最小二乘拟合 RMSE | 样本 |
|---|---|---|---|
| 成功率 SR (%) | 80.1 | 6.1 | 50 个未见场景 |
| mDist (m) | 0.270 | 0.092 | 50 个未见场景 |
表 2:通才学生在未见场景上的汇总统计(读自论文 Figure 5 的标注与正文)。
形状泛化的结果几乎「平」得可疑地好:长方体 88.5 / 0.130,圆柱 86.7 / 0.127,球 87.2 / 0.131——SR 差距不超过 1.8 个百分点,mDist 三位小数同量级。这正印证了设计意图:形状只通过「8 个关键点放在哪」进入策略,观测、网络、动作空间一律不变,剩下的差异交给两处最小的形状特定奖励。
| 物体形状 | OGF 关键点取法 | SR (%) ↑ | mDist (m) ↓ |
|---|---|---|---|
| 长方体 | 8 个角点 | 88.5 | 0.130 |
| 圆柱 | 顶缘 4 点 + 底缘 4 点 | 86.7 | 0.127 |
| 球 | 世界系 8 个象限方向、半径处 | 87.2 | 0.131 |
表 3:三种形状的策略在同一 20 场景上的结果;长方体一行与表 1 的本文方法相同(论文 Table II)。
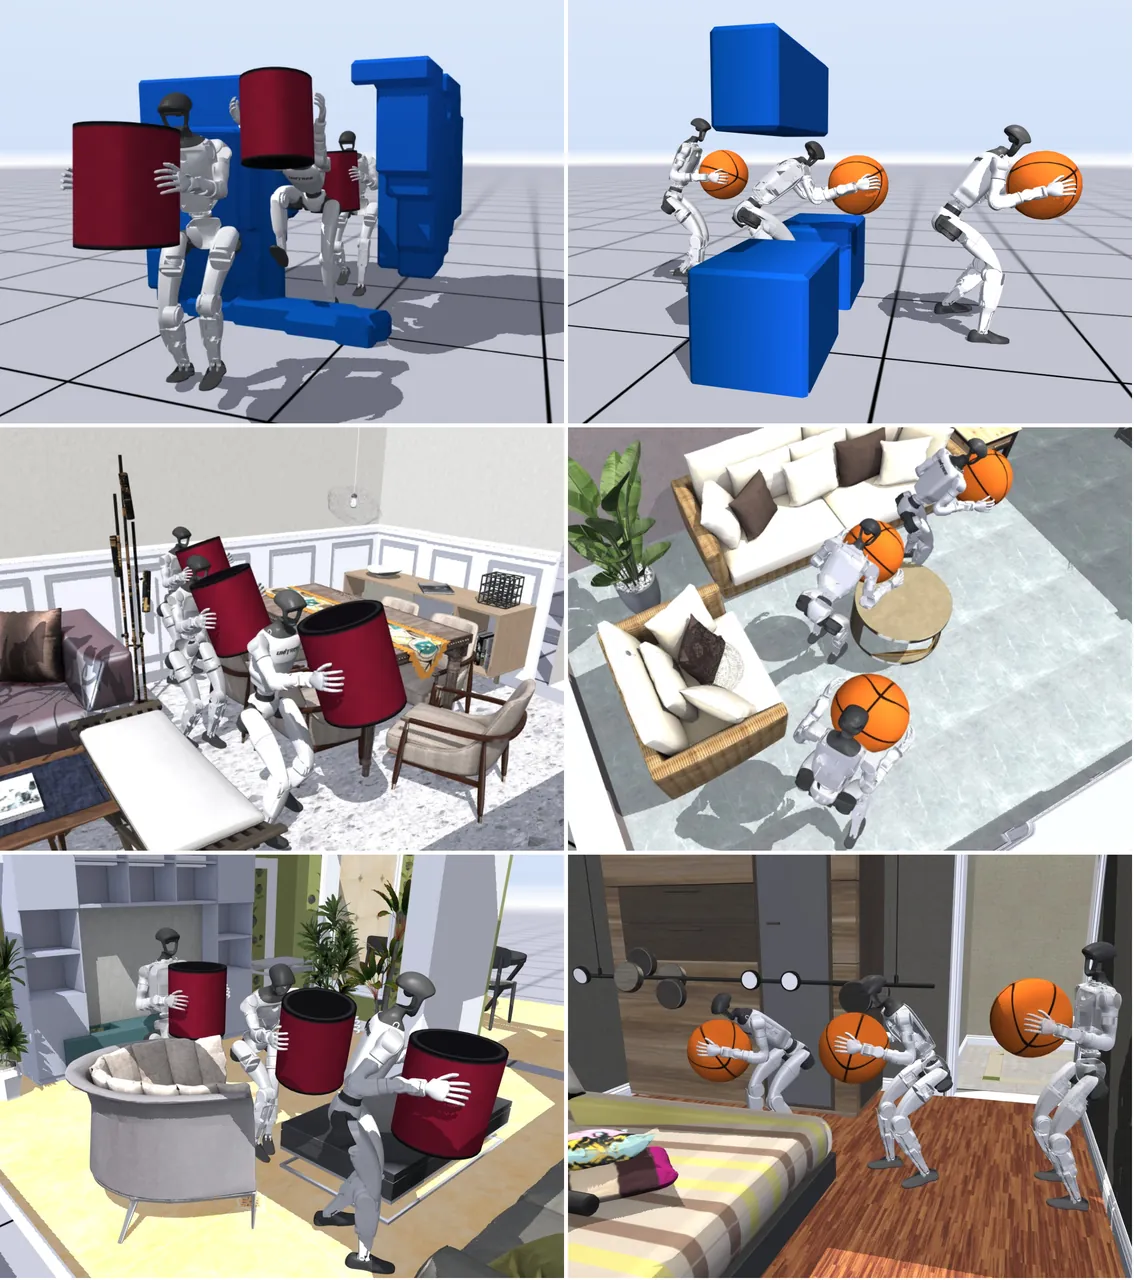
图 6:圆柱(左列)与球(右列)在程序化与真实室内场景中的搬运,仅做最小形状特定奖励调整(论文 Figure 6)。
真机实验在 Unitree G1 上进行,三类障碍各 6 次试跑:每次先由共享的 pickup 策略从支撑面取箱,再交给搬运策略,两者 50 Hz 运行。HOTICE 侧面 6/6、顶部 5/6、地面 5/6,合计 16/18;对照里最好的是 Dual-Agent & SGF 的 12/18。值得注意的是真机上的排序与仿真不同:Single-Agent & HOD-PF(11/18)反而输给 Dual-Agent & SGF(12/18),提示在真实硬件上「稳」(双智能体的贡献)比「场解耦」更稀缺;而地面障碍对所有方法都最难(最差 1/6),因为跨栏要求极端单腿支撑姿势。图 7 的三组真机帧把这三件事拍得很直白:HOTICE 依次让过侧立杆、办公椅与地面纸管;Dual-Agent & SGF 撞上侧面纸箱;Single-Agent & HOD-PF 脚绊地面纸管后倒地。
| 方法 | 侧面障碍 | 顶部障碍 | 地面障碍 | 合计 |
|---|---|---|---|---|
| Single-Agent & SGF | 3/6 | 3/6 | 1/6 | 7/18 |
| Single-Agent & HOD-PF | 6/6 | 3/6 | 2/6 | 11/18 |
| Dual-Agent & SGF | 4/6 | 4/6 | 4/6 | 12/18 |
| Dual-Agent & HOD-PF(HOTICE) | 6/6 | 5/6 | 5/6 | 16/18 |
表 4:真机实验,每类障碍 6 次试跑(论文 Table III)。每格 6 次意味着一次试跑值 16.7 个百分点,单格一两次之差并不构成统计显著,论文也未给置信区间。
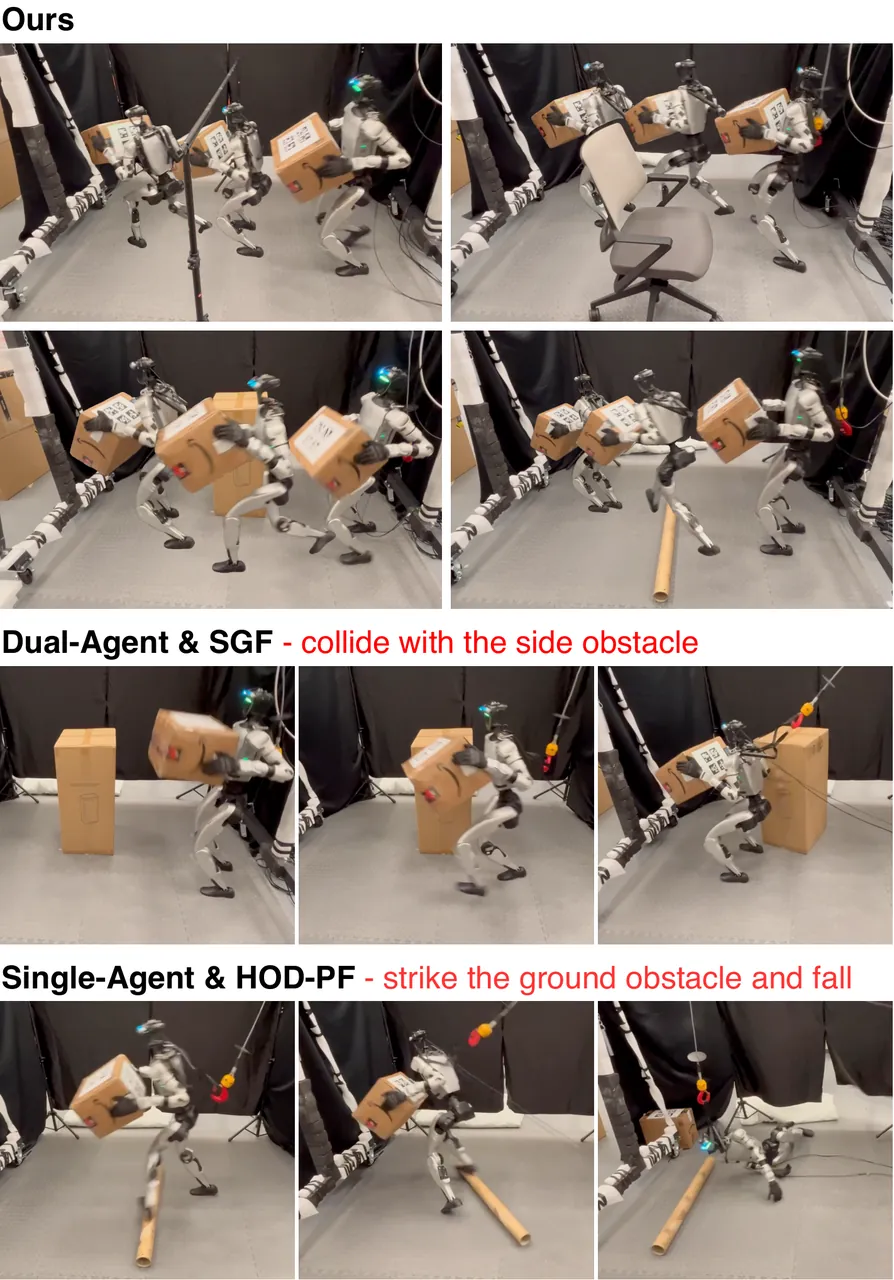
图 7:真机 rollouts。上排 HOTICE 通过侧杆、座椅、侧箱与地面纸管;中排 Dual-Agent & SGF 撞侧面障碍;下排 Single-Agent & HOD-PF 绊地面障碍跌倒(论文 Figure 7)。
局限性
作者自述的局限有四条。其一,不建模碰撞后行为:若碰撞扰动超过恢复能力,机器人直接跌倒。其二,更复杂的搬运策略够不着——把物体扛上肩、夹在髋侧这类姿势不在能力集内。其三,不处理动态场景与移动障碍。其四,未考虑「可接受碰撞」与主动障碍交互:靠墙挤过窄隙、蹭过豆袋沙发而不受罚,或用脚踢开小障碍、用背顶开门,都留给未来工作。
我的第一点判断是感知闭环未补齐:场景要靠 SLAM 预先建图,箱子要贴 AprilTags 才能估位姿,因此这是一个「定位依赖」的系统而非感知完备的系统;作者自己也承认活体 LiDAR 重建被单 LiDAR 视场遮挡挡住。第二点判断是泛化度量的循环性:未见场景相似度定义在方法自己的表示(SGF/OGF 余弦相似)上,「场景长得像」与「表示能编码」几乎是同一件事,换一个外部度量结论是否稳健尚不可知。第三点判断是载荷与抓握的范围:3.5 kg、40 cm 立方上限且默认物体已被抱持,抓握合成、重载与偏心载荷都在范围外;势场超参 $d_{0}$、$\eta$、$\xi$ 继承自前作、margin 取 8 cm 只有一句「平衡避障与通过性」的说明,没有扫参曲线。
总结与展望
HOTICE 对「人形如何抱物穿杂」的回答分三层:把几何写成两张解耦势场,让机器人与物体各拿一张地图;把控制拆成双智能体,各背各的奖励流、靠共享观测与共享奖励保持整机协调;把经验蒸成通才,75 个场景专精教师汇成一个可部署学生。数字逐层兑现:仿真 20,000 次试跑 88.5% / 0.130 m,未见 50 场景 80.1% / 0.270 m,真机 18 次试跑成 16 次。
它留下的方向同样清楚:碰撞后恢复、动态障碍、可接受接触与主动障碍交互、更丰富的搬运姿势,以及摆脱 AprilTag 与预建图的感知闭环。对即将走进仓库与家庭的人形机器人而言,「抱着东西过门」比「空手 parkour」更接近日常;HOTICE 把这件日常事第一次做成了可训练、可蒸馏、可上真机的控制问题。
金句
机器人可以临到横杆前才抬脚,怀里的箱子却必须提前半米让路——HOTICE 把这个时间差写进两张势场,并让双手只领那份真正属于它们的残差功劳。