PAPER DEEP DIVE
FAR:失败感知重试——测试时自我恢复与策略持续改进
离线示范训练出的机器人策略一旦部署到真实环境就难免失败:抓空、掉物、碰倒物体,而这些失败状态在示范数据里几乎没出现过,直接重跑只会重复同一个错误。CMU 团队提出失败感知重试 FAR:失败后不重置环境,而是保留现场、把机械臂退回起始位姿再试。FAR 先用 IQL 风格的保守价值函数对失败轨迹做归因,按价值增量 ΔV 的分位数挑出致败动作块作为负样本;再从当前策略采样候选动作块,经距离过滤与 critic 打分挑出 Top-K 正样本,组成对比偏好对;最后用扩散版偏好优化目标只做 10 步梯度更新(单卡约 1.5–3 秒),把策略从失败行为上推开,并在重试时注入时间平滑的高斯扰动做局部探索。成功的恢复轨迹再进入回放缓冲,用优势加权的去噪目标做持续策略改进。在 ManiSkill、RoboSuite、RoboMimic 九个仿真任务上,FAR 比标准扩散策略平均高 17.6 个百分点;xArm 真机三个任务上平均高 11.7 个百分点(80.0% 对 68.3%),同时减少在线学习所需的环境重置次数。
FAR:失败感知重试——在测试时从失败中学习,并让策略持续变强
论文:FAR: Failure-Aware Retry for Test-Time Recovery and Continual Policy Improvement | 作者:Haoran Hao, Shahram Najam Syed, Jeffrey Ichnowski, Jeff Schneider | 机构:卡内基梅隆大学机器人研究所(Robotics Institute, CMU) | 链接:https://arxiv.org/abs/2607.01111 | 代码:https://github.com/Hoar012/FAR (MIT 许可证,CoRL 2026 官方实现) | 状态:CoRL 2026 录用,v2(2026-10-07)
一句话总结
FAR 让机器人在失败之后不重置环境、不叫人类:用保守 critic 把失败归因到少数几个动作块,从当前策略里采样并筛选出「更好的替代动作」组成偏好对,只做 10 步扩散偏好优化(1.5–3 秒)再重试;重试时叠加时间平滑的小扰动做局部探索,而成功的恢复轨迹再回流到训练循环里做持续改进。九个仿真任务平均比标准扩散策略高 17.6 个百分点,xArm 真机三个任务平均高 11.7 个百分点。
研究背景与动机
离线示范训出来的机器人策略,在实验室指标上可以很漂亮,一旦部署就会撞上示范数据里没有的状态:抓取时差了几毫米、物体被碰倒、杯子滑到桌边。这些失败状态对预训练策略而言是分布外(OOD)的,于是「再跑一遍」往往只是把同一个错误重演一次——策略在失败状态附近没有任何新信息可用,采样出来的动作和上一次几乎一样。
现有解法大致分三类,各有代价。第一类请人类出手:DAgger 及其后续的人机共驾式纠正,效果好但人力昂贵,且把「部署」变成了「又一次数据采集」。第二类请大模型当裁判:用预训练 VLM 检测失败、用语言推理给出纠正方向,推理延迟与提示工程成本都不低,且纠正最终仍要落到动作层。第三类用强化学习单独训一个恢复策略,等于承认主策略不会自救,需要额外一个模块与额外一份训练预算。
与本文最接近的是重试类方法(retry-based recovery),尤其是 Bellman-Guided Retrials(BGR):它比较「期望的任务进度」与「观测到的任务进度」,在重试时用拒绝采样把动作推离先前失败的动作。BGR 是非参数的——测试时不更新任何权重,只维护一份失败记忆库。这带来一个本文反复攻击的弱点:失败的那一次交互往往已经改变了环境(罐子被推走了),而记忆库里存的是旧状态,距离度量在状态被扰动后就不再可靠。
FAR 的出发点因此很直接:失败本身携带监督信号,而且是最便宜的一种。问题只在于两个:其一,如何从一条失败轨迹里找出「该怪谁」;其二,策略的动作分布来自离线示范,在 OOD 状态处几乎没有探索能力,即使知道该躲开什么,也未必采样得到更好的动作。前者交给失败归因与偏好学习,后者交给重试时的轻量扰动。
方法总览
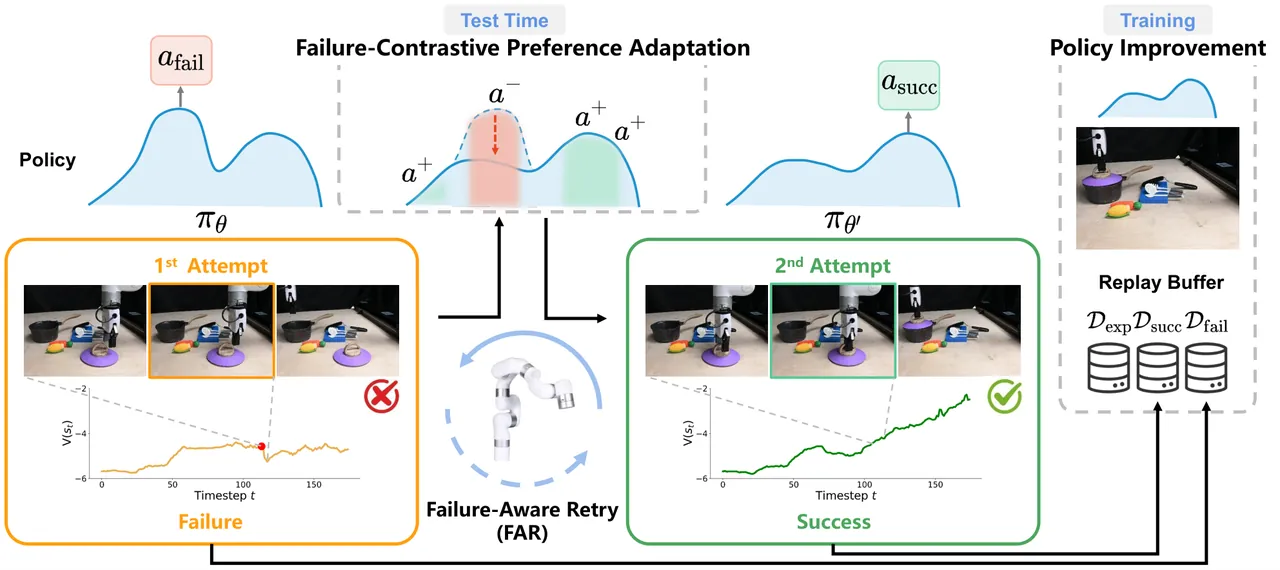
图 1:FAR 总体框架。第一次尝试失败后,FAR 用价值估计定位致败动作,把失败样本与替代正样本一起用于测试时更新;收集到的轨迹进入回放缓冲,供持续策略改进使用。
部署协议是全文的隐藏主角:失败发生后不重置环境,只把机械臂退回预定义的起始位姿,物体与环境保持失败后的原样,然后允许最多 N 次重试(仿真默认 5 次、真机 3 次)。这个协议既贴近真实部署(没人帮你摆回去),也强迫策略学会在「被自己弄乱的现场」里完成任务。奖励信号只用于训练 critic;测试时自适应阶段不需要任何任务级稠密奖励,只需要「这一次成功与否」的结果反馈。
保守价值估计:先学会不乐观
失败归因需要一个价值函数,而失败状态恰恰是 OOD 的——标准 Q 学习在这些状态上会系统性地高估价值(外推误差),归因就会指错凶手。FAR 采用 Implicit Q-Learning(IQL)的目标来训练 chunk 条件化的 critic:一个状态价值网络 $V_{\psi}$ 与一个动作块价值网络 $Q_{\phi}$,
$$\mathcal{L}_{V}=\mathbb{E}_{(s,\mathbf{a})\sim\mathcal{D}}\left[L_{2}^{\tau}\left(Q_{\phi}(s,\mathbf{a})-V_{\psi}(s)\right)\right],$$
$$\mathcal{L}_{Q}=\mathbb{E}_{(s,\mathbf{a},s^{\prime})\sim\mathcal{D}}\left[\left(r(s,\tilde{a})+\gamma V_{\psi}(s^{\prime})-Q_{\phi}(s,\mathbf{a})\right)^{2}\right],$$
其中 $L_{2}^{\tau}(u)=|\tau-\mathbf{1}(u<0)|u^{2}$ 是 expectile 回归损失($\tau=0.7$),$\mathbf{a}=a_{1:H}$ 是长度 $H=8$ 的动作块。环境实际只执行经时间聚合后的单步动作 $\tilde{a}=g(\mathbf{a})$,因此 TD 目标用 $\tilde{a}$ 定义,而 $Q_{\phi}(s,\mathbf{a})$ 扮演的是「给候选动作块打分」的角色。IQL 的保守性来自它只在离线数据支持过的动作上学习价值,不做 OOD 动作的外推——这正是失败状态处最需要的性质。
失败归因:按价值跌幅抓凶手
给定失败轨迹 $\xi=\{(s_t,a_t)\}_{t=0}^{T}$,对每个动作块 $\mathbf{a}_t=a_{t:t+H-1}$ 计算它造成的价值变化 $\Delta V_t=V_{\psi}(s_{t+H})-V_{\psi}(s_t)$。由于任务完成前奖励为负,价值通常随任务推进而上升;一段动作若让价值显著下跌,就说明它把局面推向失败。FAR 不用固定阈值,而是把整条轨迹的所有块按 $\Delta V_t$ 排序,取最低 $\rho$ 分位(默认 $\rho=10\%$)作为负样本:
$$\xi^{-}=\left\{(s_t,\mathbf{a}_t^{-})\mid \Delta V_t \leq \mathrm{Percentile}_{\rho}(\{\Delta V_j\})\right\}.$$
分位数而非阈值是一个务实的选择:阈值需要按任务调,且不同任务的价值尺度不可比;分位数保证「每条失败轨迹都贡献固定比例的负样本」,梯度规模稳定。消融也支持这一点——固定阈值版本平均 73.0,整条轨迹全当负样本的版本平均 72.0,都低于分位数版本的 74.9。
对比样本构造:躲开坏的,还要知道好的长什么样
只给负样本会让更新方向不确定:把失败动作的概率压下去之后,概率质量可能流向任何地方,甚至破坏策略原有的多峰结构。FAR 因此为每个负样本配一组正样本。先从当前策略采样 $M=64$ 个候选动作块 $\mathcal{C}(s_t)=\{\mathbf{a}_t^{(i)}\}$,再按与负样本的 $L^2$ 距离过滤,只保留「偏离程度适中」的候选:
$$\mathcal{C}_{\mathrm{safe}}(s_t)=\left\{\mathbf{a}_t^{(i)}\in\mathcal{C}(s_t)\mid d_{\min}\leq d(\mathbf{a}_t^{(i)},\mathbf{a}_t^{-})\leq d_{\max}\right\},$$
太近的候选与失败动作几乎相同,学了等于没学;太远的候选超出策略支持,critic 的打分不可信。实现里 $d_{\min}$ 取候选与负样本距离的均值 $\bar{d}$,$d_{\max}=1.0$。过滤后的候选交给 critic 打分,取价值最高的 $K=8$ 个作为正样本:
$$\mathcal{A}_t^{+}=\operatorname{TopK}_{\mathbf{a}\in\mathcal{C}_{\mathrm{safe}}(s_t)}Q_{\phi}(s_t,\mathbf{a}).$$
于是每个失败状态得到一组偏好对 $\{(\mathbf{a}_t^{+},\mathbf{a}_t^{-})\}$:在同一个状态下,这个动作应该比那个动作更被偏好。消融显示把 critic 排序换成随机挑选,平均成功率从 74.9 掉到 72.3;$K=1$ 掉到 71.4,$K=16$ 掉到 68.0——正样本太少方向不稳,太多则混入噪声正样本、优化方向互相打架。
FCPA:把偏好对变成 10 步梯度
扩散策略没有显式的动作似然,不能直接套 DPO。FAR 沿用扩散模型偏好优化的做法,用「去噪损失的负值」作为偏好分数的代理:对动作块 $\mathbf{a}$ 与状态 $s$,定义 $\ell_{\mathrm{diff}}(\mathbf{a},s;\theta)=\mathbb{E}_{k,\boldsymbol{\epsilon}}\left[\|\boldsymbol{\epsilon}-\boldsymbol{\epsilon}_{\theta}(\mathbf{a}_k,s,k)\|^{2}\right]$,其中 $\mathbf{a}_k$ 是给 $\mathbf{a}$ 加第 $k$ 步高斯噪声的结果。偏好目标为
$$\mathcal{L}_{\mathrm{pref}}=-\log\sigma\left(\beta\left[\ell_{\mathrm{diff}}(\mathbf{a}_t^{-},s_t;\theta)-\ell_{\mathrm{diff}}(\mathbf{a}_t^{+},s_t;\theta)\right]\right),$$
$\sigma$ 是 sigmoid,$\beta=0.1$ 控制偏好强度。最小化它等价于让模型给正样本更低的去噪误差、给负样本更高的去噪误差,从而在采样时把概率质量从失败行为移向恢复行为。整个测试时自适应只做 $n_{\mathrm{tta}}=10$ 步 AdamW(学习率 $1\times10^{-5}$),单张 A5000 上耗时约 1.5–3 秒——比重试一次动作本身还便宜。作者还报告了步数扫描:步数过多反而掉点,解释是对局部自适应数据过拟合。
重试扰动:给探索一点噪声,但别抖坏真机
FCPA 解决了「躲开旧的错误」,但策略的采样支持仍受离线数据限制:在 OOD 状态处,它可能根本采不到那条能绕开障碍的路径。FAR 在执行层注入轻量扰动:以概率 $\epsilon_{\mathrm{explore}}=0.5$ 采样一个目标扰动 $\boldsymbol{\delta}^{\star}\sim\mathcal{N}(\mathbf{0},\Sigma)$(每维标准差 0.1)并保持若干步不变,否则置零;实际施加的扰动做指数平滑 $\boldsymbol{\delta}_t=\alpha\boldsymbol{\delta}_{t-1}+(1-\alpha)\boldsymbol{\delta}^{\star}$($\alpha=0.3$),最终执行
$$\tilde{a}_t=\hat{a}_t+\boldsymbol{\delta}_t,$$
其中 $\hat{a}_t=g(\mathbf{a}_t)$ 是时间聚合后的动作。平滑不是为了好看:真机上高频噪声会让机械臂抖动甚至损伤硬件,作者只把扰动加在末端执行器 delta 动作的平移分量上。消融里 $\epsilon_{\mathrm{explore}}=0.5$ 是最佳折中(平均 74.9);0.0 时长程任务(Door)尚可但短程任务卡死在局部最优,1.0 时短程任务受益而长程任务被推出训练分布。平滑版与纯高斯版在仿真上成绩接近(73.8 对 74.9),但前者对真机更友好——这是少数「为部署而牺牲一点仿真分数」的诚实选择。
flowchart TB
    START[Attempt i: roll out policy in the kept scene] --> JUDGE{Success?}
    JUDGE -- yes --> SUCC[Trajectory to D_succ, episode ends]
    JUDGE -- no --> ATTR[Score every chunk by value drop dV_t = V(s_t+H) - V(s_t)]
    ATTR --> NEG[Negatives: chunks at or below the rho=10% percentile of dV]
    NEG --> CAND[Sample M=64 candidate chunks from current policy]
    CAND --> FILT[Keep candidates whose L2 distance to the negative lies in d_min to d_max]
    FILT --> TOPK[Critic ranks survivors, keep top-K=8 positives]
    TOPK --> PREF[10 AdamW steps on the diffusion preference loss, about 1.5-3 s]
    PREF --> PERT[Retry with temporally smoothed Gaussian perturbation, eps=0.5]
    PERT --> START
    SUCC --> CPI[Critic update on D_exp + D_succ + D_fail]
    CPI --> AWR[Advantage-weighted denoising update on D_exp + D_succ only]
图 2(本文绘制):FAR 单个 episode 的控制流。测试时循环只更新策略权重 10 步;持续改进循环在 episode 结束后用三个回放缓冲更新 critic 与 actor。
从恢复轨迹到持续策略改进
重试成功的那条轨迹,是全文最值钱的数据:它从「初始策略必然失败」的状态出发并完成了任务,恰好标注了当前能力边界在哪里。FAR 维护三个缓冲:离线示范 $\mathcal{D}_{\mathrm{exp}}$、在线成功轨迹(含恢复成功的)$\mathcal{D}_{\mathrm{succ}}$、失败轨迹 $\mathcal{D}_{\mathrm{fail}}$。每个学习 epoch 采 20 个 episode,先用聚合数据 $\mathcal{D}=\mathcal{D}_{\mathrm{exp}}\cup\mathcal{D}_{\mathrm{succ}}\cup\mathcal{D}_{\mathrm{fail}}$ 更新 critic(失败轨迹也进 critic 的训练集,让它们帮价值函数认清坏状态),再计算优势 $A(s,\mathbf{a})=Q_{\phi}(s,\mathbf{a})-V_{\psi}(s)$ 与权重 $w(s,\mathbf{a})=\exp(A(s,\mathbf{a})/\eta)$($\eta=1.0$),但 actor 只在 $\mathcal{D}_{\mathrm{exp}}\cup\mathcal{D}_{\mathrm{succ}}$ 上更新:
$$\mathcal{L}_{\pi}=\mathbb{E}_{(s,\mathbf{a}_0)\sim\mathcal{D}_{\mathrm{exp}}\cup\mathcal{D}_{\mathrm{succ}},\,k,\,\boldsymbol{\epsilon}}\left[w(s,\mathbf{a}_0)\left\|\boldsymbol{\epsilon}-\boldsymbol{\epsilon}_{\theta}(\mathbf{a}_k,s,k)\right\|^{2}\right].$$
这个「critic 看全部、actor 只看好的」的不对称设计,是在防止行为克隆被停滞与半失败轨迹污染。效果体现在数据效率上:按环境重置次数计,FAR 每个 episode 产出更多有效数据;按环境步数计,FAR 把额外步数集中花在能力边界附近的困难样本上,因此单位步数的提升也更高。作者还用稀疏奖励(完成给 3、其余 0)重跑了持续改进实验,FAR 依旧稳定上升——因为归因依赖的是价值的相对变化,而非奖励的绝对形状。
实验设置
仿真覆盖 ManiSkill、RoboSuite、RoboMimic 三个基准共九个视觉操作任务,每任务 50 个评测 episode、最多 5 次尝试、3 个随机种子报告均值与标准差;真机为 7 自由度 xArm,末端 delta 位置控制 30 Hz,第三人称视角来自 ZED Mini,每任务 20 个 episode、最多 3 次尝试,成功与否由人类观察员判定。示范数量刻意压得很低(3 到 100 条),以放大失败频率。所有实验在单张 NVIDIA A5000 上完成。
| 域 | 任务 | 最长步数 | 任务描述 |
|---|---|---|---|
| ManiSkill | PullCube | 50 | 把方块拉到目标区域 |
| ManiSkill | LiftPeg | 150 | 抓起 peg 并让它立起来 |
| ManiSkill | PokeCube | 100 | 用工具把方块戳到目标区域 |
| RoboSuite | Stack | 150 | 抓起红色方块叠到另一块上 |
| RoboSuite | Door | 200 | 压下把手开门 |
| RoboSuite | Bread | 200 | 抓起面包放进正确的格子 |
| RoboMimic | Lift | 100 | 把方块提到桌面上方 |
| RoboMimic | Can | 200 | 抓起罐子放进正确的格子 |
| RoboMimic | Square | 200 | 拿起方形工具插进插槽 |
| 真机 | Drawer | 200 | 推把手关上抽屉 |
| 真机 | Pot | 300 | 抓起锅盖盖到锅上 |
| 真机 | Tea | 300 | 拿起茶壶往杯子里倒水 |
基线四条:DP 是行为克隆训出的扩散策略标准 rollout;DP-NR 是同一策略允许多次尝试但不更新、不重置(naive retry);DP-BGR 是作者按本文设置复现的 Bellman-Guided Retrials;DP-FAR 是本文方法。持续改进实验里所有基线在数据采集时都加高斯噪声以保证探索公平。
仿真结果:重试有用,但只有 FAR 把重试变成学习
| 任务(示范数) | LiftPeg (20) | PokeCube (20) | PullCube (20) | Door (3) | Bread (15) | Stack (15) | 平均 |
|---|---|---|---|---|---|---|---|
| DP | 53.3±10.3 | 36.0±3.5 | 58.7±4.2 | 46.7±17.5 | 44.7±8.1 | 42.7±8.3 | 47.0±6.6 |
| DP-NR | 57.3±8.3 | 37.3±4.6 | 64.0±5.3 | 80.7±20.5 | 54.0±11.1 | 61.3±16.0 | 59.1±8.0 |
| DP-BGR | 53.3±8.1 | 36.0±7.2 | 62.7±4.2 | 80.7±14.5 | 50.7±12.2 | 63.3±21.0 | 57.8±7.7 |
| DP-FAR | 58.7±6.1 | 39.3±8.1 | 70.7±5.0 | 86.7±7.0 | 56.7±1.2 | 68.7±13.3 | 63.4±4.5 |
表 1 里最值得读的不是 FAR 的行,而是 DP-NR 的行:仅仅「允许重试、不重置」就把平均成功率从 47.0 抬到 59.1(+12.1),说明评测协议本身对这类方法的分数影响巨大,任何重试类工作的横向比较都必须先对齐尝试次数。在此之上,FAR 再拿 +4.3(63.4),且标准差从 8.0 降到 4.5——它不仅更成功,还更稳定。Door 是最能说明问题的任务:DP 只有 46.7,重试类方法跳到 80 以上,FAR 到 86.7 且方差减半,因为开门失败后把手位置已变,非参数的 BGR 记忆库开始失配,而 FAR 会针对新状态重新更新权重。
| 方法 | Lift (5) | Lift (10) | Can (10) | Can (20) | Square (50) | Square (100) | 平均 |
|---|---|---|---|---|---|---|---|
| DP | 50.0±14.4 | 70.7±2.3 | 42.7±6.1 | 82.7±3.1 | 19.3±4.2 | 48.0±5.3 | 52.2±4.8 |
| DP-NR | 66.7±11.5 | 87.3±10.3 | 54.7±7.0 | 86.0±2.0 | 34.7±9.9 | 60.0±4.0 | 64.9±1.0 |
| DP-BGR | 66.7±11.0 | 84.7±7.6 | 54.0±5.3 | 90.7±1.2 | 34.0±8.7 | 60.7±3.1 | 65.1±1.3 |
| DP-FAR | 84.7±2.3 | 92.0±2.0 | 58.0±5.3 | 89.3±6.1 | 38.0±11.1 | 63.3±2.3 | 70.9±3.0 |
表 2 把示范数量当作自变量:数据越少,FAR 的优势越大。Lift 只有 5 条示范时,DP 为 50.0、FAR 为 84.7(+34.7);Square 只有 50 条时是 19.3 对 38.0,几乎翻倍。这符合直觉——数据越少,策略的能力边界越近,失败越频繁,测试时学习能榨出的信息就越多。唯一的例外是 Can (20):BGR 的 90.7 略高于 FAR 的 89.3,作者没有回避这一点,但该列两者标准差分别为 1.2 与 6.1,FAR 的均值劣势在噪声范围内。
真机结果:把 +11.7 个百分点落在 xArm 上
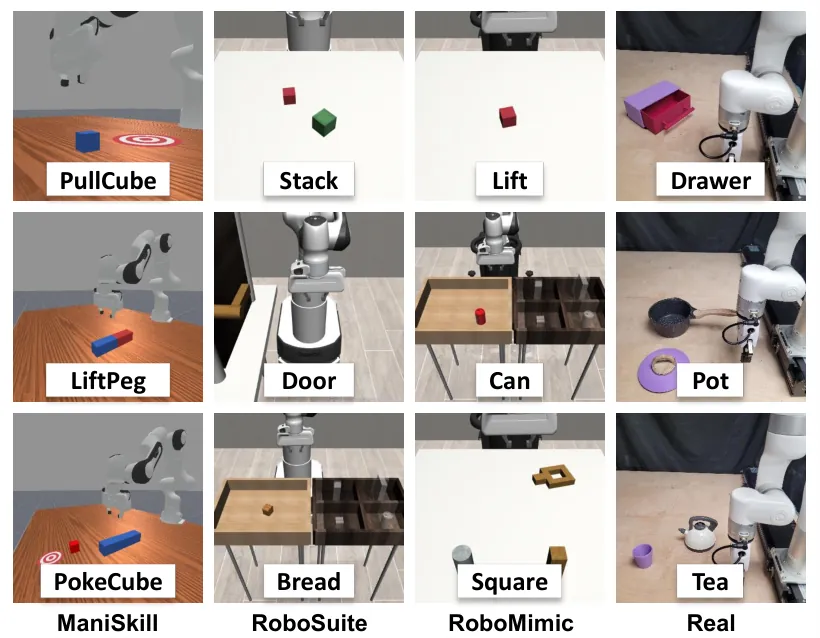
图 3:任务布置。左三列为 ManiSkill、RoboSuite、RoboMimic 的九个仿真任务,右列为 xArm 真机的 Drawer、Pot、Tea 三个任务。
| 方法 | Drawer | Pot | Tea | 平均 |
|---|---|---|---|---|
| DP | 90.0 | 60.0 | 55.0 | 68.3 |
| DP-NR | 95.0 | 65.0 | 55.0 | 71.7 |
| DP-BGR | 95.0 | 70.0 | 55.0 | 73.3 |
| DP-FAR | 95.0 | 80.0 | 65.0 | 80.0 |
真机数字(图 2 的柱状图,本文按坐标反算)呈现清晰的任务难度梯度:Drawer 是短程推任务,DP 已有 90,重试类方法触顶 95,FAR 同为 95,没有发挥空间;Pot 与 Tea 才见真章——锅盖被碰歪、茶壶倾倒角度不对之后,策略必须判断「刚才哪一步坏了」并尝试不同动作,FAR 在 Pot 上 80.0 对 DP 的 60.0、在 Tea 上 65.0 对 55.0,平均 80.0 对 68.3,即摘要所说的 +11.7 个百分点。真机上扰动只加在平移分量并经过时间平滑,20 个 episode 的成功标签由人类观察员给出。
消融:每个部件都在干活
| 变体 | PullCube | LiftPeg | Bread | Door | Lift | Can | 平均 |
|---|---|---|---|---|---|---|---|
| DP-NR(无学习无扰动) | 64.0±5.3 | 57.3±8.3 | 54.0±11.1 | 80.7±20.5 | 66.7±11.5 | 87.3±10.3 | 68.3±6.2 |
| DP + 仅 FCPA | 68.0±3.5 | 57.3±8.3 | 56.7±7.0 | 87.3±13.3 | 80.7±1.2 | 86.7±7.6 | 72.8±4.3 |
| DP + 仅扰动 | 68.7±5.0 | 56.7±11.0 | 55.3±4.2 | 86.7±3.1 | 78.0±5.3 | 86.7±3.1 | 72.0±2.3 |
| DP-FAR(两者皆有) | 70.7±5.0 | 58.7±6.1 | 56.7±1.2 | 86.7±7.0 | 84.7±2.3 | 92.0±2.0 | 74.9±2.2 |
| 归因:固定阈值 | 68.0±5.3 | 58.0±3.5 | 62.7±5.0 | 76.7±8.3 | 80.0±5.3 | 92.7±5.8 | 73.0±3.6 |
| 归因:整条轨迹 | 67.3±7.0 | 57.3±5.0 | 56.0±5.3 | 78.0±10.0 | 80.7±11.4 | 92.7±3.1 | 72.0±1.5 |
| 目标:去掉正样本 | 69.3±5.0 | 55.3±5.0 | 46.0±7.2 | 44.0±22.0 | 72.7±5.0 | 80.7±6.1 | 61.3±5.5 |
| 目标:去掉负样本 | 68.0±6.0 | 58.0±9.2 | 53.3±4.2 | 81.3±10.3 | 86.7±5.0 | 90.0±0.0 | 72.9±1.6 |
| 目标:换成 AWR | 70.0±3.5 | 56.7±11.0 | 42.0±10.4 | 78.0±6.0 | 74.7±7.6 | 90.7±4.2 | 68.7±2.5 |
三组消融里最刺眼的是「去掉正样本」:平均从 74.9 崩到 61.3,Door 上甚至只有 44.0±22.0,比不学习还差。只压负样本会把策略的概率结构推歪,这正是 FCPA 坚持成对监督的原因。换成标准 RL 的优势加权回归(AWR)也只有 68.7,因为 AWR 主要在失败轨迹上做正向利用,缺少「明确躲开失败动作」的负向信号。归因方式上,分位数(74.9)优于固定阈值(73.0)与整条轨迹(72.0),印证了「不是每个 transition 都该为失败负责」。
额外基线与一个反面教材
| 方法 | 类型 | PullCube | LiftPeg | Bread | Door | Lift | Can | 平均 |
|---|---|---|---|---|---|---|---|---|
| CCIL | 动力学模型生成纠正动作 | 64.7±4.2 | 59.3±9.2 | 42.7±3.1 | 58.7±4.2 | 69.3±9.2 | 86.7±9.0 | 63.6±1.3 |
| V-GPS | 重试时用价值函数重排动作 | 62.0±5.3 | 55.3±11.0 | 47.3±5.8 | 87.3±20.2 | 73.3±7.0 | 87.3±5.8 | 68.8±3.5 |
| DP-FAR-Realtime | rollout 中实时检测失败 | 62.7±2.3 | 46.0±5.3 | 40.0±3.5 | 42.7±4.6 | 61.3±3.1 | 84.7±8.3 | 56.2±0.4 |
| DP-FAR | 事后归因 + 偏好自适应 | 70.7±5.0 | 58.7±6.1 | 56.7±1.2 | 86.7±7.0 | 84.7±2.3 | 92.0±2.0 | 74.9±2.2 |
CCIL 与 V-GPS 的适配仍被离线数据束缚,不直接学习测试时遇到的 OOD 失败,因此平均都低于 FAR。更有教学意义的是 DP-FAR-Realtime:它在 rollout 过程中实时比较 $V(s_t)$ 与 $V(s_{t+H})$,一旦价值下跌就立即干预。结果平均只有 56.2,比不干预还差——因为实时干预会让机器人反复退回先前访问过的状态,任务进度被自己掐断;「继续走下去可能失败,但也可能成功」,事后(hindsight)归因反而更可靠。这条消融等于替后来者排掉了一个看起来很自然的坑。
计算开销与定性观察
成本侧的账很干净:默认 10 步自适应在单张 A5000 上约 1.5–3 秒,与一次重试的执行时间同量级;critic 与策略的离线训练分别为 1.5 万到 3 万步与 3 万步迭代,均在此前就要完成。作者扫描了自适应步数:过少学不动,过多过拟合局部偏好数据而掉点,10 步是经验最优。
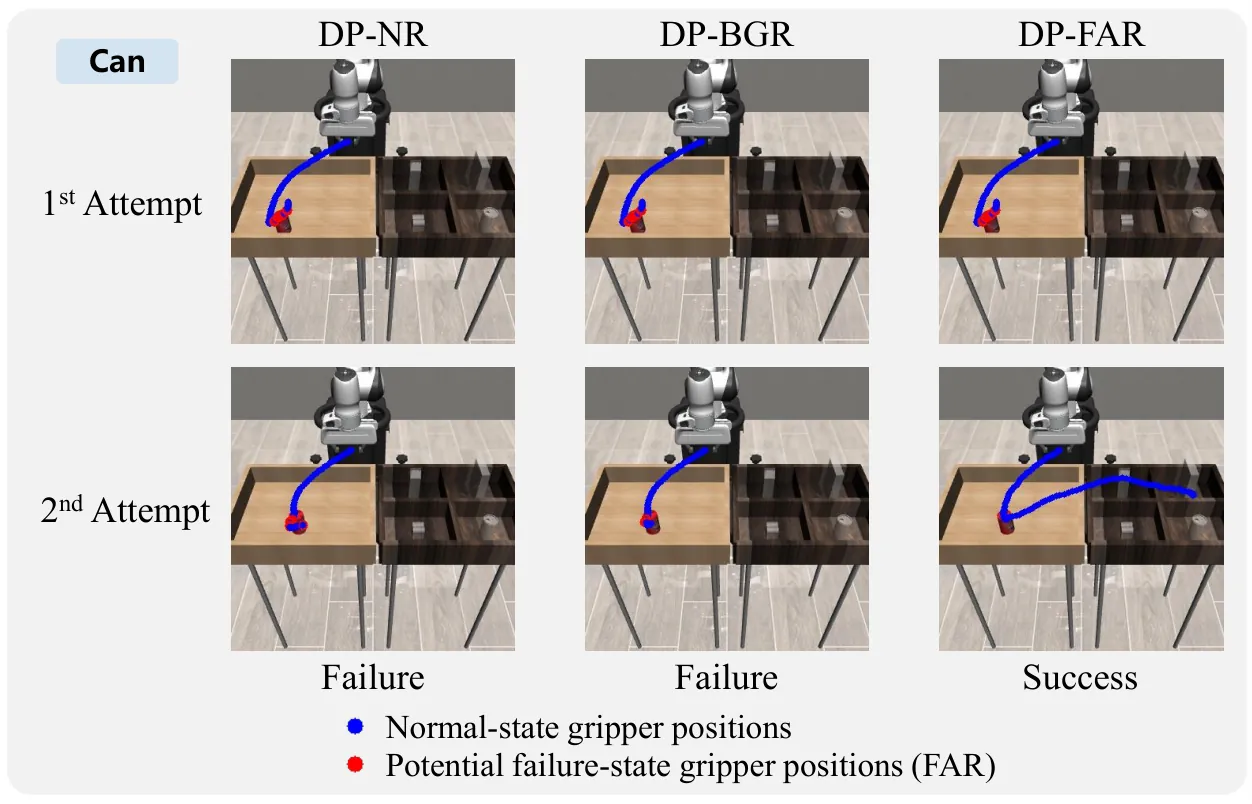
图 4:Can 任务的定性结果。红点为 FAR 判定的潜在致败位置、蓝点为正常位置;FAR 把失败定位在接触阶段(夹爪把罐子推走),第二次尝试成功抓起。BGR 的排斥式纠正在罐子被推走之后失去参照。
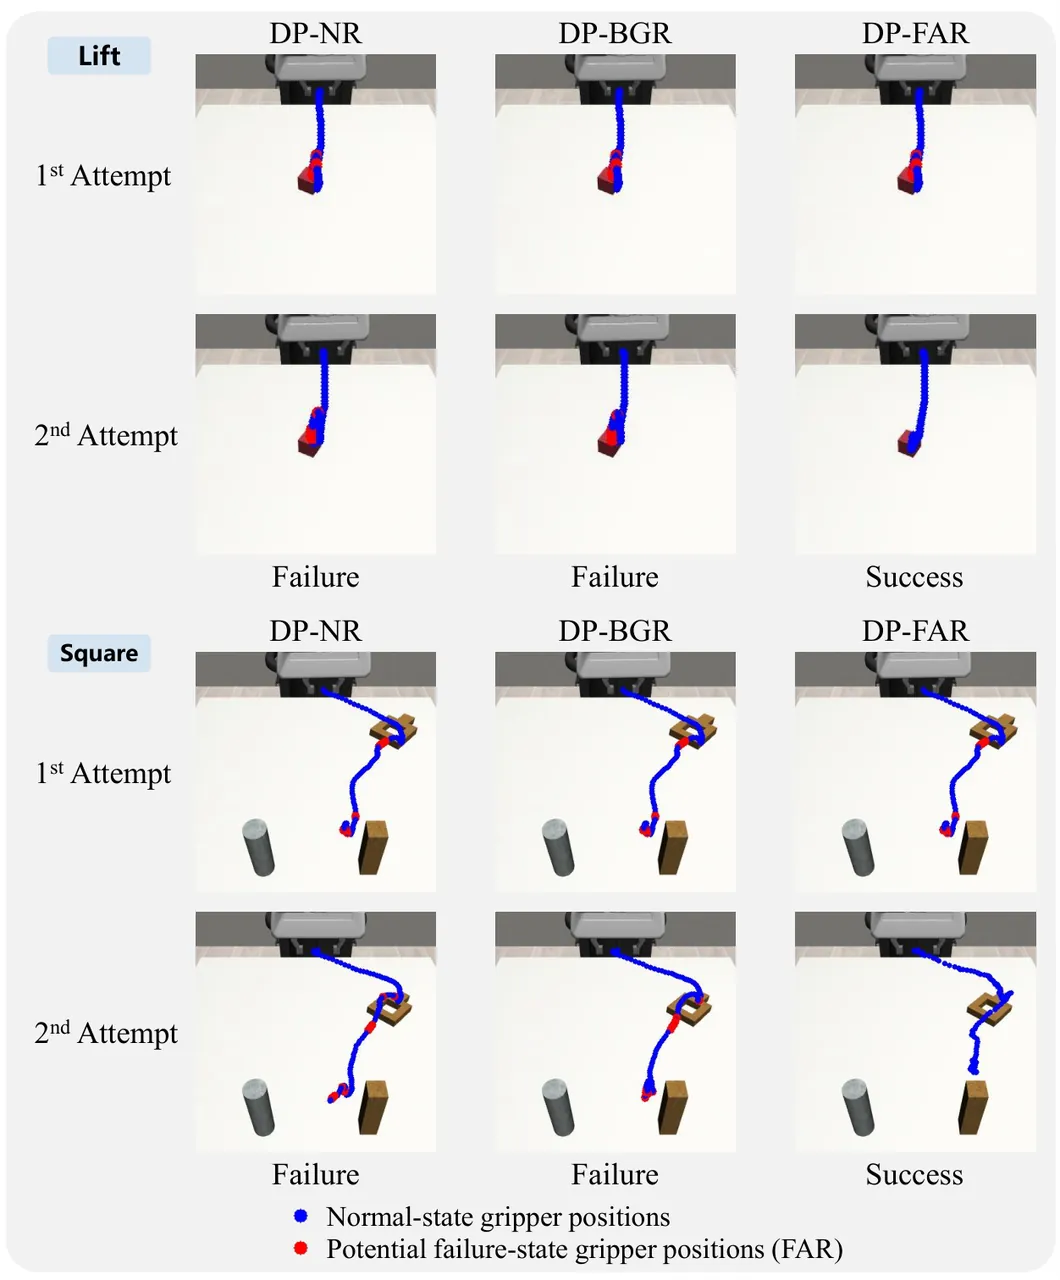
图 5:附录的 Lift 与 Square 定性结果,同样的红蓝标注方式,失败点集中在接触与插入阶段。
局限性
作者自述三条:其一,实验只覆盖从零训练的单任务扩散策略,尚未验证于大规模预训练策略(如 VLA 模型),而后者可能自带更丰富的先验与泛化能力;其二,框架没有 principled 的失败检测机制,成功与否依赖环境反馈或时间上限(真机上依赖人类观察员),未来计划引入 VLM 做任务跟踪与失败判定;其三,恢复过程中的探索安全性仍需专门研究——扰动探索在真机上并非零风险。
在此之外还有几条读者应当自行掂量。第一,真机实验每任务只有 20 个 episode、成功标签来自人类观察员,80.0 对 68.3 的差距在 20 次伯努利采样下的置信区间并不窄(标准误约 9 个百分点),+11.7 更应读作「方向性证据」而非精确效应量。第二,失败归因的质量完全押在 critic 上,而 critic 只用离线示范训练;在失败状态处 IQL 的保守性缓解了高估,但 $\Delta V$ 的排序是否真的指向因果意义上的致败动作,论文只给了定性可视化,没有受控的归因准确率评测。第三,部署协议要求「失败后保留现场」,但真实产线上很多失败(物体掉落地面、液体洒出)并不允许原地重试,协议本身的适用边界没有被讨论。第四,偏好对的构造依赖六个超参数($\rho$、$M$、$d_{\min}$、$d_{\max}$、$K$、$\beta$),消融只逐个扫描了其中一部分,组合敏感性未知。第五,BGR 基线是作者自行复现的版本,与原文实现可能存在细节差异,跨论文比较时需谨慎。
总结与展望
FAR 的贡献不在于某个新损失,而在于把「失败」从评测的终点改写成学习的起点:一套不重置环境的部署协议、一个保守 critic 支撑的归因与筛选流程、一个 10 步就能完成的测试时更新,再加一条把恢复轨迹回流到训练集的闭环。它的实验报告也值得称道:重试协议本身带来的 +12.1 被单独呈现,实时检测的反面结果被如实写出,稀疏奖励下的持续改进被补进附录,读者可以清楚看到每一分增益来自哪里。
对后续工作而言,两条路已经画好:一是把 FAR 的归因与偏好自适应搬到 VLA 等大模型策略上,检验测试时学习能否利用更强的先验;二是把「人类观察员判定成功」换成 VLM 或本体感知的自动失败检测,使闭环真正无人值守。若这两点成立,「部署即训练」的机器人运维范式将少一块关键拼图。