PAPER DEEP DIVE
CanonNav:解耦跨平台视觉导航中的导航行为与相机几何
CanonNav 将跨平台相机拍摄的图像、相对目标和轨迹统一到规范前视相机空间,并用离线可通行性估计生成的伪标签补充安全与局部进展监督。它仅靠 RGB 推理,在 18 种相机配置的仿真和 Husky 实机实验中优于 RGB 基线,并在长距离子目标上超过部分 RGB-D 方法。
一句话总结
CanonNav 先把不同相机拍到的画面、目标点和机器人轨迹投影到同一个规范前视相机空间,再利用离线可通行性伪标签补上“哪里安全”和“下一步该往哪里推进”两类监督,使纯 RGB 策略能够跨相机配置稳定导航。
研究背景:同一段轨迹,为什么在不同相机里像两回事
点目标视觉导航的常见训练形式很直接:给定当前 RGB 图像 $I_t$ 和机器人坐标系中的相对目标 $g_t=(r_t,\theta_t)$,模仿专家示范输出一条未来轨迹 $\tau_t=\{(x_i,y_i)\}_{i=1}^{N}$。ViNT、NoMaD 一类工作已经证明,这种图像到轨迹的行为克隆可以在大规模导航数据上扩展。然而,当训练数据来自不同机器人、不同安装高度和不同俯仰角时,模型看到的不只是环境变化,还被迫同时学习一套从未显式给出的相机几何映射。
论文用图 1(a) 说明这个矛盾:同一条机器人坐标系中的前向轨迹,在低视角相机中可能落到图像中央,在高视角或俯视相机中却落到画面下方;相同像素位置对应的地面距离也会随焦距和安装姿态变化。若策略直接学习 $p(\tau_t\mid I_t,g_t)$,它必须从单张图像中反推当前平台的内参、外参和高度。这个反问题在纹理弱、尺度线索不足或视野被遮挡时并不唯一。
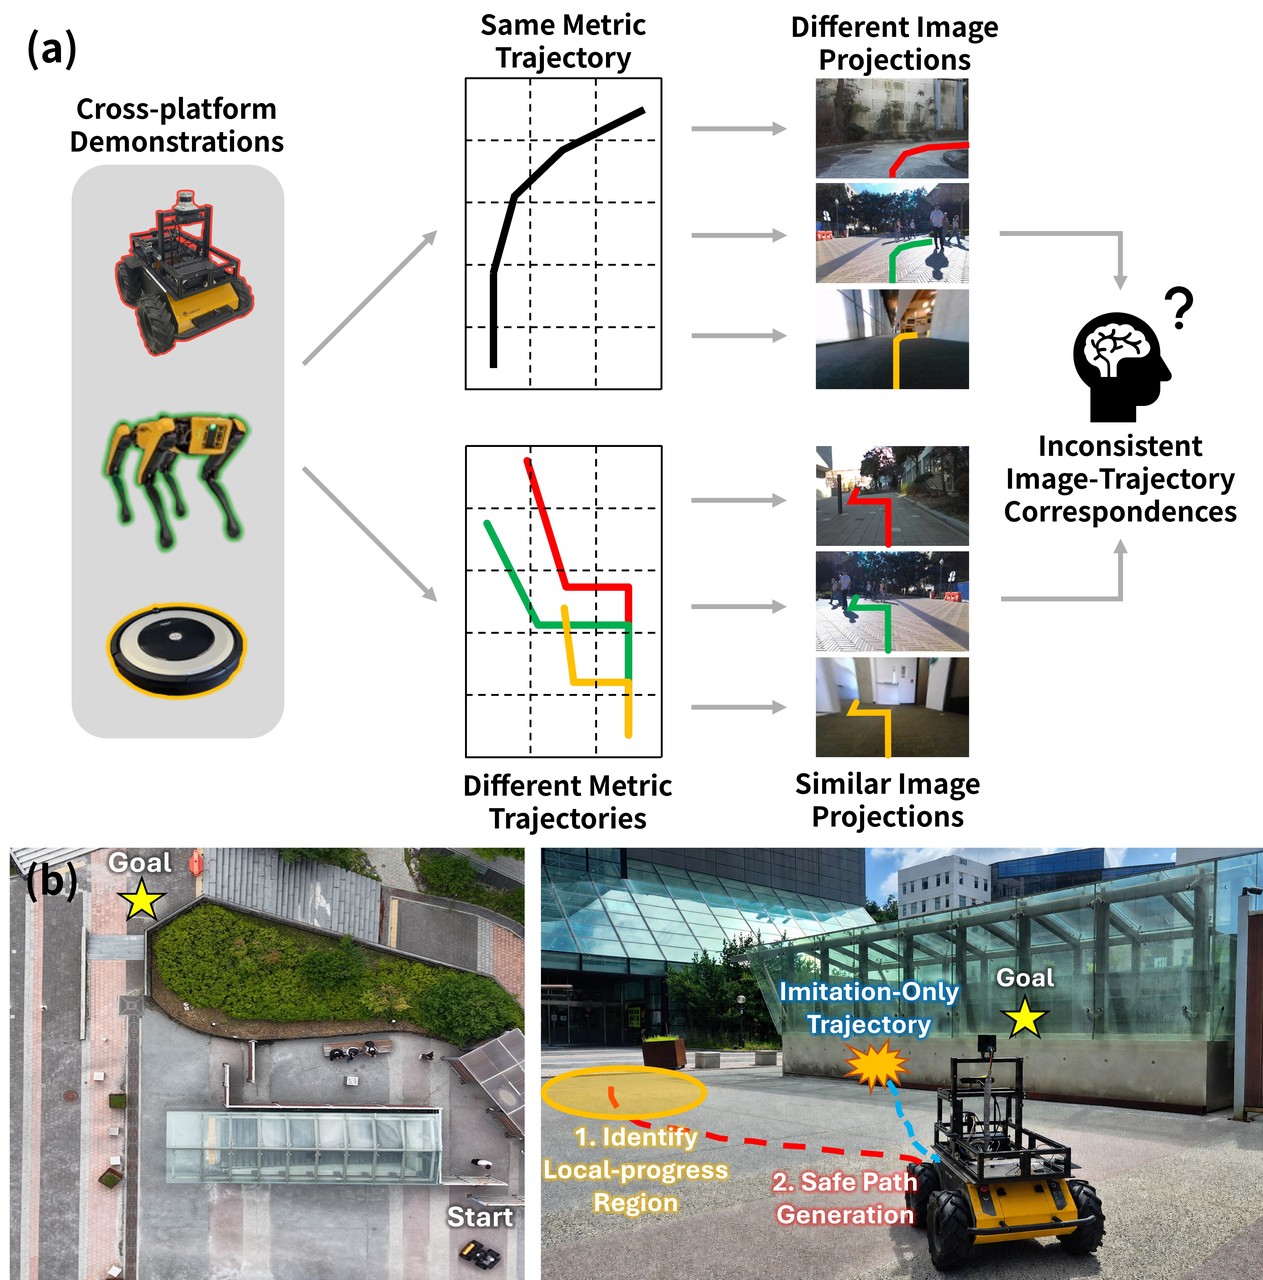
图 1:不同相机几何让图像区域与轨迹标签的对应关系发生变化;仅模仿最终轨迹也没有直接监督局部进展区域和安全路径。
现有做法通常从数据增广入手。ExAug 利用重建场景生成反事实视角,RoVi-Aug 用生成模型合成不同相机视角,RING 在仿真中随机化机器人本体和相机。它们扩大了训练分布,却没有消掉输入映射中的几何变量。只要测试相机超出增广覆盖范围,模型仍可能把“相机姿态变化”误读成“环境结构变化”。
第二个问题来自监督信号本身。专家轨迹只告诉模型最终选了哪条路,没有显式告诉它当前画面中哪块区域最值得推进,也没有逐路点标注“这里离障碍够不够远”。遇到必须绕行的长距离子目标时,纯模仿策略容易直接朝目标方向走,直到障碍进入近场才反应。深度方法可以借助距离传感器补足这一点,但 CanonNav 希望部署阶段只使用 RGB,因此必须在训练期构造可迁移的规划监督。
论文的核心判断可以概括为两层:跨平台数据首先需要一个与相机无关的统一表示;在这个表示中,安全与局部进展信号才具有一致含义。CanonNav 因此没有把相机参数直接塞进策略,也没有依赖测试时深度输入,而是先做几何规范化,再把离线可通行性估计器产生的伪标签投影到规范地面空间。
规范空间:把相机差异从策略输入中移走
论文考虑前视相机,将完整外参简化为俯仰旋转 $R_{\text{pitch}}$ 和离地高度 $h$,于是相机几何可写为 $\phi=(K,R_{\text{pitch}},h)$。原始策略需要隐含积分所有可能的几何配置:
$$ p(\tau_t\mid I_t,g_t)=\int p(\tau_t\mid I_t,g_t,\phi)\,p(\phi\mid I_t)\,d\phi. $$
这个式子解释了为什么直接行为克隆会把“会导航”和“会判断相机”耦合在一起。CanonNav 选择一个固定的规范内参 $\tilde{K}$,输入分辨率设为 $336\times256$,并令 $\tilde{f}_x=\tilde{f}_y=\tilde{c}_x=168$、$\tilde{c}_y=128$。原始图像像素通过单应变换映射到新的前视相机:
$$ (\tilde{u},\tilde{v},1)^{\top}\propto\tilde{K}R_{\text{pitch}}^{-1}K^{-1}(u,v,1)^{\top}. $$
这一步同时消除了焦距、主点和俯仰角差异。对地面点 $(x,y)$,规范相机坐标可写成 $(-y,-h,x)^{\top}$,投影后得到:
$$ \tilde{u}=\tilde{c}_x-\tilde{f}_x\frac{y}{x}, \qquad \tilde{v}=\tilde{c}_y-\tilde{f}_y\frac{h}{x}. $$
从人话角度看,像素横坐标主要编码地面点的左右偏角,纵坐标编码“它离机器人有多远”与相机高度的比值。如果把轨迹坐标同时除以 $h$,写成 $(\tilde{x},\tilde{y})=(x/h,y/h)$,投影关系就变成:
$$ \tilde{u}=\tilde{c}_x-\tilde{f}_x\frac{\tilde{y}}{\tilde{x}}, \qquad \tilde{v}=\tilde{c}_y-\tilde{f}_y\frac{1}{\tilde{x}}. $$
此时网络只要预测高度归一化坐标,就不需要知道当前机器人装的是 0.45 米高的室内相机,还是 0.75 米高的户外平台。目标也从 $g_t$ 改写为 $\tilde{g}_t=(r_t/h,\theta_t)$。轨迹的物理尺度没有被永久丢弃,推理时乘以当前相机高度即可恢复米制路径。
这项设计的关键不是“把图片 resize 成统一尺寸”。普通缩放只能统一张量形状,无法统一像素与地面点之间的透视关系;CanonNav 统一的是投影模型。官方代码在 canonnav/data/dataset.py:132-151 中把俯仰逆变换、训练期偏航增广和高度归一化放在同一条数据管线里,并同步旋转 BEV、路径、目标和到达范围标签,避免图像变换后标签仍停留在旧坐标系。
R_pitch = np.array([
    [1., 0, 0],
    [0, np.cos(pitch), -np.sin(pitch)],
    [0, np.sin(pitch),  np.cos(pitch)]
])
R_yaw = np.array([
    [math.cos(-yaw), 0, math.sin(-yaw)],
    [0, 1, 0],
    [-math.sin(-yaw), 0, math.cos(-yaw)]
])
homography = self.K @ (R_yaw @ R_pitch) @ np.linalg.inv(meta["K"])
canon = cv2.warpPerspective(rgb, homography, (self.W, self.H))
代码 1:规范图像的单应矩阵。路径与 BEV 在 120-130 行先按同一偏航角旋转,随后在 143-151 行按相机高度归一化。
网络如何同时输出轨迹、安全可达范围与逐点可通行性
CanonNav 使用 DINOv3 ViT-S+ 作为视觉主干,并通过 LoRA rank 3 做参数高效适配。论文取第 3、6、9、12 层特征,官方代码调用 get_intermediate_layers(..., n=[2,5,8,11]) 取得对应的零基索引,再用四路 $1\times1$ 卷积聚合为一张 $256\times16\times21$ 的特征图。浅层保留局部障碍和纹理,深层提供通道、门洞与可绕行空间的整体关系。
相对目标先编码成 256 维查询,视觉特征作为键和值,经过两层交叉注意力得到目标条件特征 $f_A$。随后把全局池化图像特征 $f_I^{\text{pool}}$、原始目标特征 $f_G$ 与交互后的 $f_A$ 拼接:
$$ f_{\text{cond}}=[f_I^{\text{pool}},f_G,f_A]. $$
论文把这个条件向量共享给两条预测分支。一条是条件一维 U-Net 扩散策略,输出 30 条候选轨迹,每条 16 个路点;另一条预测 Scope-of-Reach,也就是机器人当前应推进到的局部区域。Scope-of-Reach 用各向同性、轴对齐的二维高斯表示:
$$ \mathcal{S}=\mathcal{N}\left(\mu,\operatorname{diag}(\sigma^2)\right). $$
这里的高斯不是对“所有未来位置”的不确定性建模,而是压缩一个中间规划决策:目标可能被墙、灌木或门洞间接遮挡时,机器人先应该朝哪块可通行区域走。均值给出推进中心,方差允许该区域在横向和纵向上有不同宽度。代码中的 SoR_Gaussian_Head 把标准差限制在 0.02 到 0.7 的归一化范围,避免训练早期输出退化。
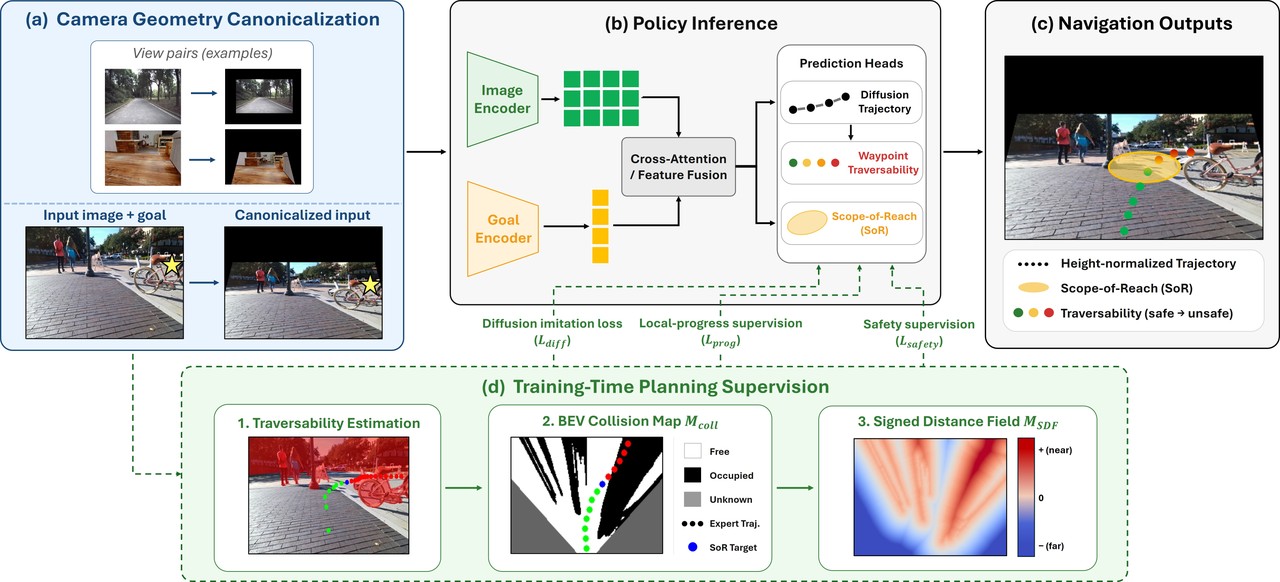
图 2:CanonNav 总览。规范相机视图与高度归一化目标进入网络,轨迹扩散、Scope-of-Reach 和逐路点可通行性共享视觉条件。
第三条分支接收去噪后的轨迹,把每个路点投影回图像并双线性采样对应视觉特征,再结合路点坐标预测 0 到 1 的可通行性分数。它不直接控制扩散采样,而是为运行时候选路径打分。这种分工让扩散模型负责生成多样轨迹,轻量评估器负责在当前图像上判断哪条路径更安全。
扩散模仿学习与训练期的“干净轨迹估计”
CanonNav 沿用 Diffusion Policy 的思路。训练时对高度归一化专家轨迹 $\tilde{\tau}^{*}$ 加噪,采样扩散步 $k$,让噪声预测网络 $\epsilon_\theta$ 在视觉条件下估计被加入的高斯噪声。标准 DDPM 损失负责恢复专家轨迹分布,但如果监督只停在这里,模型仍然不知道中间路点是否撞墙、是否正朝可实现区域推进。
为了把后续规划损失加到一条可解释的轨迹上,论文从带噪轨迹恢复一步干净估计:
$$ \hat{\tau}_0= \frac{\tilde{\tau}_k-\sqrt{1-\bar{\alpha}_k}\, \epsilon_\theta(\tilde{\tau}_k,k,f_{\text{cond}})} {\sqrt{\bar{\alpha}_k}}. $$
$\bar{\alpha}_k$ 是累计噪声系数。这个式子在说:从当前带噪版本里减去模型认为的噪声,再缩放回近似无噪轨迹。训练期安全损失和 Scope-of-Reach 一致性都作用在 $\hat{\tau}_0$ 上;推理时则完整执行 10 步去噪,再用最终轨迹做逐路点判断。官方实现 canonnav/models/model.py:147-194 正是先恢复 $x_0$,再计算 BEV 间隙、碰撞代价和路径到达范围一致性。
安全监督:用离线可通行性估计补出碰撞伪标签
训练数据只有 RGB、里程计和专家轨迹,没有逐像素深度或碰撞标签。论文用冻结的 ViTA 离线估计器为每张训练图生成可通行掩码,再结合已知相机几何把像素反投影到机器人周围 32 米乘 32 米的 BEV。每个格子边长 0.1 米,可通行掩码投到格子中心后形成碰撞地图 $M_{\text{coll}}$,并进一步计算有符号距离场 $M_{\text{sdf}}$。
安全损失包含路径级碰撞项和路点级可通行项:
$$ \mathcal{L}_{\text{safety}} =\lambda_{\text{coll}}\mathcal{L}_{\text{coll}} +\lambda_{\text{trav}}\mathcal{L}_{\text{trav}}. $$
对估计轨迹中的第 $i$ 个路点 $\hat{p}_i$,按相机高度恢复米制位置后采样距离场,低于安全间隙的惩罚经 softplus 平滑:
$$ c_i=\operatorname{softplus} \left( \frac{d_{\text{safe}}-M_{\text{sdf}}(h\hat{p}_i)}{\eta} \right), \qquad \mathcal{L}_{\text{coll}} =\frac{1}{\gamma}\log\sum_{i=1}^{N}\exp(\gamma c_i). $$
路点级评估器则采样图像特征并预测 $ \hat{q}_i\in[0,1] $。视野内且距离场大于机器人半径的目标记为 1,否则为 0;投影落在视野外的路点记为 0.5,不强迫模型对看不见的区域给出确定答案:
$$ \mathcal{L}_{\text{trav}} =\frac{1}{N}\sum_{i=1}^{N} \operatorname{BCE}(\hat{q}_i,q_i^{*}). $$
论文明确切断路点坐标和图像特征在可通行头中的梯度,使这项损失只训练评估器,不反过来改变扩散轨迹。这个细节很重要:如果让同一个轻量头既提供监督又接收近似标签,训练目标容易在伪标签错误处互相拉扯。代码还使用机器人半径 0.25 米与额外安全余量 0.5 米,合计对应论文表中的 0.75 米 $d_{\text{safe}}$。
局部进展监督:让“先走到哪里”成为可学习变量
Scope-of-Reach 目标从专家轨迹与碰撞地图中自动生成。系统把轨迹每 0.33 米采样一次,检查每个机器人足迹覆盖的所有 BEV 格子;若至少 30% 的足迹格被占据,就认为该姿态进入碰撞区域。从当前姿态沿专家路线前进,取“第一次碰撞或第一次离开相机视野”之前的最后一个有效路点作为目标 $s^{*}$。若整段都安全且可见,就取轨迹终点。
这个标签把专家最终选择拆成更细的中间判断:在还能看见、还能安全到达的范围内,机器人最深可以推进到哪里。Scope-of-Reach 的预测损失同时包含高斯负对数似然和平滑 L1,既学习位置,也学习合理的空间尺度:
$$ \mathcal{L}_{\text{prog}} =\lambda_{\text{pred}}\mathcal{L}_{\text{pred}} +\lambda_{\text{neg}}\mathcal{L}_{\text{neg}} +\lambda_{\text{cons}}\mathcal{L}_{\text{cons}}. $$
$$ \mathcal{L}_{\text{pred}} =-\log\mathcal{N} \left( \tilde{s}^{*};\tilde{\mu},\operatorname{diag}(\tilde{\sigma}^2) \right) +\operatorname{SmoothL1}(\tilde{\mu},\tilde{s}^{*}). $$
仅有目标点监督还不够。模型可能把高斯均值放对,却给不可通行区域留下很大的概率质量。负质量项直接把 Scope-of-Reach 分布投到碰撞地图上:
$$ \mathcal{L}_{\text{neg}} =\int M_{\text{coll}}(x,y)\mathcal{S}(x,y)\,dx\,dy. $$
一致性项则检查去噪轨迹是否至少有一个路点接近预测区域。对每个路点计算马氏距离 $d_i=(\hat{p}_i-\tilde{\mu})^{\top}\operatorname{diag}(\tilde{\sigma}^2)^{-1}(\hat{p}_i-\tilde{\mu})$,通过负 soft-min 鼓励最接近的路点也足够近:
$$ \mathcal{L}_{\text{cons}} =-\rho\log\sum_{i=1}^{N}\exp\left(-\frac{d_i}{\rho}\right). $$
最终训练目标把扩散、安全、进展与轨迹平滑放在一起:
$$ \mathcal{L} =\lambda_{\text{diff}}\mathcal{L}_{\text{diff}} +\mathcal{L}_{\text{safety}} +\mathcal{L}_{\text{prog}} +\lambda_{\text{smooth}}\mathcal{L}_{\text{smooth}}. $$
这三类监督回答的问题不同:扩散损失保留专家轨迹的多模态分布,安全损失压低碰撞风险,进展损失给长距离绕行提供中间目标。消融实验显示,只有三者与规范空间同时存在时,性能才达到最好。
运行时选路:不是取概率最高,而是估计能走多远
推理时模型生成 30 条候选路径。若只比较终点或采样概率,一条穿过障碍的“乐观路径”可能因为方向更接近目标而胜出。CanonNav 把每个路点的可通行分数解释为单位距离生存概率,计算每条候选路径的期望可行进长度。设第 $i$ 段长度为 $\ell_i$,到达该段起点的概率为:
$$ R_i=\prod_{j=1}^{i-1}q_j^{\ell_j}. $$
在该段内,单位距离生存概率为 $q_i$,条件期望距离是:
$$ d_i=\int_{0}^{\ell_i}q_i^{x}\,dx =\frac{1-q_i^{\ell_i}}{-\ln q_i}. $$
把所有段的贡献相加,得到期望可达长度 $\hat{L}=\sum_i R_i d_i$,再沿折线插值成期望到达点 $\bar{p}$。运行时分别计算朝目标接近量、从当前位置移动的距离和与上一帧路径的方向一致性,并按 0.6、0.4、0.2 的权重组合。代码 canonnav/inference.py:30-78 保留了这个设计,前两项在 5 米尺度上裁剪,第三项把平均航向差除以 45 度。
seg_survival = traversability ** seg_len
reach_prefix[:, 1:] = np.cumprod(seg_survival[:, :-1], axis=1)
expected_length = np.sum(reach_prefix * g, axis=1)

progress_score = np.clip(progress / 5, a_min=-9999, a_max=1)
travel_score = np.clip(np.linalg.norm(reach, axis=1) / 5, a_min=0, a_max=1)
score = 0.6 * progress_score + 0.4 * travel_score if goal_directed else travel_score
代码 2:可通行性被当作单位距离生存概率,期望到达点再用于目标进展与位移打分。完整选择逻辑还包含上一帧路径的一致性项。
这个选择器体现了一个值得保留的工程思想:生成模型可以大胆给出多峰候选,执行层则用保守的可达性估计截断不现实分支。系统无需在推理时运行 ViTA,也无需深度相机;训练期学到的轻量可通行头直接读取规范图像特征。
CanonNav 的特有数据流
flowchart LR
    A["RGB image and relative goal"] --> B["Canonical camera warp
normalize intrinsics and pitch"]
    B --> C["DINOv3 ViT-S+
LoRA rank 3"]
    C --> D["Layers 3 6 9 12
feature fusion"]
    D --> E["Goal cross-attention"]
    E --> F["Shared condition vector"]
    F --> G["DDPM trajectory sampler
30 candidates x 16 waypoints"]
    F --> H["Scope-of-Reach
2D Gaussian"]
    G --> I["Waypoint traversability"]
    I --> J["Expected reach point"]
    H --> K["Progress consistency"]
    J --> K
    K --> L["Best path and motion command"]
    M["Offline traversability estimator"] --> N["BEV collision map"]
    N --> O["Safety loss"]
    N --> H
    G --> O
图中左侧是部署链路,右侧是训练期才需要的伪标签链路。ViTA、BEV 碰撞地图和 Scope-of-Reach 目标生成都不会出现在最终机器人运行时,部署输入只有单目 RGB、相对目标和已知相机参数。
实验设置:18 种相机配置与近十万次仿真
仿真包含户外 CitySim 与室内 AWS Hospital。相机水平视场取 70、80、90 度,俯仰取 0、10、20 度,高度在 CitySim 取 0.55 和 0.75 米,在医院取 0.45 和 0.65 米,共形成 18 种配置。CitySim 的子目标距离为 6、12、20 米,医院为 6、9、12 米。312 个 CitySim 案例和 264 个医院案例分别在 18 种相机配置下重复 10 次,因此得到 56,160 与 47,520 次 rollout。
训练数据来自 SCAND、HuRoN、BotanicGarden、自采 Husky 数据和 HM3D,预处理后共有 835 万组图像、目标与轨迹样本。对比方法包含仅 RGB 的 ViNT、NoMaD、OmniVLA-edge、LiMo,以及使用 RGB-D 的 ViPlanner、NavDP。所有方法在训练未见过的环境中评估,指标为子目标成功率 SR 和每行驶 100 米的碰撞次数。
| 长距离设置 | 方法 | SR | 每 100 米碰撞 |
|---|---|---|---|
| CitySim 20 米 | LiMo(RGB) | 48.3% | 4.25 |
| CitySim 20 米 | ViPlanner(RGB-D) | 39.3% | 4.87 |
| CitySim 20 米 | NavDP(RGB-D) | 71.2% | 2.21 |
| CitySim 20 米 | CanonNav(RGB) | 86.4% | 0.89 |
| 医院 12 米 | NavDP(RGB-D) | 82.9% | 1.91 |
| 医院 12 米 | CanonNav(RGB) | 85.5% | 2.37 |
表 1:论文表 1 的关键行。CanonNav 在最有挑战的长子目标上取得最高成功率,并在 CitySim 20 米把 NavDP 的碰撞率从 2.21 降到 0.89。
这组结果最有价值的地方不是“纯 RGB 终于比 RGB-D 高”,而是它揭示了问题定义的重要性。NavDP 的深度信息对近场障碍很有效,但在 20 米子目标上仍需要提前绕行;CanonNav 利用更宽的场景上下文预测局部进展区域,因此在长距离绕障上更占优。医院 12 米场景中,NavDP 碰撞率更低,说明 CanonNav 并没有在所有指标上绝对压制深度方法。
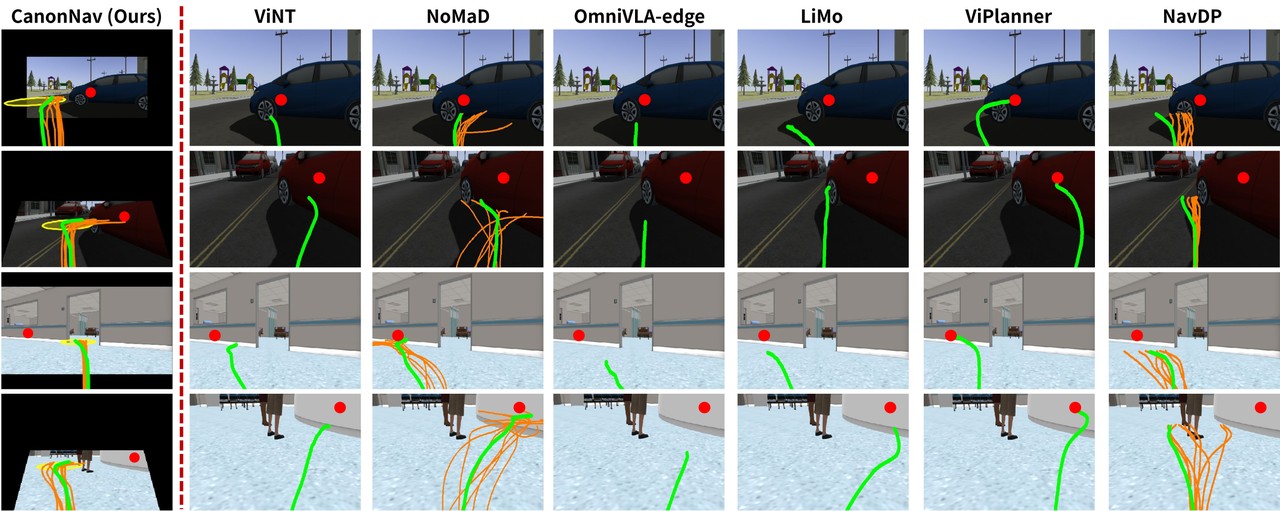
图 4:仿真定性结果。CanonNav 先预测黄色 Scope-of-Reach,再生成绕障轨迹;仅模仿的 RGB 基线更容易直接朝目标走。
相机鲁棒性:俯仰变化下成功率只波动 1.17 个百分点
图 3 把水平视场和俯仰角作为自变量,以 $70^\circ$ 视场和 $0^\circ$ 俯仰为参考报告成功率变化。更宽视场能提供更多场景上下文,但是否真正受益取决于策略能否利用新增信息。CanonNav 与 LiMo 通常从更宽视场中获益,ViPlanner 和 NavDP 在部分设置下反而下降。
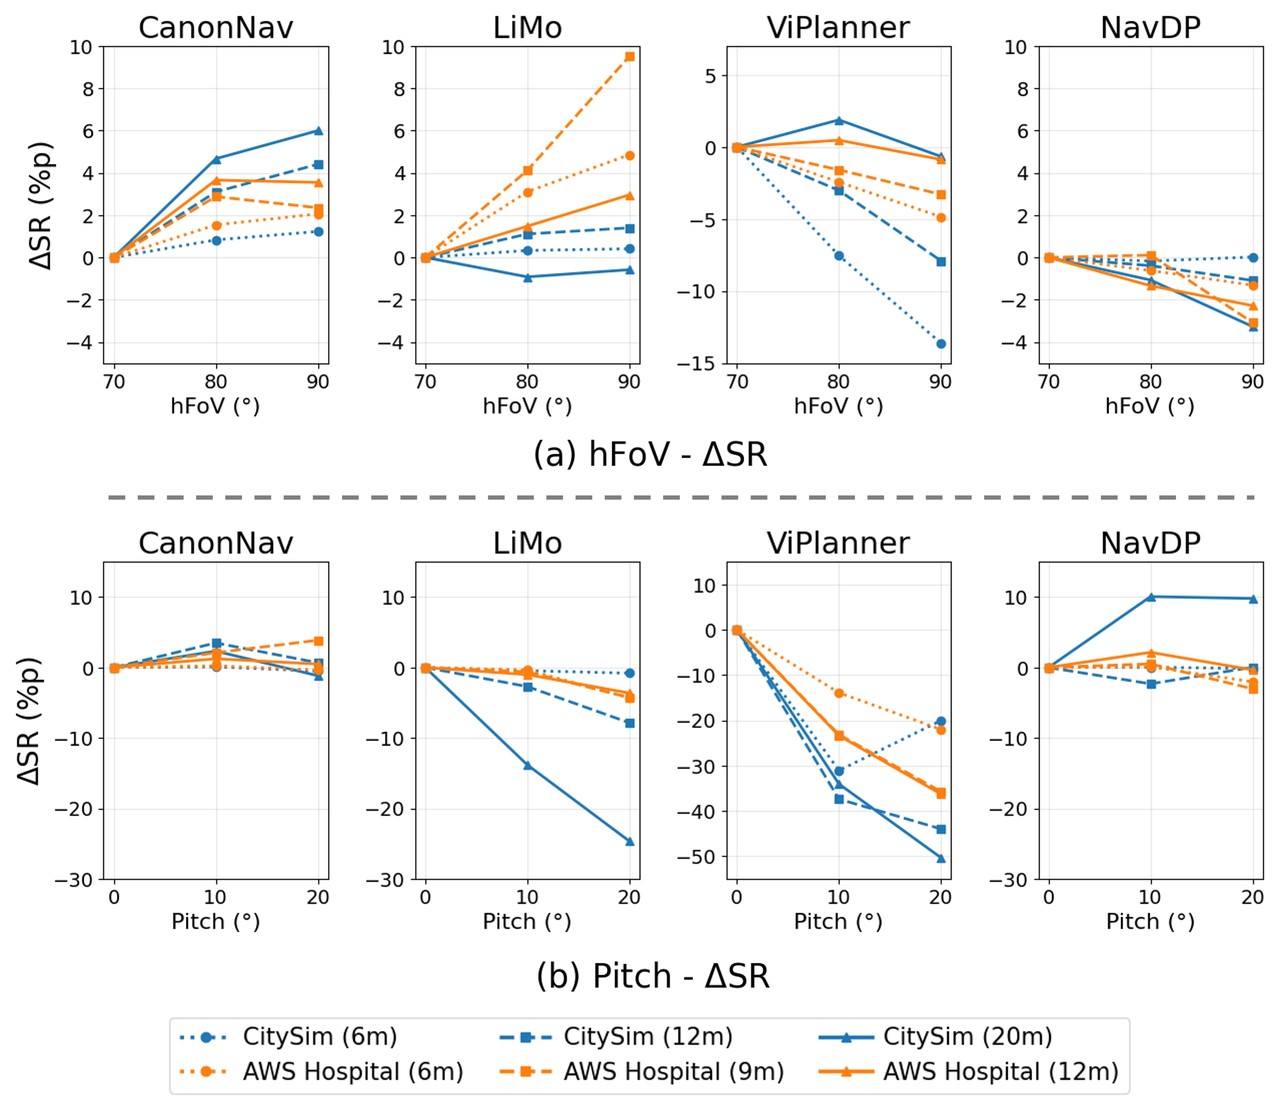
图 3:相机变化对成功率的影响。CanonNav 随水平视场变宽而提升,并在俯仰变化下保持较小波动。
俯仰变化更能暴露几何耦合。在 CitySim 20 米设置中,LiMo 下降 24.66 个百分点,ViPlanner 下降 50.34 个百分点,NavDP 提升 9.80 个百分点,说明各方法的敏感方向不同。CanonNav 只变化 1.17 个百分点;它在医院 9 米场景的最大俯仰波动为 3.87 个百分点。规范化并没有让网络忽略相机,而是把相机差异在进入策略前变成统一映射。
消融:规范化和两类规划监督缺一不可
| 设置 | CitySim 20 米 SR | CitySim 20 米碰撞 | 医院 12 米 SR | 医院 12 米碰撞 |
|---|---|---|---|---|
| 从零训练 | 28.8% | 6.36 | 32.4% | 12.15 |
| DINOv3 + LoRA | 62.6% | 2.99 | 67.0% | 4.76 |
| 加规范化 C | 65.6% | 2.52 | 70.0% | 4.62 |
| C + 安全 S | 83.0% | 1.15 | 79.8% | 3.42 |
| C + 局部进展 P | 79.1% | 1.53 | 81.2% | 3.13 |
| 安全 + 进展但无 C | 77.1% | 1.66 | 75.2% | 4.04 |
| C + S + P | 86.4% | 0.89 | 85.5% | 2.37 |
表 2:论文表 2 的组件消融。C、S、P 分别代表相机规范化、安全监督和局部进展监督。
从零训练到 DINOv3 + LoRA,CitySim 成功率提升 33.8 个百分点,说明预训练视觉表示对跨环境泛化非常重要。只加规范化 C,成功率提升约 3 个百分点,幅度不大,但它为后续规划监督提供了稳定坐标。C+S 和 C+P 分别把成功率推到 83.0% 与 79.1%,说明安全与局部进展从不同方向改善策略。
最关键的对照是 S+P 无规范化。它的 CitySim 成功率只有 77.1%,标准差从完整模型的 3.8 升到 7.7;医院也有类似趋势。规划伪标签本身没有失效,问题在于同一标签在不同透视图像中对齐的位置不一致。没有规范空间时,安全区域和到达范围会随相机配置漂移,模型反而学到互相冲突的视觉模式。
实机实验:Husky 上的成功率从 17/50 提升到 41/50
实机平台是 Clearpath Husky,装有 ZED 2i 立体相机和 Jetson AGX Orin 64GB,CanonNav 机载运行频率为 4.5 Hz。测试覆盖走廊、步道和非铺装路面,五个子目标距离为 25 到 41 米,每种设置 10 次试验,每个环境使用不同水平视场和俯仰以制造真实相机差异。
| 环境与子目标 | NavDP 成功 | NavDP 干预 | CanonNav 成功 | CanonNav 干预 |
|---|---|---|---|---|
| 走廊 G1,25 米 | 3/10 | 1.3 | 8/10 | 0.3 |
| 走廊 G2,41 米 | 0/10 | 3.8 | 7/10 | 0.4 |
| 步道 G1,32 米 | 1/10 | 1.5 | 9/10 | 0.1 |
| 步道 G2,33 米 | 9/10 | 0.1 | 10/10 | 0.0 |
| 非铺装 G1,27 米 | 4/10 | 1.2 | 7/10 | 0.5 |
| 总体 | 17/50 | 1.58 | 41/50 | 0.26 |
表 3:论文表 3。SR 表示无人工干预完成的试验数,Int. 表示每个子目标平均需要的人工干预次数。
走廊 G2 的差异最能说明长距离局部规划的价值。NavDP 在 41 米子目标上没有一次无需干预完成,平均需要 3.8 次干预;CanonNav 完成 7/10,平均干预 0.4 次。成功率和干预次数同时改善,说明模型不是靠更激进地冲向目标换取进度,而是更早选择了可绕行的局部区域。
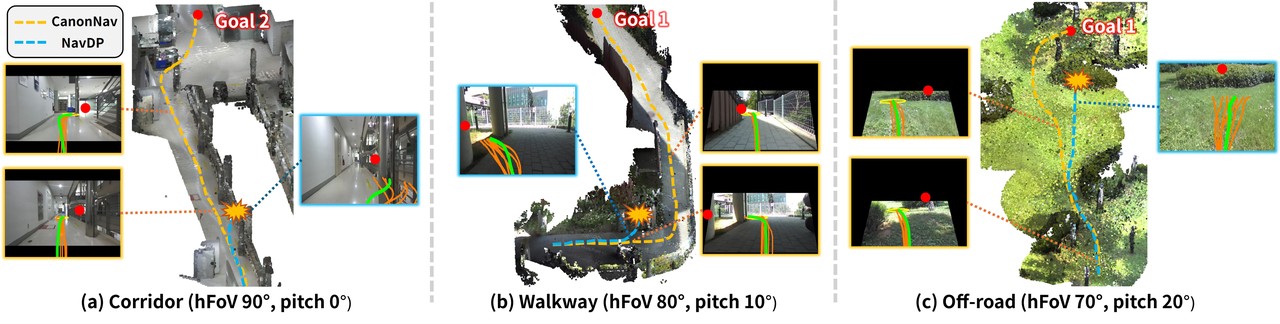
图 5:真实走廊、步道和非铺装环境。CanonNav 在远距离障碍前生成绕行轨迹,NavDP 更常在接近障碍后才反应。
论文还展示了候选路径的期望到达点示意(补充图 S1,下载文件为 fig6)。当某条路径中间经过低可通行区域时,生存概率乘积会让期望到达点提前截止,避免末端几个看似正确的路点抬高整条路径的评分。这比只取所有路点分数的平均值更能表达“走到一半就失败”的风险。
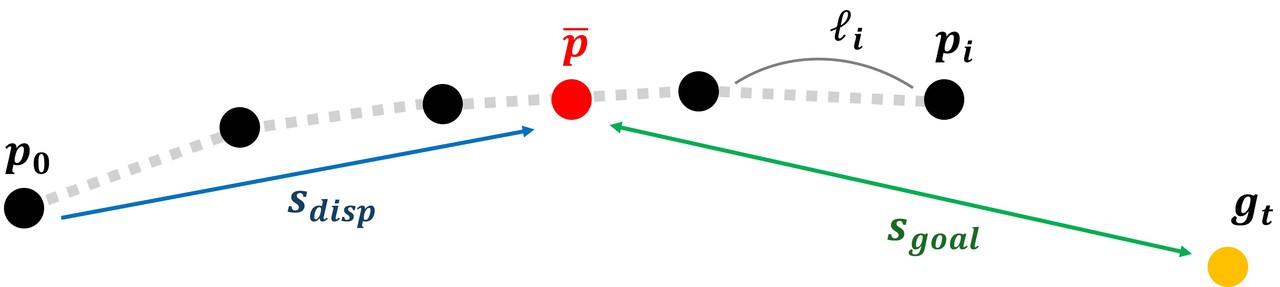
补充图 S1:每条候选路径先按逐路点可通行性估计期望到达点,再计算目标进展、移动距离和时序一致性。
官方实现中最值得关注的四个映射
第一,论文中的 DINOv3 第 3、6、9、12 层在代码里由 n=[2,5,8,11] 获取,这是论文一基编号与代码零基索引的差异,不是层数变化。第二,GoalCondTransformerDecoder 实际使用二维正余弦位置编码、两层目标查询交叉注意力和全局池化图像上下文,与补充表 S1 的 768 维条件向量相对应。
第三,代码条件向量还额外拼接了一个 nav_type 标量,因此 cond_dim = 3 * dec.out_channel + 1。这是论文抽象公式 $f_{\text{cond}}$ 之外的实现扩展,用来区分有目标导航与无目标探索;官方训练文档也明确写明 exploration_prob=0.3 是相对论文新增的探索模式。第四,轻量可通行头的输入不仅有路点坐标,还有沿路线投影采样的视觉特征,输出逐点 logit,再由 BCE 监督。
还有一处必须明确说明:论文补充材料给出的训练学习率是 LoRA $1\times10^{-4}$、其余可训练参数 $5\times10^{-3}$,当前公开 configs/train.yaml 写的是 LoRA $5\times10^{-5}$、其余参数 $1\times10^{-4}$。本文不把这两组配置强行视为一致;复现实验时应以目标提交和论文实验记录为准,并自行核对发布配置是否经过后续调整。
代码仓库提供 release checkpoint、单图演示、ROS1 Hospital 仿真示例和训练流程。仓库接受外部可通行图 trav_map 作为标签输入,但没有把 ViTA 本体打包进推理链路;若要复现训练数据生成,需要额外取得对应的离线可通行性估计器。
局限分析:不只是“换一个相机”这么简单
作者明确承认第一个限制:当原始相机视野比预设规范相机更宽时,单应变换到 $336\times256$ 的窄视野会丢失边缘上下文。规范空间消除了差异,却可能把对绕行有用的侧方障碍裁出画面。更宽的规范内参可以保留视野,但会增加输入面积、降低每个像素对远处目标的有效分辨率,因此存在上下文与细节之间的取舍。
第二个作者限制是本体差异未被建模。导航行为不只听命于相机,还受机器人尺寸、转弯半径、轮式或履带式底盘、最大速度影响。论文中的机器人半径 0.25 米和安全距离 0.75 米是特定平台训练参数;代码 configs/train.yaml 也把本体尺寸作为固定监督设置。换到更宽或更长的平台时需要重训,不能用同一个模型直接迁移。
论文补充材料还显示,失败案例主要来自错误的 Scope-of-Reach 预测:预测区域落到不可通行地面后,轨迹生成会忠实地朝那里前进。小尺寸箱子、低纹理障碍以及与周围地面外观相似的物体最容易触发这类错误。这说明安全最终仍受离线估计器伪标签质量约束,策略可以把标签学得更一致,却无法自动识别标签本身没有见过的障碍类别。
独立的工程判断还有三点。其一,部署需要相对准确的相机内参、安装高度和俯仰角,若参数标定漂移,规范单应会把整幅图投到错误位置。其二,实机只验证了 Husky 一种平台,虽然仿真覆盖多相机配置,但没有给出轮式、腿式或不同尺寸平台的零样本迁移结果。其三,论文的主要优势来自训练期伪标签,数据生成管线的可复现性、ViTA 版本和 BEV 投影标定都会影响最终行为,公开主仓库目前没有封装完整标签生成依赖。
这项工作真正改变了什么
CanonNav 把跨平台视觉导航从“收集更多视角并期待模型学会”推进到“先定义一致表示,再在表示中施加监督”。这和单纯扩大数据量是两种不同思路。相机规范化负责消除输入分布中的无关变量,安全与局部进展监督负责补充专家轨迹没有直接表达的中间决策;三者不是三个独立技巧,而是一条前后依赖的链路。
对机器人开发者而言,最可复用的部分可能是任务分解:生成层保留多峰候选,评估层用逐路点可通行概率估计可走多远,执行层再结合目标进展与时序一致性选择路径。这个结构能够容纳真实系统的传感器噪声、控制延迟和上一帧路径,而不会把所有风险压给一个黑箱回归器。
未来最自然的两条延伸是:把规范空间扩展到更一般的相机姿态或多目相机,同时不裁掉宽视野上下文;以及把机器人尺寸、转弯约束和动力学显式加入策略条件。只有当“相机几何”和“本体动力学”都被解耦,跨平台导航才真正接近即插即用。
CanonNav 没有要求模型从每张图里猜相机,而是先把相机差异变成共享坐标;规划监督之所以能跨平台成立,靠的正是这块共同的尺子。
结论
CanonNav 的核心贡献是为跨平台模仿学习建立一个相机一致空间,并在这个空间内把离线可通行性结果转成安全、局部进展和轨迹一致性监督。它仅用 RGB 推理,在 18 种相机配置的仿真中显著降低俯仰敏感性,在最长子目标上超过 RGB-D 的 NavDP,并在 Husky 实机上把无干预成功率从 17/50 提升到 41/50。其边界同样清晰:宽视场会损失上下文、本体参数仍需按平台配置、错误到达范围仍是主要失败来源。