OPEN SOURCE DEEP DIVE
RPL:在复杂地形上学习稳健的人形机器人感知行走
Amazon FAR 联合 CMU、Stanford、UC Berkeley 的 CoRL 2026 开源工作:先用特权高度图按地形训练多演员 PPO 专家,再蒸馏进双深度相机的视觉 Transformer 学生,配合速度门控深度特征缩放与随机侧向遮挡两个稳健化技巧,以及对机器人自身网格做光线投射、比 IsaacSim Warp 快 5 倍的多深度渲染。Unitree G1 真机带 2 kg 负载在 20° 坡、22/25/30 cm 台阶与间隙 60 cm 的石阵上前后行走。
三件事叠在一起:多方向、复杂地形、未知负载
人形机器人的感知行走这两年进步很快。坡道、台阶、石阵这类地形,只朝一个方向走的策略已经能走得相当稳;但把问题改成「同样的地形前后都要能走、手里还拎着重量未知的东西」,现有方法就大面积失效。失效的原因不在控制层,而在感知的几何结构:前向相机在倒退时拍到的是身后,横移时脚下地形被挤到视野边缘,而负载改变的是全身动力学,却不给策略任何直接观测。RPL 是 Amazon FAR(Frontier AI & Robotics)联合 Carnegie Mellon、Stanford、UC Berkeley 在 CoRL 2026 正面处理这三件事的开源实现,论文为 arXiv:2602.03002,协议 Apache-2.0,实验平台是 Unitree G1 的 29 自由度版本。
RPL 的答案是一个两阶段框架。第一阶段用特权高度图把每种地形训成一个专家策略,让行走与上肢技能在各自最合适的地形上先做到极限;第二阶段把这些专家蒸馏进一个只看深度相机的 Transformer 策略,并用多台深度相机覆盖所有可能的行走方向。蒸馏阶段加入两个针对性技巧——按速度指令缩放深度特征、随机侧向遮挡——分别应对非对称的多视角输入和训练时没见过的地形宽度。支撑这一切的是一套能对机器人自身动态网格与静态地形网格同时做光线投射的多深度渲染系统,在单卡上比现有模拟器最快的深度管线快 5 倍。真机结果是带 2 kg 负载在 20° 坡、踏步长 22/25/30 cm 的三种楼梯、以及 25 cm 见方且间隙 60 cm 的石阵上前后行走。
两阶段框架:先训地形专家,再蒸馏到深度相机
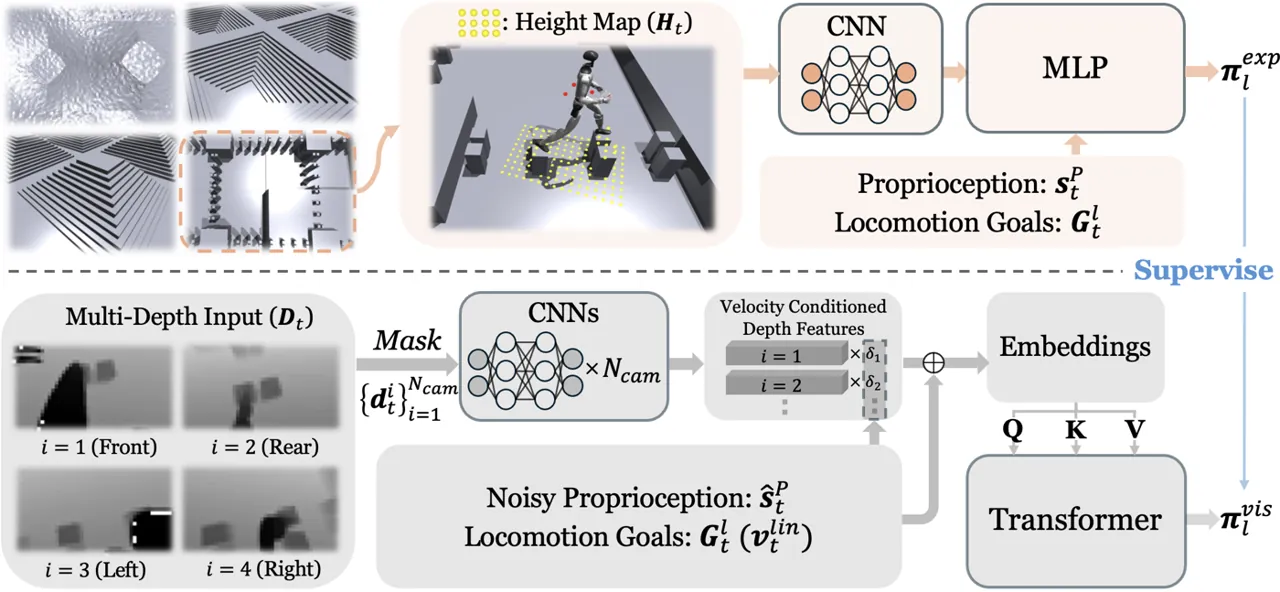
仓库的代码组织直接对应这条流水线。rpl_training/ 里是 Holosoma 核心之外的全部东西:loco-manipulation 环境、manager 各项 term、预设与启动脚本;rpl_training/data/models/ 随仓库附带四个地形教师的 checkpoint(slopes、stairs_up、stairs_down、stepping_stones_columns),蒸馏默认直接加载它们,也可以指向自己训的专家目录或 W&B checkpoint;rpl_sim2sim/ 则是 MuJoCo 侧的仿真课程与策略侧的深度学生封装,附带导出的 ONNX 学生。
这个项目的自我定位也写在 README 开头:研究版发布(research release only),RPL 的特性不会回流进 Holosoma 主线;训练后端选 IsaacGym 而非 IsaacSim,理由是 IsaacSim 的 API 还没有实现力扰动——而力扰动恰恰是负载适应能力的训练来源。这两条决定了读代码时该把哪些部分当作可复用的工程、哪些当作一次性实验配置。
专家阶段:多演员 PPO 与按地形路由的高度图教师
专家阶段沿用 FALCON 的多演员 PPO:下半身与上半身是两个独立的演员,各自有自己的策略网络与价值网络,共享同一个环境步进。网络是 512/256/256/128 四层 MLP、ELU 激活;下半身演员与批评器额外吃一份高度图感知观测,上半身演员只看本体状态。教师网络换成混合专家结构:下半身教师是 CNN 高度图编码器加按地形路由的专家头,上半身教师是按地形路由的 MLP,一种地形一个专家,用 EXPERT=stones|stairs|slopes 选择要复现哪一个 FALCON 专家的最终训练阶段。专家阶段的并行规模沿用 FALCON 的口径:4096 个环境乘 4 张卡。
地形本身是一张 10 行 20 列、格距 0.05 m 的高度场,按 0.2 坡道、0.25 上楼梯、0.25 下楼梯、0.3 石阵的比例混合;坡度上限 0.7,台阶踏步宽 0.30–0.35 m,石块边长 0.25–0.40 m、列间隙 0.05–0.7 m、坑深 0.4–2.5 m。命令空间覆盖线速度、航向、腰 yaw 与 pitch、基座高度(在 0.75 m 的默认绝对高度上加 −0.3 到 0 m 的偏移),以及上半身参考姿态——后者来自随仓库附带的 ACCAD 动作库,配合「以一定概率冻结上半身参考」「重置时把关节直接摆到动作状态」等对齐开关。石阵上关闭 yaw 与航向命令,避免让策略在稀疏落脚点上做无意义的转身。
负载适应在这一阶段就已经埋下:环境会在末端执行器上施加随机竖直力,蒸馏预设的取值范围是 −100 到 5 N(专家阶段是 −60 到 5 N),施力点沿「手到伸展极限」方向按 0 到 1 的比例采样,并随命令一起重采样;三分量里有 25% 的概率把 z 分量置零。施加的力本身也作为观测(缩放 0.1)送进策略,再配一个步长 0.05 的力缩放课程慢慢加压。2 kg 物体约 19.6 N,正好落在这个分布里——策略不是在真机上才第一次见到负载。
学生:两台深度相机喂一个视觉 Transformer
蒸馏阶段用 DAgger 的多演员版本把四个地形教师压成一个学生。学生下半身是视觉 Transformer 编码器:先用一个 CNN 分词器把两台相机的深度图(2 通道、27×48,卷积核 4、步长 2、隐通道 16/32/32)切成 token,再送进嵌入维 64、4 头、4 层、前馈 256 且带位置编码的 Transformer,最后接 512/256/256/128 的 MLP 头;上半身学生是普通 MLP。教师侧看到无噪声的高度图,学生侧看到带噪声、带延迟、带遮挡的深度图——这正是蒸馏要抹平的差距。损失是均方误差,Adam、学习率 1e-3,跑 20000 次迭代,环境数 8192(每卡 1024、共 8 卡)。
深度观测的生成链路完全对齐 FALCON:以 240×135 分辨率做光线投射,水平视场 101.41°、裁剪区间 0.1–2.0 m,加 0.1 倍标准差的噪声与 5% 概率、取值 −2.5 的 dropout,再对相机位姿做 ±2.5 cm、±2.5–3° 的随机化、视场 ±5° 的随机化,最后用带抗锯齿的双三次插值缩到 48×27。帧率 10 Hz,维护一个长度 4 的环形缓冲、固定读延迟索引 2,传感器延迟因此被显式建模。两台相机都装在 torso_link 上:前向偏移 [0.135, 0.06, 0.02]、俯仰 75°;后向偏移 [−0.125, −0.06, 0.02]、俯仰 75° 再加 180° 偏航——这就是「双向」的物理来源。光线投射还会对 22 个机器人本体 STL 网格求交,让手和腿在自己相机里正确地遮挡地形。
两个稳健化技巧:速度门控与随机侧向遮挡
多方向行走会把深度观测变成非对称的:倒退上楼梯时前向相机对着的是已经走过的路,后向相机才看着台阶。若策略无条件信任两路深度,它就会被「当前行走方向看不见地形」的那一路误导。第一个技巧是按速度指令缩放深度特征:把深度特征乘上一个由线速度命令算出的门控,参数为 k=4.0、阈值 0.2,并在 0.1 以下硬截断——站着不动或慢速挪动时深度特征的权重被压下去,朝着相机看的方向快走时才放开。实现上它只是一个独立的命令观测组送进视觉 Transformer 的门控分支,部署时零额外成本。
第二个技巧是随机侧向遮挡:训练时以一定概率把深度图某一侧一个 90×50 像素的框抹掉(两侧框大小差 30 像素,10% 不遮、45% 遮小块、45% 遮大块),并且同一时刻所有相机共用同一次采样;坡道、上楼梯、下楼梯都遮,唯独石阵不遮。动机很直接:真实地形的宽度永远比训练场窄一点或宽一点,被遮掉一侧的深度图逼着策略学会「只看看得见的那半边也能落脚」。论文的消融把这两者的分工说得很清楚:训练损失几乎一样,但去掉随机侧向遮挡的策略在没见过的窄地形上崩掉,去掉速度门控的策略在非对称多视角(前向看楼梯、后向看石阵)下崩掉,两个都在的完整版才能在未见几何与非对称感知下稳定地双向爬楼。
多深度渲染:把机器人自己也算进光线投射
深度蒸馏的算力瓶颈不在策略而在渲染:每个环境、每台相机、每一步都要一张深度图,而主流模拟器的深度相机要么不支持对动态网格求交(IsaacSim 的 Warp RayCasterCamera),要么贵到没法开多相机(IsaacGym 的 PhysX 深度、IsaacSim 的 RTX TiledCamera)。RPL 的多深度管线基于 Warp 的光线投射,同时对静态地形网格与 22 个随姿态更新的机器人网格求交,因此能在 1024 个并行环境里横向扩相机数。
| 管线 | 动态网格 | 1 台相机(显存 GB / 每迭代秒) | 2 台 | 4 台 |
|---|---|---|---|---|
| IsaacGym PhysX | 支持 | 16.8 / 35.6 | 22.5 / 70.1 | 33.9 / 146.5 |
| IsaacSim RTX | 支持 | 17.5 / 5.3 | 23.2 / 7.6 | 34.4 / 12.6 |
| IsaacSim Warp | 不支持 | 12.8 / 3.5 | 15.1 / 5.9 | 20.7 / 9.1 |
| RPL | 支持 | 13.3 / 1.3 | 14.6 / 1.5 | 17.3 / 1.9 |
上表是论文在单张 L40S、1024 个环境、240×135 深度分辨率下的实测:相机数从 1 加到 4,RPL 的每迭代时间从 1.3 s 涨到 1.9 s,而最快的基线(不支持动态网格的 IsaacSim Warp)从 3.5 s 涨到 9.1 s——5 倍差距,且 RPL 还多做了机器人自遮挡。显存上 RPL 也始终贴着最低的那条线(13.3–17.3 GB)。这套管线位于 Holosoma 子模块内,是 RPL 在基础设施层面最主要的贡献。
几台相机才够:多方向行走的视野账
相机数量与行走方向的对应关系也被系统地量过。在双向行走(只前进后退)与全向行走(加左右横移)两种任务下,比较 1 台(朝下)、2 台(前后)、4 台(前后左右)相机能达到的地形难度等级(满分 6):
| 任务 | 相机配置 | 坡道 | 上楼梯 | 下楼梯 | 石阵 |
|---|---|---|---|---|---|
| 双向(专家上限) | 特权高度图 | 6.0 | 6.0 | 6.0 | 6.0 |
| 双向 | 1 台朝下 | 6.0 | 6.0 | 5.9 | 5.1 |
| 双向 | 2 台前后 | 6.0 | 6.0 | 6.0 | 6.0 |
| 全向 | 1 台朝下 | 6.0 | 6.0 | 5.9 | 3.0 |
| 全向 | 2 台前后 | 6.0 | 6.0 | 5.9 | 4.5 |
| 全向 | 4 台四向 | 6.0 | 6.0 | 6.0 | 4.6 |
读数很说明问题:石阵是唯一会掉档的地形,因为间隙最大 70 cm 的稀疏落脚点和行走方向强相关,朝下的单相机视野覆盖不到「下一步要踩的那条线」;前后两台相机就能把双向行走拉满到专家水平。全向任务里即使四台相机也只到 4.6,说明横移下的石阵仍是开放问题。RPL 真机与蒸馏默认取 2 台前后相机,正是这张表里性价比最高的格子。
真机证据:2 kg 负载、20° 坡与 60 cm 间隙的石阵
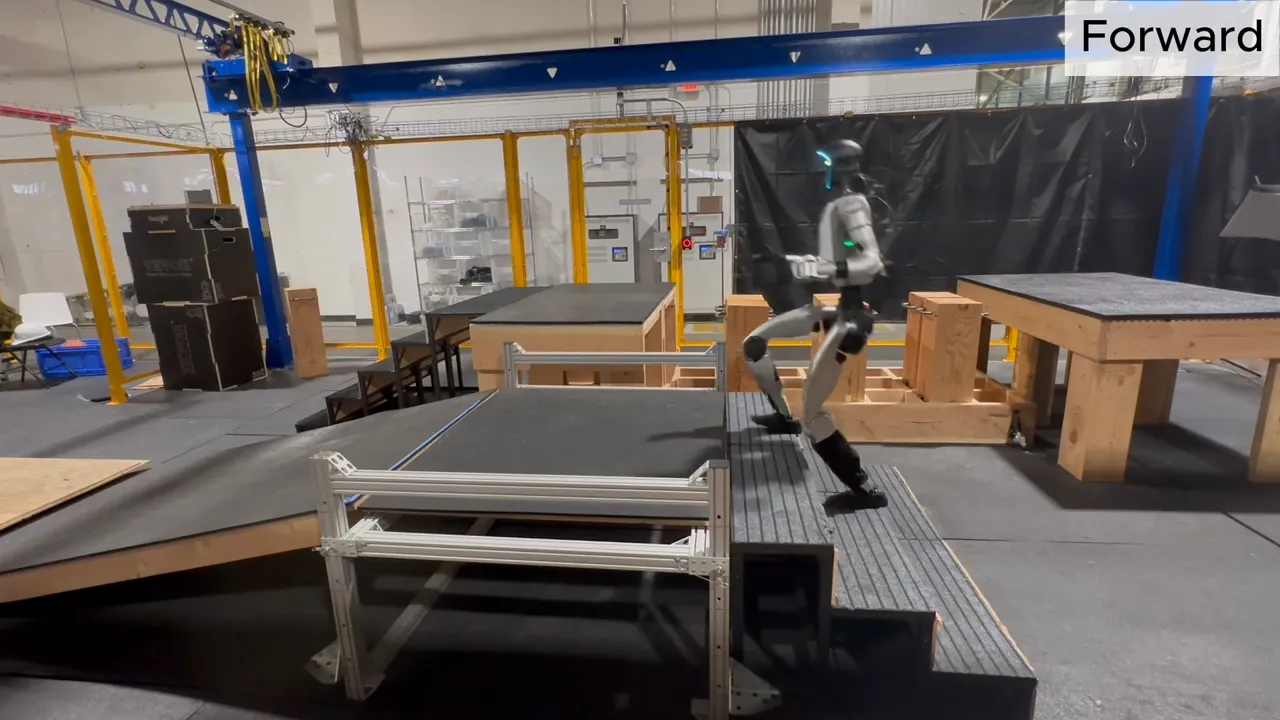
真机实验在 Amazon FAR 的室内场地完成:一条把坡道、台阶、石阵平台串起来的木质课程。策略在带 2 kg 负载的情况下完成前后行走,覆盖 20° 坡、踏步长 22/25/30 cm 的三种楼梯、25 cm 见方且间隙 60 cm 的石阵;同一策略还演示了全身遥操作——跟踪基座线速度与末端姿态命令,站姿阶段可以实时调基座高度与躯干朝向。项目站点附带的所有真机视频都出自同一个策略(标注 2 倍速播放),没有按地形换模型。
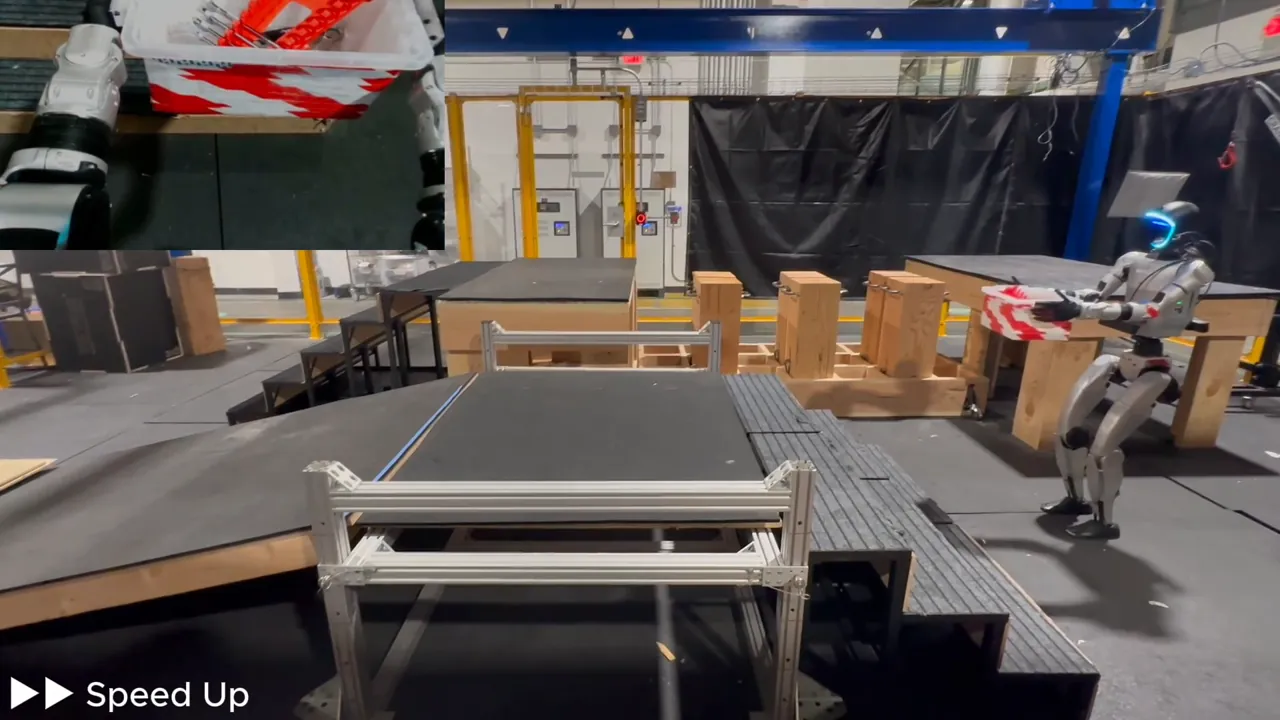
负载实验的设计也值得单独说:仿真消融里把每只手的重量从 0 kg 扫到 2.5 kg,比较完整版与去掉随机侧向遮挡、去掉速度门控的版本——三者训练损失几乎相同,差距全部出现在分布外设置上。只看训练曲线完全无法判断稳健性,必须靠未见地形与非对称感知去压测;这是这个项目方法论上最诚实的一点。
sim2sim:MuJoCo 课程与 ONNX 学生
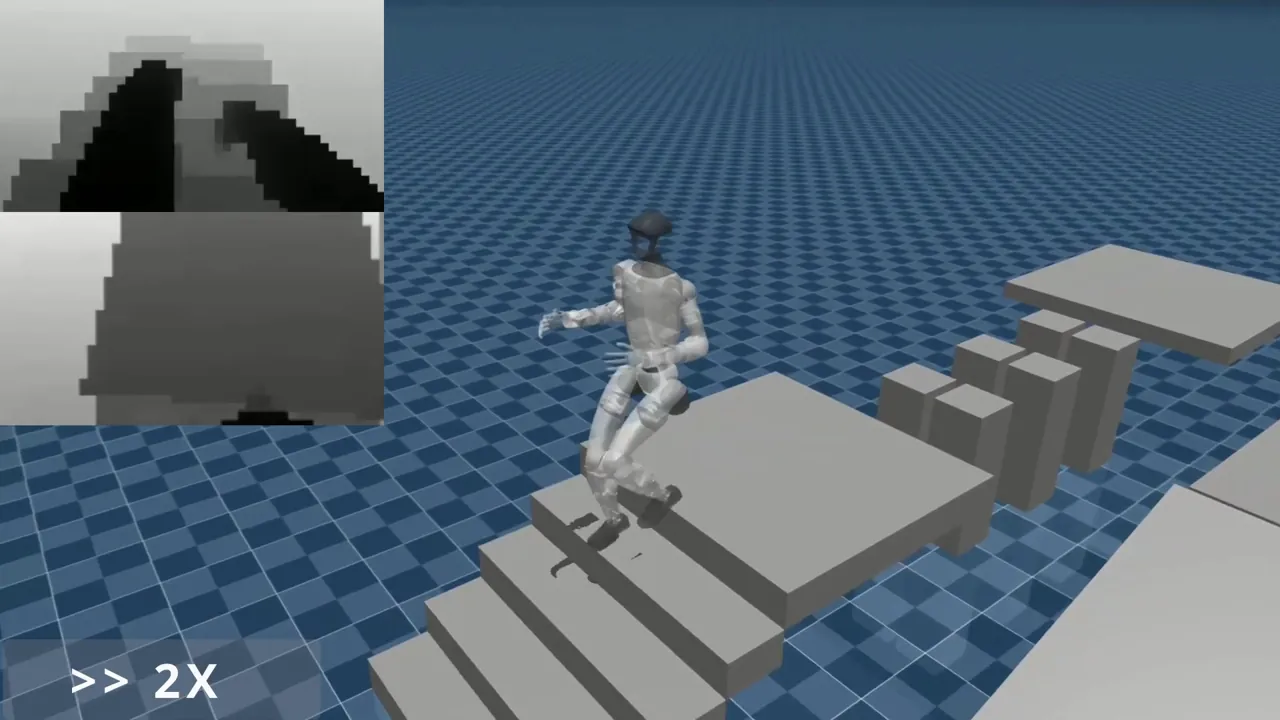
没有真机也能复现大部分行为:仓库带一套 MuJoCo 的 sim2sim 课程,仿真侧与策略侧跑在两个进程里,用 Unitree 的 sdk2py(DDS)通信,深度图走共享内存——这套结构与真机部署完全同构,等于把真机软件栈在仿真里先跑通。策略侧加载导出的 ONNX 学生(仓库附带第 19999 次迭代的导出与对照版本),输入分三组观测:本体观测历史 5 帧每步更新、深度观测历史 2 帧每 5 步采一次、线速度命令 1 帧——后者就是速度门控的输入。官方强烈推荐 Xbox 手柄操作(键盘也能跑):MuJoCo 窗口里按 9 松开固定机器人的弹性带,手柄 start 启动策略、R2 在站姿与行走间切换。
仓库边界:研究版发布、Holosoma 子模块与 FALCON 血缘
读这个仓库需要知道三条边界。其一,核心算法(Warp 多深度相机、多演员 PPO 与 DAgger、视觉 Transformer 与 CNN 模块、地形生成)都在 thirdparty/holosoma 子模块里,clone 必须带 --recurse-submodules,否则 rpl_training/ 里的预设全部无法解析。其二,大量配置以「FALCON parity」注释标明是对齐 FAR 内部 FALCON-Terrains 实验的解析结果——包括奖励项掩码、站姿重采样概率、力预算、甚至「重置时用上一回合长度」这种细节;仓库里六个对齐测试文件就是这些解析的回归守门。其三,这是研究版发布:不承诺后续支持,问题走 issue 或直接联系作者;RPL 的特性合入 Holosoma 主线是另一项独立工作。对想复现的人,路径很清晰:4 卡训专家(或直接用附带的四个教师)、8 卡蒸馏 20000 次迭代、导出 ONNX、跑 sim2sim,再决定要不要上真机。