OPEN SOURCE DEEP DIVE
ω-0 官方代码:人形移动操作世界动作模型的训练、推理与 G1 真机部署栈
论文 ω-0 的官方实现(MIT):Qwen3-VL 条件 + 冻结 ViT-g 帧编码器 + Wan2.2 VAE 潜空间监督的世界动作模型,6 层三流 predictor 耦合 flow-matching 扩散式 66 维全身动作头(30 步 chunk、RTC 实时分块);仓库同时给出 Unitree G1 真机栈——版本化 msgpack 协议、模块运行时、SONIC 全身控制适配、Pico 遥操采集与 HDF5 录制;2026-10-12 补发 7.42GB 预训练权重,与 9 月已公开的 4,828 条 episode ω-HOME 数据集合成完整闭环。
一句话定位:论文、代码、权重、真机数据四件套齐了的全身世界动作模型
ω-0(OMEGA-0)是南洋理工 MARS Lab 与北大、北京智源等团队 2026 年 8 月论文《ω-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation》的官方实现。它要解决的问题是人形机器人「边走边做」:给一句语言指令、一路视觉观测和机器人本体状态,模型直接输出 SONIC 全身控制器能吃的动作潜变量,让移动与操作在同一条策略里并发完成,而不是 locomotion 与 manipulation 两个模块拼接。
仓库 2026-09-29 首次公开(初始提交 2e5c03b),当天连发六个 README 修订;2026-10-13 的最后一次提交 2ca35a3 把 TODO 里「Publish pretrained checkpoints」勾上,并挂出 Hugging Face 权重卡。也就是说,10 月补上的是开源闭环的最后一块——7.42GB 预训练权重(HF 于 2026-10-12 上传)。数据那一块早就到位:4,828 条真机 episode 的 ω-HOME 在 9 月 29 日建仓当天就已勾掉并链到 HF,文件时间戳更早(2026-08-17)。至此代码(MIT)+ 权重 + 数据三件齐了。对一个 56 star 的早期仓库来说,这个完整度在人形机器人论文代码里属于少见的一档。
仓库基本面:小仓库,重 thirdparty
| 指标 | 读数(2026-10-15) |
|---|---|
| stars / forks / open issues | 56 / 3 / 0 |
| 建仓 / 最后提交 | 2026-09-29 / 2026-10-13(README 勾选权重发布) |
| 语言 / 许可 | Python / MIT(GitHub API 读作 NOASSERTION,原因见下文许可段) |
| 自有代码规模 | src/ 7,232 行 + real/ 6,062 行 + tools/ 260 行(Python 与 YAML 合计约 1.36 万行) |
| 仓库体积构成 | GitHub tree 共 6,790 个 blob,其中 6,688 个在 thirdparty/(G1 网格与 STL、38MB arm64 deb、Orin 视频发送器、asio 文档) |
| 配套资产 | HF 权重 keycharon/Omega-zero(7.42GB)、HF 数据集 keycharon/omega-HOME(4,828 episodes) |
两个读数值得停一下。第一,自有代码只有一万三千多行,却覆盖了训练、推理、HTTP 服务、遥操采集、真机部署五件事,说明抽象压得比较狠:src/ 是学习侧,real/ 是机器人侧,两者只通过一套版本化协议对话。第二,thirdparty 占了 98.5% 的文件数,复现时真正要读的还是 src/ 与 real/;但部署时绕不开 thirdparty/gear_sonic_deploy(NVIDIA GR00T-WholeBodyControl 的部署后端,带 Inspire 灵巧手支持)。
模型架构:条件编码、潜空间预见、扩散动作头三段式
训练与推理的主模型是 src/models/wam.py 里的 ACVJEPAModel,前向分三段。第一段是条件编码:Qwen3-VL 骨干(配置默认 Qwen/Qwen3-VL-2B-Instruct)吃「视图标签 + 当前帧 + 小写指令」的聊天模板,取最后一层隐状态在序列末尾的池化作为 VLM 特征;并行的冻结 T5 文本编码器(默认 t5-base)对指令做掩码平均池化,作为扩散头的文本条件。第二段是视觉潜空间:一个 ViT-g 规格的帧编码器(hidden 1408、depth 40、heads 16、mlp_ratio 48/11、RoPE、patch 16、输入 256×256)把历史帧编成 token 序列,finetune 阶段整块冻结;未来观测的监督不走像素,而是把下一段视频送进 Wan2.2 TI2V-5B 的 48 通道 VAE(fast_wan_vae_encode:面积上限 256×256、patch [1,2,2]、vae_stride [4,16,16]),得到潜变量网格作为预测目标。这就是论文标题里「latent predictive」的代码形态:预测未来视觉表征,而不是重建未来 RGB。
第三段是 ACVJEPAPredictor:6 个 ACBlock 堆叠,每个块维护三股 token 流——prefix(VLM 特征 + T5 文本 + 视图嵌入 + 当前帧 token)、motion(30 个可学习动作查询)、video(1,792 个可学习视频查询)——流内各自做带 ACRoPE 的自注意力(video 流因果),流间做三路交叉注意力(motion 读 prefix、video 读 prefix、motion 读 video)。video 流末端经 predictor_proj 投回 48 通道,与 Wan 潜变量目标对齐;motion 流送进 dit_ddim_xl 动作头:一个带 adaLN-Zero 调制的 DiT,配 flow matching 传输与 cosine 噪声调度,输出 30 步 × 66 维的全身动作 chunk。视图条件用两个可学习嵌入 view_1/view_3 区分第一视角与第三视角,训练时 ego 记 1、exo 记 0。
| 阶段 | 配置 | 训什么 / 冻什么 | 动作表示 | 关键超参 |
|---|---|---|---|---|
| 动作 token 预训练 | src/configs/vlm_pretrain.yaml | 训 Qwen3-VL 的 LLM 与 mm projector,视觉塔冻结 | FAST tokenizer 2,048 bins、75 维 SMPL、chunk=1、观测后第 3 帧动作 | lr 2e-5、1M steps、bf16、flash_attention_2、序列上限 8192 |
| WAM 微调 | src/configs/finetune.yaml | 冻结 VLM 与帧编码器,只训 predictor 与动作头(strict_predictor_only) | 66 维连续动作、chunk=30、RTC 开启(max_delay 8) | lr 1e-4 cosine、warmup 1000、80k steps、batch 32/卡、bf16 |
损失函数在 src/training/losses.py 的 FinetuneObjective 里,形式很干净:总损失 = jepa 权重 × MSE(预测潜变量, Wan VAE 目标潜变量) + 动作权重 × 按维加权的 L1(动作),可选再加一项 chunk 内时序差分对齐损失来抑制「整段动作塌成一条直线」。RTC(real-time chunking)在训练侧的体现是给每个样本随机一个 delay,把前 delay 步的 sigma 置 0——即告诉 flow matching「这段前缀是已知的」;推理侧 src/inference/model.py 对应地把上一段预测的动作写进噪声前缀再采样。默认微调食谱还有一个容易被忽略的设定:ac_vjepa_force_null_state: true 配合 state dropout 0.1,即主结果是不吃本体状态的纯视觉策略,状态通道留作消融。
推理服务:标准库 HTTP,单会话单推理
src/inference/server.py 没有用 FastAPI,而是标准库 ThreadingHTTPServer 加一个 Service 状态机,只暴露 /health、/reset、/act 三条路由。约束写得很硬:同一时刻只允许一个会话、一次在飞推理(拿不到锁直接 429 Model is busy);request_id 去重,重复请求报 400;会话被 /reset 换掉后旧会话进 retired 集合(上限 4096)不可复活,在飞响应也会被 generation 计数立即作废;请求体上限 128MB、socket 超时 2 秒。对真机控制回路来说,这些「拒绝服务」的边界比吞吐量更重要:宁可让客户端重试,也不能让两路命令同时进机器人。
WAMInference 负责把协议层的观测变成模型输入:图像历史 deque(默认 history_size 1)、<EGO_VIEW>/<EXO_VIEW> 视图标签、指令小写化、T5 文本缓存(指令不变不重编码)、固定种子 1039 的采样噪声;输出反归一化后是 (30, 66) 的 float32 动作块,周期 33,333,333 ns,即 30Hz 控制节奏。
真机栈 real/:版本化协议 + 模块运行时 + SONIC 适配
real/ 是这次开源里工程含量最高的部分。real/core/protocol.py 定义 VERSION=1 的 msgpack 主机契约:TensorSpec 校验 dtype/shape/有限性、单张量 64MB 上限,CommandMetadata 带 session_id、sequence 与 valid_until_ns 过期时间——过期命令在适配层直接丢弃,这是真机安全的第一道闸。real/core/runtime.py(988 行)实现模块 worker、有界 StreamQueue(满了丢新样本并计数)、按名字定锁序的 Port、以及事件绑定(键位到动作的映射表)。
| 模块(deploy.yaml) | 类型 | 速率 | 职责 |
|---|---|---|---|
| telemetry | ZmqReceiver | 100Hz | 订阅 SONIC 的 g1_debug 遥测(关节、基座四元数、双手状态) |
| camera | JpegZmqCamera | 30Hz | ZMQ 5555 收 JPEG、TCP 13579 发 OPEN_CAMERA,左目 640×360 裁剪 |
| lifecycle | Lifecycle | 50Hz | 启动/停止/规划模式切换,2.5 秒控制器安定期,键位事件源 |
| model | OmegaInferenceClient | 100Hz(推理间隔 8 步) | 调推理服务,RTC 调度(overlap 9、响应最长 5 秒),输出 SONIC 命名命令 |
| sonic | SonicCommandAdapter | 100Hz | 触发器插值到 Inspire 六通道开闭目标、限位校验、模型/XR 双源仲裁 |
| sender | ZmqSender | 100Hz | ZMQ 5556 发布 pose v4 与 command v1 给 SONIC |
OmegaInferenceClient 按服务返回的动作维度自动识别四种布局:latent66(前 64 维 token_state 直喂 SONIC,末 2 维是双手触发器)、smpl71、smpl75、joints86。后三种需要一份标定 skeleton,客户端用正向运动学把 SMPL 姿态换算成 24 关节位置与腕部目标,再拼成 SONIC 的命名输入;布局不匹配或 skeleton 缺失在绑定阶段就报错,而不是等到机器人动起来。采集侧 collect.yaml 走 Pico 体感遥操(XRoboToolkit):三点标定、SMPL 前 22 关节序映射、Inspire 手触发器插值,录制成 state_action.hdf5 + ego.mp4(可选 exo.mp4 与 exo_depth/),与 ω-HOME 的目录结构一一对应。
数据与权重:ω-HOME 4,828 条 episode,权重是 8 卡训练存档
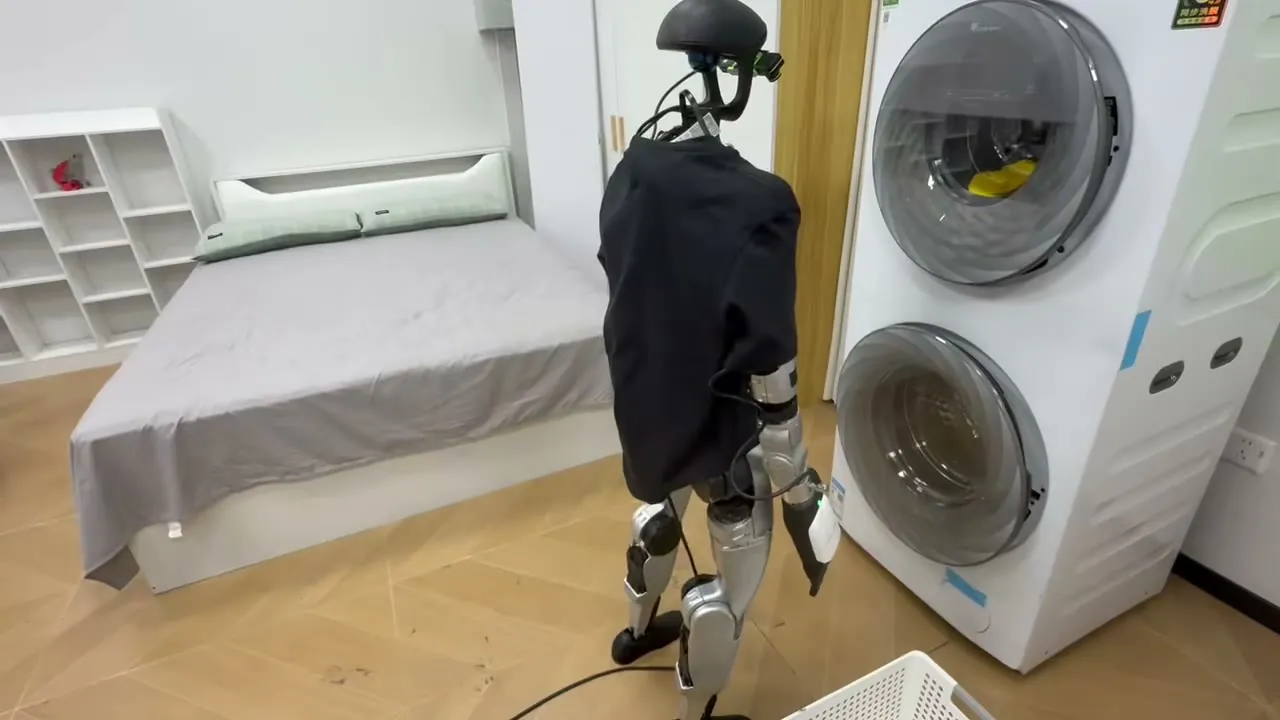
ω-HOME 数据集(HF keycharon/omega-HOME,MIT)按任务目录组织,实测 24 个任务文件夹、4,828 条 episode、19,991 个文件;每集四件套是 ego.mp4、exo.mp4、state_action.hdf5、session_meta.json,论文称总时长 40+ 小时。按 session_meta.json 逐个数是 4,828 集,顶层 episode 目录却只有 4,827 个——push_chair 下有一集被误嵌进了另一集的文件夹里(episode_0014_20260611_230102/episode_0016_20260611_230210/),是打包时的一处小瑕疵,不影响数据本身。任务分布相当均匀(单任务 187–210 集),覆盖 hang_clothes、clean_bed、mop_floor、move_table_with_human、retrieve_from_the_upper_fridge 等家庭移动操作,比论文实验章节评估的 11 项任务更宽——数据集是「采集面」,实验是「评估面」。
权重仓 keycharon/Omega-zero 于 2026-10-12 更新:model.safetensors 7.42GB、bf16、架构 Qwen3VLForConditionalGeneration(text hidden 2048、28 层),词表 153,792——比 Qwen3-VL 原生词表多出的正是 FAST 预训练加进去的 2,048 个 <|a_i|> 动作 token 与动作起止特殊符。目录里还有 8 份 random_states_*.pkl、latest 与 zero_to_fp32.py,是 8 卡 Accelerate/DeepSpeed 的原始存档形态;run_config.json 写着 exp「Wan+JEPA」、wandb group finetune、全局 batch 256、lr 1e-4 cosine。README 的 serve.yaml 说明也对应:这份权重走「original-format checkpoint」加载路径,而仓库自己训出的导出件走 model.artifact 路径。
复现门槛与许可边界
环境侧用 uv:uv sync --locked --extra train --extra deploy --python 3.10 --inexact 后还需源码编译 flash-attn。真机侧的依赖链更长:SONIC 控制器要在 gear_sonic_deploy 的 TensorRT 容器里跑,Inspire 手要装独立 SDK 环境,ZED Mini 要装 ZED SDK 并在机器人上编译 C++ 的 OrinVideoSender_jpeg,工作站还要 Pico 的 xrobotoolkit_sdk。训练侧要自备 Qwen3-VL、T5、V-JEPA 帧编码器 checkpoint、Wan2.2 VAE 与 predictor 初始化权重五个外部资产,配置里用 ${VLM_PATH} 这类环境变量占位。数据集与训练读取器之间还差一道转换:ω-HOME 发布的是 task/episode 两级目录下的四件套原始录制,而 FinetuneDataset._build_episode_list 走的是非递归的 annotation/*.hdf5 glob、再按同名 stem 去 first/ 里配 ego 视频,所以复现前要逐集跑 tools/export_training_data.py(内部用 EpisodeReader 直接吃 state_action.hdf5 与 session_meta.json)重采样导出成 annotation/ + first/ 的扁平布局。换句话说:推理与部署路径是闭环的,从头训练路径需要自己凑齐一组大模型资产。
许可要分三层读。代码仓 LICENSE 是标准 MIT 加一段「第三方代码保留原许可」的声明,pyproject 也写 license = "MIT" 并把 src/models/WAN_LICENSE.txt 列入 license-files;GitHub API 之所以读成 NOASSERTION,正是这段附加声明让自动识别器放弃了匹配。HF 权重卡标的是 apache-2.0,与代码仓的 MIT 并不相同,商用前需要分开核对。thirdparty/ 下的 gear_sonic_deploy 与 XRoboToolkit-Orin-Video-Sender 各自保留上游许可与 README。
局限与判断
三个明确的边界。其一,仓库没有 tests/ 目录,尽管 pyproject 的 pytest 配置指向它——协议层与运行时的严谨写法(锁序、过期丢弃、代际作废)目前靠代码自证,没有回归网。其二,硬件绑定深:Unitree G1 + Inspire 手 + ZED Mini + Pico 遥操是配置与几何代码的默认假设,换本体要改 skeleton、URDF 与裁剪参数三处。其三,权重是研究用途,HF 卡自己也写明不应在无安全机制的环境下无人监督部署。
但入库理由同样清楚:这是少数把「论文方法 + 训练配方 + 推理服务 + 真机运行时 + 遥操采集 + 数据集 + 权重」七件事一次放齐的人形机器人仓库,且 real/ 里的版本化协议、会话失效与 RTC 调度达到了产品级代码的自觉。对跟踪全身控制与世界动作模型这条线的读者,它既是可复现的基线,也是一份可以抄的工程范本。