MetaTron:冻结一个全身策略,让人形机器人行为变成代码
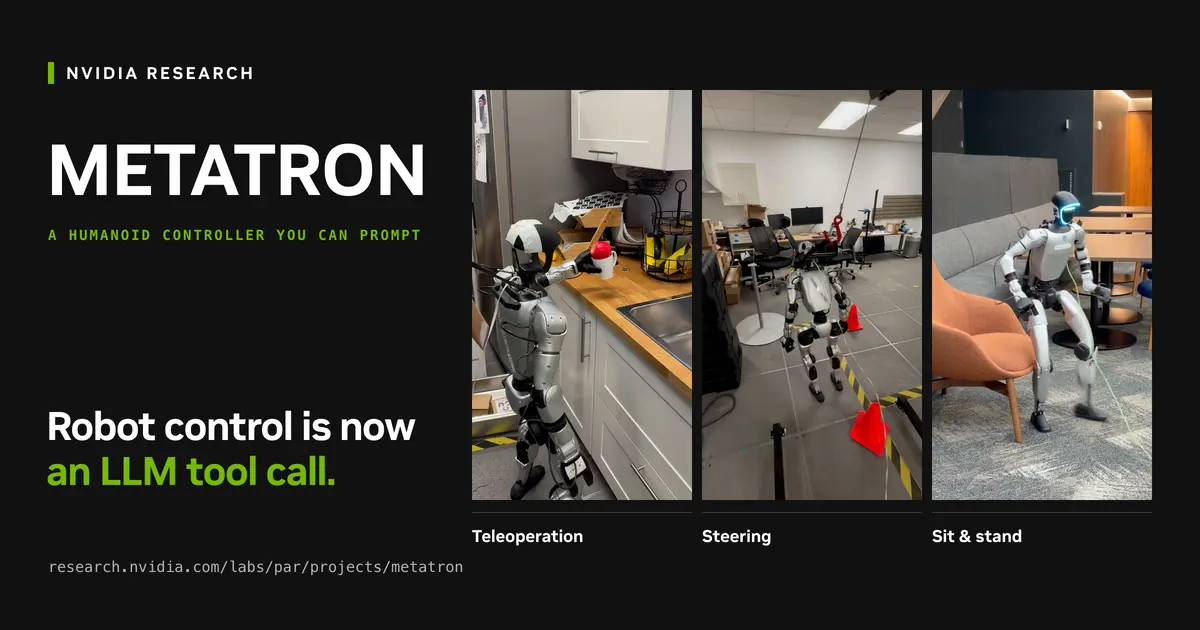
NVIDIA MetaTron 冻结可提示的全身执行层,让程序与编码智能体编写运动 skill;实测覆盖伸手、抗推、坐下、恢复与仿真运动,同时保留感知和安全边界。
MetaTron 的核心判断属于架构层面,而不只是算法层面:不要再为每一个任务重新训练人形机器人控制器。只训练一个全身执行层,把它冻结,然后让普通程序告诉这个身体下一步要完成什么。
人形机器人已经展示过行走、伸手、站立、跳舞以及跌倒后起身等令人印象深刻的能力。问题在于,这些能力往往由不同的控制器分别提供,每个控制器都有自己的奖励函数、观测、检查点和切换逻辑。每增加一种新行为,系统都要重新回答同一组底层问题:身体应该怎样转移重心,四肢应该怎样配合,又该怎样保持稳定?
来自 NVIDIA 与 Dollhouse Robotics 的研究项目 MetaTron 提出了一种更清晰的分工:生成式策略负责物理协调,带状态的程序也就是 skill 提供意图。策略针对每种机器人形态只训练一次,随后被冻结。增加新行为时,开发者改变发送给策略的目标,而不是再训练一个运动控制器。
项目页面用一句颇为直接的话概括它:“机器人控制现在是一次 LLM 工具调用。”这个说法需要加一个重要限定:语言模型并没有进入 50 Hz 的平衡控制回路。它在离线阶段编写并迭代 skill 代码。运行时,skill 像普通软件工具一样被调用,由这段代码向 MetaTron 发送结构化目标。
问题:每个任务都想要自己的控制器
传统的人形机器人系统可能用一个策略负责移动,另一个负责操作,再一个负责起身,还会有专门处理柔顺物理交互的控制器。这些模块重复实现平衡与全身协调,也会在真正关键的时刻制造接缝:坐下之后要站起,跌倒恢复之后要接着行走,或者人的手正在带动机器人手臂时,机器人仍要保持躯干目标。
MetaTron 把问题拆成两层:
- 应该发生什么? 一只手要到达某个点,躯干要降到座位上,机器人要以某个速度移动,或者身体要恢复直立。
- 身体应该怎样运动? 学习到的策略决定如何把动作分配到各个关节、如何维持平衡,并生成最终动作。
第一个问题属于 skill,第二个问题属于执行层。一个 skill 可以是简单代码、有限状态机,也可以是周期性轨迹规则。它不需要规划每一个关节。MetaTron 学会容忍粗略甚至不完整的身体目标,因此 skill 只需勾勒期望动作,不必提供一条完美的参考轨迹。
这并不意味着规划消失了。任务系统仍然负责选择目标、排序长时程行为。感知、定位、物体检测和自主接近仍是独立问题。这个项目更窄也更实用的贡献在于:只要一种行为能够表达为一串部分身体目标,同一个运动策略就可以执行它。
Prompt 不是文本,而是结构化运动目标
MetaTron 所说的“prompt”有明确的控制含义。在时刻 $t$,prompt 是一组可选的目标流与场景上下文:
$$g_t = \left(C_t^w,\ C_t^\ell,\ u_t,\ \xi_t,\ b_t\right)$$
每一项对应不同类型的请求:
- $C_t^w$ 是世界坐标系中的身体位置或朝向,每一项都带到达时间。
- $C_t^\ell$ 是标准局部坐标系中的身体姿态,不受世界位置和朝向影响。
- $u_t$ 是机器人朝向坐标系中的平面移动速度。
- $\xi_t$ 是由一小组无序示例姿态构成的风格局提示。
- $b_t$ 用长方体描述附近场景几何,每个长方体由八个角点表示。例如一张沙发可以拆成座位盒和靠背盒。
掩码决定哪些身体、属性与未来时刻受到约束。一个目标可以只要求手的位置,而让手的朝向自由;可以指定躯干位置,却完全不指定四肢目标;也可以把世界坐标系目标与局部风格提示组合起来。连时间也可以是近似的,因为每个目标携带的是到达时间,而不是精确的帧编号。
这个接口比单独一个速度指令更有表达力,也比稠密动作跟踪更宽容。只有速度指令时,系统知道走多远、走多快,却不知道双脚应该以什么节奏落地。稠密参考会规定每个身体在每一时刻的状态,却几乎没有给适应和纠正留下空间。MetaTron 的 prompt 位于两者之间:既有足够结构表达意图,也留出足够自由,让策略自行完成全身协调。
第一阶段:训练稠密运动专家
训练从仿真中的强化学习开始。一个运动跟踪器接收仿真器提供的特权状态和完整未来参考,输出能够复现该参考的关节动作。针对 Unitree G1,NVIDIA 使用四类数据训练专家:
- BONES-SEED,用于大规模日常动作捕捉。
- AMASS + LAFAN,用于移动、运动和一般人体动作。
- 合成恢复动作,从随机跌倒姿态生成。
- SAMP 场景交互,通过考虑碰撞的重定向优化,适配坐在家具上等行为。
四组 G1 专家数据的相对训练权重分别是 0.6、0.2、0.1 和 0.1。每组使用 32 步 rollout、每块 GPU 2,048 个环境,并执行两次优化。专家使用 PPO 训练。奖励由身体位置、朝向和速度的指数跟踪项,动作突变惩罚以及机器人形态相关的失败惩罚共同组成:
$$r_t = \sum_k w_k\exp\left(-\lambda_k e_{k,t}\right)-w_a R_{\mathrm{act},t}+r_t^{\mathrm{extra}}$$
额外奖励包括选定身体部位的精度项、关节限位惩罚、接触不匹配惩罚和自接触惩罚。这些奖励训练的是稠密跟踪专家,而不是最终部署的学生策略。它们相当于脚手架,使第二阶段成为可能。
第二阶段:把完整运动蒸馏成部分目标控制
一个部分 prompt 允许许多种合理完成方式。如果直接从 prompt 回归单一动作,网络可能把互不兼容的动作平均成犹豫甚至不稳定的结果。因此 MetaTron 使用条件变分自编码器。只在训练时使用的后验会看到完整参考和特权状态;可部署的先验只看到观测、传感器历史和部分 prompt。
对于观测 $x_t=(o_t,a_{t-1})$、特权状态 $s_t$ 和完整参考 $y_t$,两个分布分别定义为:
$$p_\theta(\tilde z_t\mid x_t,g_t)=\mathcal N\left(\mu_t,\operatorname{diag}(\sigma_t^2)\right)$$
$$q_\phi(\tilde z_t\mid x_t,g_t,s_t,y_t)=\mathcal N\left(\mu_t+\Delta\mu_t,\operatorname{diag}(\sigma_t'^2)\right)$$
采样得到的潜在变量会投影到单位球面,再与确定性条件融合:
$$z_t=\frac{\tilde z_t}{\lVert\tilde z_t\rVert_2},\qquad h_t=f_\theta(d_t,z_t)$$
条件 $d_t$ 携带当前观测上下文与 prompt。经过球面投影的潜在变量负责选择一种兼容的运动完成方式。解码器把融合结果、当前观测和上一时刻动作结合起来,生成关节目标。部署时,后验、完整参考编码器和稠密专家都会被移除,只保留先验、融合模块与动作解码器。
蒸馏采用 on-policy 方式。大部分仿真 rollout 由学生策略驱动,冻结的跟踪器为学生实际访问到的状态打标签。这一点很重要,因为学生一定会犯错。只由完美参考状态组成的数据集,无法教会它怎样从自己的偏差中恢复。训练混合以 0.9 的概率把控制权交给后验引导学生,其余时间交给冻结跟踪器。
主目标组合了动作模仿、先验与后验对齐、单位范数正则、动力学预测、时间一致性和动作平滑:
$$\mathcal L=\mathbb E\left[\ell(a_t^q,a_t^{\mathrm{trk}})\right]+\beta_eD_{\mathrm{KL}}(q_\phi\Vert p_\theta)+\lambda_\mu\mathbb E\left[(\lVert\mu_t\rVert_2-1)^2\right]+\mathcal L_{\mathrm{aux}}$$
辅助项预测下一时刻条件,并分别平滑连续融合表示和连续动作。G1 模型对 KL 权重使用周期性退火。推理时只运行先验路径。
G1 和仿真角色 SOMA 各有一个独立策略。G1 策略把四个专家蒸馏进一个学生,SOMA 则使用场景感知跟踪器。因此,这项工作既能展示物理人形机器人,也能展示仿真中的奔跑、滑行、攀爬和杂技,但并没有声称一个检查点可以跨机器人形态迁移。
第三阶段:skill 只是冻结策略外围的普通代码
蒸馏完成后,MetaTron 不再继续学习。每一种新行为都由一个 skill 实现:它在每个控制步观察任务状态并更新 prompt。skill 可以使用时钟、控制器输入、有限状态机、物体几何或录制动作,而策略权重保持不变。
关键设计选择是:skill 不需要直接命令关节。它添加目标,让一个原本欠定的动作更容易执行。只有速度指令时,机器人可能走出短促、犹豫的步子;转向 skill 加入带时序的落脚点目标后,步态会变得更明确。平衡与关节协调仍然由策略负责。
对于未来时刻 $\tau$ 的第 $i$ 只脚,论文中的转向规则把目标放在:
$$p_i(\tau)=b_i+\begin{bmatrix}A(v)\cos\alpha\cos\phi_i\\W s_i|\sin\alpha|+|\cos\alpha|\sin\alpha\cos\phi_i\\H\max(0,-\sin\phi_i)\end{bmatrix}$$
其中 $b_i$ 是标定后的支撑偏移,$v$ 是移动速度,$\alpha$ 是移动方向与机器人朝向之间的夹角,$\phi_i$ 按与速度相关的步频推进。这些系数让速度升高时步幅更大、节奏更快,让侧向移动时站姿更宽,并在摆动中段抬脚。两只脚相差半个周期。
部署逻辑的简化版本大致如下:
frequency = min(2.0, 0.83 + 0.93 * speed)
amplitude = 0.13 + 0.065 * speed
phase += 2 * pi * frequency * dt

for future_time in future_times:
    for foot, phase_shift in [(right_foot, 0), (left_foot, pi)]:
        angle = phase + 2 * pi * frequency * future_time + phase_shift
        offset = stance_offset(foot, travel_angle)
        offset.xy += amplitude * cos(angle) * swing_axis
        offset.z += 0.08 * max(0, -sin(angle))
        goals.add(foot, to_world(offset, future_time), future_time)

policy.execute(velocity, heading, goals)
这仍然是一段程序。它没有学习任务专用策略,也没有绕过控制器直接写关节命令。它改变 prompt,让同一个策略选择更好的行走解。
坐下:三个粗略目标已经足够
坐下 skill 接收一个由长方体编码的附近物体提示,从中提取座位上方躯干目标和座位前缘之外的脚部目标。向下移动时,躯干目标是静态的。站起时,skill 让躯干沿直线抬高并向前移动,具体的迈步方式和平衡则由策略补足。
在硬件演示中,机器人一开始就在椅子或沙发附近,并直接获得物体表示。项目没有展示自主感知和接近过程。这里真正相关的结果是:同一个冻结控制器能够从站立、行走切换到坐下,再站起来走开,改变的全部内容就是 prompt。
恢复:身体跌倒时改变目标
恢复是一个有限状态机 skill。它比较当前躯干高度和直立参考高度。低于直立高度的 65% 时,skill 暂停任务 prompt,请求直立姿态;超过 90% 后恢复原任务。滞回区间避免机器人在阈值附近来回切换。
首个请求到达时间随剩余高度差缩放:
$$\tau_0(h)=\operatorname{clip}\left(\frac{H-h}{v_{\mathrm{rise}}},0.25,1.0\right)$$
仿真中 $v_{\mathrm{rise}}=0.8$ m/s。后续目标槽每次增加 0.25 秒,最远覆盖两秒时域。G1 部署 skill 把请求进一步简化:只指定躯干高度,基本放开位置、朝向、双手和双脚。硬件演示涵盖从坐姿、仰卧、侧卧和俯卧状态恢复。这些结果证明控制器具有一定的动作库覆盖,并不构成安全保证。
柔顺交互:让手臂保持自由
进行物理引导时,skill 命令机器人保持零移动速度,并指定躯干高度与朝向,但对双臂不作任何要求。由于策略会把未指定的属性视为自由变量,人可以移动机器人手臂,而不会与隐藏的完整姿态目标对抗。项目展示了握手和人工引导动作,同时明确指出这不是经过认证的安全保证。
智能体编写 skill:代码成为新的任务接口
论文描述了一条 skill 编写回路:人类说明期望行为和成功标准,编码智能体搭建仿真试验场,分析动作片段,提出紧凑规则,运行测试,并针对失败继续修改。智能体修改的是生成目标的代码,不是策略权重。
NVIDIA 项目页面给出了两个具体例子。Claude Code 被用来从运动数据拟合转向规则。在仿真运动任务中,GPT-6 Astra 在人类指导下编写并调整目标代码、时序与动作参考。
这条工作流之所以重要,是因为它改变了“机器人工具调用”的含义。传统工具调用可能是 open_cabinet(),而 MetaTron 的 skill 位于更底层:它们生成带时序的身体目标、速度命令和切换逻辑。语言模型的价值在于能够根据仿真结果编写和迭代代码,而不是在运行时从像素直接推断关节力矩。
运动演示体现了这种分层带来的灵活性:
- 四道栏架:机器人先奔跑,在距离每根横杆 2.6 米时切换到录制的跳跃目标,双脚越过后再恢复奔跑。展示的运行通过四根 20 cm 高的横杆,没有碰杆。
- 跌倒与恢复:机器人以 3.83 m/s 撞上 40 cm 高的横杆后跌倒。同一个 skill 检测到躯干高度过低,切换到直立请求,并在跌倒后 3.28 秒恢复奔跑。
- 保龄球:录制动作提供身体目标和定时出手。展示的一球击倒 10 个球瓶中的 9 个。
- 网球与足球:带时序的球拍或脚部目标去匹配脚本控制的球。网球离拍速度为 5.37 m/s,足球峰值速度为 4.82 m/s。这些都是定时训练项目,不使用视觉感知。
硬件部署栈
部署到 G1 的策略使用 C++ 实现。TensorRT 与 CUDA graphs 在一台配备 NVIDIA RTX 5090 GPU 的笔记本上运行网络,笔记本通过以太网连接机器人。Xbox 控制器提供转向命令,PICO 头显把手部动作映射为遥操作输入。
测得的传感器到命令延迟为 1.3 ms。这个数字是处理延迟,不是控制周期。策略每 20 ms 生成一次新动作,即 50 Hz;训练时每个动作之间执行四个仿真器物理步。硬件演示使用确定性的先验均值,而不是从潜在分布采样。
一个检查点支持转向、遥操作、坐下、恢复、柔顺引导和稠密动作回放。切换模式时,改变的是目标观测与掩码,不需要替换模型权重或传感器处理代码。这就是“执行层”的实际含义:一个稳定的运动基底,任务专用程序可以在它之上组合。
实验究竟证明了什么
MetaTron 在同一个 G1 上与两条参考跟踪流水线比较。第一条用 ARDY 生成全身参考,再用 SONIC 跟踪;第二条用 GRU 生成移动动作,为伸手加入解析式手臂 IK,再交给 SONIC 跟踪。这些比较检验的是完整系统,因此不能把每一种差异都归因于单一模块。
全身伸手
伸手测试包含 54 个腕部目标,覆盖 0.35 至 1.8 米的三种距离、0.55 至 1.35 米的三种高度,并分别测试左右手。只有腕部在机器人保持直立时稳定停留在目标 10 cm 内,才计为成功。
| 方法 | 到达目标 | 到达目标上的误差 | 保持直立 |
|---|---|---|---|
| MetaTron | 87% | 5.7 cm | 100% |
| ARDY + SONIC | 39% | 6.4 cm | 82% |
| GRU + IK + SONIC | 28% | 5.6 cm | 81% |
| GRU + SONIC | 0% | 不适用 | 87% |
真正值得注意的差异不在手臂精度。对于能够到达目标的方法,腕部误差其实相近。区别在于全身是否能够充分调整,让机器人有机会到达目标。高目标需要反向配重,低目标需要折叠髋部。一个始终按固定站立高度规划的动作生成器,很难自然提供这些补偿。
转向过程中的抗推能力
每次试验都在 G1 以 1 m/s 向前行走时,对躯干施加持续 100 ms 的力脉冲。力的大小从 200 N 到 1,000 N,覆盖八个方向。只有在八秒窗口的最后两秒仍保持直立,才算成功。
| 推力 | MetaTron | ARDY + SONIC | GRU + SONIC |
|---|---|---|---|
| 200 N | 100% | 100% | 100% |
| 400 N | 100% | 100% | 75% |
| 600 N | 38% | 17% | 25% |
| 800 N | 50% | 0% | 0% |
| 1,000 N | 88% | 0% | 0% |
参考流水线在 600 N 以上的所有试验中都失败。MetaTron 在 1,000 N 时仍能承受八个方向中的七个。这里不应把非单调曲线理解为真实的物理受力响应规律:论文对每个方向只做一次试验,在这个样本量下,600 N、800 N 和 1,000 N 之间的差异属于噪声范围。
稠密动作跟踪
一个可提示策略在完整参考可用时,仍然应该能够跟随参考。基准集包含 129,553 条 BONES-SEED 动作片段,总时长 262 小时。在 MuJoCo 中,MetaTron 和 SONIC 都会提前 0.9 秒收到参考。
| 协议与方法 | 成功率 | 位置误差 | 旋转误差 | Jerk |
|---|---|---|---|---|
| 全局,MetaTron | 88.5% | 42 mm | 10.7 deg | 123 m/s3 |
| 全局,SONIC | 49.6% | 83 mm | 9.9 deg | 240 m/s3 |
| 局部,MetaTron | 97.9% | 35 mm | 11.4 deg | 111 m/s3 |
| 局部,SONIC | 98.7% | 33 mm | 10.6 deg | 146 m/s3 |
在 SONIC 的局部协议下,两个策略的成功率与姿态误差基本相当,而 MetaTron 报告的 jerk 低 24%。在全局协议下,MetaTron 更能让机器人停留在参考所指定的世界位置。这个比较也同时检验了接口:SONIC 没有接收世界位置目标,无法显式纠正不断积累的漂移。对于需要接受“去那里”这类 prompt 的控制器,这个结果很重要,但它并不是纯粹的同接口跟踪器对比。
MetaTron 也不依赖 0.9 秒的固定前视时间。把时域缩短到 90 ms 后,同一个检查点在局部协议下仍有 94.8% 的片段成功率,全局协议下为 54.0%。后者已经高于 SONIC 使用完整 0.9 秒前视时的全局成功率。
MetaTron 没有解决什么
这些限制与演示本身同样重要:
- 动作库受训练数据约束。如果动作库没有覆盖某种行为,冻结策略不会因为 skill 提出请求,就凭空发明可靠解。
- 欠定目标可能选错动作。从静止状态突然请求 2 m/s,常会导致机器人前滚。NVIDIA 用指数移动平均平滑速度命令,但这只是缓解措施,不是通用解法。
- 任务选择仍然在系统外部。MetaTron 不负责长时程任务规划,也不决定调用哪个 skill。外层智能体或状态机承担这些职责。
- 展示的坐下回路不包含感知。机器人被放在家具附近,并直接收到物体提示。自主检测、定位和接近仍是后续工作。
- 运动示例依赖任务代码,而不是视觉感知。栏架位置与球的时序都写在仿真脚本里。结果证明的是全身执行与 skill 组合能力,不是自主运动竞技。
- 硬件证据具有演示性质。恢复只覆盖测试过的初始姿态,步态改善采用定性评价。可靠性、接触安全以及接近执行器极限时的行为,仍需要系统测量。
这些限制不会抹掉架构层面的结果,只是界定了它的位置:MetaTron 是可编程运动层,不是自主机器人大脑。
这对具身智能意味着什么
当前许多机器人系统试图让一个大模型同时推理语言、视觉、规划和低层控制。MetaTron 主张换一条边界:语言模型可以发挥作用,但不必成为控制器。它可以在秒到分钟的时间尺度上检查动作数据、编写目标生成代码、搭建仿真测试并调试失败。一个更小的冻结策略则以 50 Hz 处理平衡与协调。
这种分层有三个实际优势。第一,新任务不需要新运动策略。第二,任务逻辑是代码,可读、可版本化。第三,昂贵的学习组件可以针对每种机器人形态只训练和验证一次,而应用行为围绕它更快演进。
它也让下一个瓶颈更加清楚。如果 skill 成为新接口,机器人就需要可靠的方法来生成、测试和认证这些 skill。编码智能体可以在仿真中迭代,但仿真覆盖、感知、安全与现实世界差异仍然困难。skill 层把这些难题明确暴露出来,而不是继续把它们埋进另一个端到端网络。
因此,把 MetaTron 理解为基础设施最合适。它没有让每一种人形机器人行为都变成语言模型输出;它把许多行为转化成语言模型能够协助编写的代码,前提是期望动作落在控制器已经学会的动作库中,并且外围系统能够提供正确目标。
来源与延伸材料
- 项目页面:NVIDIA Research - MetaTron
- 技术论文:MetaTron: A Promptable Whole-Body Execution Layer for Humanoids
- 交互式 MuJoCo 演示:ProtoMotions MetaTron demo
来源:NVIDIA Research, MetaTron。本文基于项目页面、交互式说明与技术论文,为 RobotWorld 进行完整改编。文中媒体均取自项目公开发布的资源,并托管在本地。
原文来源:NVIDIA Researchhttps://research.nvidia.com/labs/par/projects/metatron/