
让 3B VLM 边看边问:AgentVLN 如何把长程导航拆成可调用技能
AgentVLN 让 3B VLM 充当导航大脑,调用视觉 SLAM、建图与路径技能,并用跨空间映射和主动提问把长程导航拆成可执行的语义决策。
一台机器人走进陌生的办公楼。它收到的指令不是“前往坐标 (4.2, 8.7)”,而是一串由地标、转向、空间关系和最终目标组成的描述:走过几排柜子,在通道尽头右转,找到冰箱和灰色箱子,最后停在白色水桶前。它没有这栋楼的预建地图,也没有第二次试错机会,只能一边移动,一边从相机和深度传感器里收集证据。
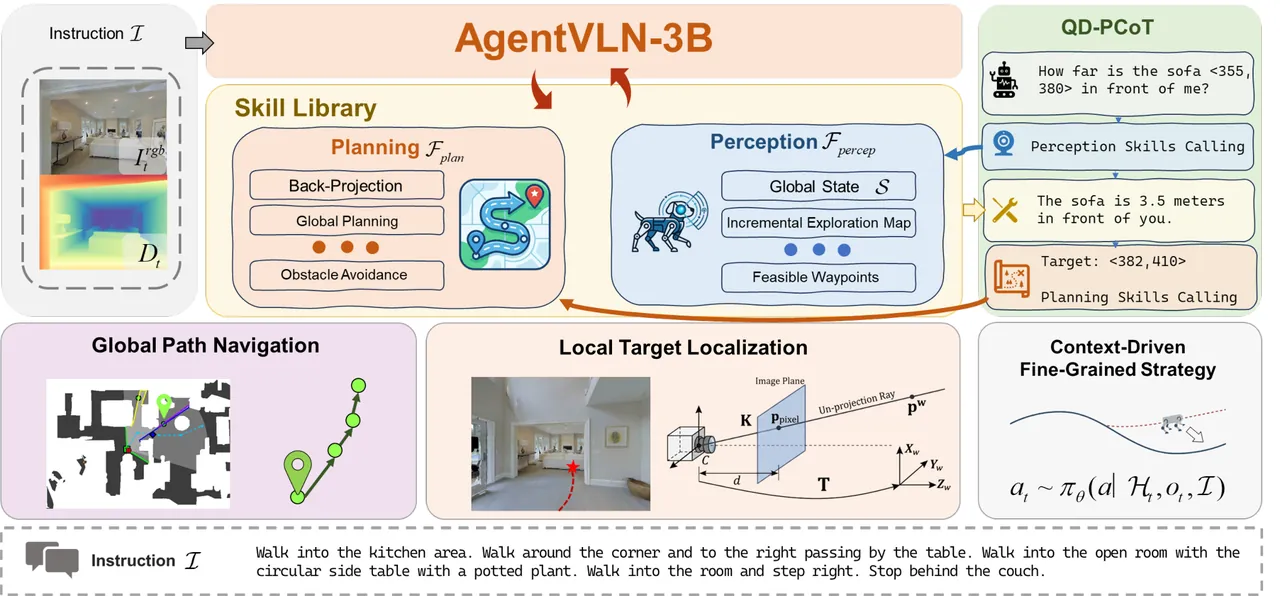
AgentVLN 对这个问题的回答,不是再训练一个更大的视觉语言模型,而是重新安排系统分工。一个 3B 参数的紧凑 VLM 不负责把所有三维几何都压进权重里。它充当高层的“大脑”:读懂指令、观察当前视觉上下文、选择感知或规划技能,再接收技能返回的结果。几何计算留在可替换的技能库中,由视觉 SLAM、建图、路径生成和机器人控制各自完成最擅长的工作。
因此,这篇工作真正值得看的不是“3B 模型又赢了多少参数更大的模型”,而是它提出的一种具身系统接口:小模型若能调用正确的空间工具,是否可以比一个被迫包办感知、推理和控制的端到端模型更容易泛化?长程导航是否能从“每个底层动作都由 VLM 决定”,变成“少量语义决策加多步技能执行”?
01. 为什么端到端导航对 VLM 这么难
视觉语言导航同时包含语言落地、视觉识别、空间推理、时序记忆和运动控制。系统需要记住两三个转弯前经过的门,需要认出当前画面里的沙发就是指令所说的那张沙发,需要判断桌子是“看得见”还是“走得到”,还要在人挡住路线时重新规划。更麻烦的是,基准测试要求机器人在未见过的环境里完成这些任务。
现有方法通常要在两种妥协之间选择。单系统模型直接把图像和语言映射到动作或动作块,结构很简洁,却要求模型从大量轨迹中隐式学会三维结构和物理可达性。到了新房间,一个看起来合理的动作仍然可能在几何上完全错误。双系统模型把语言规划器和轨迹生成器拆开,但又出现新的接口问题:规划器在二维视觉 token 上推理,底层输出的却是三维路点。两者对“左边”“后方”“三米远”的理解未必一致。
单目 RGB 还会制造另一类错误。如果指令是“停在椅子前面”,VLM 可以在像素上找到椅子,却未必知道椅子有多远。目标被部分遮挡时,错误像素反投影到三维空间,路点可能偏离数米。增加深度估计模块有帮助,但会带来延迟、显存占用和更长的上下文。对需要本地推理的机器人来说,这些成本不能忽略。
AgentVLN 的办法,是让 VLM 继续负责语义和任务组合,同时把空间证据显式摆到它面前。模型看到的不是一张需要自行脑补三维地图的原始 RGB 图,而是已经把候选路线点画在上面的图像。路线清楚时,它选择路点;路线被遮挡时,它要求做一个小范围纠正动作;目标可见但尺度模糊时,它先向感知技能提问,再预测目标像素。
02. VLM 是大脑,技能库是可插拔的手脚
AgentVLN 使用 Qwen2.5-VL-3B 作为控制器。VLM 接收自然语言指令、当前第一人称观测以及一段多模态历史上下文。它输出的不是连续速度指令,而是一个结构化技能调用。在第 $t_k$ 个决策时刻,策略通过下式选择技能:
$$ c_k \sim \pi_{\theta}(f\mid\mathcal{H}_{t_k},o_{t_k},\mathcal{I}), \qquad f\in\mathcal{F}. $$
其中 $\mathcal{H}_{t_k}$ 是历史上下文,$o_{t_k}$ 是当前观测,$\mathcal{I}$ 是指令,$\mathcal{F}$ 是可用技能集合,$c_k$ 是采样得到的技能调用。这个公式背后有一个重要的工程选择:VLM 不必输出完整底层轨迹。它只需要判断下一步应该做什么类型的操作,并把相应的语义目标或上下文交给技能。
技能库被分成感知级和规划级两类。感知技能负责回答状态、地图结构、目标可见性、深度和可行路点等问题;规划技能接收选定的路点或目标,执行一段闭环运动。论文用部分可观测半马尔可夫决策过程,也就是 POSMDP,来描述这一过程。一个规划技能可以连续运行多个底层控制步,再把控制权交还给 VLM。选择技能后的多步状态转移为:
$$ \begin{aligned} P(s_{t_k+\tau},\tau\mid s_{t_k},f_{c_k}) ={}&\sum_{a_1\ldots a_\tau} \left[ \prod_{i=0}^{\tau-1} P(s_{t_k+i+1}\mid s_{t_k+i},a_{t_k+i}) \pi_{f_{c_k}}(a_{t_k+i}) \right]\\ &\cdot \beta_{f_{c_k}}(s_{t_k+\tau}). \end{aligned} $$
这里的 $\pi_{f_{c_k}}$ 是所选技能对应的局部控制器,$\beta$ 是技能终止条件。技能尚未结束时,机器人持续执行局部控制;当 $\beta$ 被触发,VLM 获得新的观测并进入下一轮决策。半马尔可夫结构让它不必以控制器频率反复调用语言模型:一次导航技能可以覆盖多帧图像和多个底层动作。
03. 跨空间映射:把三维路线画到二维图像上
AgentVLN 最关键的接口是跨空间表示映射。感知层维护全局地图,并给出若干可行三维路点。如果只把这些点以世界坐标文本的形式交给 VLM,模型就必须自己在脑中完成世界坐标、相机姿态和图像之间的换算。AgentVLN 反过来把三维路点投影到当前图像平面,生成像素对齐的视觉提示。于是,VLM 可以直接在它本来就能识别门、家具和标志的图像空间里做选择。
首先,带深度 $d$ 的像素 $\mathbf{p}_{img}$ 通过相机内参 $K$、旋转矩阵 $R_t$ 和平移向量 $\mathbf{t}_t$ 反投影到世界坐标系:
$$ \mathbf{P}^{w} =R_t\left(d\cdot K^{-1}\mathbf{p}_{img}\right) +\mathbf{t}_t. $$
机器人移动时,这些点会增量写入占据地图。规划层随后生成候选三维路点 $\mathbf{P}_{path}^{w}$。要把某个候选点显示在当前视角里,需要做逆变换并透视投影:
$$ s\cdot\mathbf{p}_{path}^{img} =K R_t^{-1}\left(\mathbf{P}_{path}^{w}-\mathbf{t}_t\right). $$
标量 $s$ 是该点在相机坐标系里的深度缩放因子。投影完成后,候选路线会变成覆盖在 RGB 画面上的点或标记。VLM 只需选择最符合指令的那个标记。被选中的像素再映射回对应三维路点,由规划技能执行运动。换句话说,AgentVLN 把“下一个安全位置的世界坐标是多少”换成了更适合 VLM 的问题:“眼前这些可见路线中,哪一条最符合人对我的要求?”
flowchart TD
  A["指令 + RGB-D 观测 + 8 帧历史"] --> B["Qwen2.5-VL-3B 大脑"]
  B --> C{"调用技能"}
  C -->|感知| D["RTAB-Map / 占据地图 / 可行路点"]
  D --> E["把三维路点投影到当前图像"]
  E --> F["VLM 选择视觉上可选的路点"]
  F --> G["规划技能执行多步运动"]
  C -->|看不到可行路径| H["上下文纠正:前进 / 左转 / 右转"]
  H --> B
  G --> I{"目标已经明显可见?"}
  I -->|否| A
  I -->|是| J["QD-PCoT 主动询问缺失的深度或几何证据"]
  J --> K["预测目标像素,反投影并完成停靠"]
  K --> B
这个接口也让技能库真正可替换。如果部署现场把双目深度换成 LiDAR,只需要修改感知侧技能,VLM 仍然承担相同的高层角色。机器人增加了一种新传感器,并不意味着必须重新训练模型的全部语言和视觉语义。
04. 路线消失时,先做一个小动作
长程导航经常败在误差累积。机器人可能错过门口半米,可能多转了几度,也可能让目标被家具遮住。此时全局地图也许仍然正确,但当前相机画面里没有任何可用路线投影。AgentVLN 因此加入上下文驱动的细粒度纠正策略。
当全局可行路点暂时无法在视觉上使用时,VLM 可以退出高层规划,输出一个短小的原子动作:
$$ a_t\sim\pi_{\theta}(a\mid\mathcal{H}_t,o_t,\mathcal{I}), \qquad a\in\{\mathrm{Forward},\mathrm{Left},\mathrm{Right}\}. $$
这些动作不是盲目的长距离移动,而是局部探测:向拐角多看一眼、稍微靠近路口,或者转离遮挡物。一旦感知层重新产生有效路径投影,系统就回到路点选择和半马尔可夫技能执行。这个机制避免了两种极端:既不让规划器继续使用已经过时的地图,也不因为一次遮挡就放弃整段长程计划。
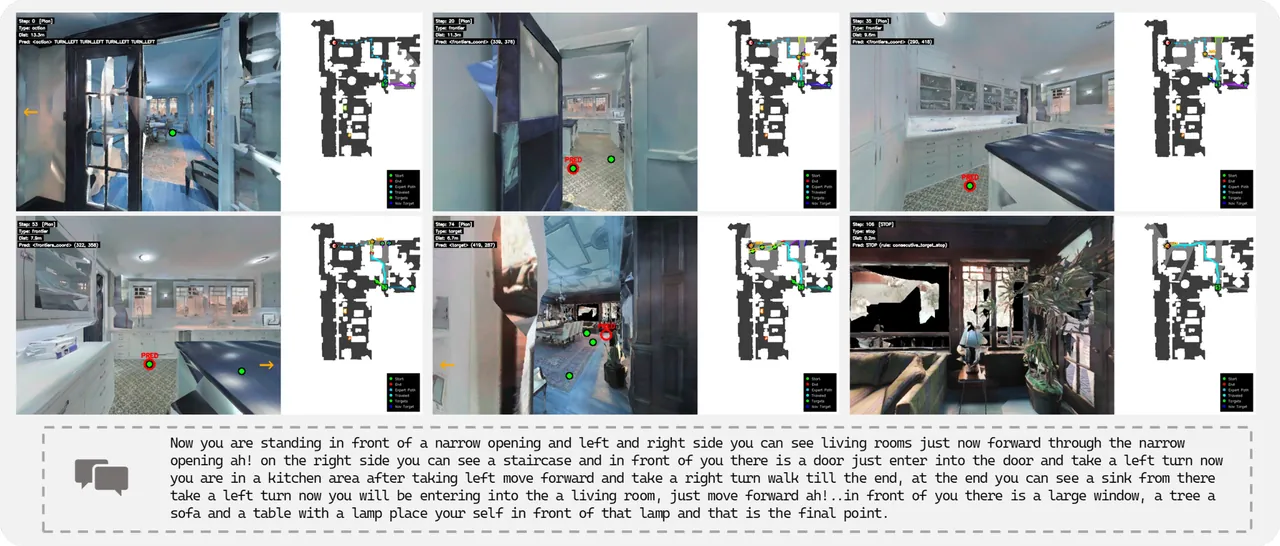
下面的 Habitat 可视化能看出这种切换。绿色点表示感知技能生成的可行路线投影,红色圆圈表示模型选中或预测的导航目标。在狭窄通道或严重遮挡的画面里,高层路点可能暂时消失,机器人于是输出细粒度转向或前进动作,直到路线重新可见。
05. QD-PCoT:先问清深度,再猜目标
全局导航解决“到正确的区域”,局部目标定位解决的是另一个问题:目标已经出现在视野里,机器人需要准确认出它并估计其米制位置。单目 VLM 很容易把“看起来大”误判成“离得近”。一把椅子占满半张图,可能是它离机器人很近,也可能只是它尺寸很大。指令里再出现“沙发前面的椅子”或“站到离桌子两米的位置”,歧义会更严重。
AgentVLN 提出的 Query-Driven Perceptual Chain-of-Thought,也就是 QD-PCoT,让模型把这种不确定性显式说出来。如果目标存在空间歧义,VLM 可以生成一个中间自然语言问题,例如“我前面的沙发有多远?”感知技能返回深度或几何上下文,答案再进入推理上下文。完成这一步后,模型才预测目标像素。
假设目标像素为 $\mathbf{p}_{target}^{img}=[u_{target},v_{target},1]^{T}$,深度图返回 $d_{target}$。该点通过下式反投影到相机坐标系:
$$ \mathbf{P}_{target}^{c} =d_{target}K^{-1}\mathbf{p}_{target}^{img} =\begin{bmatrix} \dfrac{(u_{target}-c_x)d_{target}}{f_x}\\[4pt] \dfrac{(v_{target}-c_y)d_{target}}{f_y}\\[4pt] d_{target} \end{bmatrix}. $$
其中 $f_x$、$f_y$ 是焦距,$(c_x,c_y)$ 是主点。最后再把目标从相机坐标系变换到世界坐标系:
$$ \mathbf{P}_{target}^{w} =R_t\mathbf{P}_{target}^{c} +\mathbf{t}_t. $$
最后一公里规划器现在拿到的是 $\mathbf{P}_{target}^{w}$,而不是把二维框中心直接当成物理目的地。QD-PCoT 不需要新增模型参数。它多出来的是对现有感知技能的一次调用和额外一轮文本推理。论文认为,在非结构化房间里,这比直接从 RGB 回归坐标更可靠,因为深度和遮挡会改变一句空间指令的真实含义。
06. AgentVLN-Instruct 与训练配置
论文还构建了基于 Habitat 的 AgentVLN-Instruct 指令微调数据集。它不是围绕单一端到端动作策略组织数据,而是围绕技能接口设计样本。训练内容覆盖四种能力:根据目标可见性在粗粒度导航和细粒度定位之间路由;调用可泛化的感知与规划技能;推理目标像素坐标;在空间证据不足时主动提问。数据中还会注入轨迹噪声,并在视觉路点不可用时加入原子动作回退样本。
模型从 Qwen2.5-VL-3B 开始训练。指令微调期间,视觉编码器和多模态投影层被冻结。这样既保留预训练视觉表示,又把可训练重点放在语言侧的技能选择与推理行为上。训练数据还加入 LLaVA-Video-178K,以缓解通用多模态能力的退化。
| 训练或输入配置 | 数值 | 意味着什么 |
|---|---|---|
| 基础 VLM | Qwen2.5-VL-3B | 参数规模适合边缘设备本地推理 |
| 冻结模块 | 视觉编码器和多模态投影层 | 保留视觉预训练能力,把微调集中在控制器行为上 |
| 优化器 | AdamW,批大小 128 | 大 batch 指令微调 |
| 学习率 | 余弦退火,峰值 $2\times10^{-5}$,warmup 0.03 | 让预训练模型渐进适应导航任务 |
| 观测 | 640x480 RGB,110 度视场角 | 较宽的第一人称视野用于识别路线地标 |
| 时序上下文 | 8 帧 | 保留路线记忆,同时避免注意力被过旧画面稀释 |
| 训练集群 | 32 张 NVIDIA A100 | 论文报告所用指令微调规模 |
8 帧历史并不是随手设的默认值。消融实验发现,历史太短会让模型只顾眼前,历史太长则会把大量过时视觉特征塞进注意力,反而干扰当前决策。8 帧时,R2R 验证集成功率达到 67.2%,SPL 达到 64.7%;如果没有有效时序历史,成功率只有 56.7%。
07. 基准结果:更小的控制器,更强的空间接口
主要实验在 Habitat 的 R2R-CE 与 RxR-CE Val-Unseen 划分上进行。评价指标沿用导航领域的常见定义:导航误差 NE 越低越好;Oracle 成功率 OS、成功率 SR、按路径长度加权的成功率 SPL,以及归一化动态时间规整 nDTW 越高越好。SPL 会惩罚不必要绕路,因此系统不能只靠到处游走提高成功率。
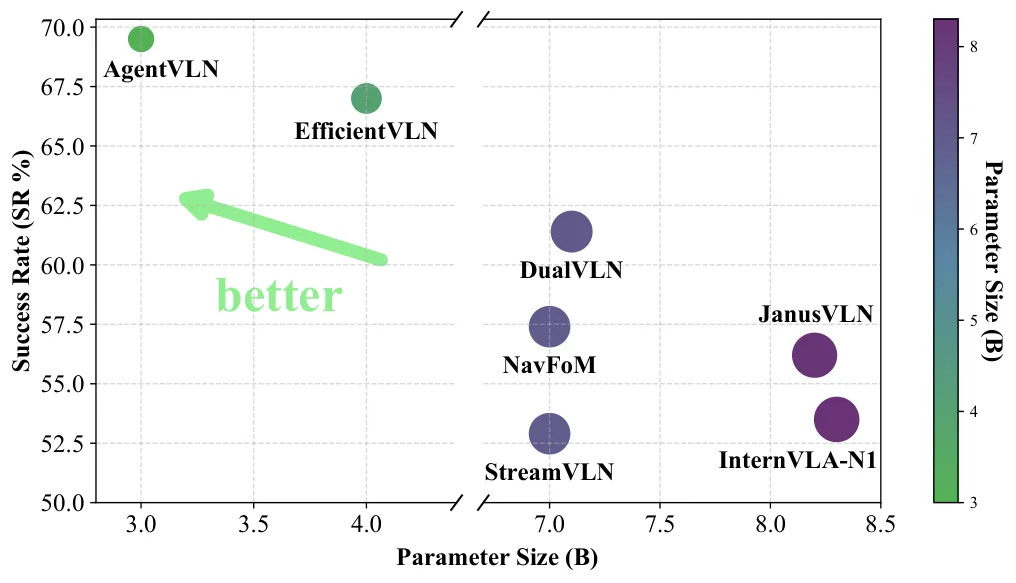
在 R2R-CE 上,AgentVLN-3B 报告 3.88 的 NE、73.5% OS、67.2% SR 和 64.7% SPL。下表保留论文中的代表性对比,可以清楚看到它为何受到关注:一个 3B 系统在成功率和路径效率上都超过表中更大的模型。
| 方法 | 参数量 | NE ↓ | OS ↑ | SR ↑ | SPL ↑ |
|---|---|---|---|---|---|
| EfficientVLN | 4B | 4.18 | 73.7 | 64.2 | 55.9 |
| DualVLN | 7.1B | 4.05 | 70.7 | 64.3 | 58.5 |
| InternVLA-N1 | 8.3B | 4.83 | 63.3 | 58.2 | 54.0 |
| AgentVLN | 3B | 3.88 | 73.5 | 67.2 | 64.7 |
RxR-CE 的指令更长、变化更多,趋势基本一致。AgentVLN-3B 报告 3.92 的 NE、69.5% SR、61.3% SPL 和 74.6 nDTW。与 EfficientVLN-4B 相比,SR 提高 2.5 个百分点,SPL 提高 7.0 个百分点;后者尤其重要,因为它说明成功轨迹整体更直接,而不是靠多走路碰到终点。
| 方法 | 参数量 | NE ↓ | SR ↑ | SPL ↑ | nDTW ↑ |
|---|---|---|---|---|---|
| EfficientVLN | 4B | 3.88 | 67.0 | 54.3 | 68.4 |
| DualVLN | 7.1B | 4.58 | 61.4 | 51.8 | 70.0 |
| InternVLA-N1 | 8.3B | 5.91 | 53.5 | 46.1 | 65.3 |
| AgentVLN | 3B | 3.92 | 69.5 | 61.3 | 74.6 |
这些数字应当理解为特定基准与实现下的证据,而不是对所有导航系统的永久排名。结果会受到仿真环境、观测配置、训练数据和执行栈影响。更有价值的结论更窄:在论文采用的评测协议下,显式空间接口让一个小 VLM 取得了比表中端到端基线更好的精度-效率平衡。
08. 消融:真正带来提升的是哪一部分
逐项消融最清楚地解释了这套架构为什么有效。基线是一个没有显式几何引导的端到端小 VLM。加入 VLM-as-Brain 和跨空间映射后,SR 从 38.6% 上升到 59.7%,NE 从 6.53 米下降到 4.67 米。这个变化很大,也直接支持论文的中心假设:如果模型可以在可见可行路点集合上做语义匹配,它就不必从原始像素中隐式学会完整的物理可达性。
继续加入上下文驱动的细粒度纠正策略,SR 升到 65.6%,NE 降到 3.90 米。提升来自在遮挡和漂移演变成不可逆错误之前及时处理它们。最后加入 QD-PCoT,SR 达到 67.2%,SPL 达到 64.7%。最后一步增益较小,但针对的正是最后一公里:机器人可能已经到达正确房间,却无法准确停到目标物前。
| VLM-as-Brain | 细粒度纠正 | QD-PCoT | NE ↓ | OS ↑ | SR ↑ | SPL ↑ |
|---|---|---|---|---|---|---|
| 无 | 无 | 无 | 6.53 | 48.50 | 38.60 | 35.10 |
| 有 | 无 | 无 | 4.67 | 65.10 | 59.70 | 55.60 |
| 有 | 有 | 无 | 3.90 | 72.10 | 65.60 | 63.40 |
| 有 | 有 | 有 | 3.88 | 73.50 | 67.20 | 64.70 |
09. 从 Habitat 走到 Unitree Go2
实机原型使用 Unitree Go2 四足机器人,搭载 Intel RealSense D455 相机。RTAB-Map 负责实时局部 SLAM,并增量更新三维占据栅格。相机处理模块把 VLM 选中的像素或路点转换到机器人全局坐标系,路径生成和控制技能再把结果变成平滑、避障的轨迹。系统并不为每个控制周期把画面传到远程数据中心;它面向 Jetson 一类边缘平台进行本地推理。
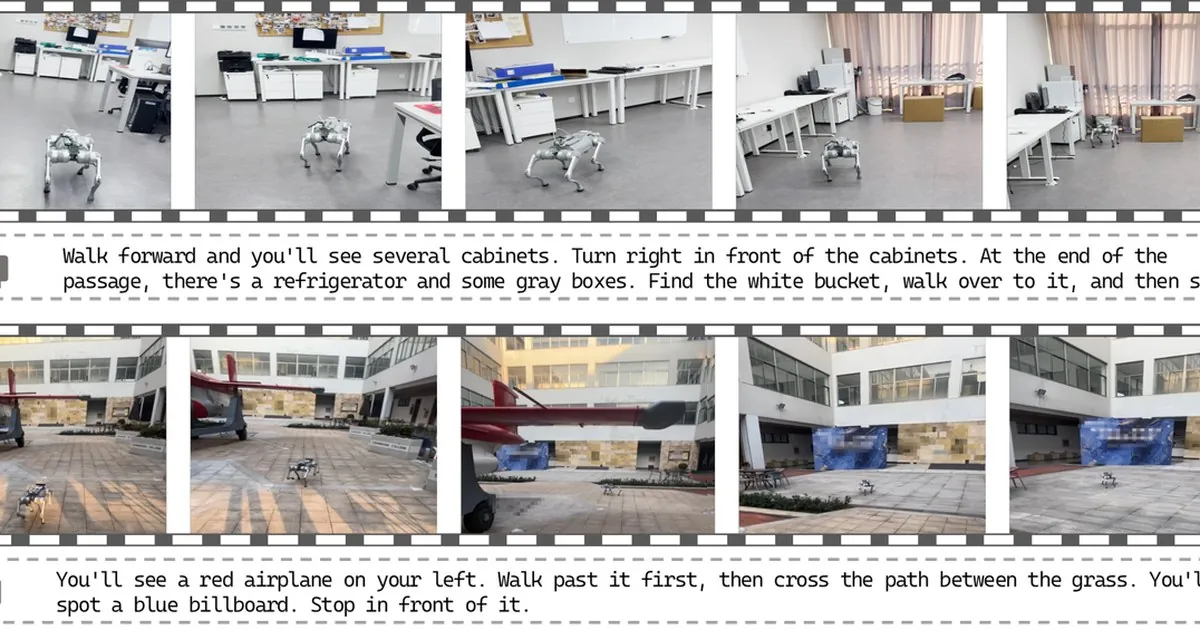
论文展示了室内和室外路线。在办公室序列里,Go2 按照包含多个地标的指令穿过柜子,在通道尽头右转,寻找冰箱和灰色箱子附近的白桶。在室外序列里,它经过红色飞机旁,穿过两块草地之间的道路,最后停在蓝色广告牌前。这些演示有意义,是因为指令同时包含路线结构和视觉约束。
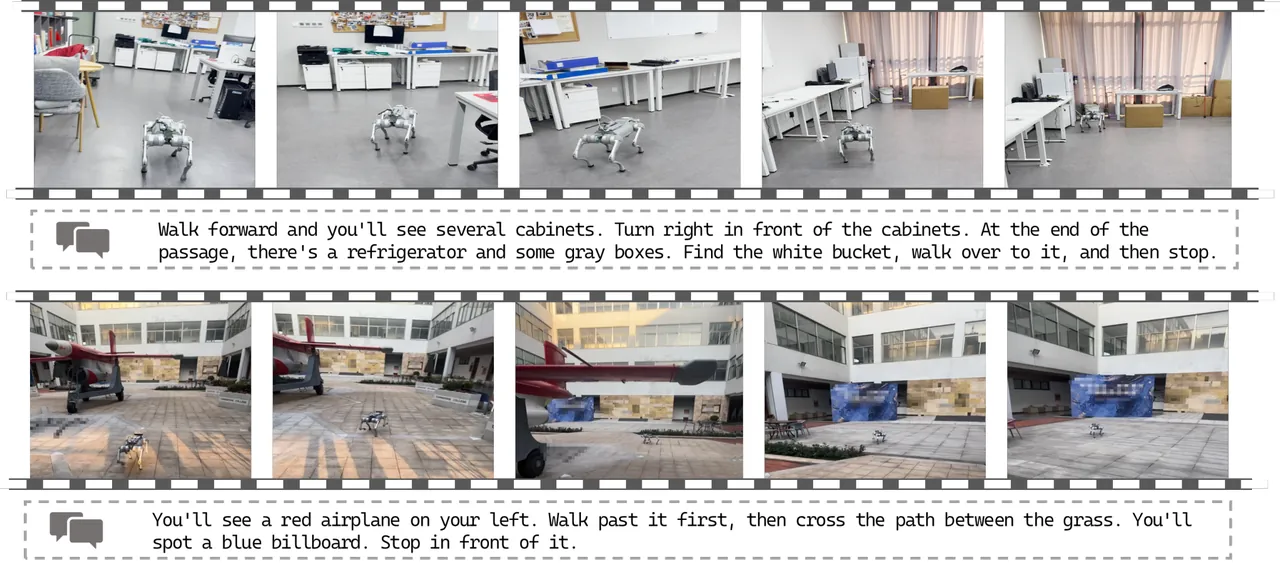
项目 README 还展示了 Unitree G1 人形机器人和 Go2 的真实演示。代码发布包含训练和推理组件、部署使用的第三方技能库、相机安装文档以及数据集生成工具。相比只有论文的发布,这已经是更完整的工程材料,但还不是开箱即用的整套环境。
10. 这套架构得到了什么,还缺什么
优势一:显式几何留在语言模型之外。 VLM 在几何感知工具生成的视觉提示中选择路线。这减少了语言模型必须隐式学习的三维推理,也让界面更容易审查:工程师可以检查地图、投影路点和最终技能调用。
优势二:技能库可以变化,而不必重训大脑。 更换机器人、深度传感器、局部规划器或控制器,都可以在技能层完成。论文提到,适配 LiDAR 只需替换相关感知技能,不需要重新训练数十亿参数的基础模型。
优势三:自我纠正局限在局部。 第一个路点消失时,机器人不会立刻抛弃整段长程计划。它先做一个小范围探索动作,刷新观测,等全局路径重新可见后再恢复执行。这是反应式控制与深思熟虑规划之间比较务实的折中。
仍未解决的问题一:发布物还不是完整复现包。 仓库 TODO 中,预训练模型检查点以及安装、环境配置说明仍未勾选。数据集、训练代码、推理代码、部署技能和演示视频已经公开,但新团队还不能直接假定可以下载完全一致的模型并端到端运行。
仍未解决的问题二:仿真表现不等于真实世界可靠性。 R2R-CE 和 RxR-CE 是有价值的受控基准,却不能覆盖真实建筑里的所有光照、动态障碍、传感器故障和社会交互。论文中的实机证据是一组演示,不是拥有置信区间的大规模随机现场研究。
仍未解决的问题三:主动感知会增加延迟。 QD-PCoT 不增加参数,但一次感知调用仍然要花时间。提问、取回深度、更新上下文、重新生成目标坐标都会拉长决策周期。部署系统需要决定歧义多大时才值得多问一轮。论文的边缘部署优势说的是基础模型和本地执行,并不是保证每条 QD-PCoT 轨迹都满足固定控制时限。
仍未解决的问题四:模块化系统也会继承模块化故障。 如果 RTAB-Map 发生漂移,如果反光表面让深度缺失,如果没有投影出可行路点,VLM 收到的就是退化证据。纠正策略能处理部分遮挡,却无法凭空制造传感器没有采集到的信息。
11. 为什么这不只是一次榜单胜利
AgentVLN 给出了具身 AI 的一种实用模式:基础模型负责语义理解和协调,物理世界通过显式、可检查的操作暴露给模型。语言、物体身份和任务意图仍在 VLM 中汇合;几何、建图和控制则留在可以独立测试、替换的工具里。
对于不能依赖远程服务器的机器人,这种模式尤其重要。3B 模型仍是可观的计算负载,但它给本地执行留下的空间,比“更大的模型再加一个独立三维编码器”更多。跨空间映射还提供了有用的调试界面:机器人走错时,工程师可以追问,是感知层给出了错误路线,投影位置不准,VLM 选错了提示,还是规划器没有正确执行。
因此,最值得关注的结论不是“3B 模型拿了第一名”,而是当环境通过一组定义清楚的技能呈现出来时,VLM 可以更像一个真正的智能体。它不需要在隐状态里幻想出一个完美的三维世界。它需要知道什么时候该看,该问什么,哪条可见路线符合指令,以及证据何时已经足够支持下一步移动。
真正有用的抽象不是“让 VLM 包办一切”,而是“让 VLM 决定下一步做什么,同时给它一种可靠方式,向物理世界索取缺失的证据”。
来源与延伸阅读
原始论文:AgentVLN: Towards Agentic Vision-and-Language Navigation,作者为 Zihao Xin、Wentong Li、Yixuan Jiang、Ziyuan Huang、Bin Wang、Piji Li、Jianke Zhu、Jie Qin、Sheng-Jun Huang。arXiv:2603.17670,已被 ECCV 2026 接收。
代码:Allenxinn/AgentVLN。项目页:allenxinn.github.io/AgentVLN。数据集:AgentVLN-Instruct on Hugging Face。
本文由 RobotWorld 根据论文与公开项目材料独立改编。文中图片来自 AgentVLN 论文,基准数字与训练细节来自论文及公开项目页面。
原文来源:arXiv / AgentVLN authorshttps://arxiv.org/abs/2603.17670