
JEPA 世界模型的 600 次实验:不改权重,把长时间规划成功率提升到 85%
基于 600 次 Push-T 实验,拆解 JEPA 世界模型如何通过 25 步子目标、带跳转成本的潜空间记忆图、对称性增强与多目标评分,在不重新训练的情况下把长时程规划成功率提升到 85%。
在人工智能领域,关于“世界模型应该是什么”一直存在一场严肃争论。生成式世界模型通过生成未来来预测未来,通常生成的是像素。Yann LeCun 和许多其他研究者认为,这种做法把过多精力花在了对行动无关紧要的细节上。大多数像素对决策并不重要,其中很多像素甚至根本无法被可靠预测。
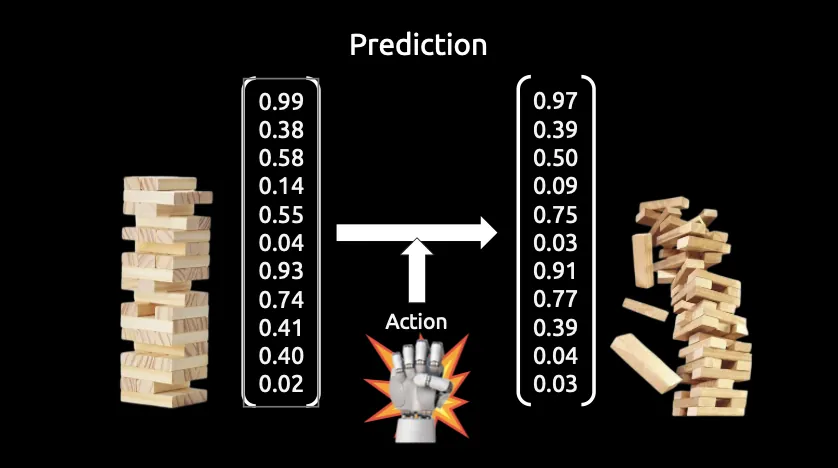
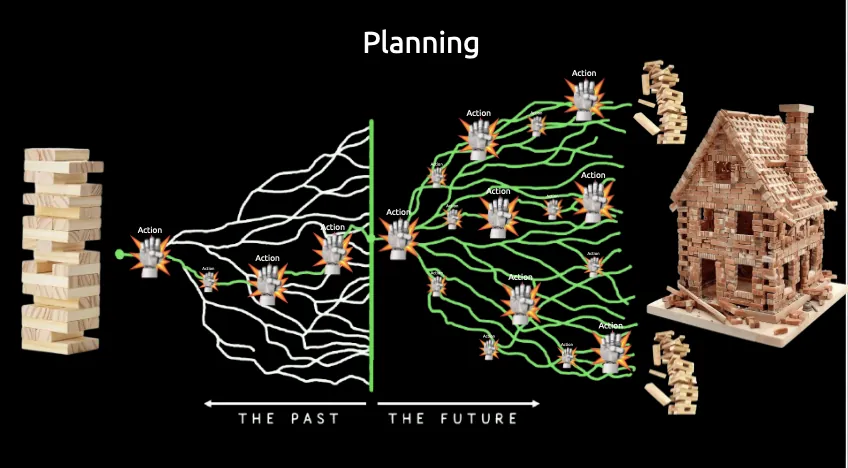
替代方案是 JEPA,即联合嵌入预测架构(Joint-Embedding Predictive Architecture)。JEPA 世界模型由三部分组成:编码器、预测器和规划器。编码器把每次观测转换为紧凑的学习嵌入;预测器接收当前嵌入和一个动作,再预测下一状态的嵌入;规划器则通过预测器采样大量动作序列,并选择预测终点最接近目标的序列。由于这个循环在表示空间中运行,模型可以忽略对控制无用的视觉细节。
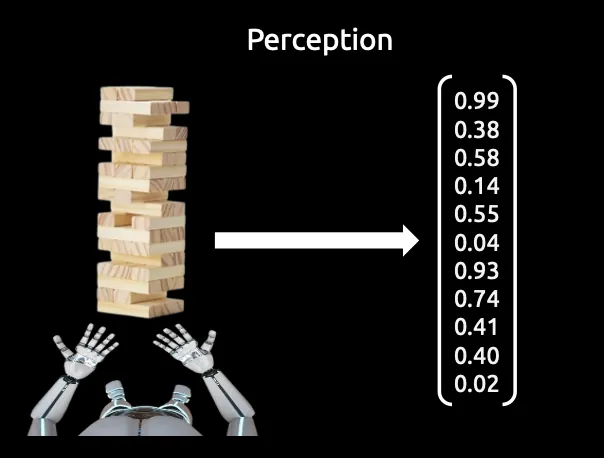
同一套表示既用于预测可能的下一状态,也用于在这些状态之间进行规划。下图把三种操作分开画了出来,但在部署系统中它们构成一个连续循环:观察、在潜空间预测、为候选计划评分、执行动作,然后再次观察。
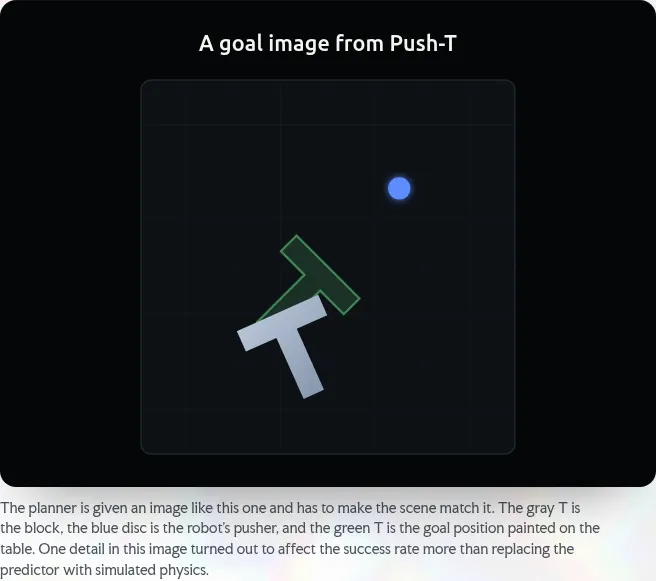
今年,一个包括 LeCun 在内的研究团队发布了 LeWM,这是一个主要在 Push-T 任务上评估的 JEPA 世界模型。Push-T 是一个模拟操作任务:机器人必须推动一个灰色 T 形积木穿过桌面,直到 T 形积木到达目标图像中绿色目标位姿。Haddy Alchaer 在 LeWM 上进行了 600 次实验,想回答一个非常实际的问题:当一个小型 JEPA 已经学会有用的动力学之后,下一步的提升究竟来自哪里?
预测已经足够好,规划才是瓶颈
第一组实验把预测器单独隔离出来。在 250 个目标距离为 75 步的长时程任务中,两个版本都获得相同的专家子目标:每 25 步取一帧专家演示。使用学习预测器的 LeWM 成功率为 78%;把预测器替换成模拟器精确物理的版本成功率为 77%。对于训练数据中出现过的那类轨迹,LeWM 作为规划模型已经和完美物理一样有用。
这个结果改变了寻找改进方向的方式。如果预测器并不是眼前的瓶颈,那么更好的控制可以来自改变训练完成的架构被使用的方式。四项规划层面的改动显著提升了表现,却没有进行任何一步梯度更新。
| 规划条件 | 目标距离 | 成功率 |
|---|---|---|
| LeWM,一次规划完整 75 步 | 75 步 | 22% |
| 精确物理,一次规划完整 75 步 | 75 步 | 42% |
| LeWM,每 25 步提供一个专家子目标 | 75 步,分段衔接 | 80% |
| LeWM,直接处理 25 步任务 | 25 步 | 89.7% |
| 精确物理,直接处理 25 步任务 | 25 步 | 90.5% |
1. 把子目标按约 25 步串联起来
完全按照论文发布时的用法,LeWM 在目标距离为 75 步的任务上只能达到 22% 的成功率;当目标距离缩短到 25 步时,成功率提高到 89.7%,与精确物理规划器的 90.5% 相差不到一个百分点。模型在较短距离上足够准确,一到较长距离就开始退化。
常见解释是预测误差累积:小错误不断叠加,因此模型必须更加准确。但受控比较指向另一种补救方式。在同一批 75 步任务上,精确物理把成功率从 22% 提高到 42%,提升 20 个百分点;给不改动的 LeWM 每 25 步提供一个新的专家子目标,则把成功率提高到 80%,提升 58 个百分点。
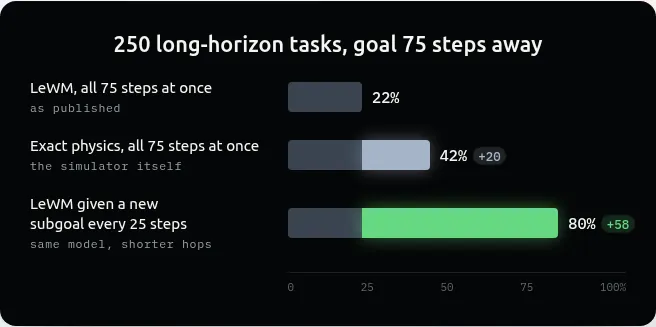
这是一种非常具体的形式化分层规划。高层过程选择一个附近的子目标,LeWM 执行它本来就很擅长的短时程搜索。实验确立了一个约 25 步的有效规划范围,也说明更长的任务应当在这个范围内通过串联搜索来完成。
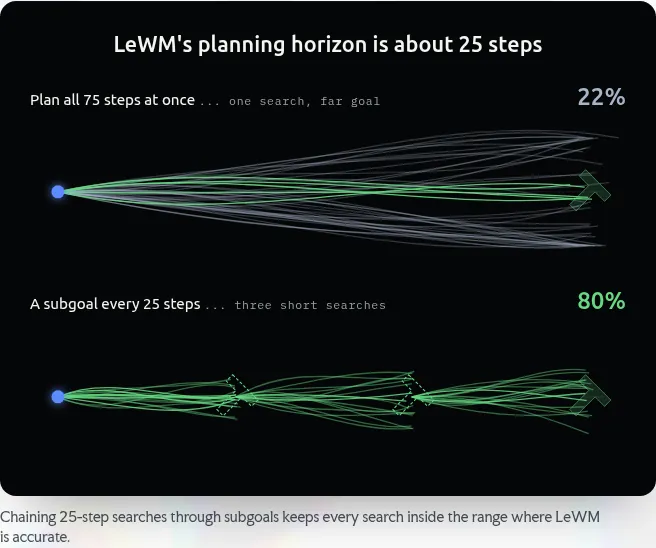
增加搜索次数并不能替代更好的任务分解。把同一个规划器运行四次并保留成本最低的结果,消耗了四倍计算量,却只带来不到一个百分点的提升。四次尝试往往一起成功或一起失败,因为重复采样并没有修复一条 75 步计划本身的结构问题。
专家子目标证明了层次化分解的价值,但部署中的机器人不能假设专家会每 25 步提供一帧。下一种方法就是要移除这个要求。
2. 构建潜空间记忆图,并为每次跳转设置代价
LeWM 是使用专家演示训练的。它的编码器可以嵌入每一帧,得到大约 46 万 个潜状态。Alchaer 把这些状态连接成一张图:每个状态连接到同一段演示中紧随其后的状态,也连接到嵌入空间中来自其他演示的邻近状态。为了求解长时程任务,规划器在这张图中搜索一条从当前状态到目标的路径,并把路径上的状态作为子目标。
这只有在潜空间距离具有物理意义时才成立。事实证明它有。给定一个机器人能在 25 步内到达的状态和一个无法到达的状态,LeWM 的嵌入距离在 87% 的情况下把可到达状态排得更近。因此,这种表示不仅是一份视觉摘要,也近似了一张可达性地图。
第一版图规划器存在结构缺陷。在两段不同演示的邻近状态之间跳跃,与在同一段演示内部沿真实转移动画前进,成本完全相同。搜索利用了这种捷径,产生积木在物理上无法跟随的路径。在一次分析中,1,015 条计划里有 318 条使用了六次或更多跨演示跳转。
为每次跨演示跳转增加代价后,问题被修复了。仅使用 LeWM 对过去演示的嵌入,在同样的 250 个长时程任务上,成功率从 62% 提高到 85%。这已经追平了由专家子目标辅助的规划器,而且测试时不再需要专家替模型选择子目标。
标准 Push-T 测试比看起来更容易
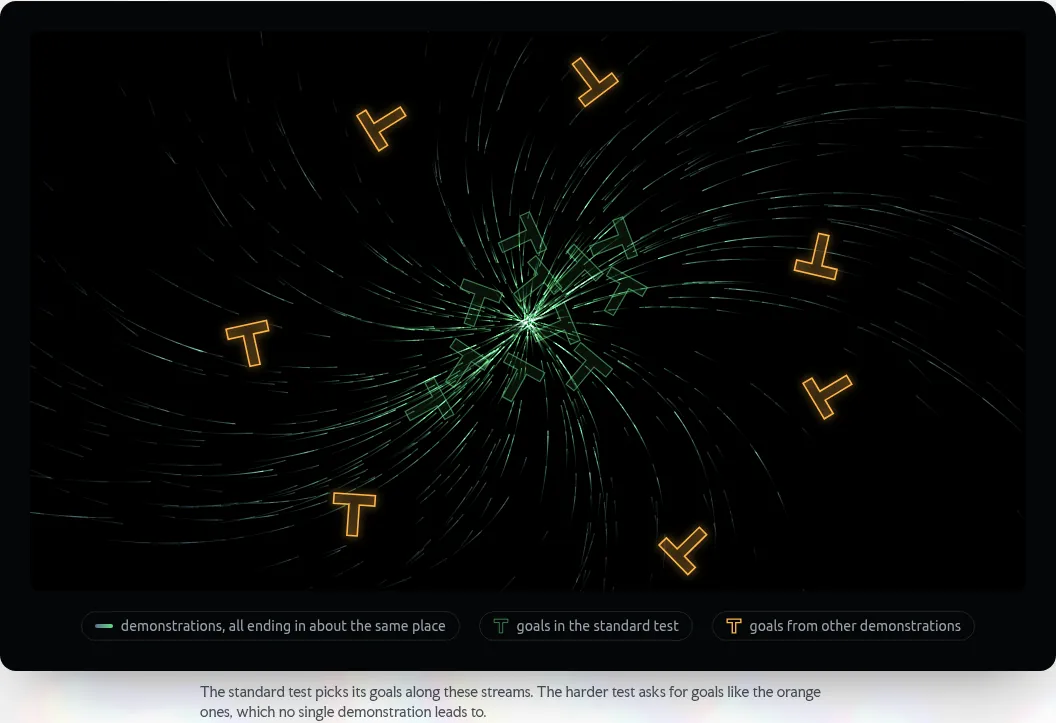
这个基准的协议制造了一种隐蔽优势。它从一段演示的中途开始,并选择同一段演示中固定步数之后的目标。每一段 Push-T 演示又都会让积木最终停在大致相同的位置。因此,标准目标总是位于演示已经走过的路径上,并朝着一个共同终点前进。对于 84% 的标准目标,记忆图中都存在一个来自另一段演示、几乎完全相同的状态。
样本量也很小。在目标距离为 50 步的官方 50 个回合中,LeWM 的成功率是 68%;用同样流程重新抽取 250 个回合后,成功率只有 44%。仅仅改变规划器的随机种子,就让 250 个回合中的 38 个在成功与失败之间翻转。这些结果提醒我们,不应把一个小基准上的分数当成稳定估计。
Alchaer 的更困难测试让每个起点来自一段演示,每个目标来自另一段演示,因此没有任何一段单独演示连接这两个状态。成功还要求积木在最后 10 步持续保持在目标上。记忆图规划器在标准任务上得到 75%,在更困难的划分上只有 45%。后续方法瞄准的正是这段差距。
3. 用变换后的演示填补记忆空缺
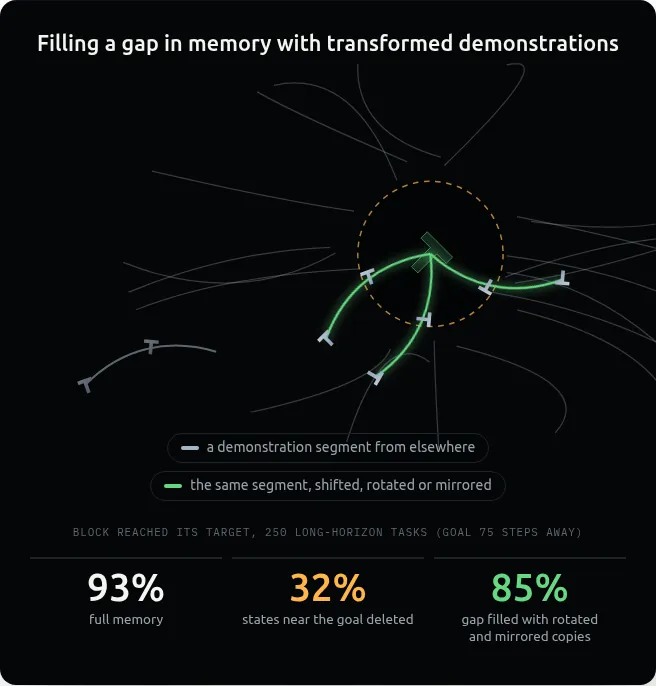
记忆图是否有用,取决于它覆盖了多少状态。当目标附近所有已存储状态都被删除后,成功率从 93% 下降到 32%。通过过去的例子来规划,在有相关例子时非常强大,一旦目标落在数据覆盖之外就会失效。
Push-T 提供了一种有用的对称性。整张桌子平移、旋转或镜像时,推动积木的物理规律并不会发生根本改变。如果图中没有靠近目标的状态,规划器就可以从别处取一段演示,把它变换到缺失区域,再通过变换后的状态进行规划。
加入变换片段后,成功率从 32% 恢复到 85%。这种变换还能让小数据集发挥更大作用:只用 1% 演示加上变换副本构建的图,与使用 10% 演示构建的图表现大致相同。在更困难的跨演示测试上,变换片段把成功率从 45% 提高到 56%。
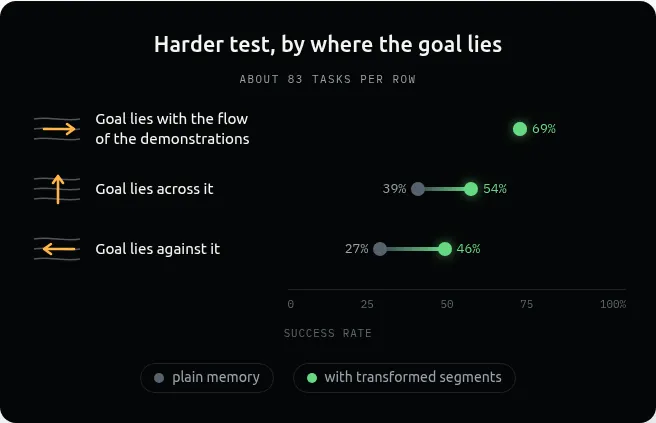
收益大小取决于缺失目标相对于演示流向的方向。当目标顺着演示流向时,普通记忆图已经有 69% 的成功率;当目标横跨演示流向时,普通记忆图的成功率是 39%,变换记忆把它提高到 54%;当目标逆着数据方向时,普通记忆图只有 27%,变换记忆则提高到 46%。
这并不是超越数据的一般推理,而是利用已知对称性制造有用潜状态的有针对性做法。当任务具有保持其动力学的变换时,这种方法应当可以迁移;它并不能解决任意外推。
4. 目标图像一直在给错误的东西评分
最令人意外的失败来自目标的表示方式。在交互式 Push-T 演示中,操作者放置积木并选择一张目标图像。目标图像里必须有推杆,因此推杆被放在期望积木位姿的后方。在一次运行中,机器人把积木移动到了距离目标 14 像素 以内,已经足够接近,可以被判定为完成;随后它却把积木推离目标,只为让推杆朝向目标图像所示的位置。
这不是随机行为。专家的演示帧同时包含积木的目标位姿和推杆在那一刻的顺带位姿。一个把预测场景与整张目标图像比较的模型,会学会同时匹配两个物体。在这个任务中,精确匹配推杆反而让积木目标更难完成。
为了把预测器误差从问题中排除,研究者用精确物理在同样的 50 个更困难任务上运行了两次。唯一的区别是成本函数是否同时包含推杆位置和积木位置。排除推杆后,有 30 个任务从失败变为成功,没有任何任务朝相反方向翻转。这种一边倒的分布如果只是偶然,大约十亿次实验才会出现两次。既然物理本身是真实基准,接近四倍的差异完全来自目标如何评分。
包含推杆的规划器确实完成了被要求的事情。在那 30 个翻转任务中,它把推杆放到了距离目标半个像素以内,却在这个过程中让积木偏离了目标。同时要求最终 T 形位姿和推杆那个顺带位姿都精确匹配,显著提高了约束难度。
LeWM 不能在训练后简单被告知“忽略推杆”。它的距离是在嵌入之间计算的,而目标图像的嵌入把积木和推杆纠缠在一起,没有一个标记为“推杆”的成分可以关闭。一种实际可行的绕过方法是把预测结果与同一目标的多个版本比较:保持积木不动,把推杆移动到已存储演示中出现过的不同位置,然后选择 16 个目标变体中最接近的一个。这个方法在没有重新训练的情况下,把更困难测试上的成功率从 11% 提高到 23%,翻了一倍。
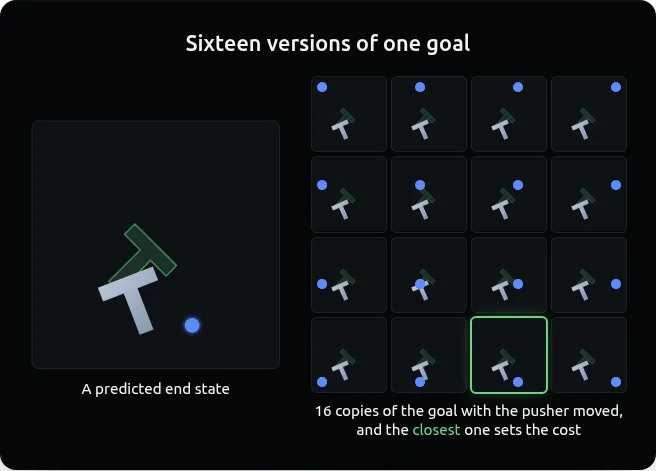
这个原则并不局限于 Push-T。目标应当描述一组成功结束状态,而不是要求逐像素复制某一帧演示。“把杯子放到架子上”在杯子安全放好、机械臂随后停下的任何位置都算完成;单张目标图像却只挑了一个机械臂位置,并要求规划器去匹配它。好的目标接受所有能解决任务的结束状态,同时仍然编码任务真正需要的约束,例如最后必须停稳。
大型演示数据集本身已经提供了这组状态中的很多部分。同一个物体可能多次出现在同一位置,而机器人处在不同位姿。与最接近的兼容目标比较,就能在不修改世界模型的情况下扩大可接受的终点集合。
仍未解决的问题
这四项发现都没有改变 LeWM 的权重。它们分别改变了推理阶段的规划、记忆构建、数据增强和目标评分。结果暗示,采用相同规划方式的大型 JEPA 世界模型,也可能在没有额外训练成本的情况下获得类似收益。
最主要的开放问题是超越完美演示的泛化。在更困难的 Push-T 测试上,最好的规划器能让积木在 56% 的时间里保持在目标上。剩余失败大多来自违背数据方向的目标。缩小这段差距需要一个更高层系统,能够提出演示分布之外的有用子目标。现有的学习型层次结构,例如 H-JEPA,还没有解决这个问题:在 Push-T 上,它们与扁平 LeWM 持平,或只是略微超过。
更广泛的启示是:一个只用数小时训练的小型 JEPA,已经能够在熟悉的轨迹上预测得足够好,与模拟器匹敌。它眼前的瓶颈并不总是表示质量。规划器如何分解时间、如何在记忆中导航、如何利用对称性以及如何定义目标,可能更加重要。LeWM 仍然做不到的,是在没有任何演示走过的地方选择有用子目标。
参考资料
- Y. LeCun,A Path Towards Autonomous Machine Intelligence,OpenReview,2022。
- L. Maes、Q. Le Lidec、D. Scieur、Y. LeCun 和 R. Balestriero,LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels,arXiv:2603.19312,2026。
- C. Chi 等,Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,RSS,2023。
- W. Zhang、B. Terver、M. Rabbat、Y. LeCun 和 R. Balestriero,H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning,arXiv:2610.06805,2026。
原文来源:Haddy Alchaerhttps://haddyalchaer.com/jepa