1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
ADAPT利用扩散动作先验,把语言指令和机器人状态直接映射为全身动作,无需先生成运动规划;机器人可连续响应指令变化并保持平衡与自然动作。
后训练后的Cosmos 3 Edge可在Jetson AGX Thor T5000上端侧运行,约1.53秒生成覆盖约2.13秒机器人运动的动作块,并持续根据新感知重规划。
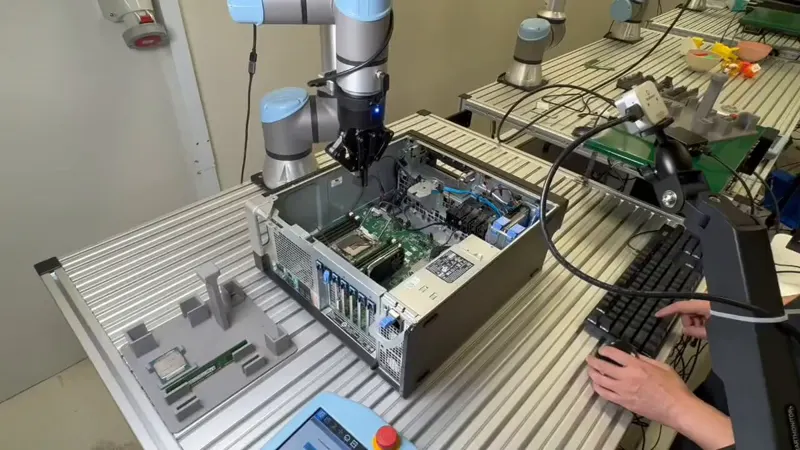
基于约1000小时力同步装配数据训练,五个亚毫米计算机装配任务平均成功率82%,具备0.5mm放置精度与50ms命令延迟。
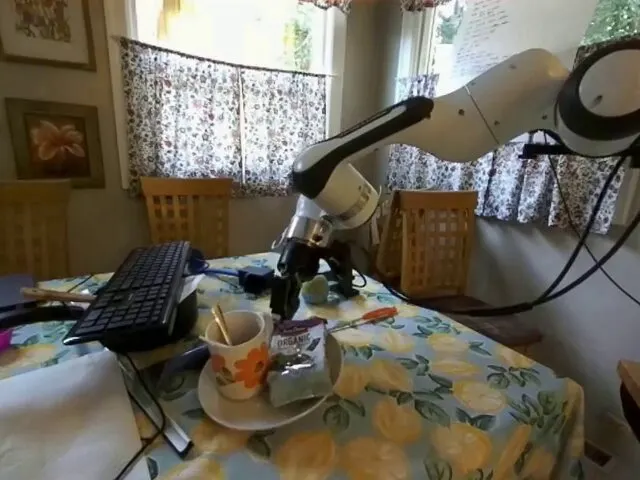
以动作流统一机械臂、夹爪与人手等不同形态,把机器人动作表示为像素运动,支持跨形态世界建模、策略预演与逆向控制。
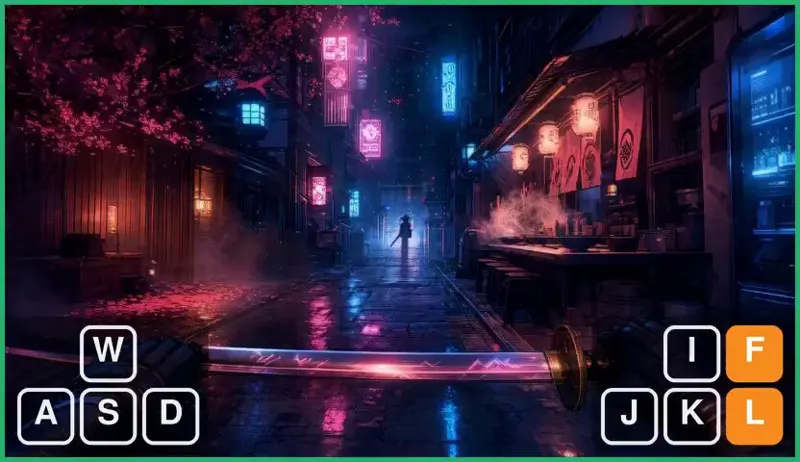
社区开发者基于 Minimax H3 构建了 H3-World,把这个视频模型变成可交互的世界生成器:用户可以在生成的场景里漫游、改变视角,实时驱动世界演化,展示了世界模型从被动生成走向可交互操控的方向。
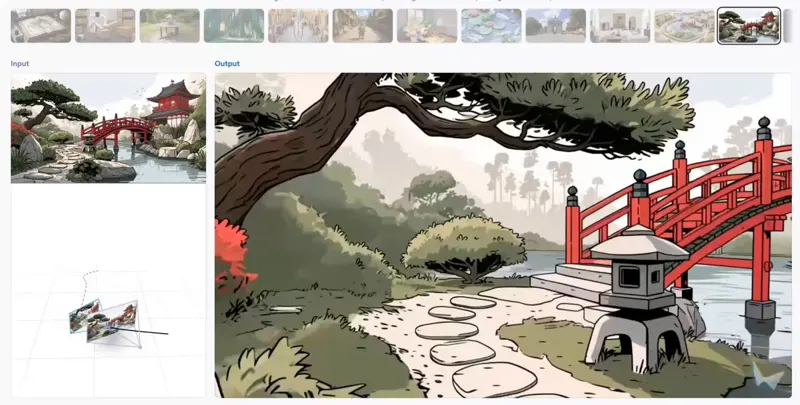
李飞飞的 World Labs 发布新一代世界模型 Atlas。相比上一代,Atlas 能从单张图片生成一个非常完整的 3D 空间场景,用户可以自由地在场景中漫游移动,模型还能理解时间维度的演变规律。这条推文配有演示视频,展示了从一张图到完整可交互 3D 世界的生成效果。
WM-LOCO 将循环世界模型与 PPO 联合训练,仅凭本体感知与单路深度图产出预测性循环特征,在落脚受限地形大幅超越基线,真机成功率 93.3%。
Liu, Yuxi, Han, Lijun, Wang, Ziming
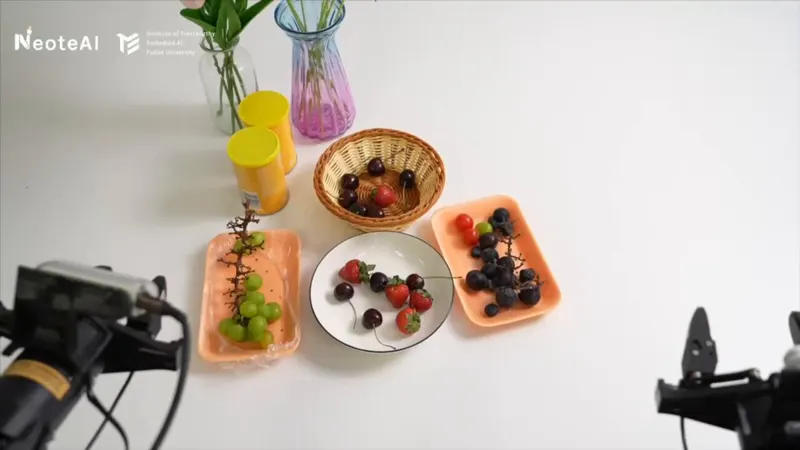
复旦 TEAI 与 NeoteAI 发布 N₀-Foundation:自研视觉触觉传感器+触觉 UMI+超 3 万小时 NeoData 多模态数据,面向可形变物体、精密装配与力控接触的触觉具身操作基础模型。
Atlas是首个多模态世界模型,可生成图像和视频帧并支持像素级相机控制,还能将场景重建为3D,用于空间智能、仿真和机器人模拟视角。
Motus2将策略、模拟器与评估器整合为自进化闭环世界模型,既能预测动作结果,也能评估输出并反馈改进策略,用于灵巧操作。
LightOrigins 开源 LightNav-0:基于 Qwen3-VL 空间智能的通用导航模型,纯仿真训练,零样本驱动人形、四足、轮式、无人机自主导航。
Light Origins 发布 LightNav-0:Real2Sim2Real 数据引擎把 2000+ 互联网真实场景变成可复用仿真世界,产出 4000+ 小时视觉-语言-动作经验,经三阶段后训练在 10 项仿真设置中刷新纪录,并零样本迁移到人形、四足、空中与轮式机器人。