
PAPER DEEP DIVE
英伟达人形机器人基础模型
GR00T N1: NVIDIA 人形机器人基础模型
GR00T N1 是 NVIDIA 发布的人形机器人基础模型,结合视觉-语言理解和动作生成,支持跨平台迁移和人形机器人通用技能学习。
GR00T N1 是 NVIDIA 发布的人形机器人基础模型,结合视觉-语言理解和动作生成,支持跨平台迁移和人形机器人通用技能学习。
PAPER DEEP DIVE
GR00T N1 是 NVIDIA 发布的人形机器人基础模型,结合视觉-语言理解和动作生成,支持跨平台迁移和人形机器人通用技能学习。
GR00T N1 是 NVIDIA 发布的人形机器人基础模型,结合视觉-语言理解和动作生成,支持跨平台迁移和人形机器人通用技能学习。
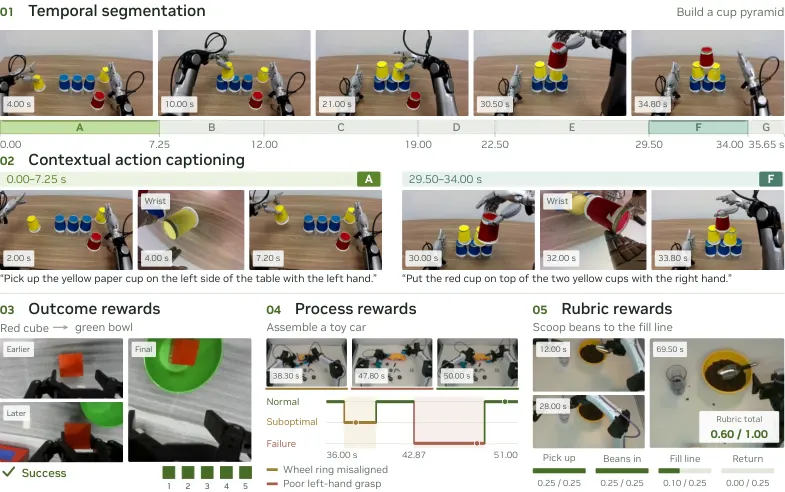
Flora 用分割、字幕和奖励三模型,把机器人视频转成时间戳动作字幕、过程奖励与结果奖励,已用于训练 GR00T。
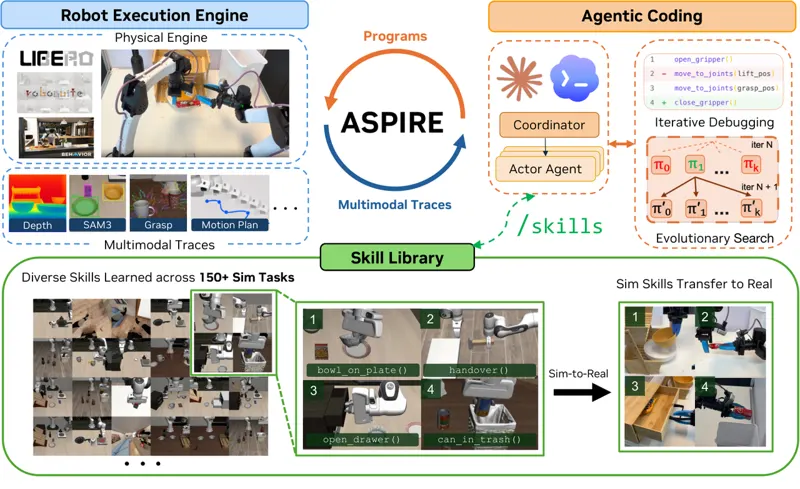
通过多模态执行轨迹诊断机器人程序失败,用进化搜索修复候选程序,并将验证过的修复沉淀为可跨任务、跨平台复用的技能库。
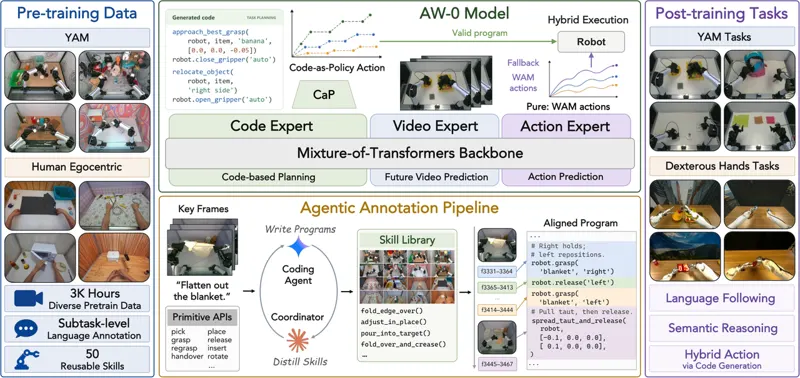
近期的世界动作模型为机器人操作提供了视觉前瞻与未来预测,但缺少显式的组合式技能复用机制。智能体机器人将基于代码的规划与推理同可复用技能相结合,却往往缺少对物理动力学的预测性支撑。我们提出 AW-0,一个将基于代码的规划与联合视频、动作预测相融合的智能体世界动作模型框架。我们在统一的混合 Transformer 架构中,将代码、未来视频与机器人动作作为三条耦合的生成流联合建模。该架构中的代码专家生成参数化技能例程与控制逻辑,视频专家与动作专家则生成未来视觉状态与底层运动指令。代码承担两种互补角色:它在世界模型内部组织多步预测与控制,并把技能表示为可供后续智能体执行复用的程序。我们进一步提出自动化整理流程,为机器人视频与人类视频轨迹标注对齐的程序,并将反复出现的例程整合为可复用技能库。在 RoboTwin 2.0 与真实双臂操作任务上的评估显示,该方法相较视觉-语言-动作模型与世界动作模型基线提升了任务表现,并在语言遵循、语义推理与鲁棒性方面取得增益,表明智能体代码能够在世界动作模型中连接规划、预测与执行。
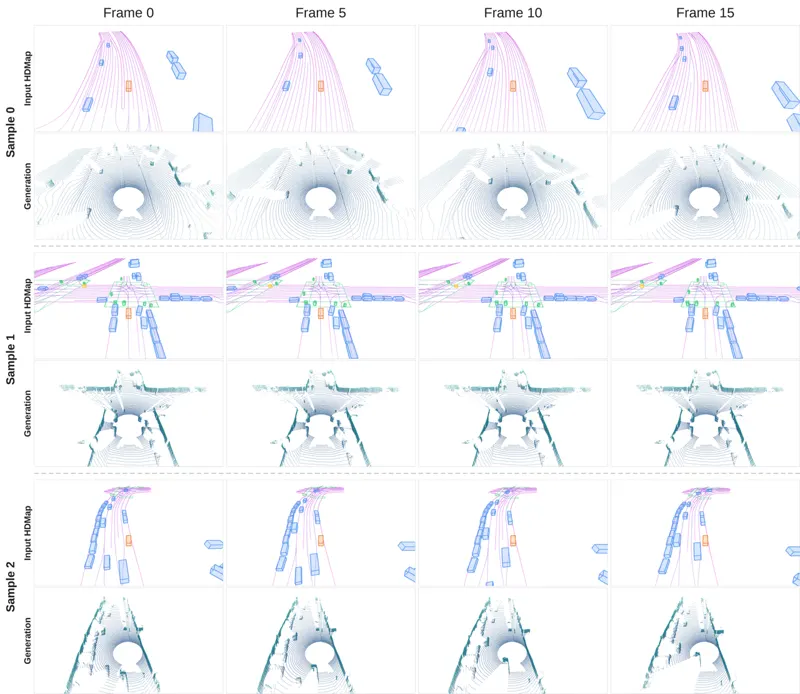
NVIDIA 等提出 LidarVerse:统一条件生成框架下的实时 LiDAR 世界模型。通用 tokenizer 将 32/64/128 线距离序列映射到共享潜空间,双向教师模型以 LiDAR 前缀、HD-Map、持久空间缓存与可选文本为条件;蒸馏出的四步自回归因果学生模型配合滚动时序 K/V 缓存与世界对齐空间缓存,在单张 H100 上以 11 FPS 实现长时程一致 rollout,在三种评测协议的大部分指标上达到 SOTA。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。