1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
在并发师生框架中引入世界模型(深度残差网络预测未来地形状态)和动量目标编码器(BYOL 式 EMA),通过预测损失强制教师编码器学习时空感知表示,为 student 提供稳定蒸馏目标,解决连续楼梯平滑运动问题。
Haidong Hou, Zhangguo Yu, Hengbo Qi
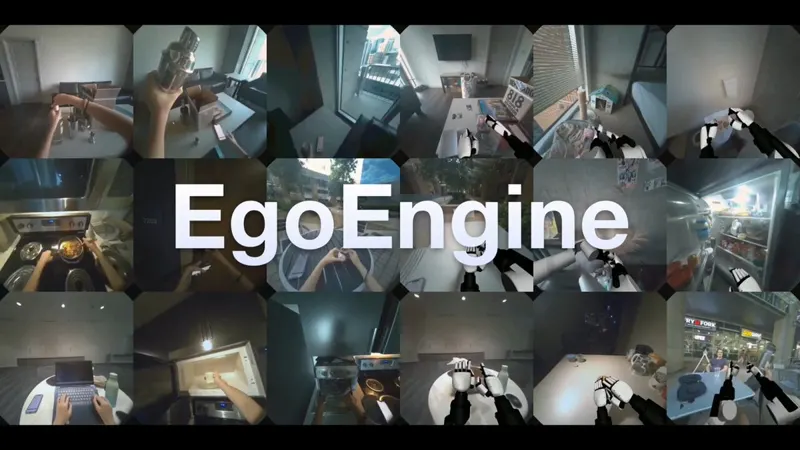
EgoEngine 把第一视角人类操作视频转成高保真机器人演示:生成对齐的机器人视角画面与可执行轨迹,实现无需真机示教的零样本灵巧操作学习。
1X 分享 1XWM 世界模型进展:通过动作可控的视频生成预测机器人动作的未来结果,使策略评估从物理实验转向模拟预测,实现规模化快速评估。
LEGS 用网格前景与三维高斯泼溅背景合成人形全身操作数据,并以运动基元自动生成演示。实验显示其训练策略在 Unitree G1 上匹敌或超过人工遥操作数据,跨场景泛化成本更低。
Kim, Hojune, Chen, Timothy, Sun, Jiankai
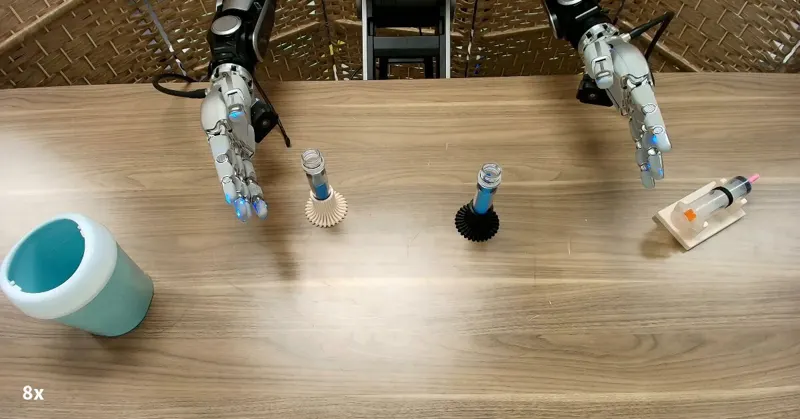
研究者推进行为基础模型BFM在人形机器人上的规模化应用,释放人形机器人操作潜力。
提出世界行动模型 (WAMs),统一状态预测与动作生成,弥补 VLA 局限。构建分类体系并分析数据生态。
Siyin Wang, Junhao Shi, Zhaoyang Fu
GRASP提出三种创新使世界模型的长程规划变得可行:提升状态实现时间并行优化、停止脆弱状态梯度保留动作梯度、周期性同步精化。在Push-T任务上长horizon成功率大幅领先CEM和GD。
NVIDIA Isaac GR00T N1.7 开源 VLA 基础模型,商用授权,面向人形机器人真实部署,支持 Hugging Face 集成。
Physical Intelligence 提出可操控的机器人基础模型 π0.7:通过语言指令、子目标图像与任务元数据等多模态上下文条件化,在未见环境多阶段任务、零样本跨本体泛化中开箱即用,性能比肩 RL 微调专用策略,并展现涌现能力。
Physical Intelligence, Bo Ai, Ali Amin
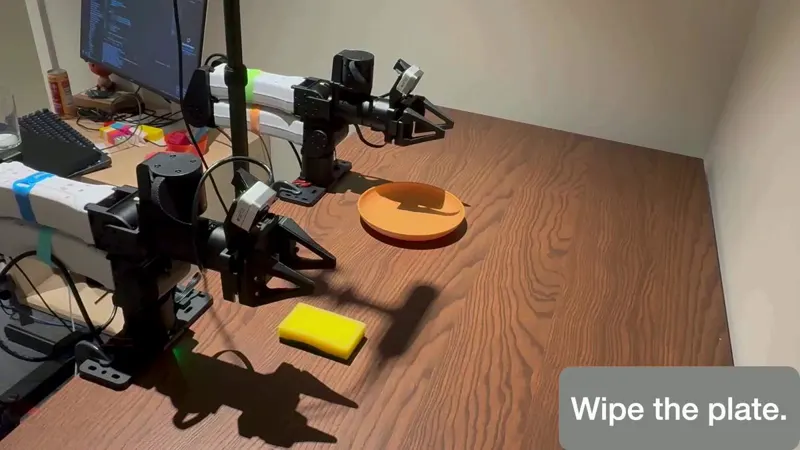
RD-VLA 用权重共享的循环动作头在潜空间迭代细化动作,无需显式推理 token,并按收敛程度动态分配测试时计算。
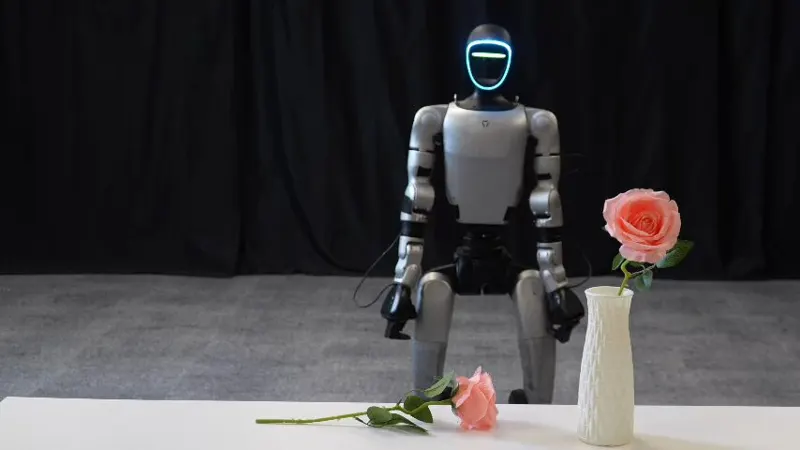
ZEST 用单阶段强化学习,把动作捕捉、单目视频和关键帧动画三类异构参考动作统一训练成模拟策略,零样本部署到 Atlas、Unitree G1 和 Spot,实现全尺寸人形机器人上首个动态多接触技能,无需接触标签、状态估计器或逐技能调参。
Jean Pierre Sleiman, He Li, Alphonsus Adu-Bredu
1X 介绍其视频预训练世界模型 1XWM,集成到 NEO 中作为机器人策略。与 VLA 不同,1XWM 从文本条件的视频生成中提取机器人动作,利用互联网视频中的世界动力学实现零样本泛化,无需大规模遥操作数据。