1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
提出FeelWorld视触觉世界模型,实现分层接触预测与规划,服务于contact-rich操作的视触觉感知。
Wenxuan Ma, Chaofan Zhang, Chao Xue
提出DeVA,通过物理引导实现解耦的视频-动作模型,服务于机器人策略学习与VLA,提升物理一致性。
Mengqi Zhang, Sahil Khose, Simar Kareer
提出FutureRTC,基于预期条件动作分块实现实时机器人执行,降低VLA推理延迟,提升实时控制性能。
Hai Jiang, Yixian Zou, Binbin Liang
提出WorldDiT,统一扩散架构同时建模世界与动作,在世界模型与动作生成上取得平衡,服务于具身智能。
Sen Wang, R. Gnana Praveen, Bidhan Roy
提出RoFacto,动作条件的扩散世界模型,让视频世界模型不只将动作看作数字,而是通过身体理解动作
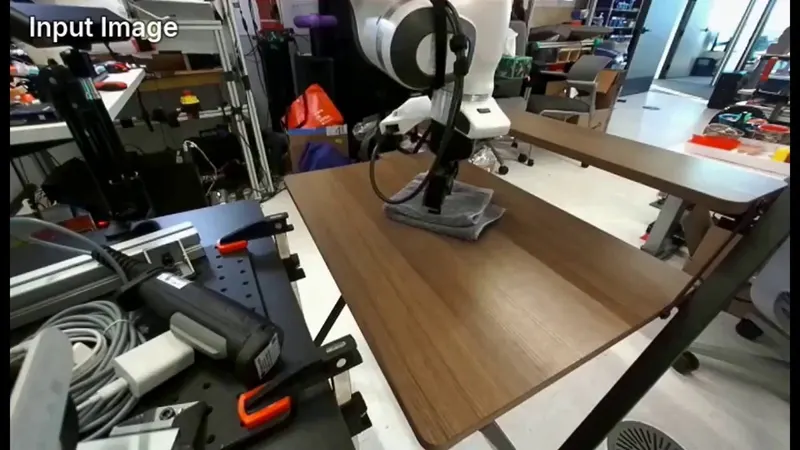
τ0-VLA面向长时序真实操作,机器人可自主清扫、做饭、调饮、收衣、整理,单次自主任务持续长达12分钟
ViTacWorld将触觉感知加入世界模型,让机器人预测与物体接触时的物理交互,解决像素预测好但接触建模差的瓶颈
现代机器人控制器多为反应式;LingBot-VA探索将双向视频模型改造为因果模型,保留预训练先验用于机器人控制
提出MulRobBench,面向多机器人安全与安全策略合规的决策级基准,评估多机器人系统的安全决策能力。
Belal S. Alsinglawi, Weizheng Wang, Junyi Wu
研究语言引导的机器人策略合成,证明少量语言指令即可显著提升机器人策略的泛化与组合能力。
Daphne Chen, Archit Ritesh Jain, Eric Goossen
研究在世界模型中,物理空间相邻集合的动作策略优于最佳预测,为世界模型动作生成提供新视角。
Liangyu Li, Qingwen Liu, Mingqing Liu
提出实时以人为中心的世界建模方法,针对上半身人物-物体交互,服务于人形机器人交互与世界模型。
Chaonan Ji, Jinwei Qi, Peng Zhang