Skip to content
← 标签

#Tsinghua University (4)

BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

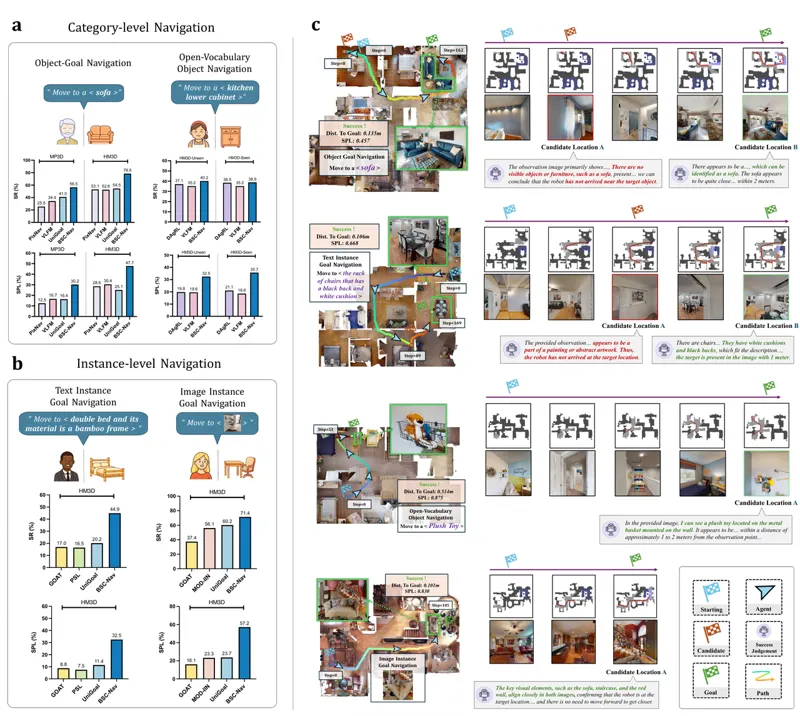
清华大学(计算机系、心理与认知科学系)与北京航空航天大学提出 BSC-Nav(Brain-inspired Spatial Cognition for Navigation)。论文指出,现有具身智能体无论走端到端强化学习还是「MLLM + 模块化流水线」,本质上都是反应式、无状态的——处理完观测就丢弃,缺乏持久的空间内部模型,导致知识碎片化、规划短视、泛化差。作者从神经科学借来答案:生物把空间知识巩固为地标、路线知识、概览知识三种互相连接的形式。BSC-Nav 用三个模块在计算上实例化了这套结构——地标记忆以四元组(世界坐标、开放词汇类别、检测置信度、GPT-4o 生成的上下文描述)编码显著线索与位置的持久关联,并用「空间重叠集 + 置信度加权融合」去重;认知地图用 DINO-v2 提取 patch 特征,经逆透视投影与级联坐标变换投射到体素网格,并采用受自由能原理启发的 surprise 驱动更新——按新特征与邻域内既有特征的平均距离决定是否写入,缓冲区满则替换 surprise 最低者,从而既保留跨视点多样性又控制存储;工作记忆按指令复杂度分层检索,简单目标用纯文本 GPT-4 推理地标记忆(甚至能由共现地标推断未记录目标的位置),复杂目标先由 GPT-4o 精炼描述、再用 Stable Diffusion 3.5 「想象」目标外观,经 DINO-v2 编码与中心距离加权池化后查询认知地图(imagine-then-localize),最后用相似度加权 DBSCAN 聚类得到候选坐标。多候选时不贪心选最高置信度,而是用 H_i = λ·p_i + (1-λ)(1-d_i/d_max) 复合打分排序探索序列。实验覆盖 MP3D/HM3D 共 62 个场景、8,195 个 episode:OGN 在 HM3D 达 78.5% SR(超 SOTA 的 UniGoal 24.0 个百分点),OVON 以零样本超越有监督的 DAgRL,IIN 达 71.4%;SPL 提升比 SR 更一致(IIN 达 57.2% vs 23.7%)。主动具身问答 A-EQA 上 LLM-Match 54.6 为最高,但仍落后人类 27.5。真机用 AgileX Ranger-mini-3.0 底盘 + Franka Research 3 机械臂 + RealSense D435i 平台,在约 200 m² 两层空间跑 75 个 episode,IIN 有 4/5 目标达 100% SR,失败时也稳定定位到语义合理区域;并展示了导航与操作原语协同的长程任务(如「做早餐」依次操作三个开放词汇物体)。论文提出「空间认知的具身图灵测试」应考察三个维度:实时构建可复用空间表征、从稀疏部分观测中抽象推理、把高层目标转译为可执行空间计划。

Ruan, Shouwei, Wang, Liyuan, Kang, Caixin · 1104次阅读 · 2025年8月24日

BSC-Nav视觉语言导航
2025年8月24日
ReST-RL:用统一自训练与价值引导搜索强化大模型推理

ReST-RL:用统一自训练与价值引导搜索强化大模型推理

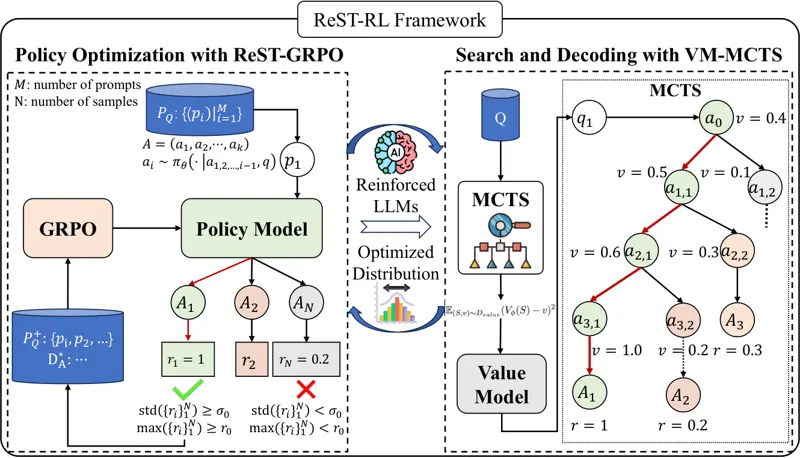
GRPO 是当前提升大模型推理能力的代表性强化学习方法,但它只在整条轨迹末端拿到一个稀疏奖励:一旦同组采样得到的奖励彼此接近,组内相对优势就退化成噪声,策略几乎学不到东西。ReST-RL 把策略优化与价值引导搜索重新接回同一条自训练流水线。第一阶段 ReST-GRPO 先按奖励标准差过滤掉信息量低的提示词,再从每个提示词的最高奖励轨迹中按离散指数分布抽取若干前缀,把它们当作在线 GRPO 的新起点——前缀只作为上下文,后缀一律重新采样并优化,而不是拿来模仿。第二阶段 VM-MCTS 在这个已静态化的策略下用 MCTS 自采价值目标,训练一个预测期望终端奖励的价值模型,推理时同一个模型既用于 UCT 搜索分配,也用于最终 Best-of-N 排序,搜索与验证共享同一套状态价值尺度。在 APPS、BigCodeBench、HumanEval 等代码基准上,Qwen3-8B 的平均分从 0.503 提升到 0.689;在匹配策略与价值模型的对照实验里,ReST-GRPO + VM-MCTS 在 APPS-500 上得到 0.642,而 GRPO + VM-MCTS 只有 0.538,说明第一阶段带来的轨迹分布改善确实穿过了价值学习环节存活下来。端到端算力核算上,ReST-GRPO 用 1752 GPU 小时对 GRPO 的 2080 小时,在 71 小时而非 207 小时达到 9% 的提升。仅用代码轨迹训练出的价值模型,在不做目标域微调的情况下迁移到 MATH、Omni-MATH 与 GPQA-Diamond 同样带来增益。

Sining Zhoubian, Dan Zhang, Jie Tang · 846次阅读 · 2025年8月27日
强化学习GRPO
2025年8月27日
Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

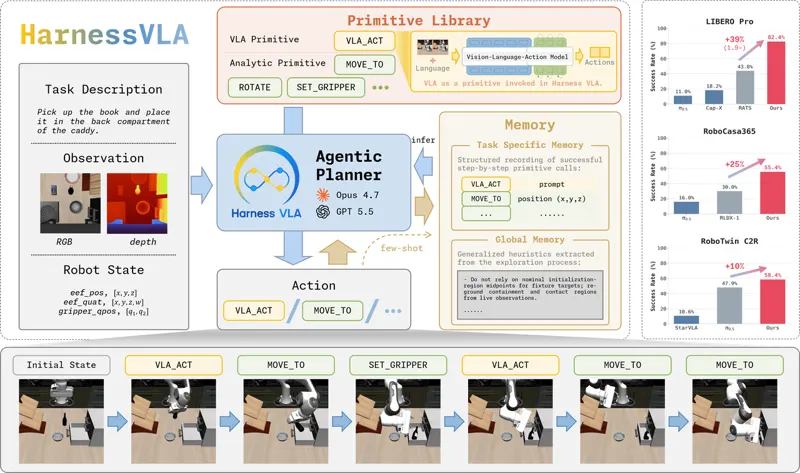
语言条件操作既需要精确的富接触控制,也需要对语言、场景和长时程的稳健推理。端到端视觉-语言-动作(VLA)模型提供强大的局部视觉运动技能,但它们是在分布内任务轨迹上训练的,在语义重定向、目标重绑定、空间布局偏移和局部接触不稳定等部署扰动下常常失效。LLM 编码智能体提供互补的语义与组合推理,但纯解析原语在不规则抓取、受限放置和铰接物体交互上表现很差。本文提出 Harness VLA,一个记忆增强的智能体框架:它把一个冻结的 VLA 暴露为可重试的富接触原语,并与一个小型固定的解析原语库组合,用于接地、暂存、搬运、导航和释放。框架不去扩大技能库,而是从任务特异的执行轨迹、全局成功规则和失败模型中学习这些固定原语的工作范围。通过把语义重接地、非接触执行和 VLA 重暂存上提到规划器,同时把冻结 VLA 留给局部富接触阶段,Harness VLA 在不微调的前提下把预训练 VLA 扩展到其原始轨迹分布之外。在被扰动的桌面操作、家庭厨房操作和 clean-to-randomized 双臂操作上,Harness VLA 在 LIBERO-Pro 和 RoboCasa365 上分别比最强相关基线高出 38.6 和 27.1 个百分点,并在 RoboTwin C2R 上达到 58.4%。代码开源于 https://github.com/RLinf/RPent 。

Yixian Zhang, Huanming Zhang, Feng Gao · 1291次阅读 · 2026年7月9日
视觉语言动作模型机器人操控
2026年7月9日

本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。