
反思、重试、奖励:强化学习驱动的自改进 LLM
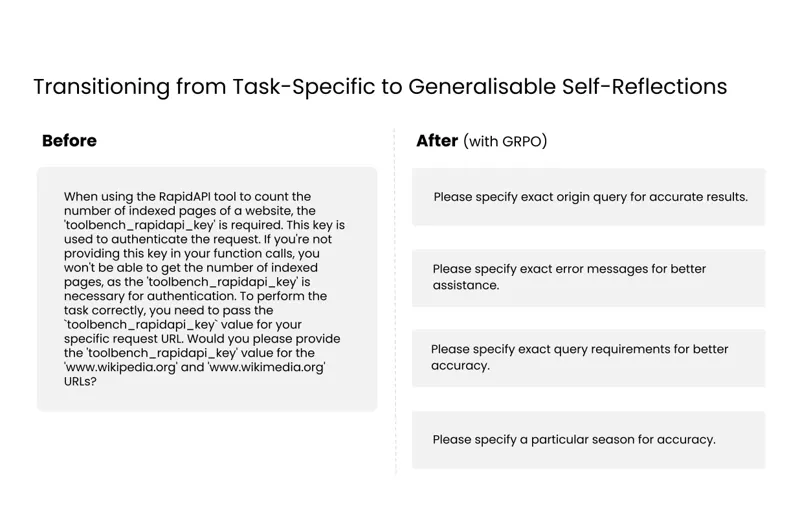
论文提出 Reflect-Retry-Reward 框架:模型首次答错后生成自反思,再带着反思重试;若重试成功,就用 GRPO 只奖励反思 token。方法仅依赖二元反馈,使 1.5B-7B 模型在函数调用和数学方程生成上显著提升,小模型可超过同族约 10 倍规模的模型。
Shelly Bensal, Umar Jamil, Christopher Bryant · 20次阅读 · 2025年5月30日
Large Language Models强化学习
2025年5月30日