Skip to content
← 标签

#RoboCasa (6)

LoopWAM:从部署回放中闭环改进的通才机器人策略

LoopWAM:从部署回放中闭环改进的通才机器人策略

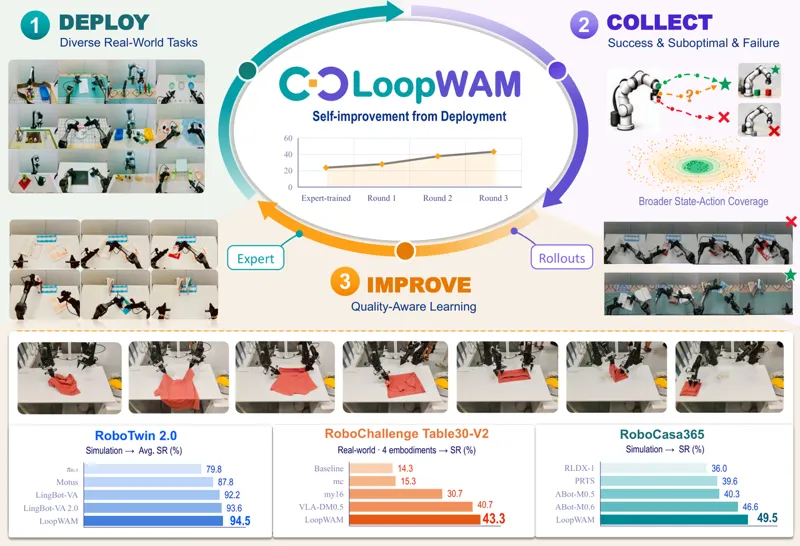
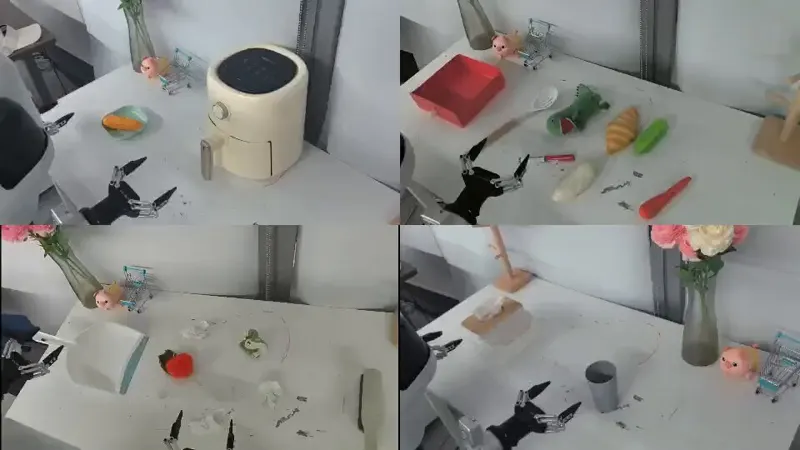
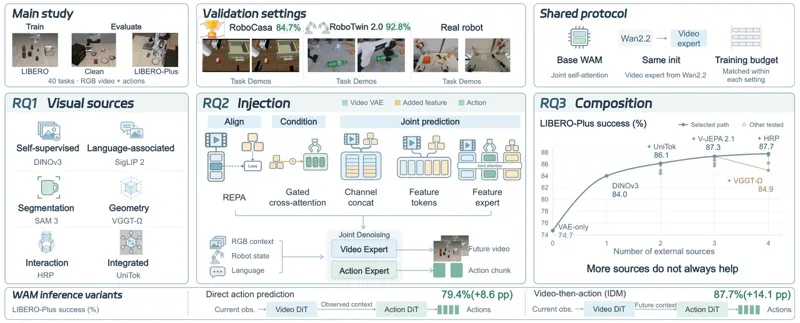
只堆专家示范,通才机器人策略并不会因为「上了真机」就变强:部署回放里既有成功,也有次优动作和彻底失败,逐个动作照抄会把坏行为一起学进去,而把失败样本直接丢掉,又丢掉了物理交互及其后果的证据。LoopWAM 是一个闭环的世界动作模型(world-action model),它直接从这份「全质量谱系」的回放里学习,回放既可以来自它自己,也可以来自别的已部署策略(X-VLA、π0.5)。方法上有三块互相咬合的设计:源相关噪声采样把行为学习与动作条件世界建模统一进同一个联合去噪目标——示范数据只对视频加噪、回放数据只对动作加噪,两条流在每一层的联合注意力里交互,学到的「后果」因此能直接参与动作生成;质量引导把质量分数写进指令后缀 Quality: q,部署时固定取最高档,使同一个模型既能被引导也能被评估;质量加权监督用 λ(q) 调节动作项的模仿强度(q=1,2 为 0.0,q=3 为 0.3,q=4 为 0.6,q=5 为 1.0),视频监督则在全质量段完整保留。模型由 Wan2.2-TI2V-5B 初始化,视频 DiT 30 层 3072 维、动作 DiT 30 层 1024 维,flow matching 训练。结果:RoboChallenge Table30-V2 上三轮「部署—采集—再训练」把成功率从 23.67% 拉到 43.33%(+19.7 个百分点),总分 36.10→56.80;RoboTwin 2.0 平均成功率 94.5%(用 LoopWAM、X-VLA、π0.5 三个策略共 22,500 条回放训练);RoboCasa365 总成功率 14.9%→49.5%,三项基准在对比方法中都是最好,且没有做额外的具身预训练。最难的叠衣服任务上,单任务后训练之后再跑两轮部署驱动改进,成功率从 13.20% 升到 55.56%。消融显示:完全不做质量引导只有 72.3%,粗粒度标注加上质量加权动作监督才到 94.5%。项目页 https://loop-wam.github.io/
Wenxuan Guo, Yingping Liang, Zhaoguo Wang · 378次阅读 · 2026年10月13日
世界动作模型自改进
2026年10月13日
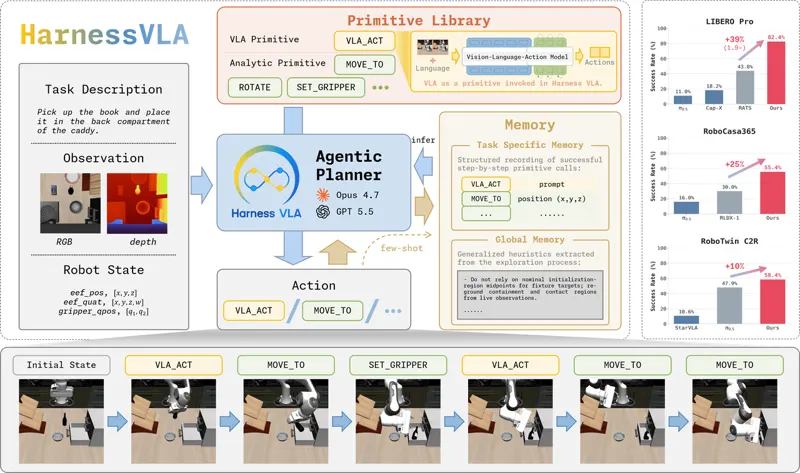
Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

语言条件操作既需要精确的富接触控制,也需要对语言、场景和长时程的稳健推理。端到端视觉-语言-动作(VLA)模型提供强大的局部视觉运动技能,但它们是在分布内任务轨迹上训练的,在语义重定向、目标重绑定、空间布局偏移和局部接触不稳定等部署扰动下常常失效。LLM 编码智能体提供互补的语义与组合推理,但纯解析原语在不规则抓取、受限放置和铰接物体交互上表现很差。本文提出 Harness VLA,一个记忆增强的智能体框架:它把一个冻结的 VLA 暴露为可重试的富接触原语,并与一个小型固定的解析原语库组合,用于接地、暂存、搬运、导航和释放。框架不去扩大技能库,而是从任务特异的执行轨迹、全局成功规则和失败模型中学习这些固定原语的工作范围。通过把语义重接地、非接触执行和 VLA 重暂存上提到规划器,同时把冻结 VLA 留给局部富接触阶段,Harness VLA 在不微调的前提下把预训练 VLA 扩展到其原始轨迹分布之外。在被扰动的桌面操作、家庭厨房操作和 clean-to-randomized 双臂操作上,Harness VLA 在 LIBERO-Pro 和 RoboCasa365 上分别比最强相关基线高出 38.6 和 27.1 个百分点,并在 RoboTwin C2R 上达到 58.4%。代码开源于 https://github.com/RLinf/RPent 。

Yixian Zhang, Huanming Zhang, Feng Gao · 1160次阅读 · 2026年7月9日
视觉语言动作模型机器人操控
2026年7月9日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。