
FAR:失败感知重试——测试时自我恢复与策略持续改进
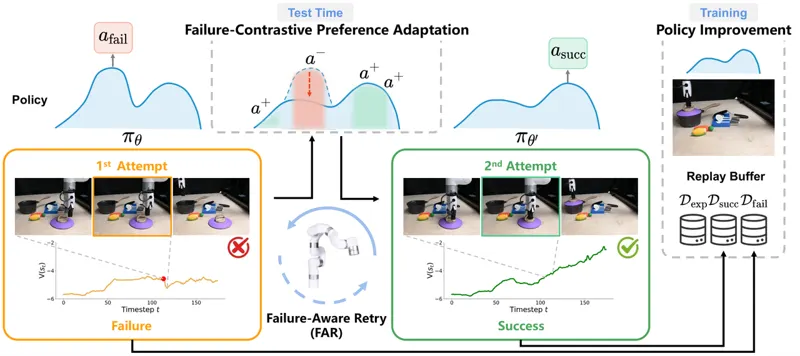
离线示范训练出的机器人策略一旦部署到真实环境就难免失败:抓空、掉物、碰倒物体,而这些失败状态在示范数据里几乎没出现过,直接重跑只会重复同一个错误。CMU 团队提出失败感知重试 FAR:失败后不重置环境,而是保留现场、把机械臂退回起始位姿再试。FAR 先用 IQL 风格的保守价值函数对失败轨迹做归因,按价值增量 ΔV 的分位数挑出致败动作块作为负样本;再从当前策略采样候选动作块,经距离过滤与 critic 打分挑出 Top-K 正样本,组成对比偏好对;最后用扩散版偏好优化目标只做 10 步梯度更新(单卡约 1.5–3 秒),把策略从失败行为上推开,并在重试时注入时间平滑的高斯扰动做局部探索。成功的恢复轨迹再进入回放缓冲,用优势加权的去噪目标做持续策略改进。在 ManiSkill、RoboSuite、RoboMimic 九个仿真任务上,FAR 比标准扩散策略平均高 17.6 个百分点;xArm 真机三个任务上平均高 11.7 个百分点(80.0% 对 68.3%),同时减少在线学习所需的环境重置次数。
Haoran Hao, Shahram Najam Syed, Jeffrey Ichnowski · 18次阅读 · 2026年7月1日
失败恢复Test-Time Adaptation
2026年7月1日