OneWM:统一因果训练能否让世界模型与动作模型相互促进?
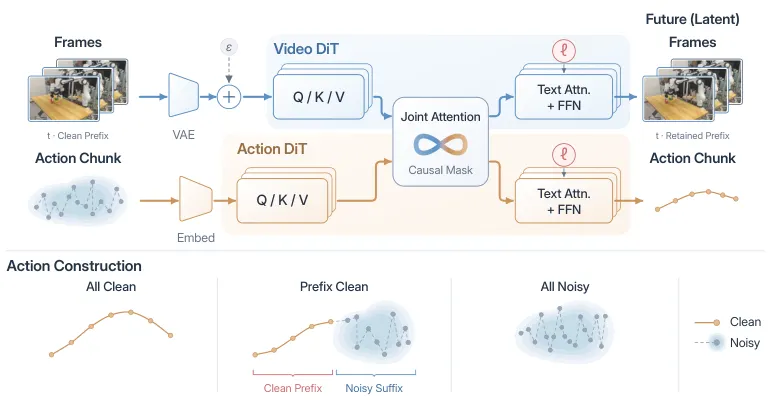
世界模型预测给定动作会带来怎样的未来观测,动作模型则根据视觉上下文生成控制。既有世界动作模型常让视频分支只接触噪声动作,或完全屏蔽动作信息,难以显式学习“指定动作会造成什么变化”。OneWM 在共享的视频—动作混合 Transformer 中引入全干净、部分干净与全噪声三种动作条件:干净动作作为未来视频的因果条件,噪声后缀作为动作去噪目标,并通过时间因果联合注意力耦合两个专家。作者在 LIBERO、LIBERO-Plus、RoboCasa365 与三项真实机器人任务上同时评估策略学习和世界预测,结果显示,指定动作的世界建模能提升策略,并改善分布偏移下的泛化;动作生成监督也会改善多视角未来视频预测,形成双向收益。
Yue Su, Bokai Lin, Xinkai Wang · 11次阅读 · 2026年10月15日
 2:52