
Kernel Forge:面向真实 PyTorch 工作负载的 CUDA 内核智能优化框架
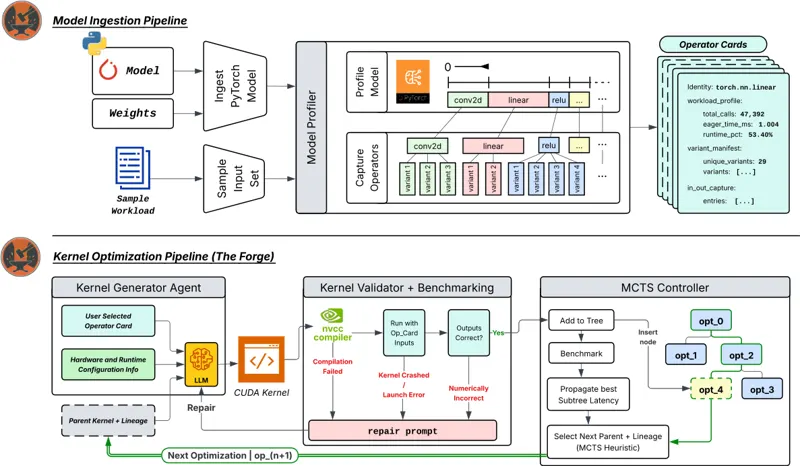
Kernel Forge 直接运行未经修改的 PyTorch 模型,捕获真实推理中执行的算子及其形状、数据类型和参数,再用大模型生成并迭代优化对应的 CUDA 内核。系统以蒙特卡洛树搜索管理多条修改路径,候选内核须经 nvcc 编译、运行和数值比对才能进入搜索树;导出时只有在捕获输入上通过验证且快于 PyTorch eager 的内核才会被调用,否则回退到原实现。作者在 DGX Spark 的 GB10 GPU 上评测 ResNet-50、Stable Diffusion 3.5 Medium、Gemma 4 E2B 与 Qwen 3.5 35B-A3B,每个算子只做 50 次优化,14 个内核超过 eager,其中 adaptive_avgpool2d 达到 1.52×、group_norm 达到 1.70×、softmax 分别达到 2.83× 与 1.54×。
Joshua Brodsky, Dhravid Kumar, Savini Kashmira · 22次阅读 · 2026年6月2日
CUDAGPU Kernel
2026年6月2日