PAPER DEEP DIVE
Kernel Forge:面向真实 PyTorch 工作负载的 CUDA 内核智能优化框架
Kernel Forge 直接运行未经修改的 PyTorch 模型,捕获真实推理中执行的算子及其形状、数据类型和参数,再用大模型生成并迭代优化对应的 CUDA 内核。系统以蒙特卡洛树搜索管理多条修改路径,候选内核须经 nvcc 编译、运行和数值比对才能进入搜索树;导出时只有在捕获输入上通过验证且快于 PyTorch eager 的内核才会被调用,否则回退到原实现。作者在 DGX Spark 的 GB10 GPU 上评测 ResNet-50、Stable Diffusion 3.5 Medium、Gemma 4 E2B 与 Qwen 3.5 35B-A3B,每个算子只做 50 次优化,14 个内核超过 eager,其中 adaptive_avgpool2d 达到 1.52×、group_norm 达到 1.70×、softmax 分别达到 2.83× 与 1.54×。
Kernel Forge: An Agent Harness for LLM-based Generation and Optimization of CUDA Kernels
Joshua Brodsky、Dhravid Kumar、Savini Kashmira、Jayanaka Danatanarayana、Jason Mars、Krisztian Flautner、Lingjia Tang(University of Michigan;前两位为共同第一作者)
arXiv:2607.24762v1 [cs.AI; cs.PF],提交于 2026-06-02 · arXiv:2607.24762 · 代码仓库 TheJoshBrod/KernelForge(MIT)
代码状态:仓库公开,包含模型摄取、CUDA 生成与校验、MCTS 搜索、.cast 打包、命令行与图形界面;论文实验脚本位于 paper_benchmarks/。
一句话总结
Kernel Forge 不要求开发者改模型,而是先把真实前向执行中出现的算子、张量形状、数据类型、步长和参数捕获成 operator card,再让大模型围绕这些具体变体写 CUDA,用持久化 MCTS 管理多条修改路径;只有编译成功、在捕获输入上通过数值比对、并且确实快于 PyTorch eager 的内核才会被导出和调用。在 DGX Spark 的 GB10 上,每个算子只搜索 50 次,四个视觉、扩散和语言模型里共有 14 个内核超过 eager,最高的 softmax 达到 2.83×。
一、问题不在“能不能写一个快 kernel”,而在写完之后能不能安全接回模型
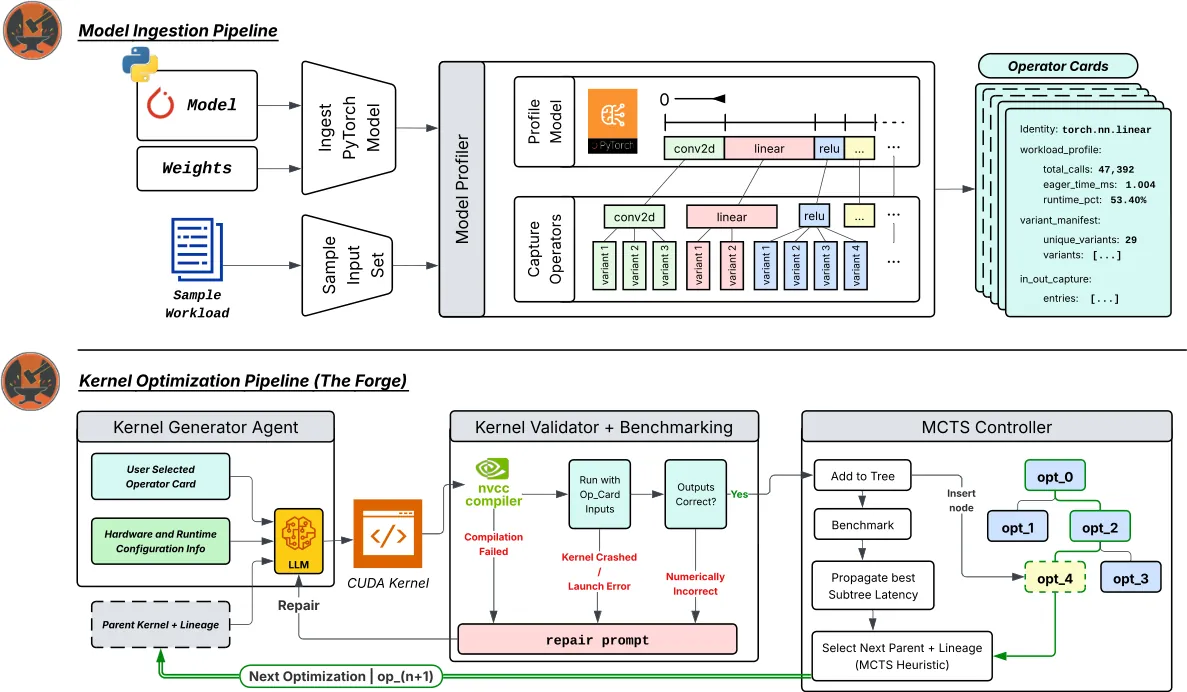
图1(论文 Figure 2):Kernel Forge 的两段式结构。上半段从真实模型执行中抽取 operator cards;下半段完成生成、编译、数值校验、基准测试、MCTS 搜索与 guarded dispatch。
一个模型的运行时间通常集中在少数算子上:矩阵乘、卷积、归一化、softmax、逐元素加法。按直觉,只要把这些算子换成更快的 CUDA 实现,模型就会变快。真实工程里这条推理经常断在三个地方。第一,孤立 kernel 的最优参数依赖随机张量或固定 shape,而模型里的同一个算子会以不同 dtype、stride、layout 和广播参数出现。第二,生成的 CUDA 往往是一个独立源文件,开发者仍要自己写绑定、处理输出分配、接回 PyTorch 调用点。第三,性能比较若只对着一个弱参考实现,赢的是基准,不是生产路径。
论文把现有工具的缺口拆成四条。其一,许多系统把集成工作留给使用者,生成的是 standalone CUDA,而不是能透明替换的执行路径。其二,部分工具只覆盖 LLM 服务或 benchmark kernel,视觉、扩散、音频模型里同一算子会以不同形状和参数出现,调好的实现未必迁移。其三,线性 refinement 让结果高度依赖早期设计选择,beam search 又可能过早剪掉暂时变慢、但后续能翻盘的候选。其四,研究原型多以脚本或 benchmark workflow 暴露,缺少查看候选、比较版本、定位失败的图形界面。
这四个缺口共同指向一个评价标准:kernel 优化系统不能只回答“生成的代码在某个测试上快不快”,还要回答“它在真实模型的这一种调用上是否正确、是否更快、如果没有更快会怎么办”。Kernel Forge 的设计围绕后一个问题展开,速度只是整条链路中的一个判据。
二、系统总览:摄取与锻造分开,算子卡是两边唯一的接口
系统分成 Model Ingestion Pipeline 与 Kernel Optimization Pipeline(论文称 The Forge)。摄取阶段执行原始 PyTorch 模型,记录实际发生的算子调用,聚合成运行时兼容的变体,并为每个算子族生成 operator card。锻造阶段以卡片为输入,让 LLM 生成 CUDA 与 launch wrapper,经编译、运行、数值校验和基准测试后进入搜索树。
这个切分有一个工程上的好处:摄取不需要 CUDA 生成,生成也不需要重新跑完整模型来决定下一步。卡片把模型侧的证据压缩成可复用的优化目标,包含算子族、调用次数、eager 执行时间、运行占比、变体清单和验证样例。生成器只需面对一个明确的 shape、dtype 和参数组合,校验器也只需重放这一组捕获输入。
论文强调“workload-specific variant”而不是“operator name”。同为 linear,在 Gemma 4 E2B 的 decode 阶段与在 Stable Diffusion 的文本编码器里可能是不同的输入维度、不同的 dtype、不同的内存布局;它们应该形成不同的优化单元。这个定义直接决定了后面所有数字的含义:提升是某个具体变体上的提升,不是对整个模型端到端延迟的承诺。
三、模型摄取:把一次真实前向拆成可重放的调用证据
用户提供模型、权重和样例输入,不需要改写模型代码。Kernel Forge 在 PyTorch dispatch 层挂钩,记录受支持的高层算子,例如 conv2d、linear、relu、归一化、池化和 softmax。每次调用保存张量形状、dtype、stride、layout、标量与可选参数、设备位置、输出元数据,以及输入输出样例。仓库里的 src/optimizer/benchmarking/profile_project.py 用 unique_case 对调用去重,保留能够重放和比对的样本。
捕获完成后,系统按运行时兼容性把调用分组。两个调用即使算子名相同,只要 shape、dtype、layout、参数、后端行为或替换要求不同,就属于不同变体。这个分组不是静态分析出来的,而是从真实执行轨迹中归纳出来的,因此能保留 PyTorch 在特定设备上实际选择的路径。
运行占比用捕获区间内的调用次数和 eager 时间估计。设变体 $v$ 的调用次数为 $n_v$,单次 eager 时间为 $t_v$,捕获算子集合为 $\mathcal{V}$,则
$$w_v=\frac{n_v t_v}{\sum_{u\in\mathcal{V}} n_u t_u}. \tag{1}$$
这个权重解释了一个容易被标题数字掩盖的事实:一个提升 2.8× 的算子,如果只占 0.19% 的运行时间,对整体延迟的贡献远小于一个只提升 1.05×、却占 53% 时间的算子。论文在结果部分反复使用 $w_v$ 来对照局部 speedup,避免把“某个 bar 很高”误读成“模型整体快了三倍”。
摄取阶段还保存 eager 输出作为后续正确性基准。校验器不是与 CPU 参考实现比较,也不是与另一个库比较,而是与同一模型、同一输入、同一 dtype 下 PyTorch 实际产生的输出比较。这个选择让比较贴近部署环境,也抬高了门槛:生成代码必须打赢框架自己和厂商库,而不是打赢一个教科书实现。
四、生成器:先写一个能跑的 CUDA 扩展,再在父代基础上改
第一轮,生成器把 operator card 中的张量元数据、参数值、输出元数据和 launch 接口交给 LLM,要求它输出一个 kernel.cu 文件,其中包含 device 代码和一个名为 launch 的 C++ host wrapper。系统提示词明确禁止把目标计算转交给 PyTorch、ATen、cuDNN、cuBLAS 或其他 wrapper,要求计算在 kernel 内完成。提示词是约束,不是保证;因此后续还有审计标签来区分“真的生成了 CUDA”和“绕回了后端库”。
后续轮次不再从零开始。MCTS 控制器选择一个已经通过验证的父节点,把父代源码和 lineage 一并交给生成器,要求它在保持卡片所描述行为的前提下降低延迟。lineage 包含此前尝试过的修改方向,使模型能沿一条有历史的路线继续,而不是每一轮都重新猜。
生成器同时接收硬件与运行时配置,例如 GPU 型号、计算能力、编译器和可用内存。这个信息影响 tile 大小、共享内存使用、线程块配置和向量化宽度。论文没有把硬件参数做成固定模板,而是让提示词携带目标环境,使同一个算子在不同 GPU 上可以得到不同的候选。
五、校验器:编译、运行、数值比对,失败就回到有界修复回路
候选先由 nvcc 编译。编译失败时,编译器错误被送回生成器,进入一个有界 repair loop;修复后的代码再次编译。编译通过后,系统用 operator card 中保存的输入启动 kernel。启动错误、崩溃、非法内存访问同样进入修复回路,并携带对应的失败信息。
能编译、能启动还不够。候选输出必须与捕获的 eager 输出做数值比较。浮点张量使用 torch.allclose 语义:
$$|x_i-y_i|\leq \mathrm{atol}+\mathrm{rtol}\,|y_i|. \tag{2}$$
仓库默认取 $\mathrm{atol}=10^{-2}$、$\mathrm{rtol}=10^{-1}$;整数或非浮点输出走精确相等。对量化的 TinyGEMM 路径,容差另有专门配置。容差不是“宽松到能过”的装饰,它决定了 fp16、bf16 累加误差、softmax 归一化和归约顺序差异能否被接受。论文把校验定位为 workload-specific filter,而不是对所有可能输入的正确性证明:通过只说明候选在捕获样例上匹配,不说明它在分布外输入上安全。
只有通过校验的候选才进入 MCTS 树。失败候选不会污染搜索统计,但其错误信息会用于修复。这个顺序很关键:如果先按速度排序再验证,树里会混入不可用的快代码,后续选择会围绕错误节点展开;先验证再计时,搜索的每个节点至少是一个可执行、可比较的实现。
六、MCTS 控制器:搜索的是修改路径,不是单个 kernel 的 hyperparameter
每个变体有一棵持久化 revision tree,节点保存源码、父子链接、访问次数、优化笔记、审计状态和实测延迟。树存放在项目的 SQLite 文件 nodes.db 中,进程重启后可以继续搜索。节点不是超参数组合,而是一份具体的 CUDA 源码及其修改历史;边表示“从哪个版本改到哪个版本”。
选择分两步。第一步是 progressive widening:节点 $x$ 的访问次数为 $N_x$,根节点访问次数为 $R$,则允许的子节点数量满足
$$\left|\mathrm{children}(x)\right|\leq\left\lfloor N_x^{\alpha(R)}\right\rfloor. \tag{3}$$
指数 $\alpha(R)$ 在前 1000 次根访问中从 0.5 线性退火到 0.3:
$$\alpha(R)=0.5-(0.5-0.3)\min\!\left(1,\frac{R}{1000}\right). \tag{4}$$
早期指数大,节点更容易长出新分支,搜索面更宽;后期指数小,新增分支变慢,计算更多花在已有分支的深挖上。这正对论文想解决的问题:一个早期看起来更慢的候选,可能在后续几轮修改后变成更好的父代,所以不能在第一轮就按当前速度把它剪掉。
当节点不再扩展时,控制器按最小化版本的 UCT 选择子节点:
$$\mathrm{score}(c\mid p)=L_c-C\sqrt{\frac{\log N_p}{N_c}},\qquad C=1.0. \tag{5}$$
这里 $L_c$ 是子节点子树内观察到的最佳延迟,若没有则用子节点自身延迟;$N_p$、$N_c$ 是父节点和子节点的访问次数。第一项利用已知的最好结果,第二项奖励访问不足的分支。与最大化奖励的 UCT 不同,这里分数越低越好,因为目标是降低毫秒数。
每次测量后,最佳延迟沿祖先链向上传播:
$$L_x=\min\!\left(\ell_x,\ \min_{c\in\mathrm{children}(x)}L_c\right), \tag{6}$$
其中 $\ell_x$ 是节点自身的实测延迟。传播让一个“自己不算快、但后代很强”的节点仍然有继续被选中的价值。树保留更快和更慢的有效候选,因为慢候选可能是下一次结构修改的必要中间态。控制器还设置了停滞阈值:一个子节点被访问足够多次、子树最佳值却从未超过自身值时,会被暂时跳过,避免在死胡同里反复采样。
七、打包与 guarded dispatch:默认回退,只有证据支持时才替换
优化完成后,选中的候选被导出为 .cast 包。包里包含生成的源码、launch 元数据、验证状态、计时信息、workload-specific 算子元数据和审计标签。仓库的 docs/FileFormat.md 规定它是 ZIP 容器,第一个条目必须是 HEADER.json,并带 checksums.sha256 做完整性校验;paper_benchmarks/paper_bench/cast_export.py 的选择策略是 auto_best_fastest_valid,只导出通过验证且更快的 kernel。
运行时替换是一个合取条件。设候选 $k$ 的验证结果为 $V_k$,与捕获调用模式的兼容性为 $C_k$,候选延迟为 $t_k$,eager 延迟为 $t_{\mathrm{eager}}$,则只有在
$$\mathrm{use}(k)=V_k\land C_k\land\left(t_k<t_{\mathrm{eager}}\right) \tag{7}$$
成立时才 dispatch 生成的 CUDA,否则走原 PyTorch eager 路径。这个策略把“优化”从一次性全局替换改成了逐变体决策:同一模型里,softmax 可以用生成内核,linear 继续用 cuBLAS;conv2d 继续用 cuDNN,tensor add 用生成实现。论文结果图里的半透明 cap 就是回退恢复到的 1.0×,它不是额外的加速,而是 guard 的可视化。
审计标签把三种结果分开:generated CUDA、wrapper/backend path、fallback。一个包可能改善了捕获区域的整体表现,但其中某些算子仍靠回退;也可能用了生成代码,却在内部调用了后端库。论文在统计“generated-CUDA win”时排除 wrapper/backend 路径,避免把库调用算成模型的功劳。这个区分看起来只是报表细节,实际决定了结论是否可信。
八、实验设置:四个真实工作负载,一张 GB10
所有实验运行在 NVIDIA DGX Spark 上,GPU 为 GB10,计算能力 12.1(sm_121)。软件栈为 PyTorch 2.10.0+cu130、CUDA 13.0、nvcc 13.0.88、驱动 580.126.09、cuDNN 9.15.1。生成与优化提示统一使用 Anthropic Claude Opus 4.7,成本按每百万输入 token 5 美元、每百万输出 token 25 美元计算;校验、计时、回退和成本记账都在本地 harness 完成。
| 工作负载 | 模型与精度 | 输入与计时策略 | 捕获调用 |
|---|---|---|---|
| 视觉 | TorchVision ResNet-50 V1.5,IMAGENET1K_V2,fp16 | ImageNetV2 matched-frequency,224×224;20 个 warmup batch,100 个计时 batch | 2,800 |
| 扩散 | Stable Diffusion 3.5 Medium,Diffusers,bf16 | T2I-CompBench 提示;batch 1,1024×1024,28 步,guidance 3.5,最大序列 256;20 warmup,100 次生成 | 75,544 |
| 语言 | Gemma 4 E2B,bf16,CUDA/offload,eager attention | 100 条固定提示(60 MT-Bench、20 ShareGPT、20 LongBench multi_news);batch 1,贪心解码,KV cache,最多 128 个新 token | 3,840 |
| 语言 | Qwen 3.5 35B-A3B,bf16,CUDA/offload,eager attention | 同一组 100 条提示;batch 1,贪心解码,KV cache,最多 128 个新 token | 912 |
表1:论文 Table 1 的工作负载、捕获来源与计时策略。
搜索预算分为 opt0、opt5、opt10、opt20、opt50 五个臂。opt0 是第一次生成的候选,opt$i$ 表示经过 $i$ 次优化迭代后的审计点。论文明确说明这些臂不保证单调改善:更多搜索可能找到更好的候选,也可能把预算花在运行占比很低、或 eager 基线已经很强的算子上。所有结果都是 operator-region 测量,不是端到端模型加速。
基线是每个变体在原模型中实际执行的 PyTorch eager 路径,包括 ATen、cuBLAS、cuDNN、SDPA 等成熟实现。这个基线比“手写 naive kernel”难打,也更接近部署现实。论文把 24 个 open-source/native 算子与 9 个 proprietary/vendor-backed 算子分开统计,避免用前者的大量小胜掩盖后者几乎全败的事实。
九、结果:局部高倍率与运行占比之间的错位
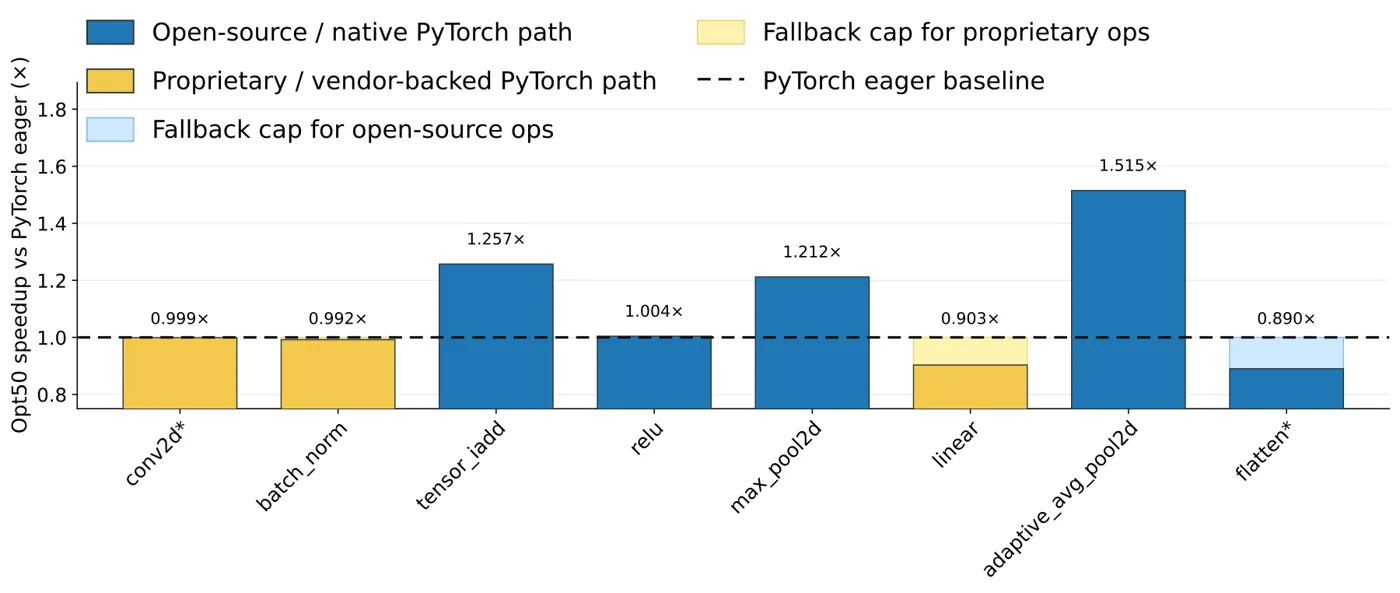
图2(论文 Figure 3):ResNet-50 在 opt50 下的算子级结果。蓝色为 open-source/native,黄色为 proprietary/vendor-backed,半透明 cap 表示回退到 1.0×,星号表示 wrapper/backend 路径。
ResNet-50 的胜点集中在原生算子。tensor add 达到 1.257×,运行占比 13.71%;ReLU 为 1.004×,占 11.90%;max pooling 为 1.212×,占 1.63%;adaptive average pooling 为 1.515×,但只占 0.12%。反过来,占 53.35% 的 conv2d 只有 0.999×,batch norm 为 0.992×,linear 为 0.903×,flatten 为 0.890×;这些路径要么是厂商库,要么已经足够成熟,guarded fallback 保留了 eager。
这组数字说明了一个部署事实:生成代码可以在“框架没有极致优化”的算子上赢,但模型的大部分时间往往恰恰在“框架已经极致优化”的算子上。ResNet-50 的 conv2d 占据超过一半的捕获时间,Kernel Forge 没有强行替换它,而是让生成的 tensor add、ReLU、pooling 在旁路生效。单看 1.515× 很亮眼,乘上 0.12% 的占比后,对整体延迟的影响非常有限。
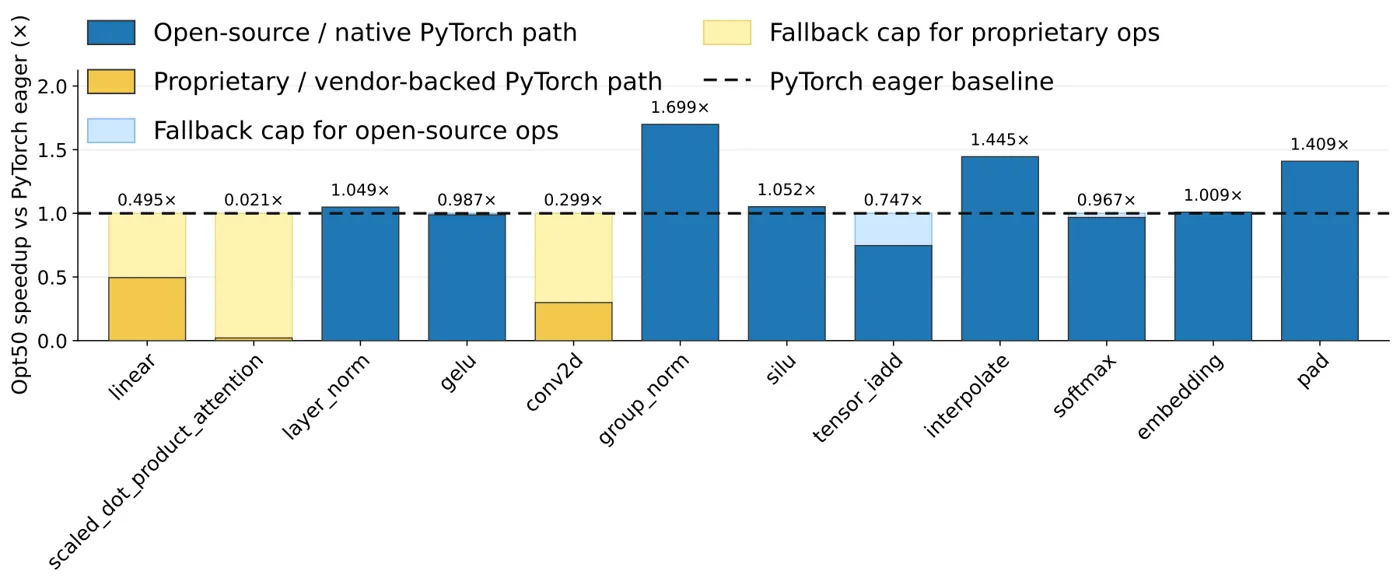
图3(论文 Figure 4):Stable Diffusion 3.5 Medium 在 opt50 下的算子级结果。
扩散模型的模式更尖锐。group norm 达到 1.699×,layer norm 为 1.049×,SiLU 为 1.052×,interpolate 为 1.445×,pad 为 1.409×,embedding 为 1.009×。可是 group norm、layer norm 和 SiLU 合计只占 10.48% 的捕获时间。真正的大头是 linear 的 53.40% 与 scaled dot-product attention 的 27.12%,二者合计 80.52%,而它们的生成候选分别只有 0.495× 和 0.021×;conv2d 也只有 0.299×,占 2.55%。
注意力只有 0.021×,是全部结果里最刺眼的数字。它说明在一个已经使用高度优化 SDPA 的扩散模型里,让 LLM 从零写 attention 内核,五十轮搜索也很难接近框架实现。论文没有把这个失败藏起来,而是用 guard 把它挡住。对读者而言,这比再报一个漂亮加速更有信息量:系统的价值不只是“找到快的”,也包括“知道什么时候不该用自己找到的”。
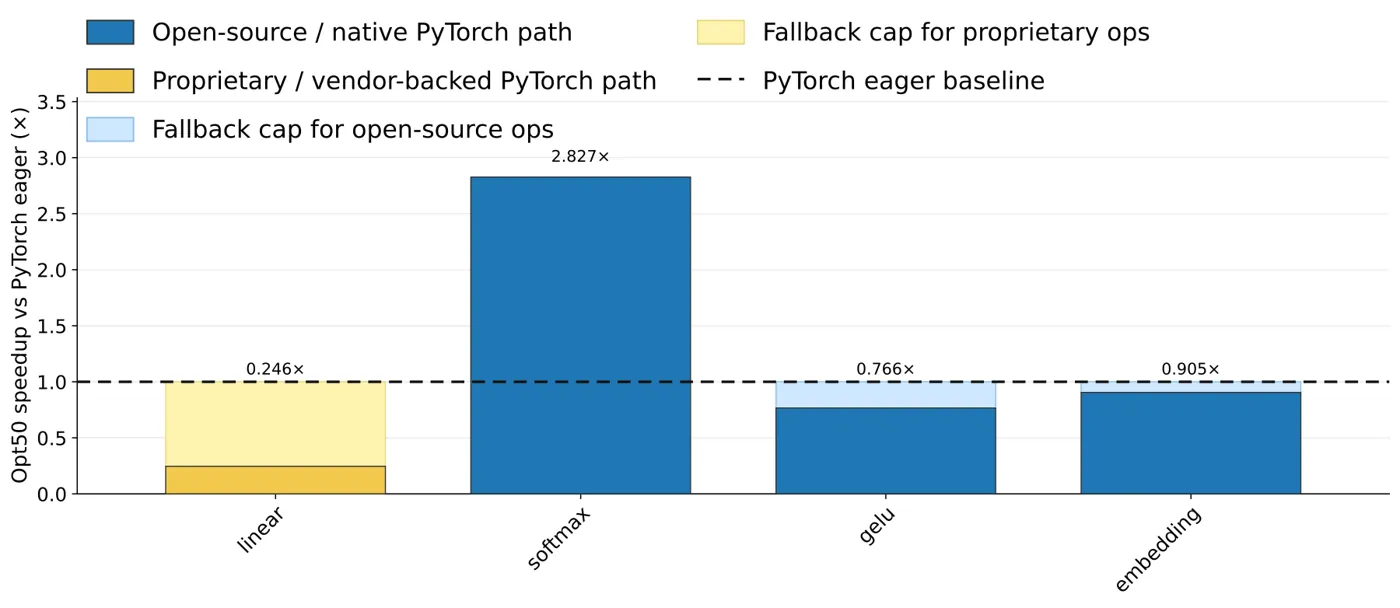
图4(论文 Figure 5):Gemma 4 E2B 在 opt50 下的算子级结果。
Gemma 4 E2B 的结果把错位推到极端。softmax 达到 2.827×,是全文最高的局部加速,但只占 5.93% 的运行时间;linear 占 90.13%,生成候选只有 0.246×,gelu 为 0.766×,embedding 为 0.905×。最终可以安全启用的是 softmax,模型的绝大部分时间仍然走 eager。标题里的 2.83× 是真实的算子级数字,但它不等于 Gemma 端到端快 2.83×,也不等于整体快 5.93%——因为 softmax 只是捕获区域的一部分。
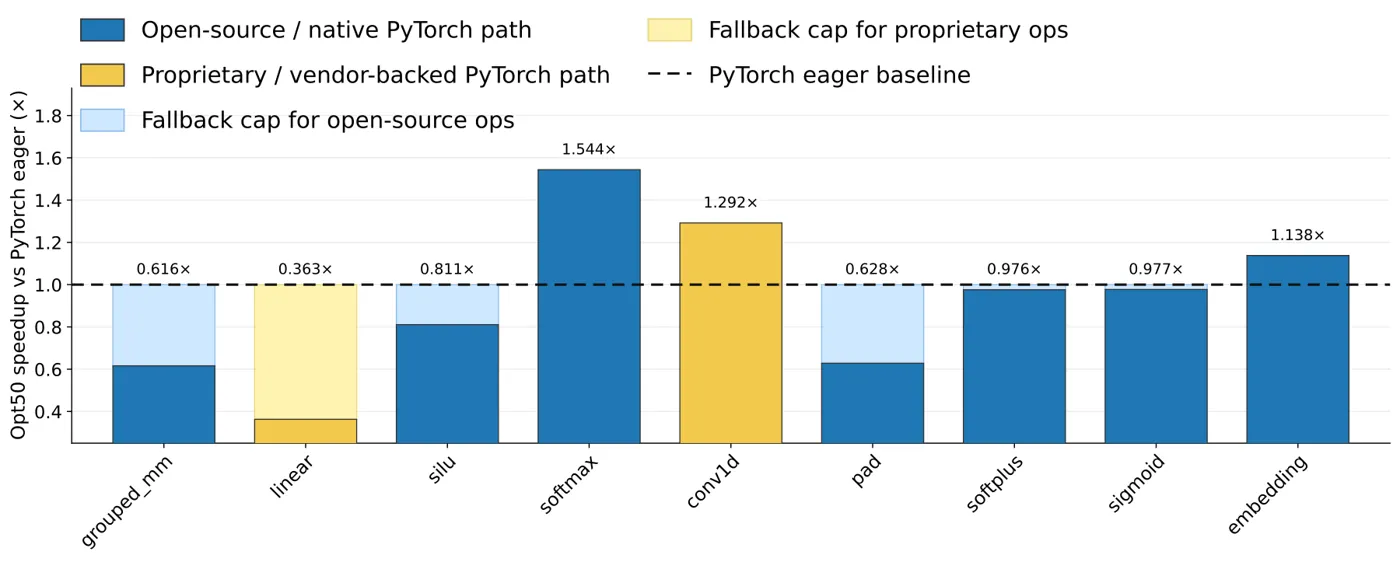
图5(论文 Figure 6):Qwen 3.5 35B-A3B 在 opt50 下的算子级结果。
Qwen 3.5 35B-A3B 的结构类似:softmax 为 1.544×(占 0.19%),conv1d 为 1.292×(占 0.40%),embedding 为 1.138×(约 0.002%);grouped matrix multiplication 占 93.62%,只有 0.616×,linear 占 4.98%,只有 0.363×。softplus、sigmoid、pad 和 SiLU 都在 1.0× 以下或附近。guarded policy 再次只放行少数小算子,把绝大多数时间留给厂商实现。
| 工作负载 | 算子 | opt50 speedup | 捕获运行占比 | 路径 |
|---|---|---|---|---|
| ResNet-50 | tensor add | 1.257× | 13.71% | native |
| ResNet-50 | ReLU | 1.004× | 11.90% | native |
| ResNet-50 | max pooling | 1.212× | 1.63% | native |
| ResNet-50 | adaptive avgpool | 1.515× | 0.12% | native |
| ResNet-50 | conv2d | 0.999× | 53.35% | wrapper/backend |
| SD3.5 Medium | group norm | 1.699× | 与 layer norm/SiLU 合计 10.48% | native |
| SD3.5 Medium | linear | 0.495× | 53.40% | proprietary |
| SD3.5 Medium | SDPA | 0.021× | 27.12% | proprietary |
| Gemma 4 E2B | softmax | 2.827× | 5.93% | native |
| Gemma 4 E2B | linear | 0.246× | 90.13% | proprietary |
| Qwen 3.5 35B-A3B | softmax | 1.544× | 0.19% | native |
| Qwen 3.5 35B-A3B | conv1d | 1.292× | 0.40% | native |
| Qwen 3.5 35B-A3B | grouped matmul | 0.616× | 93.62% | proprietary |
表2:论文 Figure 3–6 中与正文对应的关键算子。speedup 为生成候选相对同变体 PyTorch eager 的比值;占比为捕获算子区域内的运行时间权重。
汇总统计更能说明分布:opt50 展示的 24 个 open-source/native 算子中 13 个快于 eager,9 个 proprietary/vendor-backed 算子中只有 1 个快于 eager。这个差异与“成熟库路径更难被从零生成的内核打败”一致,但论文没有把它上升为不可能性证明;它只是说,在当前的模型、硬件和 50 轮预算下,胜率呈现这样的结构。
十、搜索成本:opt50 花得更多,但不一定花在刀刃上
论文记录每个搜索臂的 Opus 4.7 API 开销,并分别给出增量成本与累计成本。设输入 token 数为 $T_{\mathrm{in}}$、输出 token 数为 $T_{\mathrm{out}}$,按论文使用的价格,单次调用成本为
$$c=5\cdot\frac{T_{\mathrm{in}}}{10^6}+25\cdot\frac{T_{\mathrm{out}}}{10^6}. \tag{8}$$
结果显示 opt50 的成本明显抬升,因为它比早期臂多出大量生成与修复尝试。成本上升并没有被运行占比加权收益同步抵消:最大的局部加速往往落在低占比算子上,而高占比算子又常由成熟库占据。论文随后把统计限制在至少占 1% 运行时间的算子上,趋势仍然存在——后段预算占总支出的很大一部分,但未必改变聚合结果。
这不是“搜索无用”的结论,而是“统一预算不对齐部署影响”的结论。一个更合理的策略是按运行占比与基线强度分配预算:低影响算子早停,高占比且基线可挑战的算子多给轮次,连续多次无法接近 eager 时停止。论文把这点写进展望,而不是事后用结果拟合出一个更漂亮的故事。
十一、代码对应:论文里的每个部件都能在仓库里找到落点
Kernel Forge 不是只有架构图的原型。仓库中的 MCTS 控制器在 src/optimizer/core/mcts.py,节点结构与 UCT 打分在 src/optimizer/core/types.py;progressive widening 的指数、停滞阈值和探索常数在 src/optimizer/config/settings.py。树持久化到每个项目的 nodes.db,节点表保存源码、访问次数、中位延迟、子树最佳值和阶段。
摄取与重放在 src/optimizer/benchmarking/profile_project.py;CUDA 编译、运行和 allclose 校验在 src/optimizer/backends/cuda/verifier.py;量化路径的容差与 TinyGEMM ABI 在 src/optimizer/quantized.py。导出策略在 paper_benchmarks/paper_bench/cast_export.py,包格式在 docs/FileFormat.md,生成器对“不要转交 wrapper”的硬约束在 src/generator/prompts/GeneratorSystemPrompt.md。这些文件让论文的“guarded”“audit”“persistent tree”不再是抽象形容词。
| 论文部件 | 仓库落点 | 关键实现 |
|---|---|---|
| 模型摄取与变体捕获 | src/optimizer/benchmarking/profile_project.py | dispatch hook;unique_case 去重;保存输入输出与元数据 |
| CUDA 生成约束 | src/generator/prompts/GeneratorSystemPrompt.md | 单一 kernel.cu;launch wrapper;禁止转交后端库 |
| 编译与数值校验 | src/optimizer/backends/cuda/verifier.py | nvcc / load_inline;修复回路;torch.allclose |
| 量化容差 | src/optimizer/quantized.py | 默认 $10^{-2}/10^{-1}$;TinyGEMM 专用 ABI 与容差 |
| MCTS 控制 | src/optimizer/core/mcts.py、types.py、config/settings.py | SQLite 树;progressive widening;最小化 UCT;停滞跳过 |
| 打包与导出 | paper_benchmarks/paper_bench/cast_export.py、docs/FileFormat.md | auto_best_fastest_valid;.cast ZIP;校验和与审计标签 |
表3:论文方法与开源实现的对应关系,均来自本轮对仓库源码的阅读。
十二、方法流程一图看清
flowchart LR
    A["PyTorch model
weights + sample inputs"] --> B["Forward run
dispatch hook"]
    B --> C["Captured calls
shape / dtype / stride / args / output"]
    C --> D["Runtime-compatible variants"]
    D --> E["Operator cards
calls / eager time / runtime share"]
    E --> F["Generator agent
CUDA source + launch wrapper"]
    F --> G["nvcc compile"]
    G -->|"failure"| H["Bounded repair loop"]
    H --> G
    G -->|"success"| I["Run on captured inputs"]
    I -->|"crash or mismatch"| H
    I -->|"allclose passes"| J["Benchmark against eager"]
    J --> K["Persistent MCTS tree
widening + UCT"]
    K -->|"select parent + lineage"| F
    K --> L["Export .cast
source / ABI / validation / timing / audit"]
    L --> M{"valid and compatible
and faster"}
    M -->|"yes"| N["Dispatch generated CUDA"]
    M -->|"no"| O["Fallback to PyTorch eager"]
这张图里没有“一次性生成全部 kernel”的捷径。每个变体都要单独走编译、验证、计时和搜索;每个导出包都要在运行时重新判断是否满足替换条件。Kernel Forge 的“端到端”指的不是一次点击优化整个模型,而是把从模型执行到安全调用的每一段都接起来,并且允许某些段选择不做替换。
十三、局限:作者承认的边界与本文的判断
第一,验证是 workload-specific filter,不是正确性证明。候选只在捕获的输入、dtype 和参数上匹配 eager 输出;换一个 batch size、换一种 padding、换一个序列长度,行为可能就变了。论文在 3.3 节明确写出这一点,guarded dispatch 也只能在“捕获调用模式兼容”的范围内成立。
第二,结果是 operator-region measurement,不是端到端加速。论文没有报告整模型延迟的下降,也没有把算子级 speedup 按运行占比合成一个端到端数字。原因很实际:替换会改变内存布局、kernel launch 次数、同步点和缓存行为,算子级收益未必线性叠加。读者不能把 2.83× 直接写进“Gemma 快 2.83×”的标题。
第三,固定每算子预算与部署影响不匹配。opt50 对所有变体一视同仁,但高占比算子往往打不过成熟库,低占比算子即使大幅提升也难改变整体。论文自己指出应引入运行占比与基线强度感知的预算策略;这意味着当前结果更像“上限探测”,而不是成本最优的生产方案。
第四,实验覆盖有限。所有结果来自一张 GB10(sm_121)、四个模型、推理场景、固定输入集和单一 LLM。没有训练、多卡、动态 shape、长上下文或不同 GPU 架构的验证。MCTS 的超参数($C=1.0$、0.5→0.3 退火、1000 次根访问、停滞阈值 10)也没有做消融,因此论文不能声称这套搜索策略优于线性 refinement 或 beam search;它只展示了这套组合在本文设置下可用。
第五,审计与安全边界仍然有限。系统用标签区分生成 CUDA、wrapper/backend 和 fallback,但标签来自导出流程,不是对任意运行时的形式化保证。生成代码仍可能在未捕获输入上越界、泄漏或产生错误结果;guarded dispatch 降低了风险,但没有把“LLM 生成的 CUDA”变成可信执行环境。
十四、结论:把“更快”放回“可用”的约束里
Kernel Forge 的贡献不只是让 LLM 写 CUDA。它把真实模型执行、算子变体、数值校验、搜索树、打包和回退串成一条可审计链路,并用四个不同模态的模型证明这条链路能跑通。最重要的结果不是某个 2.83×,而是结果呈现出的结构:生成内核更容易在原生、低占比算子上赢;高占比算子通常由成熟库把守;guarded dispatch 让系统在赢不了时退回 eager,而不是把回归推给用户。
对机器人或具身智能系统而言,这个思路有直接的借鉴价值。感知、规划、控制链路里同样存在大量形状固定、调用频繁的算子;端侧 GPU 的库覆盖又不如数据中心完整。真正可用的优化工具需要知道哪些调用来自真实轨迹、哪些输出必须逐值对齐、哪些候选只能在特定传感器输入下启用。Kernel Forge 给出的不是“让模型自动写 kernel”的口号,而是一套把这些约束写进系统结构的工程模板。
金句
“The largest local speedups often occur on operators with small runtime contribution, while dominant operators are frequently backed by mature framework or vendor implementations.”
局部加速最大的地方,往往不是模型真正花时间的地方;而真正花时间的地方,通常已经站着最强的库实现。Kernel Forge 的价值,是让这句话变成可测量、可回退、可审计的系统行为。