P-BFM:感知行为基础模型实现人形机器人地形自适应控制
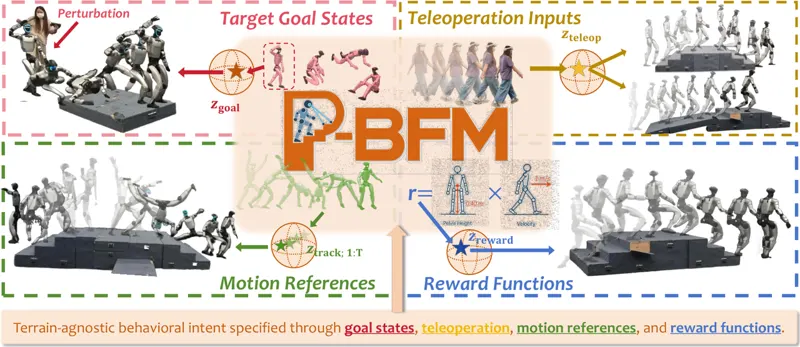
P-BFM 用无监督 RL 把动作参考、目标状态与奖励函数统一编码进地形无关的意图空间,一个冻结策略凭深度感知在不同地形实现同一意图;配合显式根部指令 ERI,零样本迁移到 Unitree G1,未见动作恢复率 61.4%。
Xue Wang, Yitang Li, Yiming Zhang · 17次阅读 · 2026年10月11日
人形机器人Unsupervised Reinforcement LearningForward-Backward Representation2026年10月11日