VLAct:表示中心的VLA继续预训练
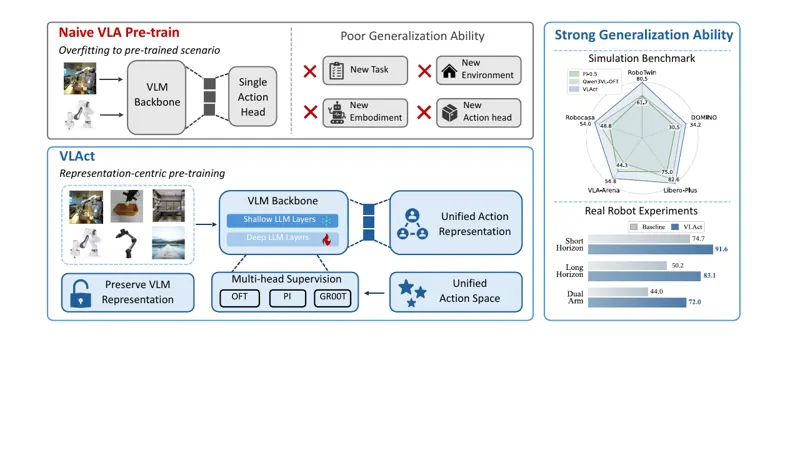
VLAct 将 VLA 继续预训练重新定义为表示学习:以 Qwen3-VL-4B 为基座,在 DROID、InternA1、RoboCoin、MolmoAct 等全开源多本体机器人数据上继续预训练,用冻结视觉编码器与下半 LLM 的浅层保护加字幕混合保留 VLM 先验,用 OFT、PI、GR00T 三个连续动作头协同监督避免表示坍缩到单一扫码几何,并以 20 维部分统一动作空间(共享夹爪维、掩码非活跃维)与周期关节 wrap-aware 损失对齐跨本体动作语义。预训练组件在微调时全部丢弃、只留骨干。固定下游微调协议下,LIBERO-Plus 达 82.6%、VLA-Arena 54.8%、RoboTwin 2.0 达 92.5%、DOMINO 成功率 18.50,真机单臂与双臂全面超过未预训练基线;RoboCasa-GR1 人形本体仅用 20% 下游数据即超过全数据 GR00T-N1.6。全部结果仅用开源数据与 16 卡训练取得。
Senqiao Yang, Chengyao Wang, Yuxin Chen2026年8月27日
视觉语言动作模型Continued Pre-training跨本体2026年8月27日