WildAWM:为计算机使用智能体合成可执行世界与长程任务
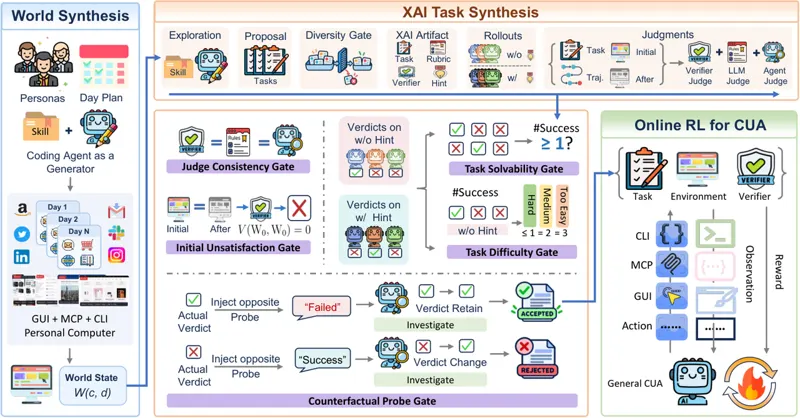
WildAWM 针对的痛点很具体:计算机使用智能体不缺模型,缺的是能让它反复试错的环境。在真实系统上直接做交互式学习既慢又有副作用,而现有合成环境的状态规模只有千级 token、任务也偏短。这篇工作把环境合成拆成两段:先由人格与日程驱动,生成 640 个可执行状态、中位 52.4K token 的世界(对照 CUA-Gym 的 1.1K),并配 83 个技能与 17.16 万条数据库记录;再用五道门禁(裁判一致性、初始未满足、可解性、难度、反事实探针)筛出 341 个长程任务,其中 273 个困难、68 个中等,平均 4.2 个子任务、3.1 次界面切换,74.5% 的任务需要重访同一界面。训练侧用 18 个模型-框架组合跑出每题 6 条轨迹,SFT 预热后接带自适应 rollout 与清单式奖励的 GRPO:4B 平均提升 8.21 分、35B 提升 10.58 分,而 GPT-6-Astra 在这套题上也只有约 60% 通过率。代价同样写得很清楚:单题合成约 6980 万输入 token(p90 1.309 亿),而按题目难度分箱后,最难的那四分之一(多为 OS-2 / ALE 上的超长任务)对所有变体都几乎没有增益,说明这套流水线抬高了中位难度,天花板还没顶开。
Zhaoyang Wang, Qianhui Wu, Haorui Wang · 9次阅读 · 2026年10月19日
Computer-Use Agent世界模型
2026年10月19日