DiscoveryRSI:递归学习发现有价值假说
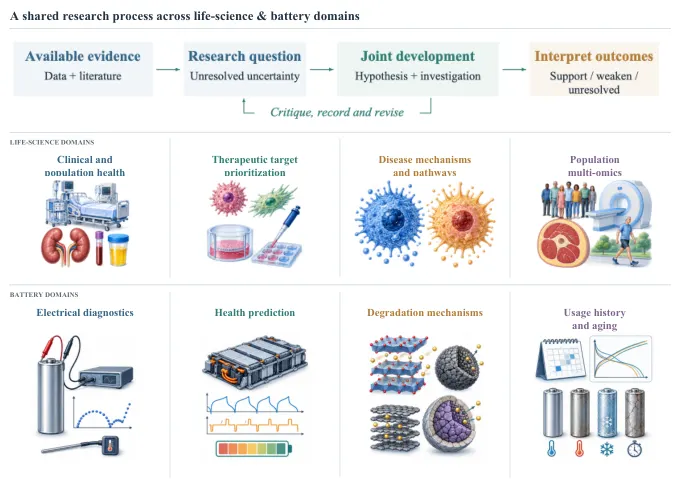
科学发现的难点不在生成想法,而在把值得做的假说发展成可执行的调查,并从这一过程中学习。本文先给出「有价值且可检验的研究假说」的操作性定义:有据可依的主张 + 可行的调查计划 + 明确的判定标准 + 替代解释。DiscoveryRSI 用多智能体进化搜索生长假说树,把选中的调查编译成可执行的 Harbor 任务,并通过三条互相咬合的机制递归自改进:假说信用优化把科学评估按文档化贡献归因成有界监督信号,harness 回放在冻结模型权重的前提下改进研究工作流,rediscovery 把被接受的更新放回新问题继续积累经验。配套的 DFM-Bench 在假说、修订、发展路径、研究轮与跨提案贡献五个层次评估质量与累积进展。四个生命科学域上,假说质量从基座模型的 4.86 升至两轮自改进后的 5.39,增益集中在可证伪性与数据可解性;专家盲评中 DiscoveryRSI-27B 在重要性与「主张可信且有证据边界」两项上高于 GPT-6 Luna;与模型 cutoff 之后发表研究的对应率为 6.3%,高于 GPT-6 的 2.5% 与 Claude Opus 5 的 2.3%。代码、27B 模型与基准均已开源。
Jianyuan Zhong, Chenwei Wu, Zhaochen Yu · 15次阅读 · 2026年10月16日
Scientific discoveryMulti-Agent Systems
2026年10月16日