MIT 许可、构建在 ggml 上的纯 C/C++ 推理实现,无任何依赖。17 个后端覆盖 CUDA/Metal/HIP/Vulkan/SYCL/WebGPU/CANN/Hexagon/MUSA/zDNN/ZenDNN;1.5-8 比特整数量化;CPU+GPU 混合推理让超出显存的模型也能跑;GGUF 是它输出的事实标准权重格式,连 vLLM 都直接吃。llama cli / llama serve 两行起一个 OpenAI 兼容服务。
Modly 是 Lightning Pixel 开源的图生 3D 网格桌面应用(Windows / Linux / Apple Silicon macOS,v0.4.3,MIT 加署名条款),用你自己 GPU 上的开源模型把一张照片变成可用网格,推理全程不出机器。架构是 Electron 壳托管绑定 127.0.0.1:8765 的 Python FastAPI 后端;默认模型 TripoSR(约 2.4GB),Hunyuan3D 2 Mini、TripoSG、Trellis2 GGUF 等以「GitHub 仓库 + manifest.json」的扩展形式安装,manifest 里声明多源权重 model_sources、共享权重 weight_groups,以及带 size_gb / vram_gb 的可分别安装量化档 weight_variants。生成流程用节点图工作流表达(Image → Generate Mesh → Add to Scene),场景走 modly.scene-manifest.v1 契约,导出支持 glb/stl/obj/ply,并为 OrcaSlicer 单开一条带毫米缩放的 stl/obj 打印路径。对外还给了三条 agent 通路:stdlib-only 的 JSON-first CLI(仓库自带 SKILL.md)、暴露 9 个 modly_* 工具的 MCP server、以及可跑本地 llama.cpp GGUF 池或外部模型端点的应用内工具调用 agent。AMD ROCm 自动检测、Apple Silicon 内存预算串行工作流与 Jetson headless 运行都附有实测数据的文档。
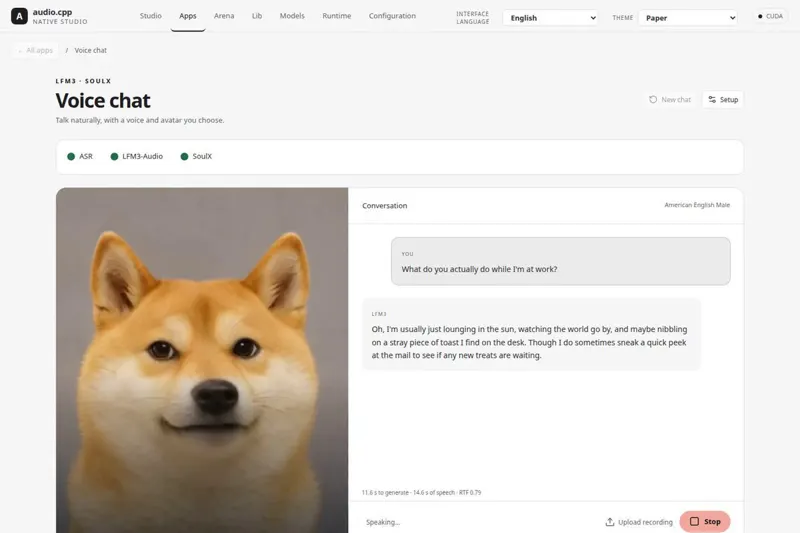
基于 ggml 的纯 C++ 音频推理框架,把 TTS、声音克隆、语音转换、语音识别、说话人分离、VAD、源分离、音频编解码与音乐生成等 110 多个模型族收进同一套原生运行时,后端覆盖 CUDA、HIP、Vulkan、Metal 与纯 CPU,入口有 CLI、OpenAI 风格服务、内嵌 WebUI 与 JSON 流水线;同机对拍 Python 参考实现,多条 TTS 路径快 1.8 到 5 倍,Q8 量化包最高降低 37% 峰值显存。
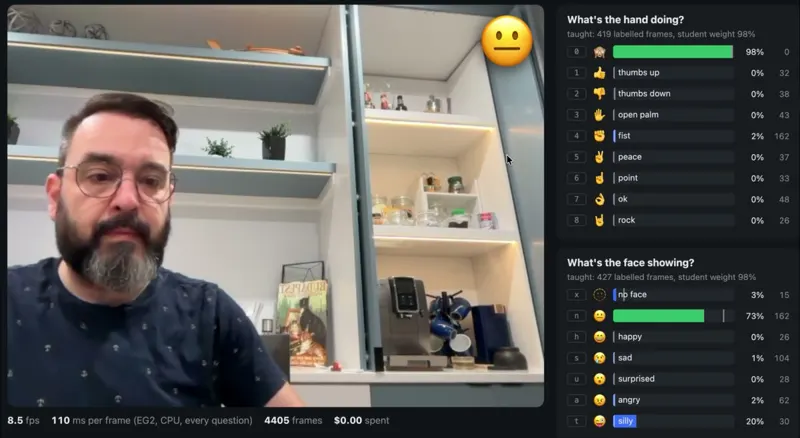
Hunch 先复用精确答案,再用 EmbeddingGemma 2 驱动的单问题学生处理熟悉状态;陌生、不确定或未毕业的判断交给教师模型,并由后台审计持续校准。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。

 0:42