
XBot-Omni:面向具身理解与交互的全模态模型
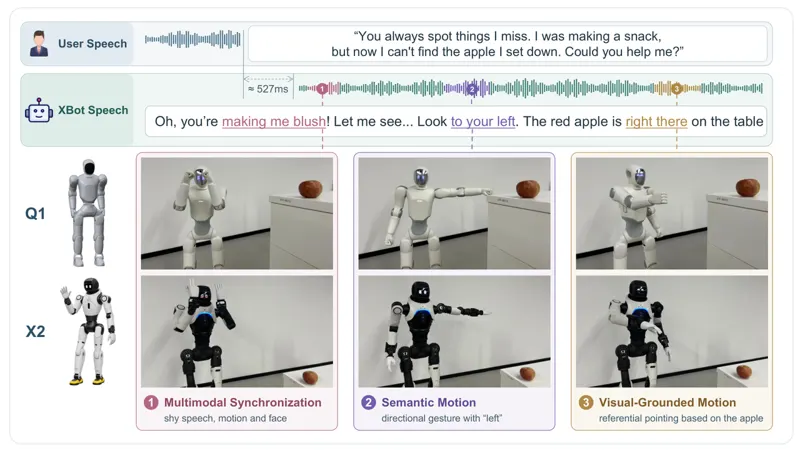
XBot-Omni 是面向具身理解与交互的全模态模型,采用 Thinker–Talker–Actor 三层架构。Thinker 统一处理文本、图像、音频和视频,Talker 以流式方式生成语音,Actor 直接利用二者的原生内部表示,同步生成身体动作与面部表情,并通过语义事件控制、语音—动作对齐和视觉指向训练,把场景理解转化为可执行的非语言表达。模型在七个基准上评估,在 Daily-Omni 达到 86.30%,在 ReTurn 达到 84.00%,语义动作质量显著高于已有动作生成方法;项目页目前只提供展示与视频,尚未发布公开模型代码。
Kerui Gu, Xing Fu, Shuoyang Sun · 21次阅读 · 2026年11月12日
具身智能Omni-Modal Model
2026年11月12日