PAPER DEEP DIVE
XBot-Omni:面向具身理解与交互的全模态模型
XBot-Omni 是面向具身理解与交互的全模态模型,采用 Thinker–Talker–Actor 三层架构。Thinker 统一处理文本、图像、音频和视频,Talker 以流式方式生成语音,Actor 直接利用二者的原生内部表示,同步生成身体动作与面部表情,并通过语义事件控制、语音—动作对齐和视觉指向训练,把场景理解转化为可执行的非语言表达。模型在七个基准上评估,在 Daily-Omni 达到 86.30%,在 ReTurn 达到 84.00%,语义动作质量显著高于已有动作生成方法;项目页目前只提供展示与视频,尚未发布公开模型代码。
一句话总结
XBot-Omni 把多模态理解、流式语音生成和语义受控的肢体动作放进同一个“思考者—说话者—行动者”链路,让机器人不只回答“说了什么”,还尝试同步表达“怎样说”和“指向什么”。
开源状态:截至本次精读,项目页仅显示“Coming Soon”,公开的 GitHub 仓库只是站点占位页,没有模型代码、权重、训练配置或推理接口。因此本文不声称完成源码核验,也不能从公开材料复现实验结果。下文讨论的是论文公开描述的方法、数字和工程含义。
研究背景与问题定义
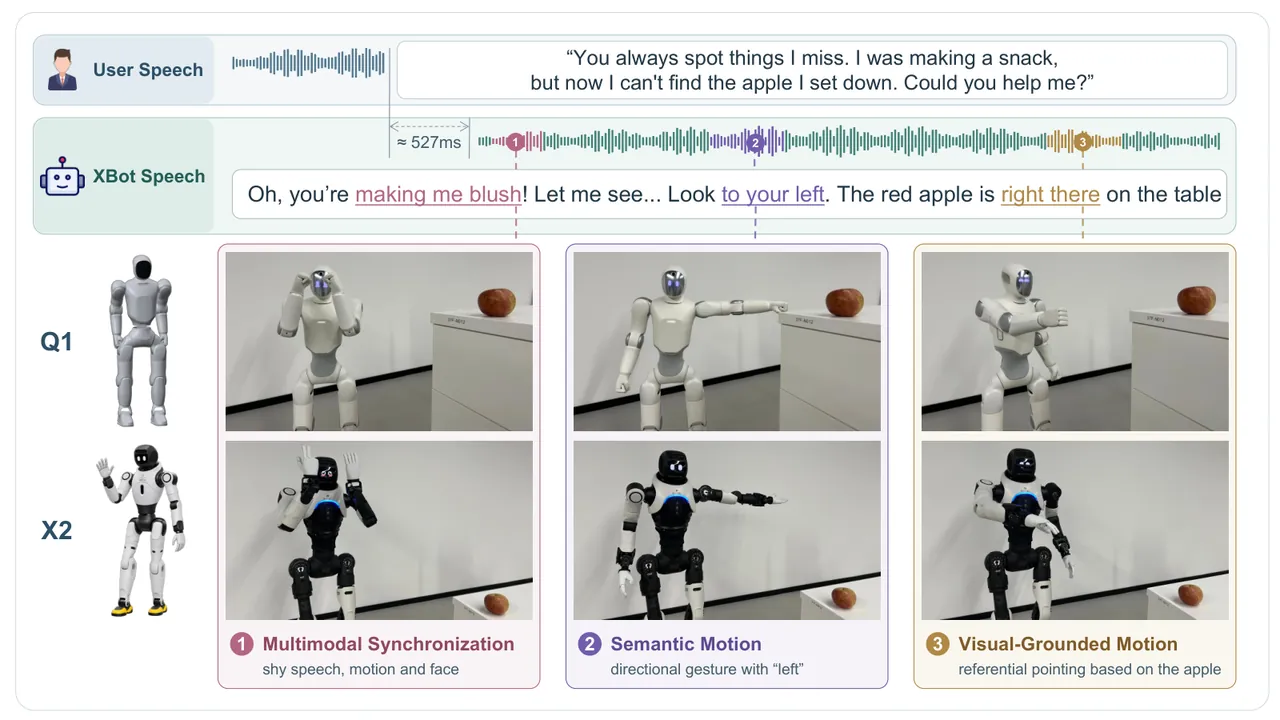
具身交互与普通的音视频问答有一个关键差别:回答并不止于一段文字或一段语音。一个人说“把左边那个红色的杯子递给我”时,听者会同时调动对话历史、说话者意图、场景物体位置和非语言线索;机器人若要自然回应,还需要让语音、目光、身体姿态和指向动作共享同一条时间线。XBot-Omni 的问题设定正是把这条链从“理解输入”延伸到“组织机器人可执行的表达输出”。
现有全模态模型已经把文本、图像、音频和视频放进统一模型。Qwen3.5-Omni、Gemini 3.1 Pro 一类系统能够理解跨模态内容并生成语音,但它们的主要输出仍是文本与声音。另一侧的动作生成研究,例如共语手势模型,擅长从语音节律或语言语义生成身体动作,却通常把动作视为语音之后的附属模块。两类系统的边界刚好落在本文要处理的交汇处:语义来自多模态理解,动作又要与正在生成的语音同步。
常见的级联方案先让理解模型生成回复,再把合成语音交给音频驱动动作模块。这个方案工程上清晰,但有两层信息损耗。第一,语音波形只保留已经说出口的内容,原回复中隐含的意图、视觉指代和场景关系可能没有被完整表达;第二,动作模块必须等待波形释放并重新提取声学特征,流式生成时会产生额外延迟。论文因此选择直接复用 Talker 在波形解码前的内部状态,而不是等语音变成音频后再猜一次。
另一个问题是显式语义控制。自然共语手势需要逼真,但机器人交互还要求手势在正确的时间表达正确的意思。例如指向动作既要知道“指向什么”,也要知道这个指代对应回复中的哪个短语。XBot-Omni 将 Thinker 的多模态语义表示接入 Semantic Action Controller,把动作类别、参与手、持续时间和目标位置组织成事件条件,再由 Speech–Action Aligner 将这些事件放到语音时间轴上。
论文的核心主张可以概括为三点:用原生内部状态减少级联损耗;用显式语义事件连接理解与动作;在一条流式响应链中协调语音、身体和面部输出。它没有声称已经解决机器人全部具身智能问题,而是提出一个可扩展到机器人特有模态的架构骨架,并用视觉问答、多轮指代、动作质量和指向任务分别检验链路中的不同能力。
总体架构
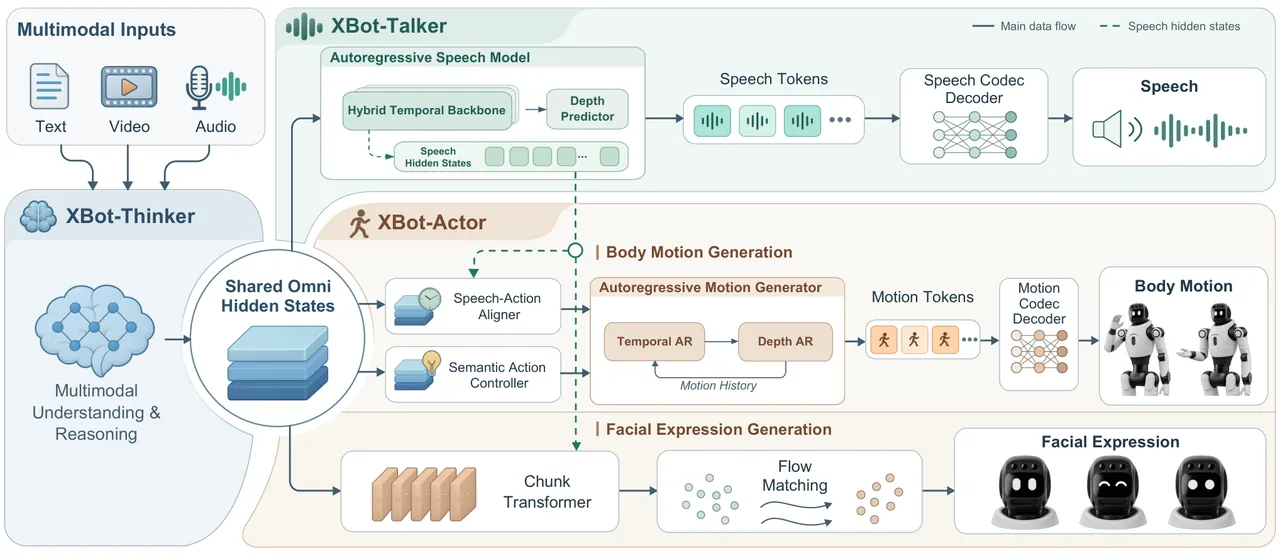
系统由 Thinker、Talker 和 Actor 三部分组成。Thinker 接收文本、图像、音频、视频和对话历史,形成上下文响应;Talker 将响应转成流式语音;Actor 读取 Thinker 的语义状态与 Talker 的演化语音状态,生成身体动作和面部表情。三者没有简单串成“理解—文本—动作”,而是共享两类原生表示,使语义和语音进度可以在生成过程中传给 Actor。
Thinker 的多模态编码不是本文最激进的创新,但它提供两个关键上下文:回复语义与场景指代。Talker 除了生成语音 token,还显式暴露解码器内部隐藏状态;Actor 的动作生成器因此可以在波形尚未完成时获得连续的语音条件。这个设计也解释了论文为何反复强调“native representations”:Actor 读取的是上游生成过程的状态,而不是重新编码后的音频副本。
flowchart LR
    IN["Text image audio video
and dialogue history"] --> TH["Thinker
multimodal reasoning"]
    TH --> SEM["Response semantics
and visual referents"]
    TH --> TK["Talker
autoregressive speech"]
    TK --> SP["Streaming speech tokens"]
    SP --> CODEC["Speech codec decoder"]
    TK --> NAT["Native Talker hidden states"]
    TH --> SAC["Semantic Action Controller"]
    NAT --> ACT["Actor motion conditioning"]
    SAC --> EVT["Gesture events
meaning and timing"]
    EVT --> ACT
    ACT --> MG["Motion Generator"]
    MG --> BODY["Body motion tokens"]
    BODY --> IK["X2 or Q1 kinematic adapter"]
    TH --> FACE["Chunk Transformer"]
    NAT --> FACE
    FACE --> FLOW["Conditional flow matching"]
    FLOW --> EXPR["Facial expression sequence"]
    CODEC --> OUT["Speech"]
    BODY --> OUT
    EXPR --> OUT
这张流程图对应论文实际的数据路径:Thinker 不只是提供一个文本答复;它还把语义上下文送到动作控制器。Talker 不只是输出声音;它在解码前把隐藏状态送到动作模型。Actor 则同时接收事件语义、语音进度和自身历史,这与把动作生成器接在语音文件之后的级联结构有明显区别。
Thinker:全模态理解与时间定位
Thinker 按模态建立输入通路后汇入统一序列。文本使用主干分词器;图像和视频帧经过视觉编码器;音频被重采样并转换为梅尔频谱,再由初始化自 Qwen3-Omni 的 AuT 处理,并通过轻量投影器映射到主干表示空间。这个描述意味着模型并没有把每种模态都压成独立任务,而是在共享上下文中解析“谁在对谁说什么、画面里对应哪个对象”。
视频和音视频输入采用绝对文本时间戳。每个时间片段前会加入以秒为单位的文本标记,使模型看到明确观测时刻,而不只依赖随帧率变化的位置索引。对于需要判断事件先后、共语关系和指代变化的具身交互,这种显式时间信息比单纯的序列位置更直接。论文将时间戳同时用于声学和视觉片段,为后续动作对齐提供共同参照。
Thinker 的训练分三段。第一段用多模态指令数据做监督微调,建立理解、时间推理、说话人和目标人判断等基础能力;第二段按任务训练多个 GRPO 专家;第三段用多教师在线策略蒸馏把专家能力合并到一个学生策略中。这个训练组织说明论文并不试图让单一 SFT 模型同时承担所有具身任务,而是先让不同任务拥有专门策略,再在共享参数里整合。
多教师蒸馏的目标不是简单拟合专家输出,而是在学生自己访问到的前缀上获得专家监督。设任务域为 $k$,学生从任务混合分布中采样输入 $x$,再按当前策略生成回复轨迹 $y$。对每个学生访问到的前缀,对应冻结专家给出下一 token 分布,学生最小化 reverse KL:
$$ \mathcal{L}_{\mathrm{MOPD}}(\theta)= \sum_{k=1}^{K}\alpha_k \mathbb{E}_{x\sim\mathcal{D}_k} \mathbb{E}_{y\sim\pi_\theta(\cdot\mid x)} \left[ \frac{1}{|y|}\sum_{t=1}^{|y|} D_{\mathrm{KL}} \left( \pi_\theta(\cdot\mid x,y_{<t}) \middle\| \pi_{\phi_k}(\cdot\mid x,y_{<t}) \right) \right]. $$
其中 $\alpha_k$ 是任务域采样概率,$\phi_k$ 是冻结的专家参数,$\theta$ 是可训练学生参数。公式的关键是“on-policy”:监督发生在学生自己生成的轨迹上,能覆盖推理时会遇到的错误前缀。它并不保证各专家的能力在合并后完全无损,但比只对标准答案做监督更贴近部署时的自回归状态分布。
Talker:在波形之前暴露语音条件
Talker 采用自回归流式语音生成结构,主干以混合专家方式推进语音 token,深度预测器在每一帧的残差码本上做多 token 预测,最后由语音编解码器逐步解码波形。对动作模型而言,真正有价值的不是最终 PCM 样本,而是语音尚未完全合成时的演化表示。论文把这些隐藏状态直接暴露给 Actor,使身体动作不必等待完整音频生成。
这条接口路径需要谨慎理解。它减少了“波形释放—重采样—音频编码”的显式等待,但并不自动保证零延迟,也不意味着动作和语音在物理上已经严格同步。Actor 仍需要推断语音进度、将语义事件映射到说话位置,并在运动历史约束下连续生成动作。论文报告的 527 ms 首次动作延迟来自展示场景,不能替代对完整延迟分布、抖动和最坏情况的系统评测。
从工程角度看,原生状态共享提出了一种比 API 级级联更紧的集成方式:语音模型和动作模型可以在同一生成时钟内交换状态。代价是两者形成较深的表示耦合,任何 Talker 升级、量化或蒸馏都可能改变 Actor 的输入分布;论文公开材料没有提供这种耦合在替换主干后的稳定性实验。
Actor 的身体动作生成
设 Thinker 的原生状态流为 $H^{\mathrm{th}}=\{h_i^{\mathrm{th}}\}$,Talker 的原生状态流为 $H^{\mathrm{sp}}=\{h_n^{\mathrm{sp}}\}$。循环因果适配器把语音状态映射到动作条件空间,动作生成器在每一步根据已生成动作、可用的语音条件和当前语义事件预测离散动作码:
$$ p_\theta(Z\mid H^{\mathrm{sp}},U) =\prod_t p_\theta\left(z_t\mid z_{<t},e_{\le t},U_t\right). $$
这里 $z_t$ 是一组离散动作码,$e_{\le t}$ 是截至当前动作步可用的适配语音状态,$U_t$ 汇集活动动作事件及其时间条件。若事件涉及指向,$U_t$ 还包含目标在 Actor 体坐标系中的位置。生成动作码既可以解码为关节轨迹,也会成为下一步动作历史的一部分,因此新事件能够插入正在进行的运动,而不必切断整个序列重新开始。
Semantic Action Controller 负责把 Thinker 中的交互意图转换为显式事件。每个事件 $e$ 包含手势类别 $y_e$、语义参数 $a_e$、可用掩码 $m_e$ 和对应文本片段。事件条件向量可写为:
$$ c_{e,t} =\left[ \phi_y(y_e); \phi_a(a_e\odot m_e,m_e); \phi_\tau(b_{e,t},\delta_{e,t}) \right]. $$
其中 $\phi_y$ 编码手势类别,$\phi_a$ 编码参与手、方向或三维目标等语义属性,$\phi_\tau$ 编码开始信号与经过时间。掩码让缺失属性不会被误当成零值语义。这个接口把“做一个手势”和“这个手势在表达什么”拆开:动作生成器学习怎样运动,控制器决定当前需要表达什么。
论文采用加性条件调制,使多个同时活跃的事件可以叠加。设空条件为 $c_\emptyset$,当前活动事件集合为 $A_t$,则语音特征上的调制参数和结果为:
$$ (\gamma_t,\beta_t) =g(c_\emptyset) +\sum_{e\in A_t}\left[g(c_{e,t})-g(c_\emptyset)\right], \qquad \tilde v_t=(1+\gamma_t)\odot v_t+\beta_t. $$
这相当于以空条件为基线,把每个事件带来的偏移相加。它的优点是不必为任意事件组合枚举训练样本,也能让多个语义要求共同影响动作;局限是事件之间若存在物理冲突,例如双手指向相反目标,单靠加性条件并不能显式求解优先级,仍需控制层或训练数据覆盖冲突情形。
Speech–Action Aligner 估计回复文本位置与语音步之间的对齐。若位置分数为 $\ell_{n,i}=\alpha q_n^{\top}k_i$,前向递推可以写成:
$$ \pi_n(i) \propto \exp(\ell_{n,i}) \sum_r A_n(r,i)\pi_{n-1}(r). $$
它把当前位置的声学证据与从前面语音位置前进到当前位置的转移概率结合起来。对语义事件 $e$,系统再根据预测语音长度和期望动作时长安排执行窗口:
$$ \widehat T_e =\min\{T_n:n\in O,\widehat p_n\ge i_e\}, \qquad T_e^{\mathrm{start}} =\max(T_e^{\mathrm{next}},\widehat T_e-d_{y_e}). $$
这里 $\widehat p_n$ 是语音进度位置,$i_e$ 是事件关联的文本位置,$d_{y_e}$ 是手势类别的期望持续时间。系统希望在不晚于指代词出现时开始动作,同时避开上一事件尚未结束的重叠。实际效果受到语音进度估计、文本位置和动作时长误差的共同影响。
面部表情与协调输出
身体动作使用离散动作 token 自回归生成,面部表情走另一条连续生成路径。Chunk Transformer 将 Thinker 与 Talker 的状态组织为分块条件,再以条件流匹配生成面部序列。设目标面部块为 $F_j^\star$、高斯噪声为 $\epsilon_j$、条件为 $C_j$,插值状态和训练目标为:
$$ F_j(\tau)=(1-\tau)\epsilon_j+\tau F_j^\star, $$
$$ \mathcal{L}_{\mathrm{face}} =\mathbb{E}_{j,\tau,\epsilon_j} \left[ \left\| v_\eta(F_j(\tau),\tau,C_j) -(F_j^\star-\epsilon_j) \right\|_2^2 \right]. $$
这个损失让网络学习从噪声指向真实面部块的常微分方程速度场。身体和面部使用不同生成机制,却共享 Thinker 语义与 Talker 语音上下文,并被放到同一响应时间线。论文将这个组合视为协调输出,但没有单独量化身体—面部同步误差,也没有展示长时间多轮场景中的漂移统计。
数据与 Actor 训练
数据来自公开具身活动视频与私有的人—人、人—机器人交互记录。公开数据提供第一视角活动、物体操作、工具使用和程序性任务;私有数据补充自然对话、社交互动、协同活动、机器人辅助任务以及同步语音、环境声、动作和面部变化。论文强调的不只是模态数量,而是交互片段的时间连续性。
标注流程由智能体编排语音识别、说话人分离、物体检测与跟踪、动作识别和音视频事件定位等工具,将长录像切成保留上下文依赖的交互片段,再生成场景理解、音视频关系、时间推理和意图理解样本。最后通过跨模态一致性检查与原始录像证据核验过滤不可靠标注。该流程属于论文自述,外部无法检查提示词、工具版本、标注一致率和误差传播。
Actor 第一阶段把固定 Talker 的内部状态适配成动作条件。离线音频特征作为监督目标,在线推理则直接使用 Talker 状态。设适配器为 $A_\psi$,有效配对步集合为 $\mathcal V$,目标特征为 $e_n^\star$,归一化回归损失为:
$$ \mathcal{L}_{\mathrm{adapt}}(\psi) =\frac{1}{|\mathcal V|d_e} \sum_{n\in\mathcal V} \left\| \frac{A_\psi(h_{\le n}^{\mathrm{sp}})-e_n^\star}{\sigma_e} \right\|_2^2. $$
其中 $d_e$ 是条件维度,$\sigma_e$ 是训练数据估计的逐特征标准差。Talker 与动作编解码器在此阶段冻结,适配器只学习把已有内部状态转换为动作可用的语音特征。这个设计将“语音表示是否保留动作信息”与“动作生成器是否能使用这些信息”分开训练。
对齐器使用离线声学对齐产生的文本位置标签,并按置信度加权。设来源集合为 $\mathcal S$,来源 $s$ 的语音步数为 $T_s$,目标文本位置为 $i_{s,n}^\star$:
$$ \mathcal{L}_{\mathrm{align}} =-\frac{1}{|\mathcal S|} \sum_{s\in\mathcal S}\frac{1}{T_s} \sum_{n=1}^{T_s}w_{s,n} \log P_{s,n}(i_{s,n}^\star). $$
第二阶段训练语义事件动作。给定参考动作 token $z_{t,k}^\star$、历史 $\mathcal H_{t,k}$、语音条件 $e_{\le t}$ 和事件条件 $U_t$,动作交叉熵按逻辑组进行平衡:
$$ \mathcal{L}_{\mathrm{motion}} =-\sum_{g\in\mathcal G}\frac{\alpha_g}{N_g} \sum_{(t,k)\in g}m_{t,k} \log p_\theta \left(z_{t,k}^\star\mid\mathcal H_{t,k},e_{\le t},U_t\right). $$
论文还分别预测动作核心完成与可释放概率,用平衡二元交叉熵监督。总目标为 $\mathcal L_{\mathrm{Actor}}=\mathcal L_{\mathrm{motion}}+\lambda_{\mathrm{comp}}\mathcal L_{\mathrm{comp}}$。第三阶段加入模型自己生成的历史,使训练分布包含自回归误差。设前一步生成 token 为 $\widehat z_{t,1:K}$,当前步较早码本仍使用教师强制:
$$ \mathcal{H}_{t,k}^{\mathrm{gen}} =\left(\widehat z_{t,1:K},z_{t,k}^\star\right). $$
这比始终使用完整参考历史更接近部署时的情况,但如果生成轨迹已经严重偏离,参考完成时间不再证明模型自己的动作真的完成。论文因此在生成历史上屏蔽无法合理解释的完成标签,并用自由运行解码和语义执行质量做开发集选择。
视觉接地与机器人指向
SGPT 把视觉指代接到动作事件。Thinker 先根据指令和画面确定目标,目标检测、深度估计和相机几何给出相机坐标系中的三维点,再通过外参变换到机器人身体坐标系:
$$ \widehat{\mathbf p}^{\,\mathrm{body}} =R_{\mathrm{cam}}^{\mathrm{body}} \mathcal P(\widehat g,\widehat D,K) +\mathbf t_{\mathrm{cam}}^{\mathrm{body}}. $$
这里 $\widehat g$ 是视觉接地结果,$\widehat D$ 是深度,$K$ 是相机内参,旋转与平移把相机点变换到 Actor 坐标系。该点成为语义参数 $a_e$ 的空间部分,对应指代表达则作为语音对齐锚点。若系统已经拿到直接三维坐标,也走同一条件接口。
在任务条件训练中,指向样本与自然共语动作混合。设 $\mathcal D_P$ 为指向演示,$\mathcal D_N$ 为自然动作,$\rho$ 为采样概率:
$$ \mathcal{L}_{\mathrm{PA}}(\theta_A) =\rho\mathbb E_{d\sim\mathcal D_P} \left[\mathcal L_{\mathrm{Actor}}(\theta_A;d,U^\star(d))\right] +(1-\rho)\mathbb E_{d\sim\mathcal D_N} \left[\mathcal L_{\mathrm{Actor}}(\theta_A;d,U^\star(d))\right]. $$
Thinker 和 Talker 在此阶段保持冻结,训练只更新 Actor 侧参数。推理时,视觉接地提供目标,动作生成器通过共享事件接口组织参考姿态,再由 X2 或 Q1 各自的坐标变换、运动学模型、指向轴标定和约束执行逆运动学。论文没有公开适配器代码与标定参数,因此这些平台相关步骤无法独立复现。
实验分析
论文共使用七个基准,覆盖音视频理解、多轮交互、近邻推理、具身推理、动作质量、空间定位和指向。不同实验并不共享同一输入接口:Thinker 测试以多模态问答为主;动作质量使用 BEAT2 语音和文本;指向实验使用公开空间手势片段和坐标条件。因此应把结果视为一组组件能力证据,而不是一个统一的端到端任务成功率。
Daily-Omni 检查 30 秒与 60 秒视频中的六类音视频理解。XBot-Omni 总体准确率为 86.30%,比 Qwen3.5-Omni-Plus 的 84.74% 高 1.56 个百分点。它在所有能力维度和两个时长组上都领先,最明显的优势来自音视频对齐与事件顺序。这说明 Thinker 的时间戳和具身数据训练可能改善了跨模态事件关系,但该基准仍是受控问答,不等同于机器人现场执行。
| Daily-Omni 指标 | XBot-Omni | Qwen3.5-Omni-Plus | 差值 |
|---|---|---|---|
| 总体 | 86.30 | 84.74 | +1.56 |
| 音视频对齐 | 87.39 | 84.42 | +2.97 |
| 事件顺序 | 86.60 | 83.95 | +2.65 |
| 30 秒组 | 84.39 | 83.41 | +0.98 |
| 60 秒组 | 88.55 | 86.36 | +2.19 |
ReTurn 更接近多轮交互:模型要在五轮对话中 reconfirm、reground、retrieve 和 rebind。XBot-Omni 的总体准确率为 84.00%,大幅高于 Doubao-Seed-2.1-Lite 的 70.04%。提升主要集中在 Reground 与 Rebind,分别达到 67.20% 和 88.48%,说明模型更能根据新轮次改变早先的物体解释。但它在 Reconfirm 上只有 87.20%,低于基线的 98.24%;Retrieve 也只有 93.12%,低于 97.28%。因此“总体领先”来自上下文更新能力,而不是每个子任务都更强。
| ReTurn 子任务 | XBot-Omni | Doubao-Seed-2.1-Lite | 解读 |
|---|---|---|---|
| 总体 | 84.00 | 70.04 | 提升 13.96 点 |
| Reconfirm | 87.20 | 98.24 | 低 11.04 点 |
| Reground | 67.20 | 29.60 | 提升 37.60 点 |
| Retrieve | 93.12 | 97.28 | 低 4.16 点 |
| Rebind | 88.48 | 55.04 | 提升 33.44 点 |
EgoProx 测试近邻意图、探索和利用,报告近似与相对距离判断。XBot-Omni 在意图、探索、利用上的准确率分别为 65.54%、62.57% 和 69.43%;其中利用场景的相对准确率为 57.72%,比最佳基线 57.86% 低 0.14 点。这一微小差距提醒读者,模型的空间优势并不自动覆盖所有以机器人为中心的距离判断。
ERIBench 的结果也呈任务分化。XBot-Omni 在意图推断上为 85.51%,低于 Qwen 的 91.45%;安全边界为 68.76%,空间关系为 59.17%,视觉接地为 69.81%。相较基线,安全、空间关系和接地分别提升约 6.51、20.99 和 2.27 点。空间关系的领先与 EgoProx、三维定位中的结果方向一致,但意图推断落后说明“理解场景关系”与“理解人的目的”仍是不同能力。
动作质量与语义时序
动作评测从 BEAT2 测试集读取 500 段转写,最终得到 499 个有效语音样本;语义动作集包含十个目标的 119 个有效短回复。流程一致性在统一身体表示中比较,基线使用相同语音或转写,XBot-Omni 使用对应原生状态。语义质量由视觉模型对匿名、静音、正面或斜侧动作视频打 0 到 3 分,再按目标均值汇总:
$$ \mathrm{SQ} =\frac{1}{|\mathcal C|} \sum_{c\in\mathcal C} \left( \frac{1}{|\mathcal I_c|} \sum_{i\in\mathcal I_c}q_i \right). $$
时序一致性只在实际表达清晰且具备有效语音对齐的样本上计算:
$$ \mathrm{CT} =\left( \frac{1}{|\mathcal E|} \sum_{i\in\mathcal E}h_i \right)\times100\%. $$
XBot-Omni 的 FGD 为 1.351,低于 EMAGE 的 1.389;总体 SQ 为 1.383,明显高于 Semantic Gesticulator 的 0.608。三个语义族中,方向、幅度、交互得分分别为 1.750、1.000 和 1.208。它首次达到清晰兼容表达的样本数为 54/119,其中 46 个时序正确,得到 85.19% 的 CT。
| 方法 | FGD 越低越好 | 总体 SQ / 3 | CT |
|---|---|---|---|
| EMAGE | 1.389 | 0.467 | 70.59%(12/17) |
| Semantic Gesticulator | 9.817 | 0.608 | 56.52%(13/23) |
| XBot-Omni | 1.351 | 1.383 | 85.19%(46/54) |
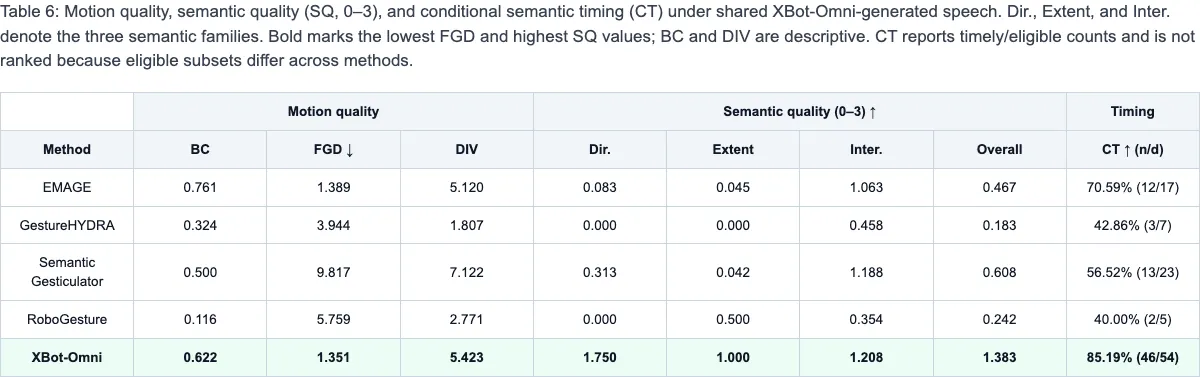
CT 的数字最容易被误读。54 是 XBot-Omni 自己有多少个输出达到“清晰兼容表达且可评估时序”的条件,46 是其中按时表达的数量;其他方法的可评估集合分别只有 5 到 23 条。论文明确说这不是整体交互成功率。更稳妥的解释是:在这套受控短回复和机器辅助评分协议下,XBot-Omni 产生了更多可识别、可评分的语义动作,并在这些样本上达到较高时序命中率。
空间定位与指向
TraceSpatial-Bench 以 20 厘米容差评估起始和结束位置的 2D/3D 定位。XBot-Omni 的三维起始与结束成功率为 67.00% 和 68.00%,比对应最强基线高 24 和 29 个百分点;二维成功率是 47.00% 和 53.00%,仍落后于二维最强基线。SUN RGB-D 的五类 mAP@0.25 为 35.04%,略高于最佳基线的 34.15%。结果说明优势集中在三维目标位置,而非通用二维检测。
指向实验从公开空间接地手势基准中选择 100 个高分开发片段。Score b 衡量空间准确率,Score a 衡量时间对齐,STG 是联合分数。加入 SGPT 后,Score b 从 0.357 升到 0.990,Score a 从 0.654 升到 0.851,STG 从 0.241 升到 0.843。空间指标接近人类参考 0.999,时间指标仍低于人类 0.985,但两者都已大幅改善。
| 指向设置 | Score b 空间 | Score a 时间 | STG 联合 | FGD | Beat Align. |
|---|---|---|---|---|---|
| 无 SGPT | 0.357 | 0.654 | 0.241 | 0.485 | 0.432 |
| XBot-Omni + SGPT | 0.990 | 0.851 | 0.843 | 0.498 | 0.423 |
| 人类参考 | 0.999 | 0.985 | 0.984 | 0.389 | 0.393 |
代价同样清楚:指向臂 FGD 从 0.485 升到 0.498,节拍对齐从 0.432 降到 0.423。Jerk 从 0.558 降到 0.530,速度多样性从 0.696 降到 0.650,更接近人类的 0.618。SGPT 显著改善了“指得准、指得对上话”的能力,却没有让所有动作自然度指标同向提升。这是空间约束进入动作生成后合理的权衡,也是论文数字中最值得工程团队关注的部分。
局限性
第一,作者明确承认语义 CT 使用各方法自己的可评估子集,因而不能视为统一配对比较或整体交互成功率;语义动作评价是机器辅助、受控短回复协议,也没有提供人类偏好结果。该问题不是计算错误,而是评测设计的外推边界:一个方法产生更多可评分样本,与它在所有样本上的成功率并不是同一件事。
第二,论文没有专门的 Limitations 章节,也没有公开代码、权重、训练配方、数据规模和关键超参数。项目页只有占位信息,GitHub 仓库没有实现。因此无法核查原生状态接口、动作编码器、X2/Q1 逆运动学适配器、数据过滤规则,也无法复现训练曲线或误差传播。对这类高复杂度系统,缺少实现会让“架构有效”和“工程可部署”之间留下很大空白。
第三,评测没有端到端闭环任务成功率。多模态理解、动作质量、空间定位和指向分别在各自基准上测量,却缺少同一机器人、同一场景、同一会话中的联合指标。例如 grounding 失败是否会被动作生成器吸收,语音延迟变化是否破坏语义时序,指向后物体交互是否成功,公开结果都没有回答。展示视频能说明系统可以运行,但不能替代定量部署测试。
第四,论文对失败模式覆盖有限。没有报告深度传感器误差、相机外参漂移、遮挡、多人同时说话、目标离开视野、动作冲突和长时间自由运行的统计。527 ms 首次动作延迟是一个展示场景的中位数,不足以描述尾延迟和抖动。机器人真实部署往往被这些长尾条件决定,因此该方法目前更适合作为研究框架与组件验证,而不是已证明可规模化部署的完整产品。
结论与展望
XBot-Omni 的主要贡献不是单独提高某一种模态分数,而是把“理解—说话—行动”的接口从文本和波形推进到原生隐藏状态与显式语义事件。Thinker 提供跨模态意图和场景指代,Talker 提供波形前的语音进度,Actor 将语义、时序、目标和动作历史统一到流式生成中。Daily-Omni、ReTurn、动作质量和指向实验分别证明了链路上的不同环节具有可测优势。
这项工作也暴露出下一阶段应补的证据:统一端到端任务评测、公开实现与可复现训练、不同深度和运动学误差下的鲁棒性、长时流式延迟分布、多事件冲突处理以及真人偏好研究。若这些缺口被补齐,原生表示共享会从有吸引力的系统设计进一步变成可比较、可维护的机器人交互基础设施。
机器人真正的“会交流”,不是先想完、说完再动,而是让语义、语音和动作在同一条时间线上彼此知道对方正在做什么。