PAPER DEEP DIVE
智能体式机器人操作策略研究
通用模型无需示范即可通过代码直接控制机械臂。AMP1在RoboLab-120零样本达到85.6%,真实机器人完成104/108次试验。
一句话总结
这项研究提出“智能体式操作策略”,让通用大模型持续留在控制闭环中,通过持久 Python 程序直接观察、规划和驱动机器人;参考实现 AMP1 在无需示范和任务微调的情况下取得 RoboLab-120 零样本 85.6% 成功率,并以持久记忆把 RoboDojo 成功率从 26.4% 提升到 84.1%。
研究背景:为什么还要把模型留在闭环里
过去几年,机器人操作的主流路线是把人类示范转成策略。视觉语言动作模型把图像、语言和动作映射到同一个网络,世界动作模型则尝试通过学习环境动力学来产生动作。它们在熟悉的物体、相机和任务分布中速度很快,但一个根本问题没有消失:训练数据覆盖不到的失败、遮挡、接触变化和语义歧义,仍要由策略自己处理。论文没有否认这类方法的价值,而是指出它们把大量通用推理能力压进了任务专用参数,换来的鲁棒性并不稳定。
另一种思路是技能编排。通用模型负责选择“抓取、放置、推”等已有技能,机器人执行技能库中的短动作。这样的系统能重新规划,但控制权被技能接口限制住了。若抓取器判断错误,或者物体需要先被推到桌边才能形成可抓区域,模型很难在技能内部改变策略。它的智能停留在外层调度,无法把自己的几何判断落实到手指、姿态和接触顺序上。
离线程序合成也常被称为“代码即策略”。模型在部署前写一段程序,程序运行时读取传感器并执行反馈。它比技能编排更灵活,却仍有一个结构性缺口:写出程序的模型已经退出运行过程,遇到初始假设失效时,负责修改控制策略的智能不在现场。于是程序可能忠实执行一个错误方案,直到超时。
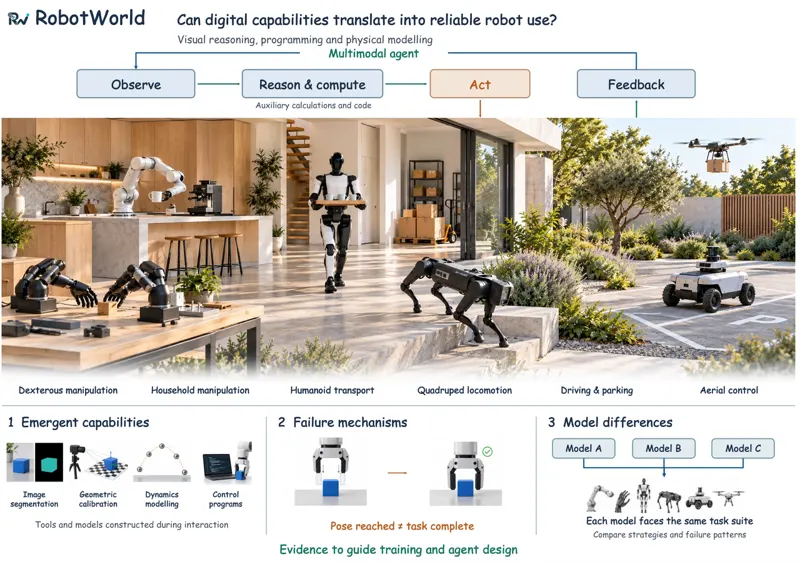
论文将第三条路线命名为智能体式操作策略,简称 AMP。通用模型不只是先写代码,也不只是选技能,而是每个回合都能读取新图像、运行新代码、执行动作并根据结果继续推理。模型既保留任务的全局目标,也能改变接触方式、重新标定相机,或把失败动作当成一次物理测量。这一区别看起来只是交互频率不同,实际改变了系统的能力边界:控制权限没有被人为压缩到预定义动作集合,模型可以把自己的空间理解直接转成轨迹。
真正让这一路线变得可行的,不只是大模型会写程序,还包括它们在空间判断、工具使用和长程任务上的进步。论文据此提出的问题不是“通用模型能否在真空中直接控制机器人”,而是一个更可检验的工程问题:当感知、代码执行、轨迹预览和机器人服务器被组织成一套稳定接口时,通用模型能否跨单臂、双臂和移动平台工作,并在没有示范的条件下超过专用策略。
从“策略网络”转向“机器人程序代理”
传统策略通常把观测到动作的映射写成神经网络,AMP 则把策略表示成一段仍在被编写的程序。这里的“策略”包含代码、场景模型、当前目标和执行记录。模型每个回合只决定下一步要获取什么信息、要写什么代码;代码可以被反复运行,变量和函数在剧集内保留。由于解释器状态持续存在,模型可以把上一回合算出的质心、抓取方向、相机偏置和路径点继续用于下一回合,而不是每轮重新概括整幅图像。
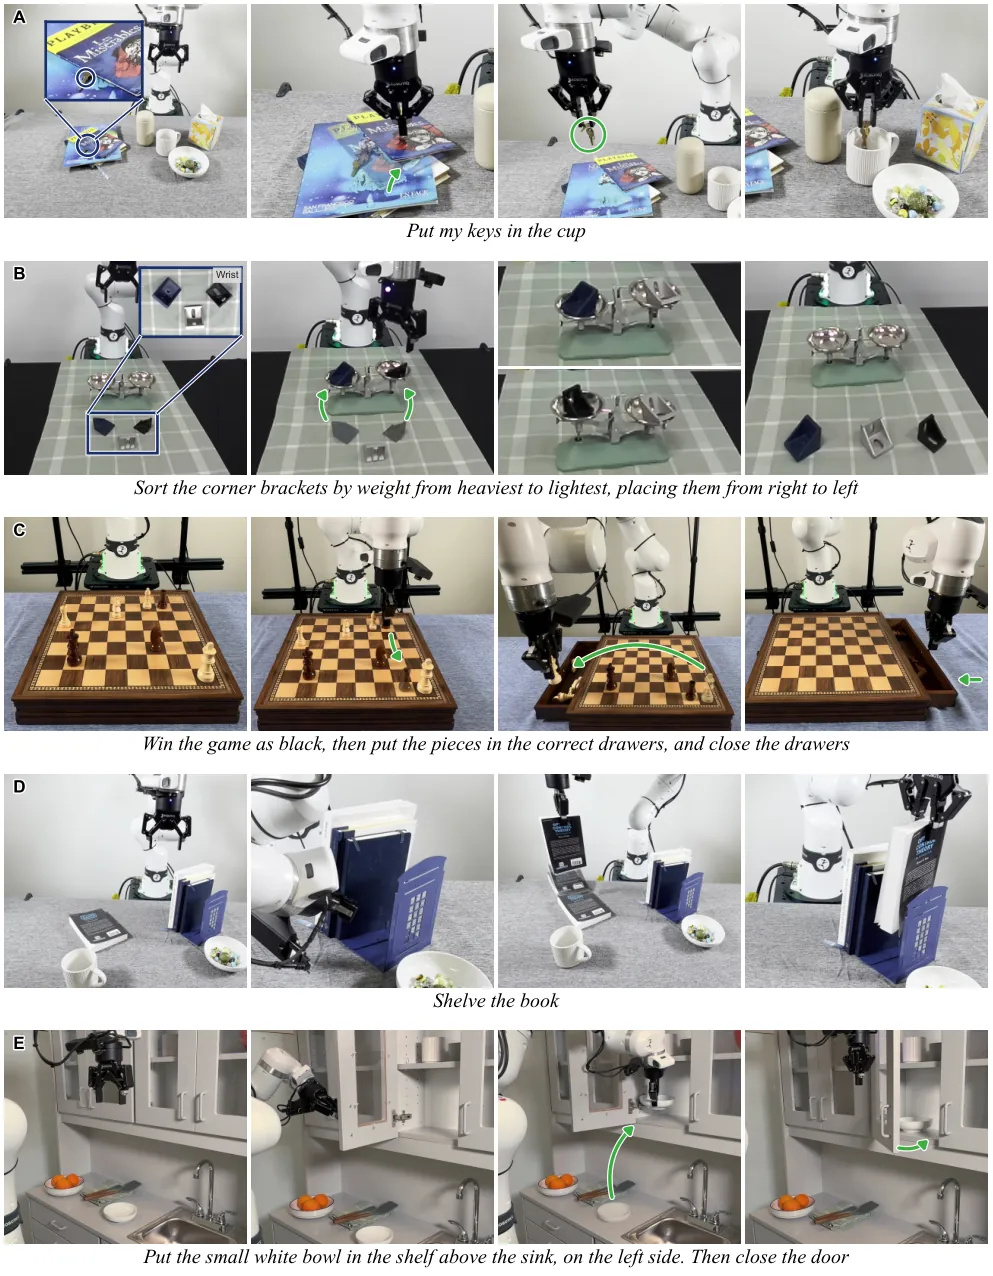
论文中的 AMP1 是参考外壳,不是某个固定任务的专用模型。它由通用模型、持久 Python 解释器、机器人服务器、感知与运动 SDK、路由策略和参考文档组成。模型通过代码调用 SDK;服务器返回相机、深度、机器人状态和场景对象,并检查和执行轨迹。任务说明、机器人模型和剩余控制步数都通过同一接口进入模型。换句话说,模型看到的是可操作的机器人世界,而不是被压成一句文本摘要的世界。
基础外壳刻意不提供抓取或放置技能。它只提供 TCP 点、关节状态、相机、深度、标定、对象网格以及“预览、检查、执行轨迹”等能力。这样做会增加模型的工作量,却保留了最关键的反馈粒度:一次错误的手指闭合、一次与桌面的碰撞、一次抓空,都能被模型看到并据此改变下一步,而不是被一个不透明的抓取例程吞掉。
方法详解
1. 持久解释器把回合串成完整策略
每个剧集启动一个沙箱内的 Python 解释器。模型提交的代码与上一次调用共享命名空间,导入、变量、图像数组和自定义函数都能保留。代码的打印输出、异常栈、显示图像以及剩余控制步数一起返回给模型。下一次模型调用从这些结果继续。这里的“持久”不是简单缓存上下文,而是让模型拥有一个可执行的工作空间:它可以在第一回合写点云聚类函数,第二回合复用该函数计算抓取点,第三回合把抓取点转换成轨迹。
源码中的 src/amp/kernel/kernel.py 明确把内核定义为“每个剧集一个持久且沙箱化的 Python 内核”,并持有外壳 SDK;src/amp/kernel/child.py 则在同一命名空间执行模型代码,并把结果封装成下一次对话可读的返回值。这个设计让模型既能做高层任务分解,也能把低层几何代码保存下来,成为实际动作策略的一部分。
零样本时,每个新剧集都从空内核开始,因此模型必须重新编写搜索、测量和抓取程序。AMP1+ 则把工作区中的笔记和 Python 文件带入后续剧集,使程序代理可以把一次经验转成下一次可调用的工具。论文强调这些程序不是由外部专家预先写好,而是由模型在感知与动作接口上自行构建。
2. 感知层把多相机数据变成可编辑场景
机器人可读取每台相机的 RGB、降采样深度、内参和相机在基座坐标系中的位姿。所有相机点云可以融合成带颜色的三维点云。服务器将融合点云体素化,把相邻体素聚成候选对象,并在颜色突变或接触边界处停止;小块噪声会合并或丢弃。每个对象随后由顶面高度图向下挤成闭合网格,得到用于碰撞检测的三维占用区域。遮挡造成的顶面空洞通常会被补全,除非相机确实看见缺口。
场景模型不是只读的。模型可以查看对象列表、点集、包围盒、颜色、尺寸和质心,也可以从一个像素扩张对象、用包围盒定义对象、替换错误对象或删除伪对象。新观测到来时,系统用最小代价匹配在前后帧之间保持对象编号;只有质心距离、颜色和尺寸都在容差内才视为同一对象。这样,模型既可以用自动分割快速起步,也能在自己的几何判断与分割结果冲突时修理场景,而不是被迫接受错误输入。
这个“可编辑世界模型”是 AMP1 与普通代码代理的重要差别。模型不是每次从图像猜一个坐标后直接执行,而是先把自己相信的物体边界、桌面高度和可用接触面写进场景模型,再在模型上做碰撞检查。若相机看不到柜子顶板,模型还能从被挡住的动作反推出上方存在不可见结构,并调整抓取位置。
3. 时序 TCP 路径点把代码意图变成运动
基础运动接口接收一串带时间戳的 TCP 位姿和夹爪命令。单个路径点可写为:
$$w_i=(T_i,t_i,g_i),\qquad T_i=(p_i,R_i)\in SE(3),\qquad g_i\in\{0,1\}$$
其中 pi 是末端工具中心的位置,Ri 是朝向,ti 是期望到达时刻,gi 表示夹爪开合。模型通常以当前位姿、物体质心或另一个路径点为参考,通过位置加接近方向或沿工具轴平移来构造位姿。双臂平台需要为每条机械臂分别生成路径点序列。
服务器把相邻路径点之间的归一化时间写成 u,分别对位置和旋转插值:
$$u=\frac{t-t_{i-1}}{t_i-t_{i-1}}$$
$$p(t)=p_{i-1}+\sigma(u)(p_i-p_{i-1})$$
$$R(t)=R_{i-1}\exp\!\left(\sigma(u)\log(R_{i-1}^{\top}R_i)\right)$$
五次多项式时间缩放 σ 用来减小加加速度。控制器在每个固定控制步长 Δt 上对插值位姿求逆运动学,并以上一帧关节角作为数值解初值:
$$q_k=\tau(k\Delta t)$$
求逆解之后,系统检查实际正运动学位姿与目标位姿的误差、关节速度上限,以及采样配置是否碰撞。场景对象占据的空间可写成:
$$\mathcal{O}=\bigcup_j M_j$$
机器人在配置 q 下占用的空间记为 A(q),碰撞配置集合与自由配置集合分别为:
$$\mathcal{C}_{\mathrm{obs}}=\{q\in\mathcal{C}\mid\mathcal{A}(q)\cap\mathcal{O}\neq\emptyset\}$$
$$\mathcal{C}_{\mathrm{free}}=\mathcal{C}\setminus\mathcal{C}_{\mathrm{obs}}$$
路径被拒绝时,服务器返回拒绝原因和受影响步骤,模型据此修改目标、放慢动作或换一个接近方向。这一拒绝不是简单报错,而是一条可学习信号。论文统计显示,在 1,200 个 RoboLab 剧集中,模型在 40% 的剧集里读取拒绝原因并修复计划;另在 39% 的剧集中诊断执行失败后重新规划。
运动 API 在源码中对应 src/amp/robot_server/api/motion.py 的 preview、plan_execute、stop 等入口,场景与持有物体由 src/amp/robot_server/world.py 的 World 管理。代码结构与论文描述一致:模型先预览,再检查,再执行,并在出错时保留上下文。
4. 强调直接控制,而不是把困难藏进辅助技能
论文比较了基础外壳和辅助外壳。基础外壳只给路径点、夹爪和碰撞工具,模型必须自己决定抓哪里、怎样接近、何时闭合。辅助外壳额外提供排序后的抓取与放置候选,以及自动重试的抓取例程;模型仍可选择任务对象和顺序,也随时能回到基础接口。
结果出乎“抽象越高越容易”的直觉。成功率最高的四个模型在基础外壳上表现更好,使用辅助外壳最多下降 7.5 个百分点;成功率最低的六个模型则得到帮助,最弱模型最多提升 17.6 个百分点。论文的解释很直接:辅助抓取会把内部失败重试隐藏起来,只报告最后有没有抓住,强模型因此看不到失败原因。直接控制虽然更繁琐,却保留了接触过程中的诊断信息。
flowchart LR
    A[语言任务] --> B[通用模型推理]
    B --> C[持久 Python 内核]
    C --> D[传感与场景 SDK]
    D --> E[点云融合与对象网格]
    C --> F[时序 TCP 路径点]
    F --> G[逆运动学与碰撞预览]
    G --> H[机器人服务器执行]
    H --> I[机械臂状态与相机反馈]
    I --> B
    E --> B
    G -->|拒绝原因或碰撞| B
5. AMP1+ 用工作区记忆代替权重更新
AMP1+ 在 AMP1 外增加一个跨剧集持久文件夹,记为 M。文件夹没有规定格式,可以放 Markdown 笔记、Python 库、数据或图像索引。模型在每个剧集开始时读取它,并自行决定保留哪些内容。常见做法是保存机器人坐标系、物理限制、缺少深度时的三角测量方法、抓取和放置的通用函数,以及失败条件。模型权重始终不变,学到的内容体现在可执行资产上。
少样本练习按批次进行。第 k 轮用共享记忆 Mk 并行运行 B 个布局,得到二值奖励和完整执行记录,再由反思代理汇总并生成下一版记忆:
$$\mathcal{M}_{k+1}=F\!\left(\mathcal{M}_k,r_{0:B}^{0:k},\tau_{0:B}^{0:k}\right)$$
论文使用 B=4、总练习预算 N=48,因此最多 12 轮。反思代理能看到所有奖励、代码、输出和相机记录;执行代理只看到当前记忆,不直接读取训练反馈。练习结束后冻结记忆,在未见布局上评估。
持续学习则按随机顺序遍历 42 个 RoboDojo 任务。第 t 个任务使用上一版记忆执行一次,得到反馈后更新:
$$\mathcal{M}_t=G\!\left(\mathcal{M}_{t-1},r_t,\tau_t\right)$$
这使学习从“为每个任务单独训练”变成“为一个机器人维护长期工作手册”。系统既考核已见任务是否保持能力,也考核未见任务能否从早期经验获益。论文中的重要发现是,增益不是只来自任务内记忆。完成第一段任务后,第四段尚未见任务的成功率已从 24% 上升到 47%,说明坐标、抓取和缺深度补偿等通用知识能够迁移。
flowchart TD
    A[练习剧集] --> B[官方二值结果]
    A --> C[对话代码图像记录]
    B --> D[反思与复盘]
    C --> D
    D --> E[笔记 Markdown]
    D --> F[可复用 Python 函数]
    D --> G[参数与失败条件]
    E --> H[下一任务工作区]
    F --> H
    G --> H
    H --> I[读取并直接调用]
    I --> A
实验结果
零样本仿真结果
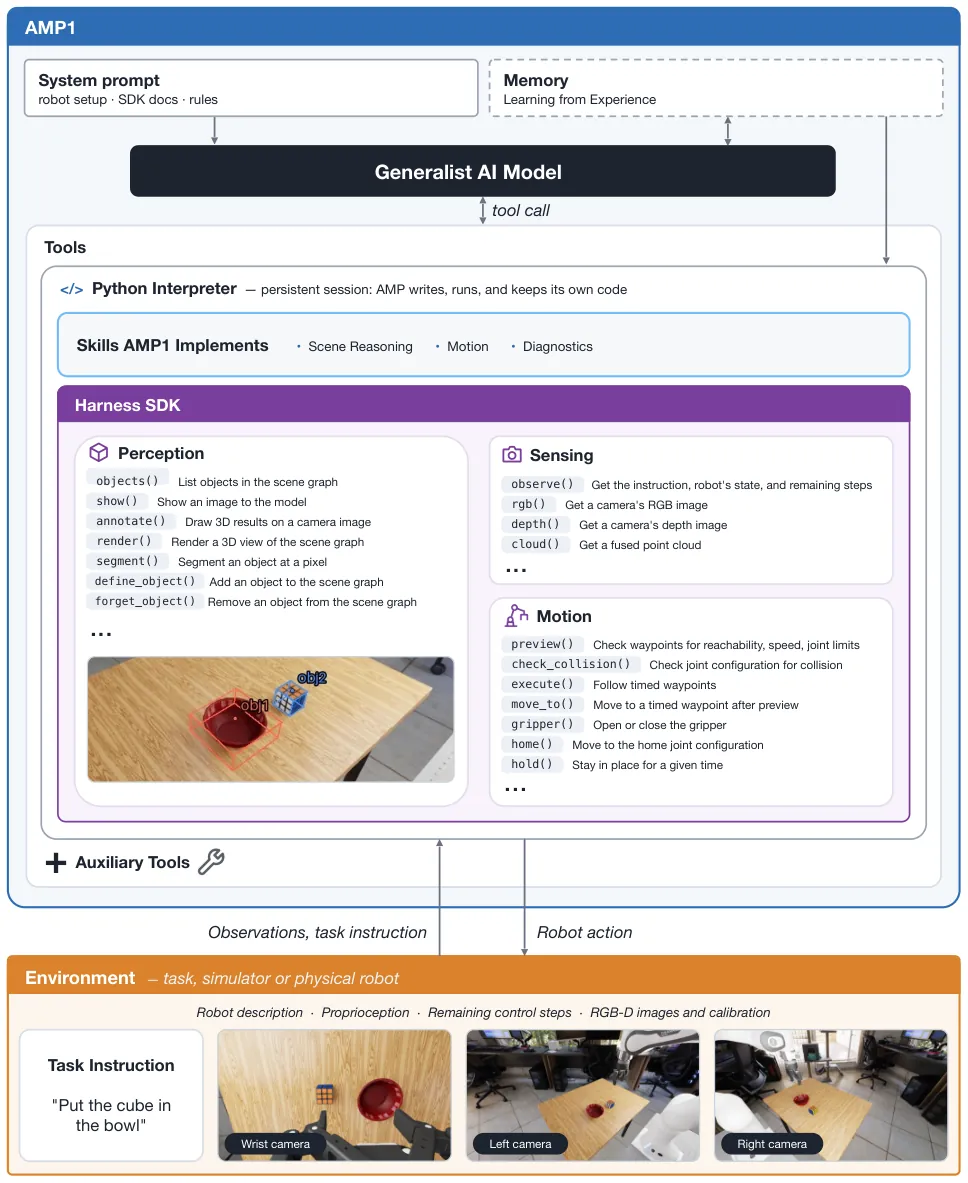
论文选择四个公开仿真基准来覆盖不同能力:RoboLab-120 有 120 个语言指定操作任务,并在默认、模糊和具体三种指令下评估;LIBERO-PRO 扰动物体位置和任务措辞;robosuite 包含单臂与双臂任务;BEHAVIOR-1K 的两个任务要求移动操作。AMP1 在所有基准中使用同一外壳,只替换机器人描述和相机配置。每个 RoboLab 任务运行 10 次,三种指令合计 3,600 个剧集;LIBERO-PRO 运行 3,000 次,robosuite 700 次,BEHAVIOR-1K 50 次。
Gemini 4 Argon 与 AMP1 组合在 RoboLab-120 默认指令下达到 85.6%,95% 置信区间为 83.5% 至 87.5%;Opus 5.5 与 AMP1 达到 82.8%。当时公开榜首的 SenseNova-RoboRSI 为 57.1%,最强学习策略 Lakeside 为 51.0%,最强 VLA 和 WAM 分别为 49.2% 与 42.9%。更重要的是跨指令稳定性:Gemini 在模糊和具体条件下仍为 84.0% 与 87.1%,Opus 5.5 为 79.8% 与 82.8%,波动约三个百分点;专用策略的下降则明显更大。
| 基准 | 任务与规模 | AMP1 结果 | 论文中的对照 |
|---|---|---|---|
| RoboLab-120 | 120 任务 × 10 次;默认、模糊、具体三种指令 | Gemini 4 Argon:85.6%;Opus 5.5:82.8% | 最强 VLA:49.2%;最强 WAM:42.9%;榜首智能体:57.1% |
| LIBERO-PRO | 60 个扰动任务 × 50 次 | 95.2% | 零样本 CaP-Agent0:18.2%;微调 π0.5:34.9%;HarnessPAI:96.5% |
| robosuite | 7 任务 × 100 次,其中 2 个双臂任务 | 700/700,100.0% | HarnessPAI:96.3%;人类程序:82.6% |
| BEHAVIOR-1K | 2 个移动操作任务 × 25 次 | 48/50,96.0% | CaP-Agent0:64%;人类程序:54% |
这组数字有两个容易被忽略的地方。第一,AMP1 的零样本定义为没有示范、没有基准训练、没有练习回合,而不是“模型从未在互联网上见过机器人代码”。它利用的是通用模型已有的空间和编程能力。第二,CaP-Gym 的最强程序代理能在 LIBERO-PRO 上略高 1.3 个百分点,但它会在评估任务的回合中反复改进程序;AMP1 不进行这种任务内练习。因此,比较重点不是某一个数字是否绝对最高,而是同一外壳在四类平台上如何保持接近饱和的表现。
真实机器人结果
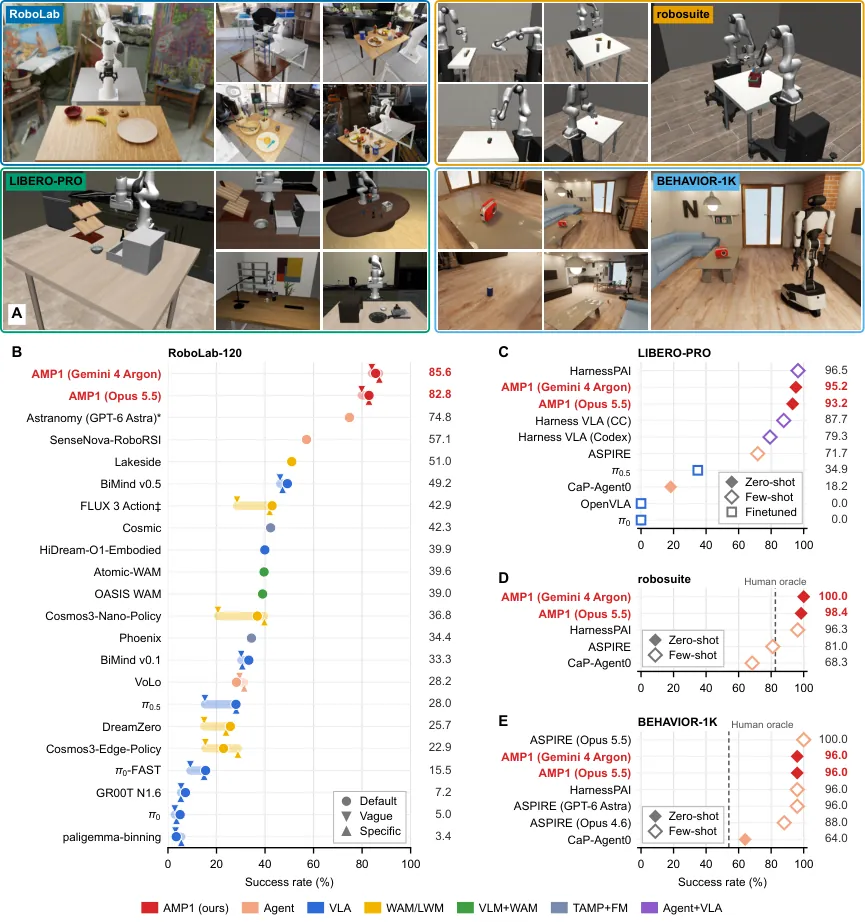
真实实验使用 12 个任务、3 套 DROID 风格平台,每套平台对每个方法运行 3 次,因此每个方法与任务组合有 9 次试验。平台都使用 7 自由度 Franka Research 3、Robotiq 2F-85 夹爪和 ZED 相机,但桌面背景、相机标定、线缆和部件磨损不同。所有方法共享 5 分钟执行预算,初始物体位姿由场景恢复工具对齐。AMP1 与 Opus 5.5 组合完成 104/108 次试验,成功率 96.3%;FLUX 3 Action 为 49/108,π0.5 为 30/108。
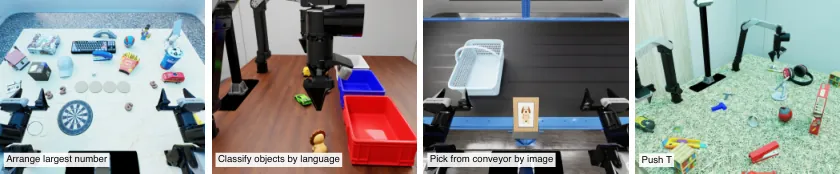
真实任务比“抓起来放进容器”更杂:有的要求排除锤子后整理工具,有的要求按颜色和类别选物,有的需要先形成可抓区域,有的要求覆盖再揭开。AMP1 的成功时间被拆成执行和推理两部分,平均成功试验总时间为 280 秒,其中执行 69 秒、推理 211 秒。这组时间已经揭示了论文的核心代价:方法擅长处理变化,但机器人大量时间在等待模型思考。它并没有把慢隐藏起来。
| 配置 | 成功数 / 总数 | 成功率 | 说明 |
|---|---|---|---|
| AMP1 + Opus 5.5,开启错误恢复 | 104 / 108 | 96.3% | 12 个任务、3 个硬件实例、每任务每实例 3 次 |
| AMP1 + Opus 5.5,关闭错误恢复 | 94 / 108 | 87.0% | 控制器错误直接终止试验;近接触任务受益最大 |
| FLUX 3 Action | 49 / 108 | 45.4% | 专用世界动作策略 |
| π0.5 | 30 / 108 | 27.8% | 专用视觉语言动作策略 |
错误恢复消融很值得注意。AMP1 可调用状态查询和恢复接口,在 Franka 碰撞反射中断动作后继续同一个剧集。开启恢复时从 94 次提高到 104 次成功,收益集中在夹爪或持有物需要贴近场景的任务;例如“装罐”从 3/9 提高到 9/9。这说明在真实接触中,智能不只是选对物体,还包括在机器人保护性停机后判断发生了什么、恢复状态并重新走一条更安全的路径。
涌现行为:模型在无技能库时自行发明操作策略
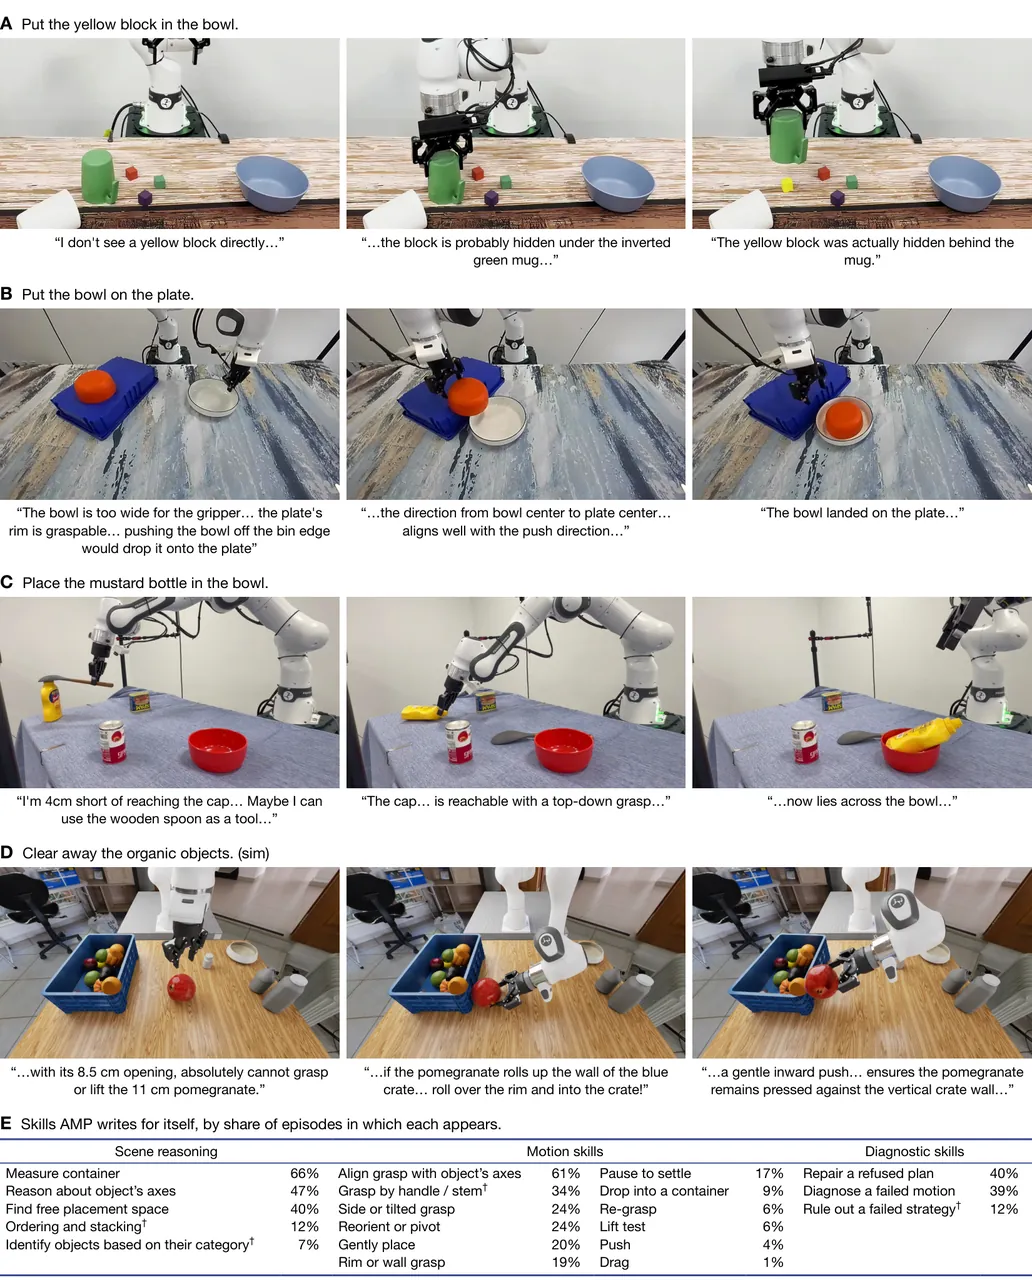
论文记录的行为并非提示词里逐条列出。书平放在桌面难以抓取时,模型会先把它推到桌边,让一部分悬空形成可抓边缘。目标被遮挡时,模型会移动遮挡物再寻找。大水果超过 85 毫米夹爪行程时,模型把它顶在更重物体上,再从下方像叉车一样托起。长条物体无法一下放平时,模型先让一端接触桌面,再沿弧线放下另一端。失败动作也能成为传感器:机械臂被看不见的层板挡住时,模型根据指令位姿与实际到达位姿的差异推断遮挡结构,并在后续动作中留出安全余量。
这些行为表明 AMP 不只是执行“抓取 + 放置”的组合,而是在构造可行动方案。论文对 1,200 个 RoboLab 剧集做了技能统计,只有至少出现在 5 个剧集、2 个任务中的模式才计为技能。测量容器再放置出现在 66% 的剧集,按物体坐标轴对齐抓取出现在 61%,考虑长短轴的策略出现在 47%,读取拒绝原因并修复计划出现在 40%,执行失败后诊断再规划出现在 39%。统计依赖代码和思维记录匹配,因此它衡量的是可重复行为,而不是证明每个行为都完全正确。
从经验中学习
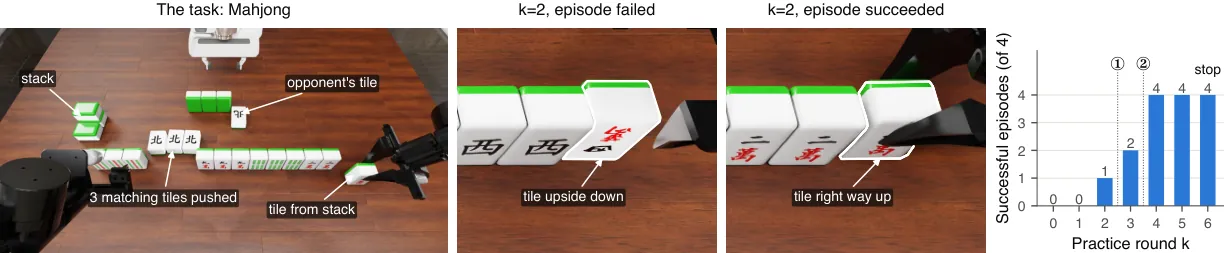
RoboDojo 包含 42 个双臂任务,只提供 RGB,没有深度和相机标定,难度明显高于 AMP1 已接近饱和的 RoboLab。零样本 AMP1 成功率为 26.4%。少样本 AMP1+ 在种子 0 布局上练习,每任务最多 48 个剧集,最后在种子 2 的 50 个未见布局上评估。练习后成功率升到 84.1%,超过榜单当时第一名 Q0-Preview 的 68.9%。模型调用数约下降 35%;到第二轮时,42 个任务中已有 39 个保存了代码库,常用过程不再每回合重写。
麻将任务展示了记忆为何有效。模型要从牌堆取牌并立在行末,但评分还要求牌面方向正确。第 2 轮中,一个失败剧集和一个成功剧集对比后,反思代理放大最后一帧,发现成功样本的红色符号在下、失败样本在上;追踪动作后,它判断两张牌是从相反端拿起的。记忆记下“哪一端是顶部”,下一轮再修正“先张开夹爪再接近牌堆”,该任务的未见布局成功率从练习前 10% 升到 100%。
持续学习更接近部署后的长期运行。模型按随机顺序只做一次每个任务,在每次二值反馈后更新共享工作区。完整走过 42 个任务后,总体成功率从 26.4% 升到 57.6%。第一段 10 个任务完成后,未见过的第四段从 24% 升到 47%,而已经见过的任务没有明显回退。工作区里保存的内容通常不是“某张图的答案”,而是机器人坐标系、速度与工作空间限制、没有深度时如何三角测量、抓取函数以及何时打开夹爪这类跨任务知识。
控制实验:模型、推理量和感知接口
论文让外壳固定,只改变 13 个模型和推理档位。成功率从 Qwen3.6-35B-A3B 的 12.8% 到 Gemini 4 Argon 的 85.6% 不等;Claude 家族中 Opus 5.5 为 82.8%,Haiku 5.5 为 51.6%,较旧的 Opus 4.5 为 35.2%;开源权重模型里 Qwen3.8-Flash-Next 最高,为 64.9%。提高推理强度对所有模型都有帮助,Claude 模型最多提升 17.2 个百分点。模型选择的影响明显大于单纯改一个感知开关。
感知消融进一步区分了“会不会做”和“做得多费劲”。Opus 5.5 从完整 RGB、标定、深度和感知工具,逐步去掉工具、深度和标定,成功率分别是 82.8%、81.9%、81.1% 和 75.8%;每剧集模型调用数依次为 34.8、38.7、46.3 和 53.5。强模型会用多视角三角测量补回深度,或移动到已知夹爪姿态拍图,再用 SIFT 匹配和最小二乘恢复相机内外参。成功率没有崩塌,但计算量显著增加,这说明鲁棒性来自主动感知,而不是传感器缺失没有影响。
弱模型的补偿能力差得多。Haiku 5.5 在只有 RGB 时从 51.6% 掉到 10.7%。直接把图像换成文本描述也会让 Opus 5.5 从 82.8% 降到 36.8%,与之前某些研究推荐文本摘要的结论相反。相机数量反而不是决定性因素:完整感知下,三相机为 82.8%,只用场景相机为 80.8%,只用腕部相机为 80.0%;腕部相机条件下,模型会先收回机械臂,让更多场景进入视野。
| 输入条件 | RoboLab-120 成功率 | 每剧集平均模型调用数 | 观察 |
|---|---|---|---|
| RGB + 标定 + 深度 + 感知工具 | 82.8% | 34.8 | 完整输入 |
| RGB + 标定 + 深度 | 81.9% | 38.7 | 模型自行检测并提升对象到三维 |
| RGB + 标定 | 81.1% | 46.3 | 通过多视角匹配像素并三角测量 |
| 仅 RGB | 75.8% | 53.5 | 主动拍图恢复相机参数与几何 |
| 仅文本描述 | 36.8% | 论文图中单独报告 | 视觉信息被摘要后损失关键空间细节 |
失败分析与成本
RoboLab 中 Gemini 的 1,200 次默认指令试验成功 1,027 次。173 次失败里,121 次可归因于基准自身:物体几何或质量不适合标准平行夹爪,或者验证器错误拒绝满足任务的终态;真正属于代理决策错误的只是一部分。Opus 5.5 的 206 次失败里有 135 次是同类基准伪影。在 95 个没有这些伪影的任务上,Gemini 与 AMP1 达到 96.2%,即 914/950。这个分析没有把所有失败都算作算法能力,也让接近饱和的数字更可信。
成本方面,Opus 5.5 在 RoboLab-120 中平均每个剧集花费 1.39 美元,约为论文所引 Astranomy 使用 GPT-6 Astra 时 36.40 美元的四十分之一;更准确地说,论文称约低 26 倍,同时 AMP1 的成功率更高。节省来自两点:一次模型回合可以下发整条轨迹,而不是每个小末端步骤都请求模型;图像只在模型主动查看时进入上下文。代价则是单次响应更复杂,推理延迟仍可能主导真实任务时间。
局限与风险
作者明确承认推理速度是主要瓶颈,机器人经常在等待模型思考。第二项作者局限是模型无法在轨迹执行过程中重新考虑策略,而论文评估大多面向准静态场景;如果目标正在移动或物体在夹持中滑动,控制器可能在模型下一次回合前已经错过修正窗口。这两点直接限制了高频接触和动态任务。
从系统角度看,远程通用模型 API 还会引入网络、供应商限流和模型版本变化风险。论文中的部分失败被明确归为提供方阻塞。真实实验只覆盖 Franka 单臂、Robotiq 夹爪和固定 DROID 相机组合,而双臂和移动平台主要来自仿真,因此“同一外壳跨形态”已有较强证据,但还不能等同于真实双臂与移动机器人的广泛验证。
感知依赖深度、标定和点云质量。强模型可以通过主动感知弥补部分缺失,但调用成本和延迟显著上升;弱模型几乎无法补偿。基准伪影与验证器偏差也提醒读者,85.6% 不是脱离评价协议的能力常数。另一个尚未解决的问题是安全:代码运行在沙箱中,但机器人动作仍需工业级碰撞、速度和权限约束。模型会预览和检查,实验也启用了机器人保护反射,但这不等于形式化安全保证。
AMP1+ 的记忆同样不是无风险的知识积累。模型可能把一次偶然成功的策略写成通用规则,也可能把只适用于某个相机或硬件的坐标偏差带进新任务。论文没有给出记忆冲突检测、权限审计或回滚机制。若部署到多用户环境,工作区中的可执行代码还需要来源、版本和安全审查。
源码与复现细节
公开仓库提供了论文检查点和可运行外壳。持久内核位于 src/amp/kernel/;机器人运动、世界模型和辅助抓取接口分别位于 src/amp/robot_server/api/motion.py、src/amp/robot_server/world.py 和 src/amp/robot_server/api/assist.py。docs/practice.md 把 AMP1+ 的工作区解释为任务笔记本:少样本每任务维护一个,持续学习让 42 个任务共享一个,评估阶段禁止写入。
仓库还公开了 fewshot_best5 和 continual_chain00 等工作区检查点,可分别复现不同练习轮次和持续学习节点。实践脚本将每个练习批次设 4 个并行剧集,最多 48 个练习剧集;持续学习使用一次随机任务排列,并在第 10、20、30、42 个任务后做完整评估。这个实现边界很重要:记忆是有大小上限的文件夹,不是无限上下文,更不是偷偷更新模型参数。
总结与展望
这篇论文的贡献不只是刷新几个基准,而是把机器人操作的控制权重新分配给一个会观察、会写代码、会从接触中修正假设的通用模型。AMP1 证明,在没有任务专用训练时,持久解释器、可编辑场景、带时序的 TCP 路径和直接执行反馈足以支撑单臂、双臂和移动操作。AMP1+ 进一步说明,经验可以存成笔记与可执行函数,在不改权重的情况下改善成功率与调用效率。
论文最有价值的判断是“能力与速度不应被混为一谈”。专用策略更快,但当前可靠率远不足以支撑开放任务;AMP 更慢,却已经能把多数任务做对。未来路线不是简单在两者之间选边,而是把 AMP 产生的程序和执行记录蒸馏成更快的本地控制器,让模型在低频层维护语义与策略,让学习到的反馈控制器在高频层处理接触和动态变化。这一路线若解决延迟、安全验证和真实多形态评估,通用机器人操作才可能从演示走向可维护的长期系统。
金句
智能体式操作的核心不是让大模型“说出动作”,而是让它保留改变动作策略的权力,并把每一次失败变成下一次观察与执行的输入。