Skip to content
←返回能力前沿雷达

SOTA · 智能体与运行时

游戏与模拟

可复位环境里的长时序策略、开放世界游戏 Agent

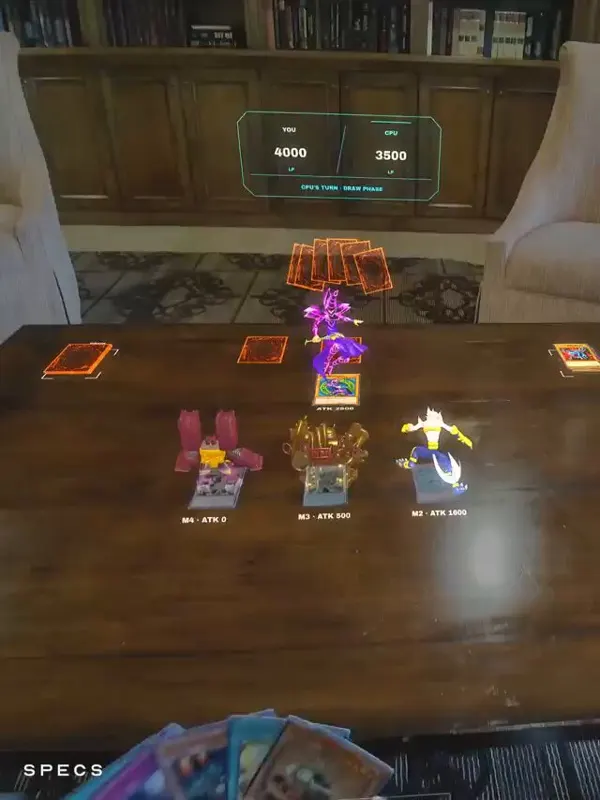
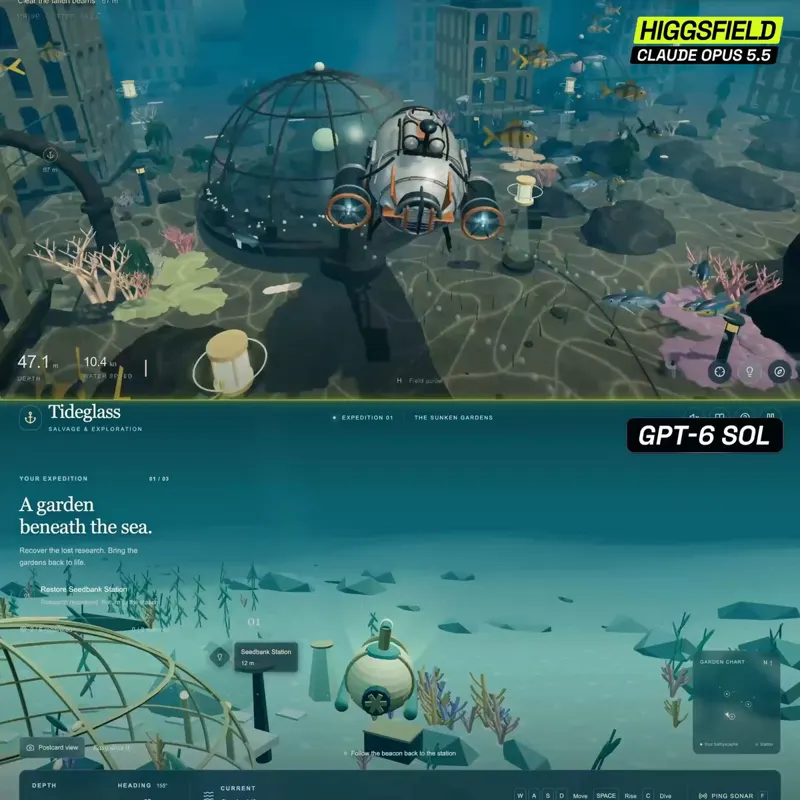
游戏与模拟是 agent 能力的可复位实验场:同一个环境可以无限次重开,失败没有真实代价,这让「策略学习」第一次能被大规模测量。它与 AGI 的关系不在「AI 会玩游戏」,而在游戏是唯一同时提供长时序决策、部分可观测、稀疏奖励与可交互物理的标准化环境——真实世界的这四条,在这里都能被隔离研究。`games` 被放进「智能体与运行时」家族而不是「具身」家族,正是因为这条区分:游戏环境可复位,真机不可复位,两者的失败代价与数据获取方式完全不同,混在一个域里会让「进展」这个词失去意义。判断这个域看的是策略迁移与长时序一致性,不是画面:一段看起来很聪明的 demo 可能只是脚本触发的。收录现状:当前梯顶只有一条桥接资产(Genesis-Embodied-AI 的 genesis-world,30k★,同时挂 embodied / world3d / games / safety),独立的通用游戏智能体系统(Atari、Procgen、MineDojo、BALROG 口径)尚未入库;世界模型侧的 zing-world-model(123★)在证据流可见,但因低于证据门限不进阶梯。

尺子Atari 100k、Procgen、MineDojo、BALROG

SOTA 阶梯

1
具身智能

Genesis World:面向物理 AI 的统一多物理仿真平台

Genesis AI 开源的物理 AI 仿真平台:一套 Pythonic API 之下是多物理引擎(刚体、FEM、MPM、PBD、SPH、Stable Fluid、IPC)、Nyx 路径追踪渲染器,以及跨平台 Python-to-GPU 编译器 Quadrants。它的定位是机器人基础模型的评测引擎而不是数据工厂——单卡 3 万并行环境跑出 43M FPS;在零样本 real-to-sim 协议下,仿真与真实的评测一致性皮尔逊相关 0.8996、平均最大排序违背 0.0166。Apache 2.0,29.9k star。

30kGitHub Star 数
Genesis World:面向物理 AI 的统一多物理仿真平台
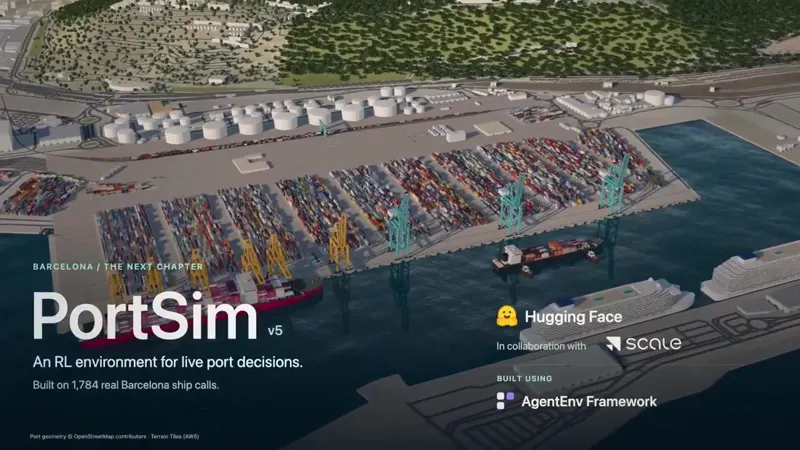
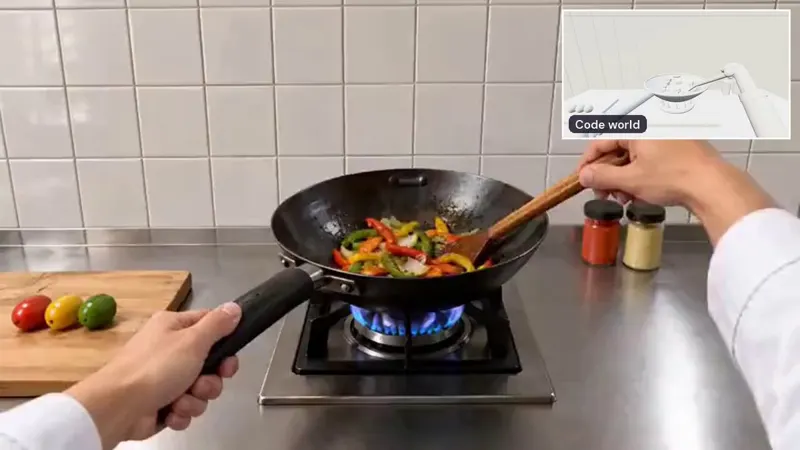
最新演示

8

论文与深读

2

开源项目

3

现在就能用的资产

这个域还没有挂上可直接装用的 skill。

消费它的领域

边界与失败模式

这个域的经典陷阱是「在基准里通关,在游戏里不能用」。一是策略不迁移:在 Atari 100k 这类固定协议下学到的策略,换一个分辨率、一套按键映射、一次版本更新就崩,因为它学的是像素统计而不是游戏规则,而商业游戏每次补丁都在改这两样。二是评测协议与真实玩法脱节:Procgen、MineDojo、BALROG 各量一个侧面(泛化、开放世界、语言理解),没有一个能代表「一个 agent 能不能替玩家完成一段真实流程」,所以这个域的基准读数默认标 needs-reproduction。三是记忆与状态管理是真瓶颈:长流程游戏要求 agent 记住几十分钟前发生了什么、物品放在哪、哪个 NPC 说过什么,当前的上下文窗口与检索机制撑不住这种量级的持久状态,失败表现为反复走同一条路或忘记已经解开的谜题。四是不可复位环境的成本外溢:即使环境可复位,一次完整流程的推理成本也远高于一次对话,自动化跑一晚上可能烧掉相当可观的 token,这让「大规模自我对弈」在当前价位下只对少数实验室成立。五是 sim-to-real 的鸿沟:游戏里学到的控制策略迁到真机时,物理引擎的近似误差会直接暴露,这也是 games 与 embodied 分家的根本原因。

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。