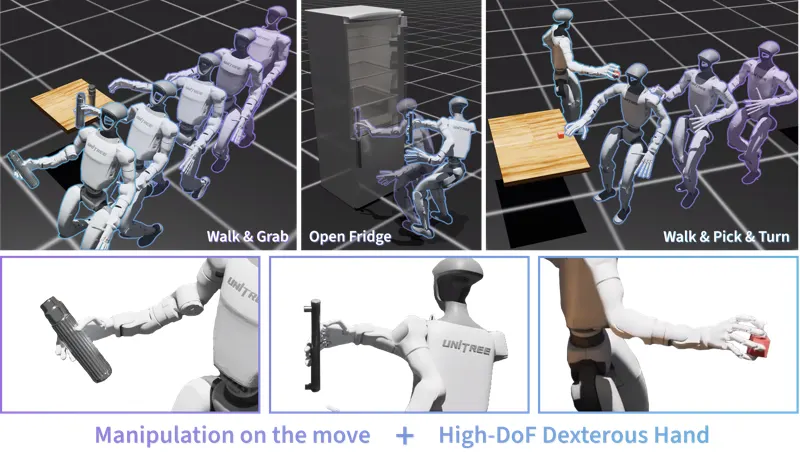
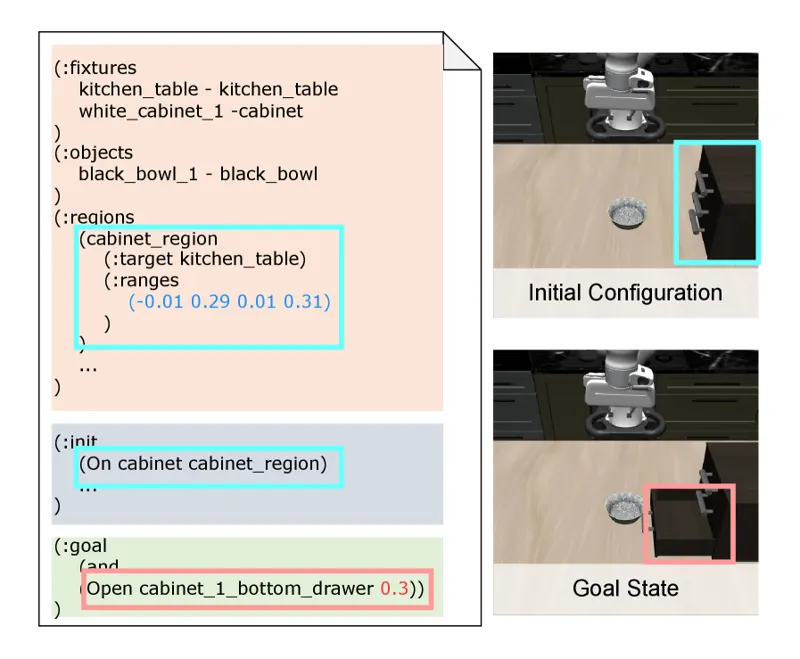
人形机器人行走操作常被简化为走走停停——走到物体前停下操作。CoorDex 提出协调身体与手部先验的框架,实现行走与操作同时进行的连续灵巧 loco-manipulation,无需停顿即可在移动中抓取和操控物体。
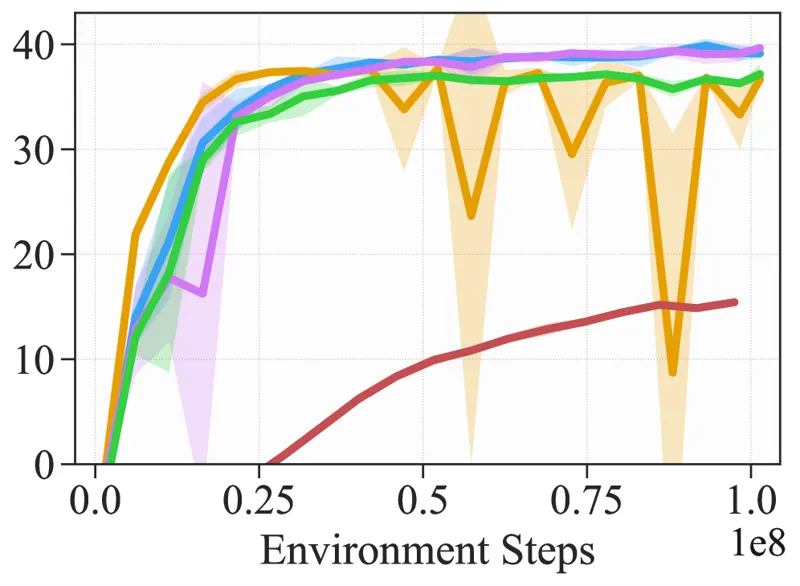
对目标动作施加均值中心 tanh 截断映射,仅用于 Bellman 备份中目标 Q 值计算,用变量替换推导一致熵项——减少极端目标动作方差放大,在 MuJoCo Playground 和 HumanoidBench 上实现更快更可靠的离策略 RL 训练。
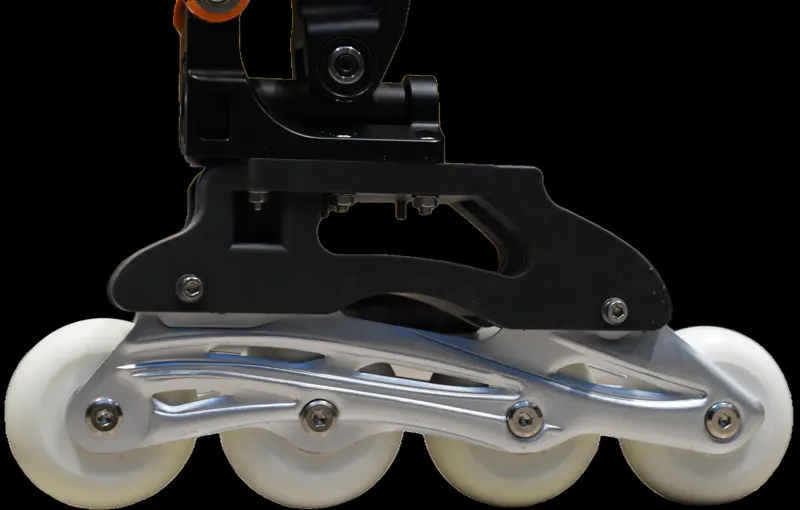
将强化学习与人形机器人结合,解决被动轮滑的欠驱动复杂力学问题,实现动态轮滑步态的新形态。
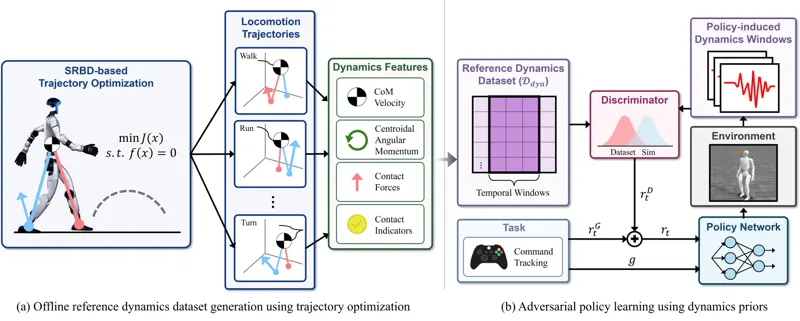
用轨迹优化生成参考动力学特征(质心运动、动量、触地力),通过对抗判别器正则化策略生成的动力学窗口而非模仿关节级运动学,实现对外部扰动更强韧的人形运动恢复。相比 AMP 成功率提升 18 个百分点。
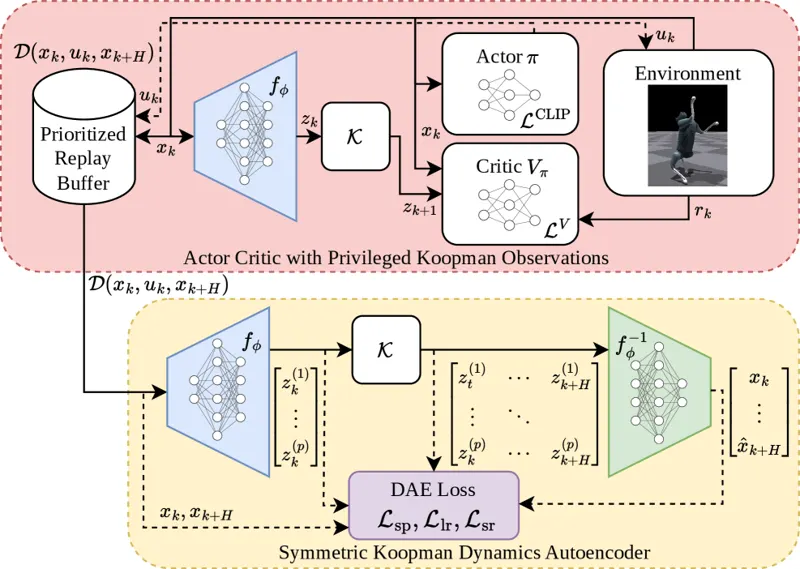
将形态对称性(C2反射)与 Koopman 动力学自编码器结合,在 actor-critic RL 中为 critic 提供线性化动力学预测作为特权观测,显著提升样本效率和跨对称任务泛化能力。在 Cyberdog2 双足任务上验证。
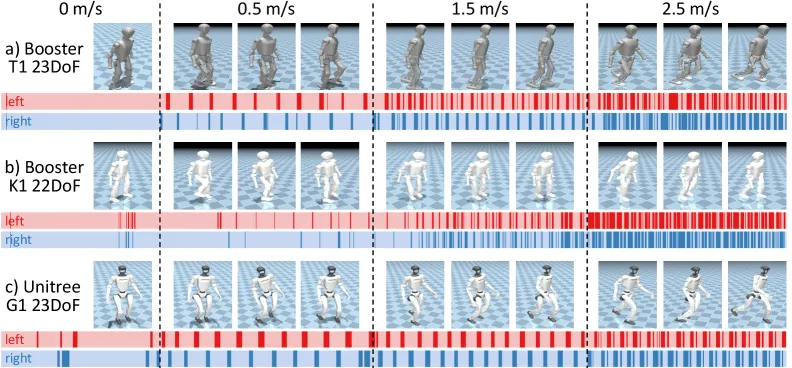
将预训练行走策略当作种子技能,通过 GaitWave 节奏生成、H-SLIP 步态动态塑形和残差适应三个模块,让一个策略连续覆盖行走→慢跑→跑步,在五种人形形态上实现零样本迁移。
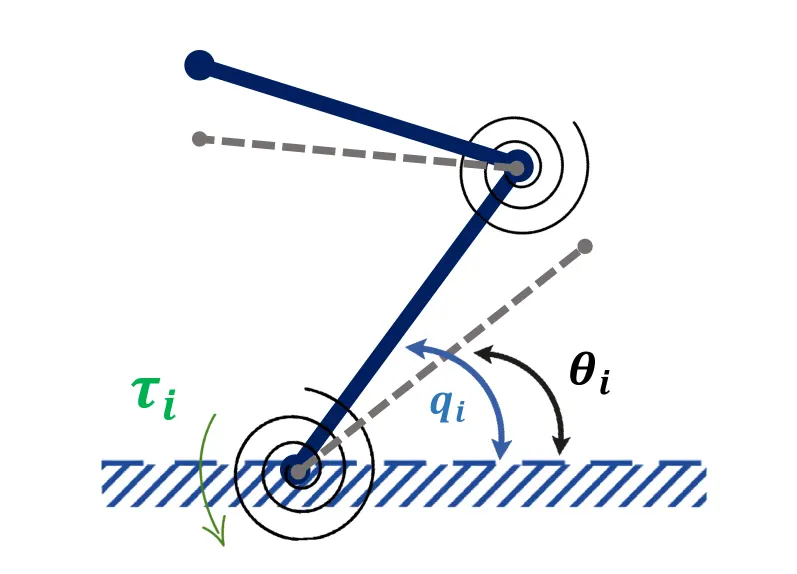
提出结合比例-阻尼(P+d)控制器与TD3深度强化学习agent的混合控制方法,在关节柔性与时变通信时延下实时调节远端增益,降低振动并提升跟踪性能,基于Lyapunov-Krasovskii分析保证有界时延下的稳定性。
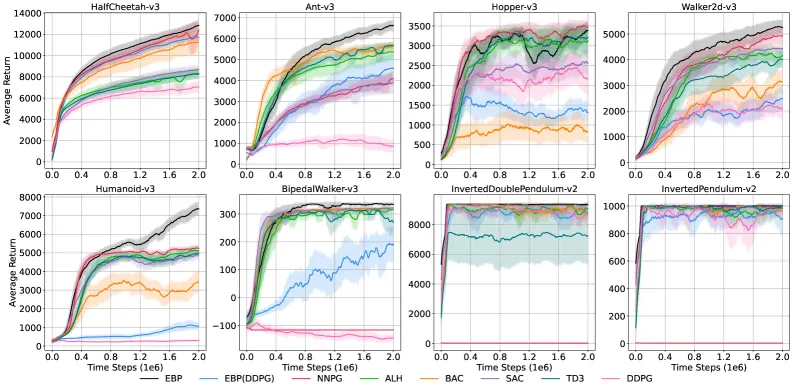
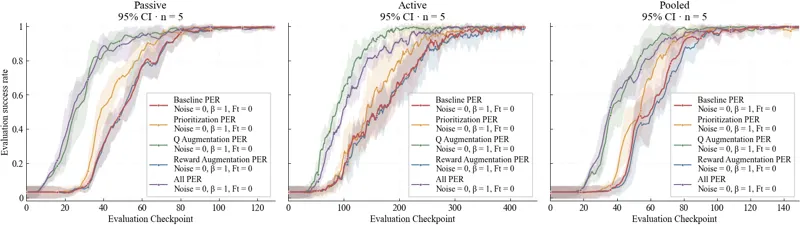
针对行为先验强化学习依赖静态离线数据集的局限,提出专家行为先验(EBP)算法,用Q引导的条件变分自编码器直接从在线replay buffer生成高价值动作先验,结合专家策略引导与策略梯度校正,在机器人控制与工业控制基准上显著提升样本效率与收敛稳定性。
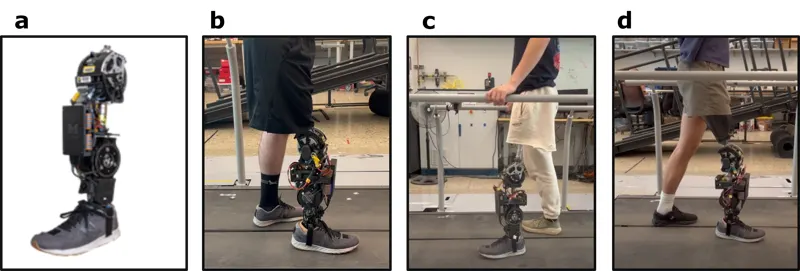
针对动力假肢阻抗控制器个性化挑战,提出回放约束的仿真框架,在低维参数空间外探索,降低人工调参与时间成本,实现步态生物力学个性化的高效优化。
针对长时程操作任务中强化学习稀疏奖励与长时程难题,提出LLM增强的自动课程学习(LEACL),利用大语言模型渐进式生成由易到难的任务序列,提升agent样本效率与最终性能。
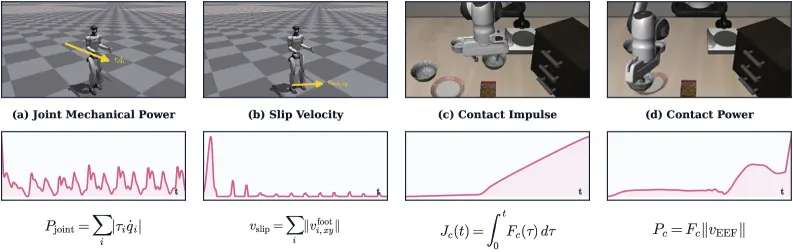
PRISM 提出一种紧凑的策略表示方法,将可观测物理变量间的多项式交互显式化、可学习化。标准 MLP 策略接收一阶变量(位置、速度),但许多动作相关线索来自乘积交互(如关节功率=扭矩×速度)。PRISM 用因子化多项式模块直接暴露这些交互,无需枚举所有单项式,在人形机器人行走和接触丰富操作上显著超越 MLP 基线。
本文提出一种离线方法,利用fNIRS(功能近红外光谱)引导强化学习来塑造机器人行为,将脑信号解码与机器人控制策略训练相结合。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。