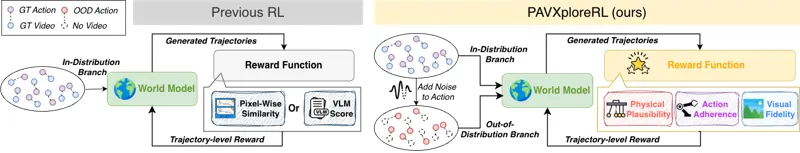
PAVXploreRL提出物理-动作-视觉世界模型强化学习方法,通过动作探索实现具身智能体的环境理解和策略优化。
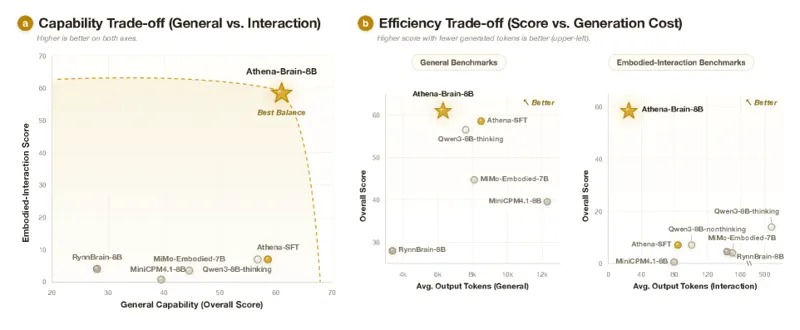
Athena-Brain是一个高效的机器人大脑系统,面向通用智能和具身交互,集成感知、推理和行动能力。
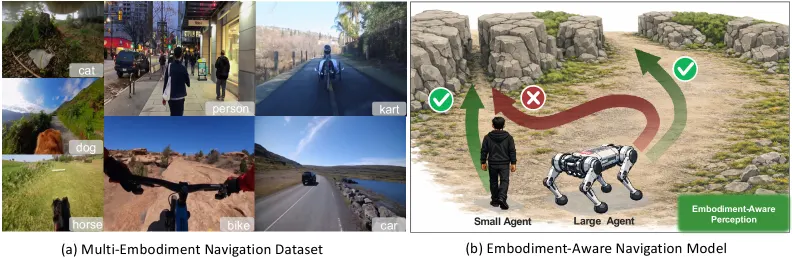
EA-Nav提出具有身体感知的安全视觉导航策略学习方法,让机器人理解自身身体约束进行安全导航。
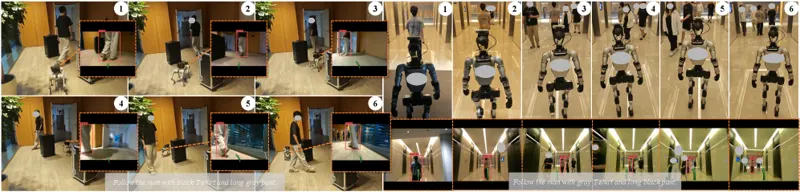
ReferTrack提出先指代再跟踪的范式用于身体化VLA模型,结合自然语言指代和视觉跟踪实现机器人对目标的精准操作。
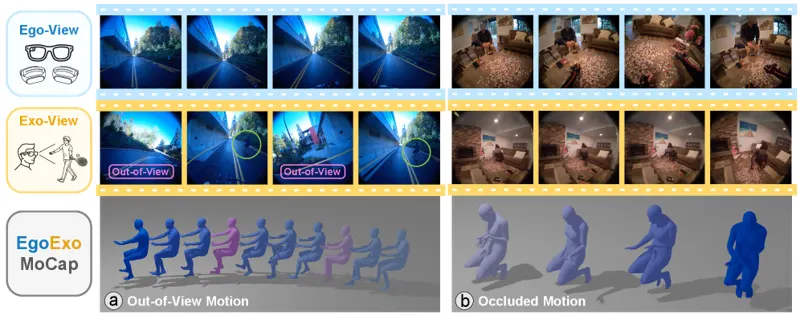
从头戴设备进行人体运动捕捉,同时估计佩戴者和周围人的运动,为具身AI和VR/AR提供可扩展的真实人体运动数据。
Octo 是一个开源的通用机器人策略模型,基于 Transformer 架构,可在多个机器人平台上快速微调,支持多模态输入。
RT-2 将预训练视觉-语言模型转化为机器人策略,使机器人能根据自然语言指令执行未见过的操作,展现强大的零样本泛化能力。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。